LangChain vừa nâng cấp LangSmith với Engine v2 hỗ trợ kiểm thử tự động, Managed Deep Agents thế hệ mới và khả năng tinh chỉnh mô hình chuyên sâu giúp tối ưu hóa quy trình phát triển AI.
LangChain vừa giới thiệu LangSmith Fine-Tuning tại hội nghị Interrupt, cho phép chuyển đổi các lượt chạy thành công từ LangSmith thành tập dữ liệu huấn luyện thông qua công cụ CLI mã nguồn mở smithtune trên nền tảng Baseten Loops.
LangChain vừa giới thiệu LangSmith Fine-Tuning cùng công cụ CLI SmithTune, giúp đơn giản hóa quy trình hậu huấn luyện mô hình mà không cần xây dựng đường ống dữ liệu thủ công.
Together AI giới thiệu mô hình phân loại Jev dựa trên nền tảng Qwen3.5 4B. Bài viết hướng dẫn chi tiết quy trình tinh chỉnh mô hình này trên nền tảng serverless với chi phí tối ưu.
DịchNhà phát triển AlicanKiraz0 đã ra mắt Kahya-TTS, một mô hình chuyển văn bản thành giọng nói được tinh chỉnh từ VoxCPM2 bằng 100 giờ dữ liệu tiếng Thổ Nhĩ Kỳ, hiện đã có mã nguồn mở trên Hugging Face.
Nghiên cứu đề xuất phương pháp tinh chỉnh mô hình bằng cách giới hạn độ lệch hành vi, tập trung vào việc chọn hướng cập nhật tối ưu thay vì chỉ quan tâm đến khoảng cách, giúp bảo toàn năng lực gốc của mô hình.
Nghiên cứu giới thiệu bài toán ghi nhớ dài hạn, nơi mô hình phải học 100 tác vụ liên tiếp mà không bị quên kiến thức cũ. Nhóm tác giả đề xuất kết hợp các cơ chế bổ trợ để tối ưu hóa việc lưu giữ thông tin qua nhiều lần cập nhật trọng số.
LangChain tích hợp Baseten Loops nhằm tối ưu hóa quy trình huấn luyện và tinh chỉnh mô hình cho LangSmith, cho phép triển khai trực tiếp lên nền tảng suy luận của Baseten thông qua API.
Together AI bổ sung hỗ trợ cho các dòng mô hình mới như GLM-5.3, Kimi K2.7 và Qwen 3.5, đồng thời tích hợp tính năng theo dõi thử nghiệm trực tiếp và kiểm soát dữ liệu chuyên sâu.
NoRA (Normalized Low-Rank Adaptation) giới thiệu một thay đổi đơn giản nhưng hiệu quả trong cấu trúc LoRA, giúp cải thiện khả năng hội tụ mà không làm tăng chi phí tính toán.
NoRA cải thiện hiệu suất LoRA bằng cách chuẩn hóa ma trận chiếu dưới, giúp tăng tốc hội tụ, ổn định huấn luyện và giảm thiểu quên lãng mà không làm tăng chi phí tính toán.
New Amazon paper shows KV-cache policy is not just an inference optimization; but it can change the …
DịchNghiên cứu mới của Amazon chỉ ra rằng việc đồng bộ hóa chiến lược KV Cache trong quá trình tinh chỉnh (fine-tuning) giúp mô hình tránh lỗi mất ngữ cảnh khi xử lý văn bản dài, thay vì chỉ tập trung vào tối ưu suy luận như trước đây.
Small models, specialized capabilities. 🚀 Developer @JacobLinCool customized MiniCPM5-1B with two …
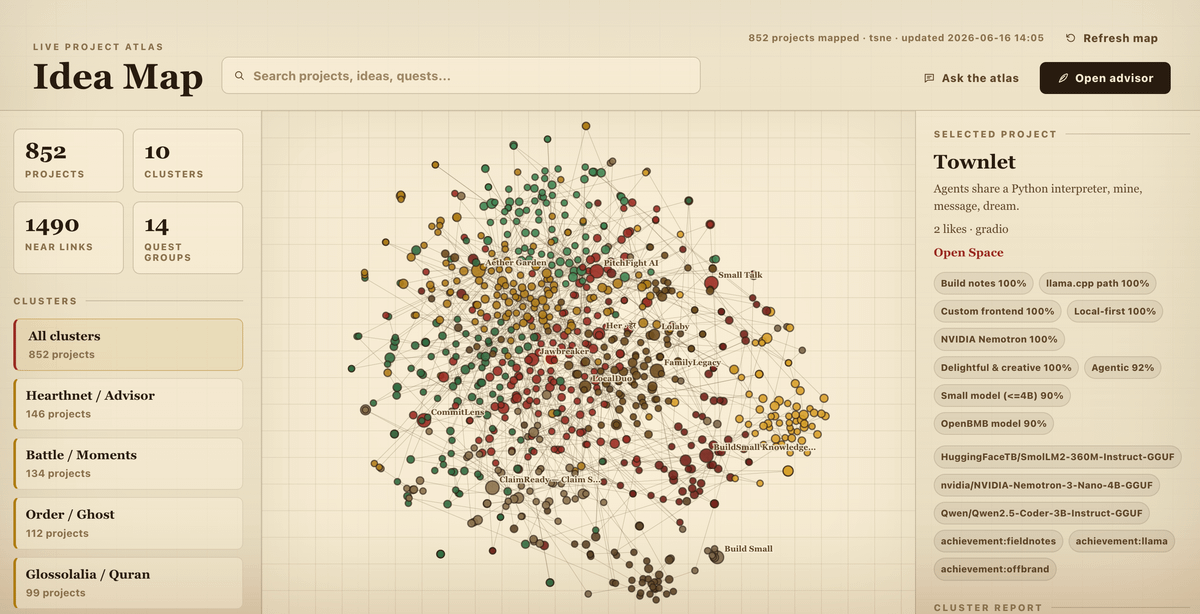
DịchNhà phát triển JacobLinCool đã tinh chỉnh MiniCPM5-1B bằng hai bộ LoRA để tạo ra trợ lý tư vấn sáng tạo và công cụ phân loại dự án thi đấu, chứng minh tiềm năng mạnh mẽ của các mô hình nhỏ khi được tối ưu hóa cho tác vụ cụ thể.
Bài viết cung cấp quy trình toàn diện từ xử lý luồng, lọc dữ liệu đến tinh chỉnh mô hình dựa trên bộ dữ liệu suy luận SupraLabs, giúp tối ưu hóa hiệu suất cho các mô hình AI tư duy.