Check out this week's updates and releases: - Gemini 3.8 Flash TTS and Gemini 3.8 Flash-Lite TTS, t…
DịchGoogle vừa giới thiệu bộ đôi mô hình Gemini 3.8 Flash TTS và Flash-Lite TTS chuyên về âm thanh, đồng thời ra mắt Gemini 3.8 Live tích hợp Avatar ảo cho trải nghiệm hội thoại trực quan.
Google vừa giới thiệu Gemini 3.8 Flash TTS và Gemini 3.8 Flash-Lite TTS, tối ưu hóa cho các tác vụ lồng tiếng sáng tạo và xử lý tự động hóa với tốc độ cao.
Google vừa giới thiệu hai mô hình chuyển văn bản thành giọng nói (TTS) mới là Gemini 3.8 Flash TTS và Flash-Lite TTS, hiện đã có sẵn trên Gemini API và Google AI Studio.
Google giới thiệu hai mô hình Gemini 3.8 Flash TTS và Flash-Lite TTS, chuyển đổi khả năng tạo giọng nói từ các thiết lập tĩnh sang môi trường studio tùy chỉnh linh hoạt.
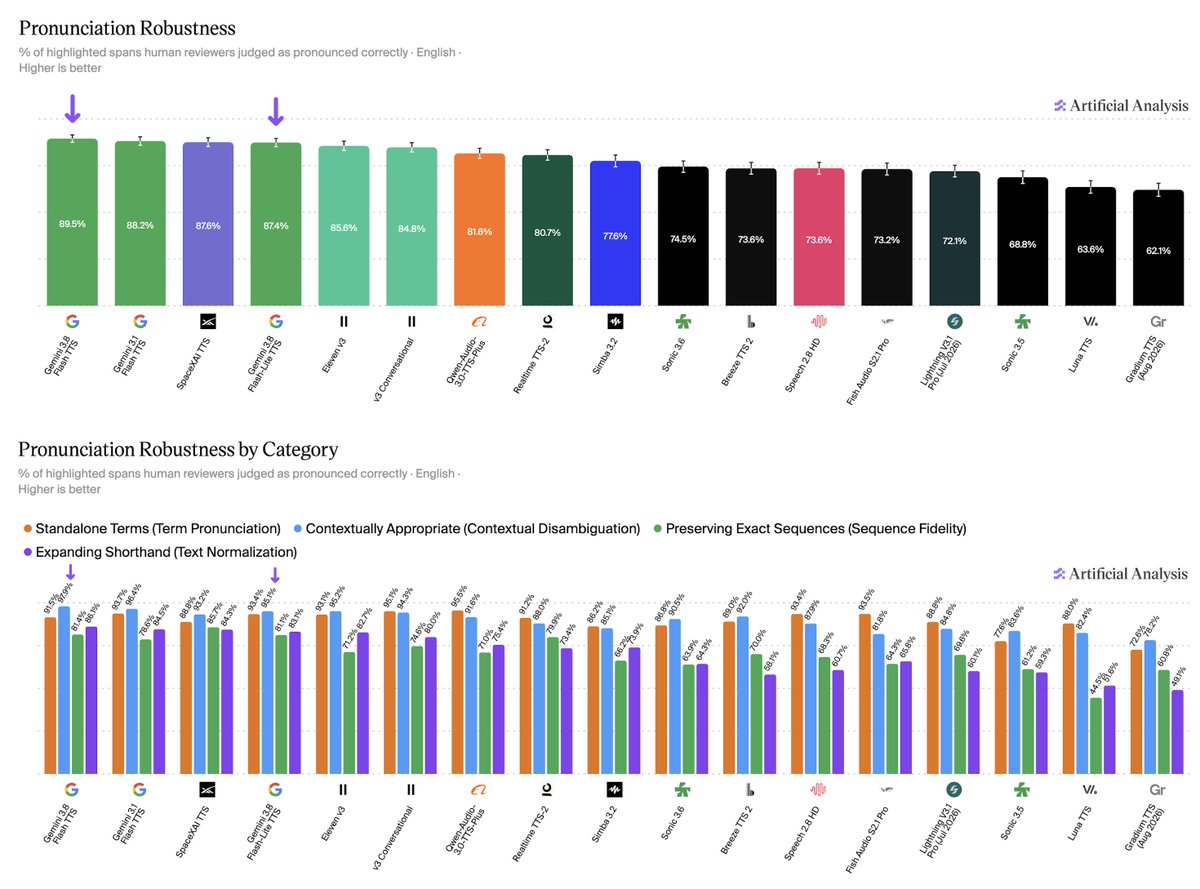
Gemini 3.8 Flash TTS takes the #1 spot on the Artificial Analysis Pronunciation Robustness benchmark…
DịchGemini 3.8 Flash TTS vừa chiếm lĩnh vị trí số 1 trên bảng xếp hạng Artificial Analysis với điểm số 89,5%, vượt qua các đối thủ như Gemini 3.1 Flash TTS và SpaceXAI TTS.
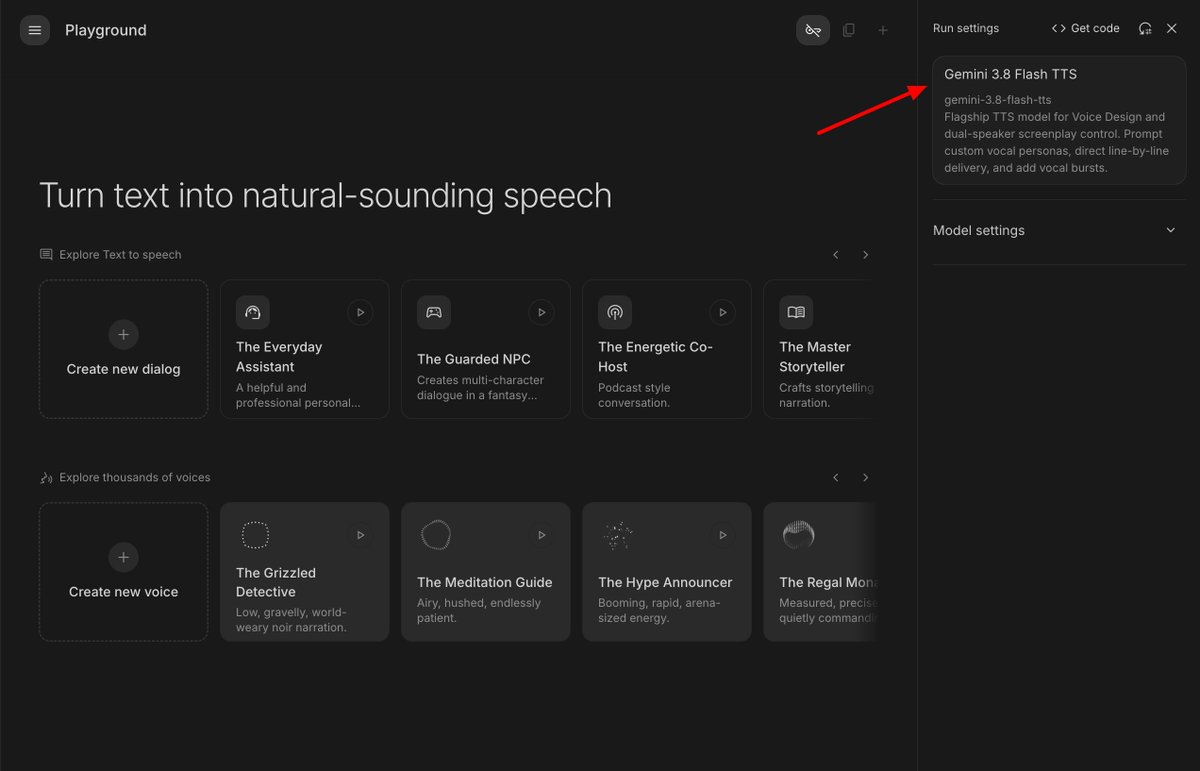
Google vừa giới thiệu bộ đôi mô hình Gemini 3.8 Flash TTS và Flash-Lite TTS, cho phép kiểm soát chi tiết từng dòng thoại với hỗ trợ hơn 100 ngôn ngữ và 2000 tùy chọn giọng nói có sẵn.
Mô hình chuyển văn bản thành giọng nói (TTS) mới vừa được trình làng, mang đến khả năng thiết kế giọng nói linh hoạt với thư viện hàng ngàn lựa chọn cho người dùng.
GOOGLE 🔥: Gemini 3.8 Flash TTS and Gemini 3.8 Flash-Lite TTS are now live on Google AI Studio and A…
DịchGoogle vừa giới thiệu Gemini 3.8 Flash TTS và Gemini 3.8 Flash-Lite TTS, được đánh giá là các mô hình tạo âm thanh biểu cảm nhất từ trước đến nay, hiện đã có mặt trên Google AI Studio và Gemini API.
Google DeepMind giới thiệu hai mô hình Gemini 3.8 Flash TTS và Flash-Lite TTS, hỗ trợ tạo giọng nói từ mô tả tự nhiên, sao chép mẫu âm thanh 30 giây và xử lý đa ngôn ngữ với khả năng điều khiển biểu cảm chuyên sâu.
Diễn biến sự kiện · 16 bài →Thêm 12 nguồn khác đưa tinX: Google AI (@GoogleAI)Artificial Intelligence News (Web)X: Testing Catalog (@testingcatalog)MarkTechPostHacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)The Decoder: AI NewsX: Artificial Analysis (@ArtificialAnlys)Simon Willison BlogX: Logan Kilpatrick (@OfficialLoganK)X: Ammaar Reshi (@ammaar)IT HomeX: Google DeepMind (@GoogleDeepMind)
Vì sao đáng đọc: Google đã giới thiệu chi tiết về khả năng, thứ hạng đánh giá và cổng truy cập của hai mô hình TTS. Các nhà phát triển có thể dựa vào đây để đánh giá và lựa chọn mô hình cho quy trình tạo giọng nói của mình.
Google has released Gemini 3.8 Flash TTS and Gemini 3.8 Flash-Lite TTS. Gemini 3.8 Flash TTS debuts …
DịchGoogle vừa giới thiệu hai mô hình chuyển đổi văn bản thành giọng nói (TTS) mới là Gemini 3.8 Flash TTS và Gemini 3.8 Flash-Lite TTS, hỗ trợ cả giọng đọc mặc định lẫn tính năng sao chép giọng nói cá nhân.
We're launching Gemini 3.8 Flash TTS and Gemini 3.8 Flash-Lite TTS ⚡️ Our most expressive audio mod…
DịchGoogle giới thiệu hai mô hình Gemini 3.8 Flash TTS và Gemini 3.8 Flash-Lite TTS, hỗ trợ hơn 100 ngôn ngữ với khả năng tùy chỉnh giọng nói linh hoạt, cho phép tạo ra hàng giờ âm thanh chất lượng cao, mượt mà và nhất quán.
⚡ Meet Qwen-Audio-3.1! ASR, TTS & Realtime are fully upgraded, joined by two new models: TTS-Next fo…
DịchQwen giới thiệu Qwen-Audio-3.1 với 5 mô hình mới, bổ sung TTS-Next và ASR-Next cùng khả năng tương tác thời gian thực thông minh. Đặc biệt, chi phí sử dụng được cắt giảm mạnh tới 95%, hỗ trợ nhận diện cảm xúc và phản hồi tự nhiên hơn.
Vì sao đáng đọc: Nhà phát hành công bố chi tiết năng lực của năm mô hình âm thanh cùng ba mức giảm giá, giúp độc giả đối chiếu với nhu cầu thực tế để đánh giá chi phí thay thế.
Alibaba vừa giới thiệu 5 mô hình thuộc dòng Qwen-Audio-3.1 bao gồm ASR, ASR-Next, TTS, TTS-Next và Realtime, hỗ trợ toàn diện từ nhận diện, tổng hợp giọng nói đến tương tác thời gian thực.
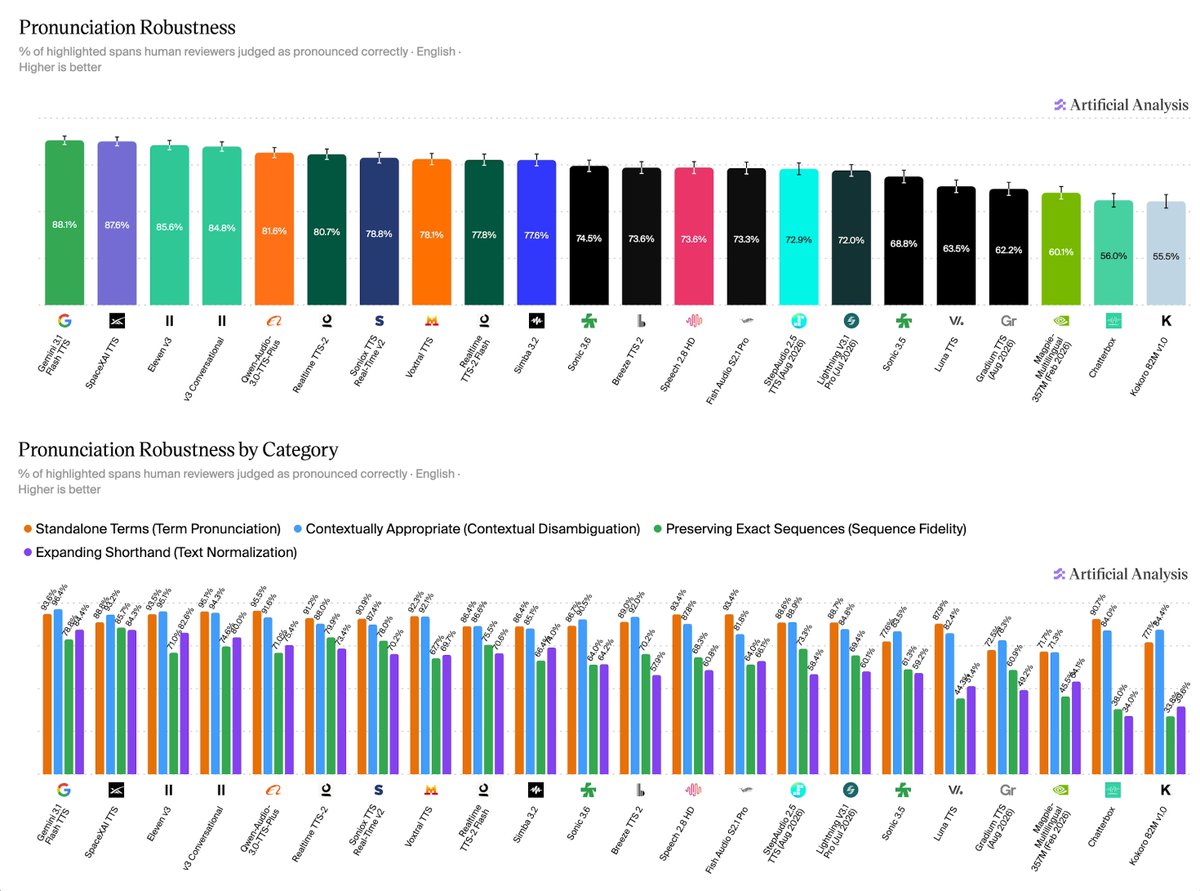
Announcing the Artificial Analysis Pronunciation Robustness benchmark, measuring how reliably Text t…
DịchArtificial Analysis vừa ra mắt bộ tiêu chuẩn đánh giá khả năng phát âm của các mô hình TTS. Google Gemini 3.1 Flash dẫn đầu với tỷ lệ chính xác 88,1%, theo sau là SpaceXAI và ElevenLabs.
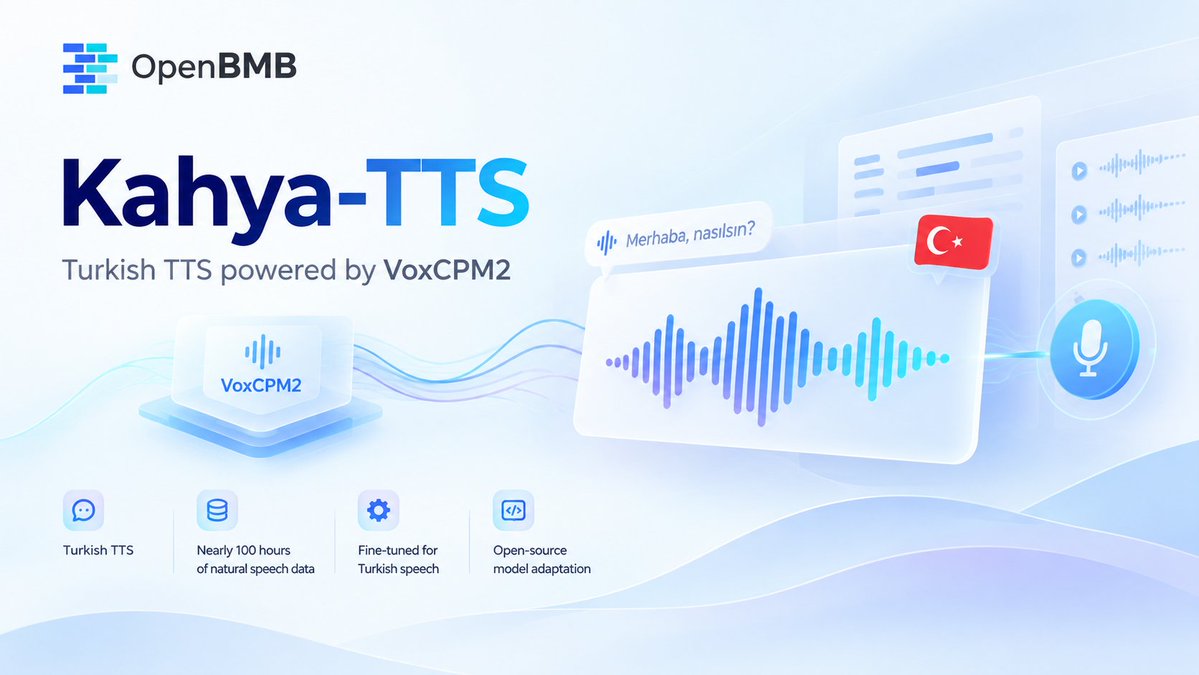
DịchNhà phát triển AlicanKiraz0 đã ra mắt Kahya-TTS, một mô hình chuyển văn bản thành giọng nói được tinh chỉnh từ VoxCPM2 bằng 100 giờ dữ liệu tiếng Thổ Nhĩ Kỳ, hiện đã có mã nguồn mở trên Hugging Face.
🇹🇷🎙️ Kahya-TTS is live - a great example of fine-tuning VoxCPM2 with ~100 hours of natural Turkis…
DịchKahya-TTS là mô hình TTS tiếng Thổ Nhĩ Kỳ được tinh chỉnh từ VoxCPM2 với 100 giờ dữ liệu giọng nói tự nhiên, mang lại chất lượng âm thanh vượt trội cho cộng đồng mã nguồn mở.
Nghiên cứu đề xuất phương pháp huấn luyện mô hình TTS nhỏ gọn bằng cách sử dụng mô hình sao chép giọng nói lớn làm nguồn dữ liệu tổng hợp, giúp tối ưu hóa hiệu năng cho các ngôn ngữ ít tài nguyên như tiếng Thái.
DeepSeek đang triển khai thử nghiệm tính năng trò chuyện bằng giọng nói trực tiếp trên ứng dụng, cho phép người dùng lựa chọn giữa 4 giọng đọc AI khác nhau gồm Beike, Bailang, Haixing và Anchao.
StepAudio 3 Gen là mô hình tạo âm thanh đa năng sử dụng kiến trúc tự hồi quy rời rạc thay vì khuếch tán, hỗ trợ toàn diện từ chuyển văn bản thành giọng nói, thiết kế âm thanh đến tạo nhạc trong một khung duy nhất.
ICYMI 👀: DeepSeek mobile app has 4 different voices for you to select from, for its read-aloud feat…
DịchDeepSeek vừa bổ sung tính năng đọc văn bản (TTS) trên ứng dụng di động với 4 tông giọng khác nhau. Đây có thể là bước đệm cho việc ra mắt mô hình TTS chuyên biệt của hãng trong tương lai gần.
OpenRouter cung cấp dịch vụ chuyển văn bản thành giọng nói (TTS) thông qua endpoint tương thích với OpenAI, cho phép bạn truy cập nhiều mô hình từ các nhà cung cấp khác nhau chỉ với một API key duy nhất.
🚀 AuK is officially here. Nano banana🍌 for audio An open-source foundation model for unified spee…
DịchTencent Hunyuan giới thiệu AuK, mô hình nền tảng hỗ trợ tạo và chỉnh sửa giọng nói đa năng từ văn bản và âm thanh mẫu, cùng phiên bản AuK-Flash tối ưu hóa với tốc độ suy luận chỉ trong 4 bước.
I usually scroll past benchmark posts because they're self-reported. This one isn't: Voice Arena mea…
DịchVoice Arena vừa thực hiện kiểm thử thực tế trên 10 mô hình TTS, trong đó Gradium đạt tốc độ phản hồi nhanh nhất với độ trễ p50 là 231ms. Kết quả này được đánh giá cao nhờ tính minh bạch và dữ liệu thực tế thay vì chỉ dựa trên thông số công bố từ nhà phát triển.
Mô hình VoxCPM đang được tinh chỉnh để tối ưu hóa khả năng phát âm tiếng Thổ Nhĩ Kỳ, mang lại chất lượng giọng nói giàu cảm xúc và tự nhiên hơn thông qua dự án Kahya-TTS.
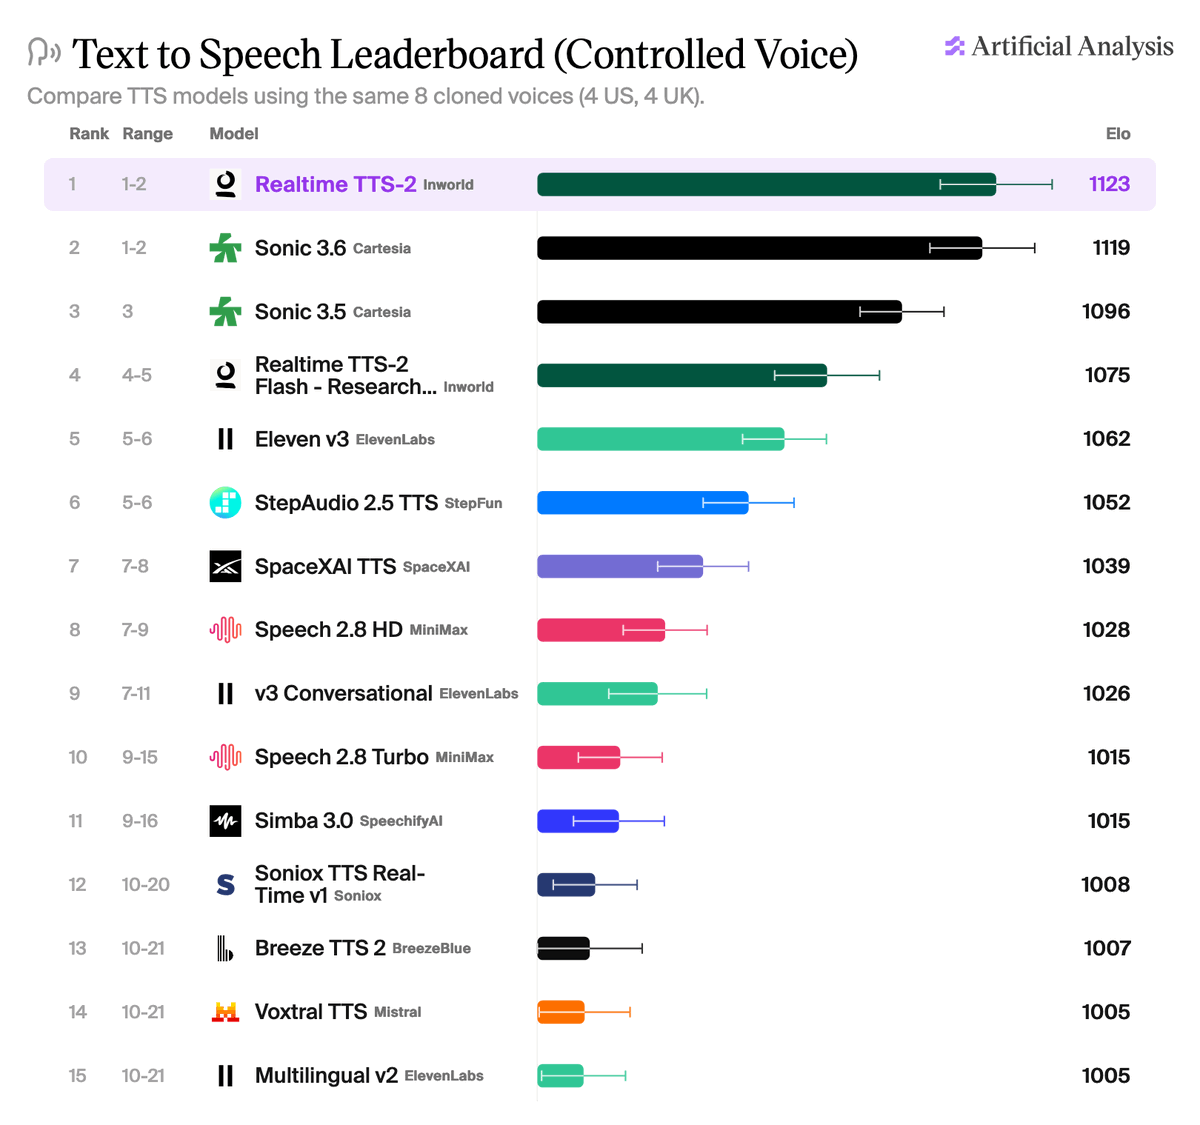
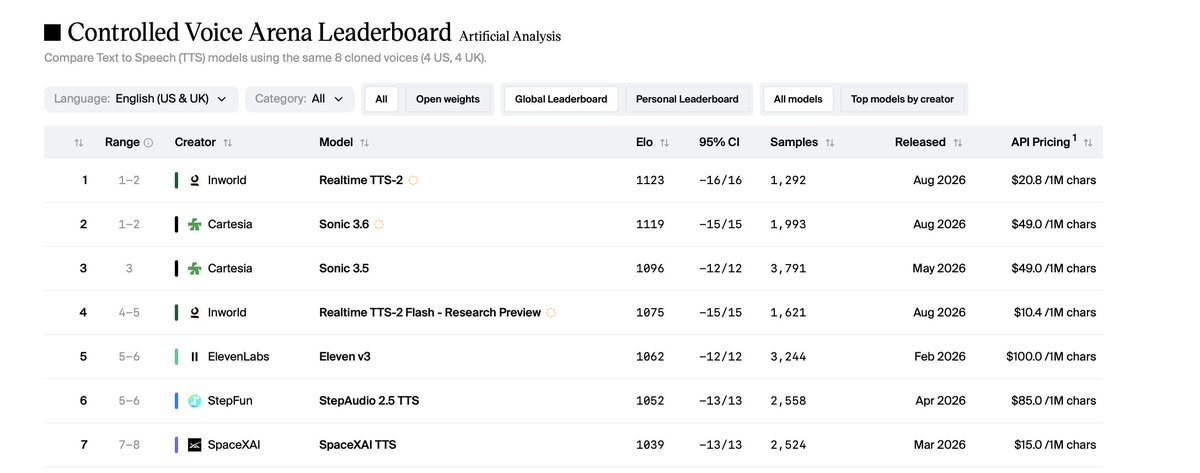
Inworld's newly released Realtime TTS-2 is the new #1 on the Artificial Analysis Controlled Voice Ar…
DịchMô hình Realtime TTS-2 mới của Inworld vừa đạt 1.123 điểm Elo, vượt qua Cartesia Sonic 3.6 để dẫn đầu bảng xếp hạng Controlled Voice Arena và giữ vị trí thứ hai trong Provider Voice Arena.
Inworld has released Realtime TTS-2, focused on clarity, and TTS-2 Flash, built for low latency and …
DịchInworld vừa giới thiệu bộ đôi TTS-2 và TTS-2 Flash với khả năng sao chép giọng nói siêu tốc chỉ trong 5-15 giây, hỗ trợ đọc chính xác các mã số phức tạp và tối ưu độ trễ thấp.
Inworld's Realtime TTS-2 is now generally available and currently ranks #1 in Artificial Analysis' C…
DịchInworld chính thức phát hành Realtime TTS-2, mô hình được đánh giá nhanh nhất phân khúc trên Artificial Analysis. Người dùng có thể tùy chỉnh cảm xúc và ngữ điệu linh hoạt thông qua mô tả văn bản, dựa trên những phản hồi tích cực từ phiên bản thử nghiệm trước đó.
Gradium AI vừa cập nhật mô hình chuyển đổi văn bản thành giọng nói (TTS) mặc định cho nền tảng, giúp cải thiện đáng kể tốc độ phản hồi và độ chính xác mà không làm gián đoạn các giọng nói tùy chỉnh hiện có của người dùng.
Breeze TTS 2 is now the leading Open Weights TTS model in the Artificial Analysis Provider Voices Sp…
DịchBreeze TTS 2 vừa vươn lên dẫn đầu các mô hình TTS mã nguồn mở trên bảng xếp hạng Artificial Analysis với 1.215 điểm Elo, vượt xa Fish Audio S2 Pro tới 90 điểm.
Nari Labs vừa ra mắt dịch vụ mô hình đa phương thức thời gian thực, đạt tốc độ phản hồi âm thanh đầu tiên (TTFA) chỉ trong 50ms, mang lại trải nghiệm hội thoại tự nhiên cho các trợ lý ảo.
FireRedTTS3 tích hợp khả năng sao chép giọng nói zero-shot, thiết kế âm thanh qua mô tả văn bản và chỉnh sửa giọng nói chính xác trong một mô hình duy nhất, đạt hiệu suất dẫn đầu ngành trên nhiều bảng xếp hạng.
Vì sao đáng đọc: Đây là bước tiến đột phá trong công nghệ TTS khi hợp nhất ba tác vụ phức tạp vào một mô hình, có tính ứng dụng thực tế cao và hiệu suất vượt trội so với các đối thủ hiện nay.
Cartesia vừa trình làng Sonic-3.6, mô hình TTS đạt độ trễ dưới 90ms và vượt qua ElevenLabs để chiếm lĩnh vị trí số 1 trên bảng xếp hạng Artificial Analysis.
Alibaba chính thức đưa Qwen-Audio-3.0 lên nền tảng Qwen và Bailian. Dòng mô hình này bao gồm ASR, TTS và tương tác thời gian thực, hiện đang giữ vị trí số 1 thế giới trên bảng xếp hạng Artificial Analysis.
Đội ngũ dots của Xiaohongshu vừa công bố mô hình tổng hợp giọng nói (TTS) end-to-end với 2 tỷ tham số, đạt hiệu suất vượt trội về độ chính xác nội dung và khả năng mô phỏng giọng nói trên bộ đánh giá Seed-TTS-Eval.
Vì sao đáng đọc: Đây là bước tiến đáng chú ý trong lĩnh vực TTS mã nguồn mở, mang lại hiệu năng cạnh tranh cao và giá trị thực tiễn cho cộng đồng phát triển AI.
Dots.tts là mô hình TTS 2 tỷ tham số sử dụng cơ chế tự hồi quy trong không gian ẩn liên tục, loại bỏ hoàn toàn token rời rạc để đạt độ chính xác và tính tự nhiên vượt trội, đồng thời hỗ trợ mạnh mẽ cho các tác vụ chỉnh sửa giọng nói.
Thêm 1 nguồn khác đưa tinWeChat: Xiaohongshu Tech (dots.llm)
Vì sao đáng đọc: Đây là bước tiến kỹ thuật quan trọng trong lĩnh vực TTS, giải quyết hạn chế của token rời rạc. Việc mã nguồn mở hoàn toàn cùng hiệu suất SOTA khiến nó trở thành tin tức giá trị.
Soniox TTS v2 is one of those models you need to actually hear. They just launched TTS v2, a text-t…
DịchSoniox vừa trình làng mô hình TTS v2 với khả năng hỗ trợ đa ngôn ngữ, tích hợp tính năng cảm xúc và sao chép giọng nói, tối ưu cho các tác nhân AI thời gian thực với mức giá chỉ 0,7 USD/giờ.
I wasn't expecting Soniox TTS v2 (a text-to-speech model) to sound this natural. They just released…
DịchSoniox giới thiệu mô hình TTS v2 hỗ trợ hơn 60 ngôn ngữ với chi phí chỉ 0,7 USD/giờ. Công nghệ này tối ưu cho AI agent nhờ khả năng phản hồi thời gian thực, độ trễ thấp và tính năng sao chép giọng nói trung thực.
 Google AI@GoogleAI