StepFun has released StepAudio 3 ASR, ranking #1 on the AA-WER Index for non-streaming Speech to Tex…
DịchStepFun vừa ra mắt StepAudio 3 ASR, đạt tỷ lệ lỗi từ (WER) chỉ 1,7% trên bảng xếp hạng của Artificial Analysis, vượt xa thành tích 4,7% của phiên bản tiền nhiệm.
Bản tin tổng hợp 10 sự kiện AI nổi bật, tiêu điểm là StepAudio 3 của StepFun với khả năng xử lý âm thanh toàn diện, hiện đang dẫn đầu bảng xếp hạng Artificial Analysis.
StepFun and ACE Studio present StepAudio 3 Music, StepFun's first music generation foundation model …
DịchStepAudio 3 Music là mô hình tạo nhạc nền tảng đầu tiên của StepFun, cho phép tạo bài hát hoàn chỉnh từ lời và gợi ý. Với công nghệ ABC-COT, người dùng có thể tùy chỉnh cấu trúc nhạc, biên tập ký âm và chuyển đổi giọng hát một cách linh hoạt.
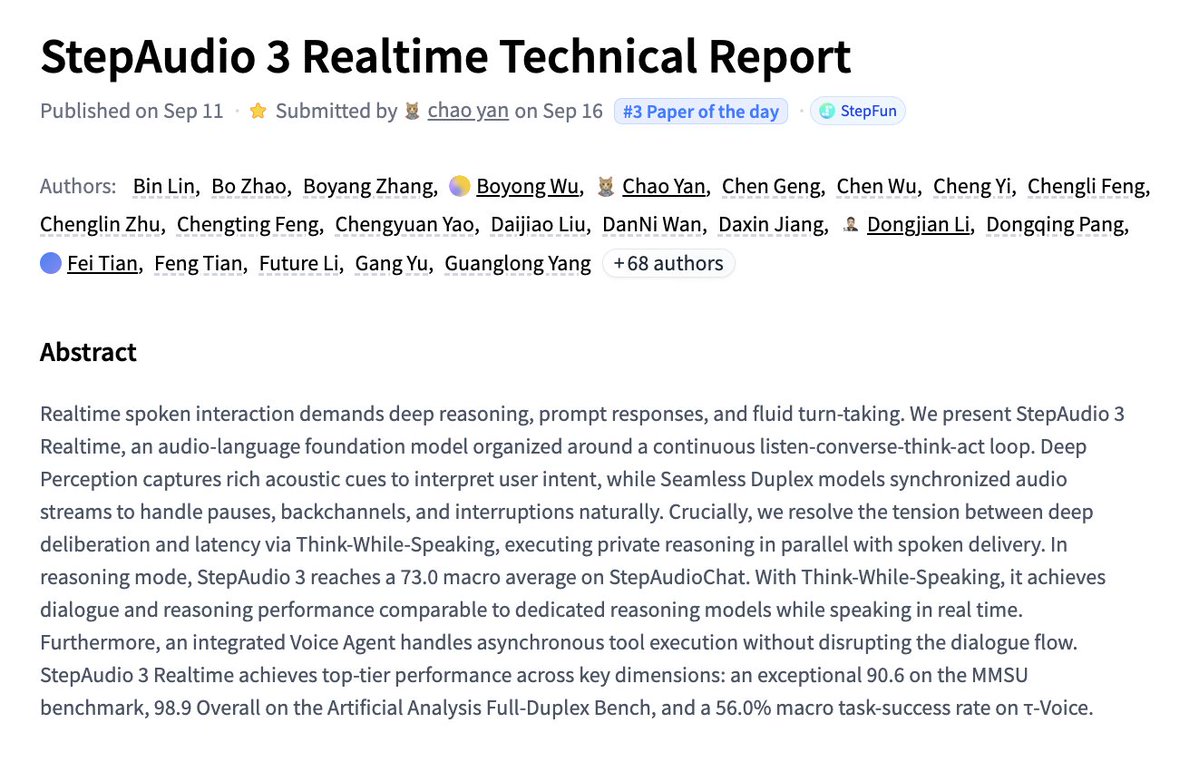
DịchBáo cáo kỹ thuật giới thiệu StepAudio 3 Realtime, mô hình mới tập trung vào khả năng xử lý âm thanh thời gian thực với độ trễ thấp và chất lượng vượt trội.
StepAudio 3 Music là mô hình tạo nhạc quy mô lớn, sử dụng kiến trúc Diffusion Transformer kết hợp lập kế hoạch bằng ký hiệu ABC để kiểm soát chặt chẽ cấu trúc, hòa âm và nhịp điệu của bản nhạc.
Introducing StepAudio 3, our new family of 5 audio models for real-time voice, speech recognition, s…
DịchStepFun vừa trình làng bộ 5 mô hình StepAudio 3, dẫn đầu bảng xếp hạng Artificial Analysis về khả năng hội thoại và suy luận giọng nói, đồng thời đạt tỷ lệ lỗi nhận diện (ASR) cực thấp chỉ 1,7%.
Diễn biến sự kiện · 6 bài →Thêm 3 nguồn khác đưa tinX: Hongming (@hongming731)X: StepFun (@StepFun_ai)IT Home
Vì sao đáng đọc: Sự kiện quan trọng khi một mô hình AI nội địa đạt thứ hạng cao trên bảng xếp hạng quốc tế uy tín, thu hút sự quan tâm lớn từ cộng đồng công nghệ.
We're bringing StepAudio 3 to San Francisco this Wednesday. Live demos, an open AMA with the StepAud…
DịchStepFun mang StepAudio 3 đến San Francisco vào ngày 16/9 với các buổi demo trực tiếp, tọa đàm cùng chuyên gia về tương lai của AI thời gian thực và các giải pháp thực tế trong sản xuất.
StepAudio 3 Gen là mô hình tạo âm thanh đa năng sử dụng kiến trúc tự hồi quy rời rạc thay vì khuếch tán, hỗ trợ toàn diện từ chuyển văn bản thành giọng nói, thiết kế âm thanh đến tạo nhạc trong một khung duy nhất.
 Artificial Analysis@ArtificialAnlys