Mô hình
Google ra mắt Gemini 3.8 Flash TTS và Flash-Lite TTS, hỗ trợ thiết kế giọng nói qua prompt
(giờ Việt Nam)
Tóm tắt AI
Google vừa giới thiệu hai mô hình chuyển văn bản thành giọng nói (TTS) mới là Gemini 3.8 Flash TTS và Flash-Lite TTS, hiện đã có sẵn trên Gemini API và Google AI Studio.
Chính văn · Bản dịch AI
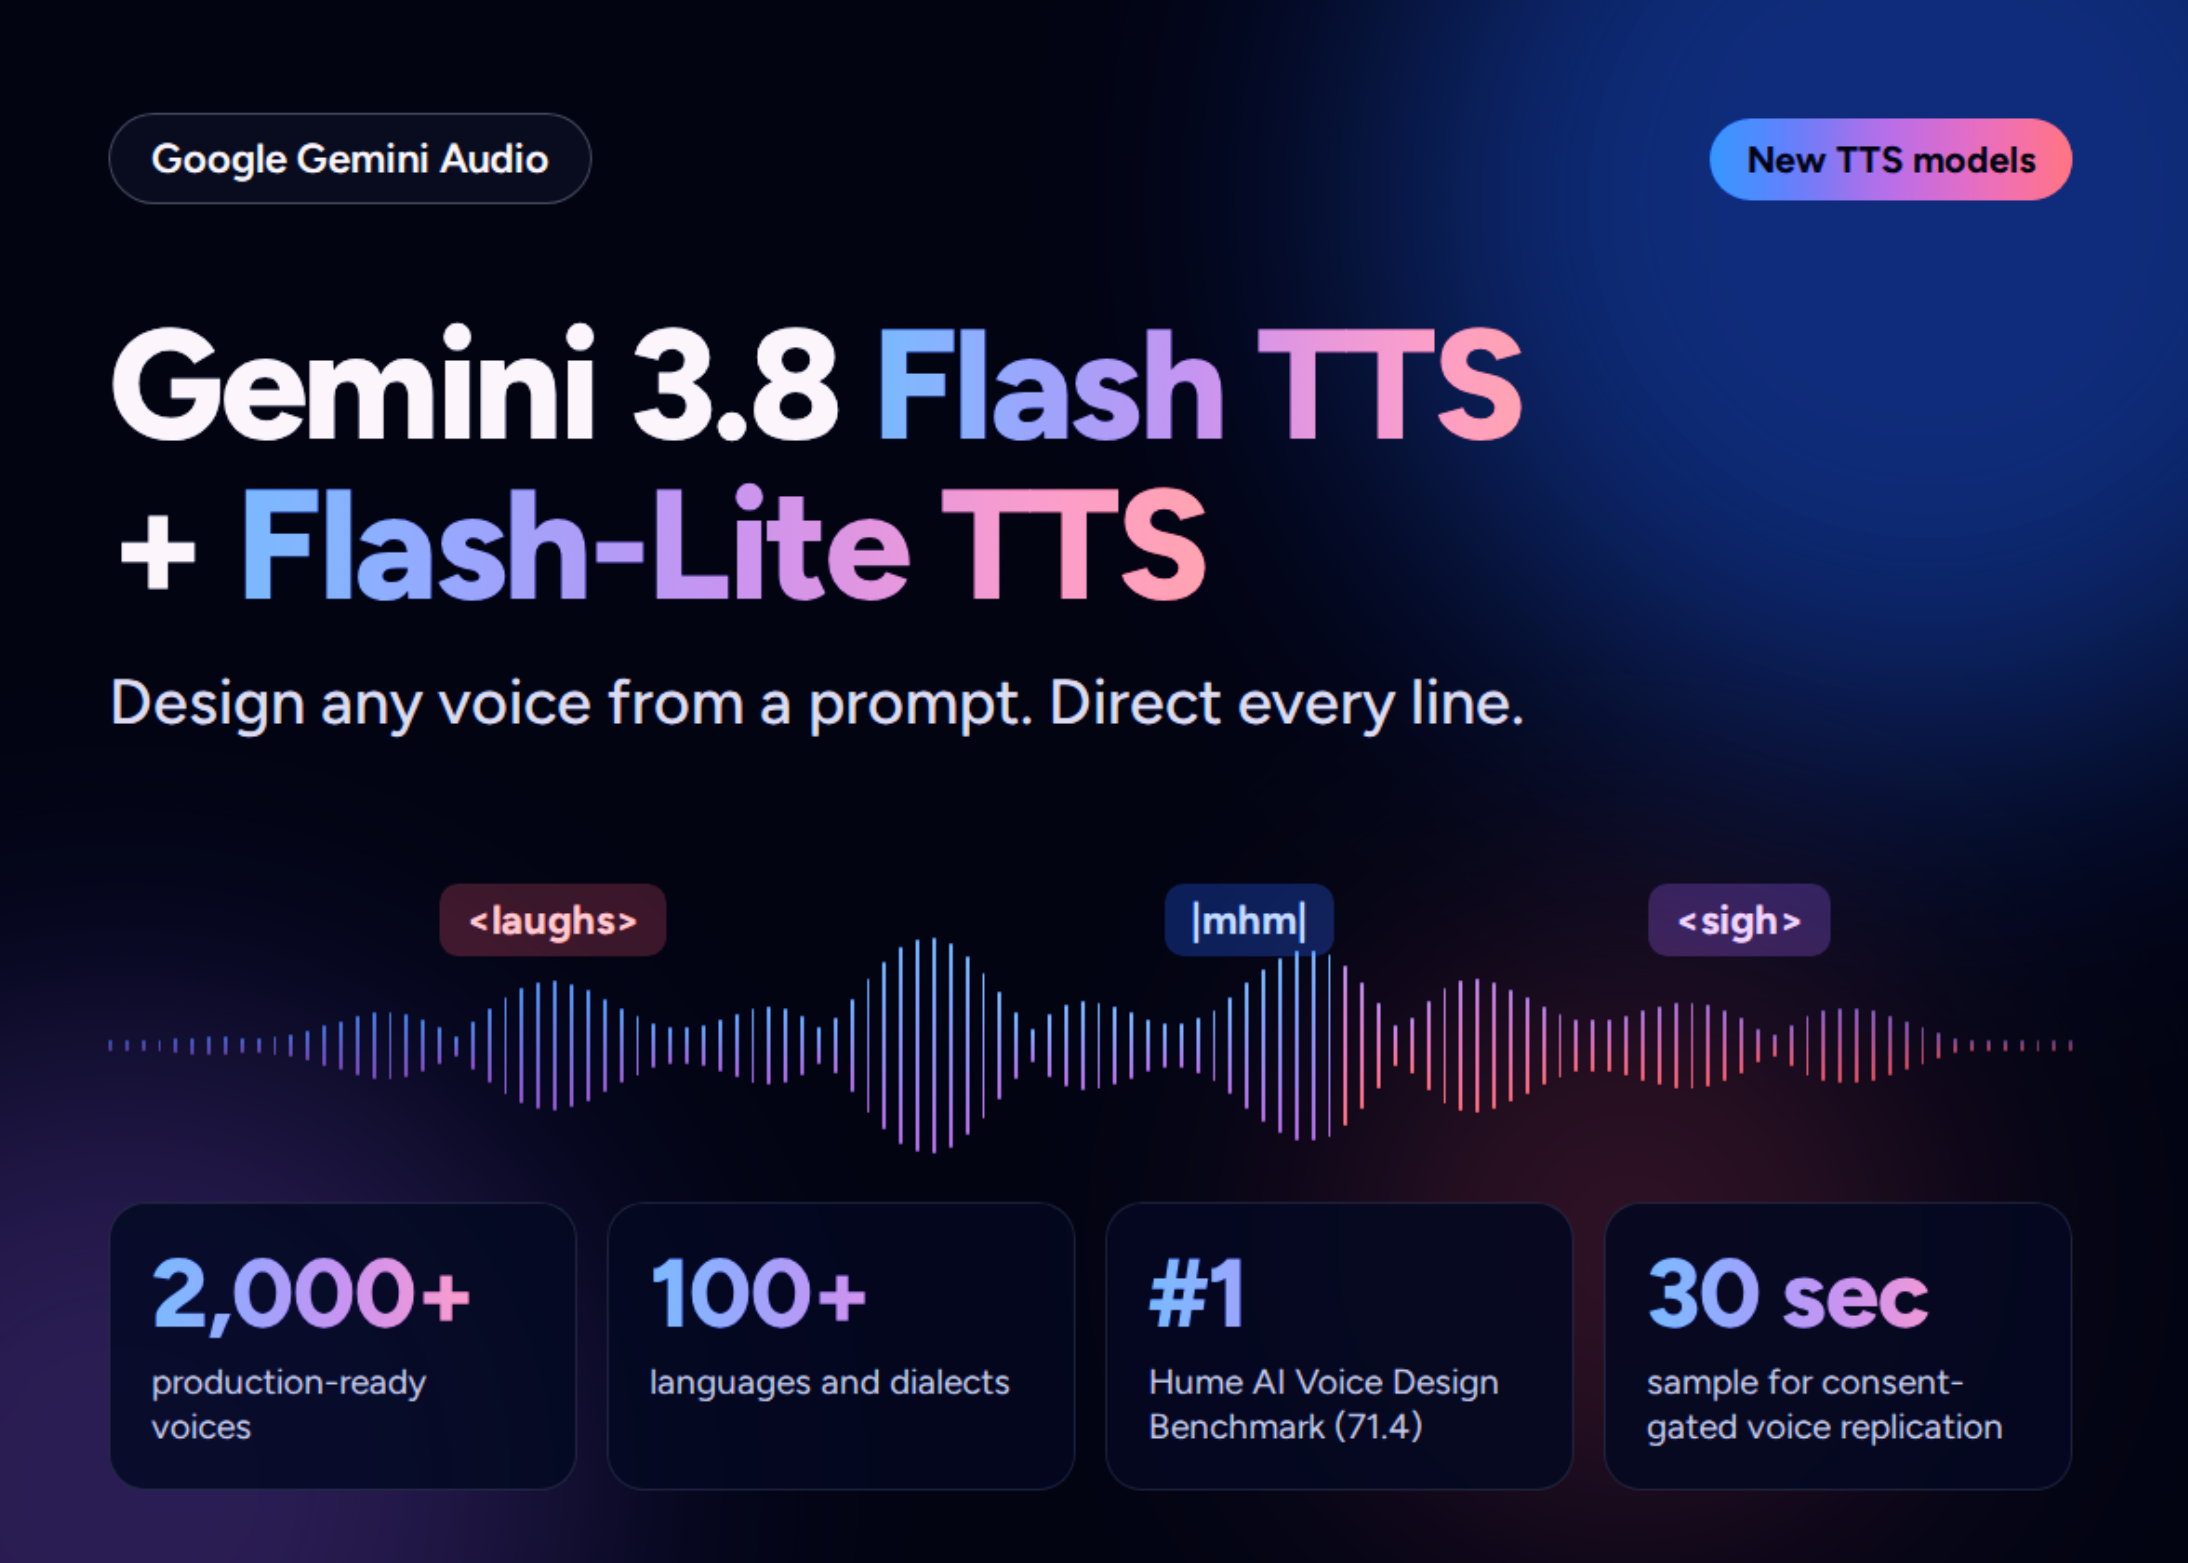
Google đã phát hành Gemini 3.8 Flash TTS và Gemini 3.8 Flash-Lite TTS, 2 mô hình chuyển văn bản thành giọng nói mới trong dòng sản phẩm Gemini Audio. Google gọi đây là những mô hình tạo âm thanh biểu cảm nhất của hãng từ trước đến nay. Flash TTS hướng tới mục tiêu chỉ đạo sáng tạo và giọng nói nhân vật. Flash-Lite TTS hướng tới mục tiêu sản xuất quy mô lớn, tiết kiệm chi phí. Cả hai đều cho phép các nhà phát triển điều khiển cách đọc từng dòng bằng ngôn ngữ tự nhiên.
Có thể triển khai được không? Có, cả hai mô hình hiện đang được triển khai thông qua Gemini API và Google AI Studio. Quyền truy cập chỉ thông qua API, không có mã nguồn mở để tự lưu trữ. Quyền truy cập API doanh nghiệp thông qua Gemini Enterprise được liệt kê là sẽ sớm ra mắt.
Những gì Google đã phát hành
Bản phát hành chia TTS thành 2 cấp độ với các tùy chọn điều khiển chung:
- Gemini 3.8 Flash TTS được xây dựng để chỉ đạo sáng tạo chuyên sâu và thiết kế nhân vật. Các mục tiêu sử dụng bao gồm trò chơi, sách nói nhập vai, podcast và phương tiện tương tác. Nó cung cấp khả năng kiểm soát chi tiết các tín hiệu diễn xuất, nhịp độ, thay đổi phương ngữ và phản hồi hội thoại.
- Gemini 3.8 Flash-Lite TTS được xây dựng cho quy mô lớn, tiết kiệm chi phí. Google định vị nó cho việc lồng tiếng, tạo nội dung âm thanh và các tác nhân giọng nói biểu cảm. Nó cung cấp khả năng kiểm soát tinh vi về tông giọng, nhịp độ và sắc thái biểu cảm.
Trong AI Studio, các liên kết playground sử dụng định danh mô hình gemini-3.8-flash-tts và gemini-3.8-flash-lite-tts.
Thiết kế giọng nói từ văn bản gợi ý (Prompt)
Các phiên bản Gemini TTS trước đây cung cấp 30 giọng nói gốc. Bản phát hành 3.8 chuyển sang một hệ thống giọng nói lớn hơn nhiều.
- Thiết kế giọng nói tạo sinh: Flash TTS tạo ra các giọng nói mới từ các gợi ý mô tả vai trò, giọng địa phương và đặc điểm giọng nói. Tính năng này hoạt động trên hơn 100 ngôn ngữ và phương ngữ. Các bản demo của Google bao gồm một DJ ở Melbourne, một robot giọng đơn điệu và một con rồng Nhật Bản.
- Thư viện giọng nói: Các nhà phát triển có hơn 2.000 giọng nói sẵn sàng để sản xuất. Phạm vi bao gồm các biến thể khu vực như tiếng Tây Ban Nha Mexico, tiếng Pháp Quebec và tiếng Anh Scotland.
- Lưu và mở rộng: Các giọng nói tùy chỉnh có thể được lưu và tái sử dụng, với độ lệch tối thiểu giữa các dự án.
- Phối lại giọng nói (sắp ra mắt): Người dùng sẽ điều chỉnh âm sắc, cao độ, nhịp độ và giọng địa phương của một giọng nói trong thư viện thông qua các gợi ý.
Chỉ đạo diễn xuất
Cả hai mô hình đều chấp nhận các chỉ dẫn sân khấu được viết trong kịch bản. Gemini cũng có thể điều hướng cách đọc từ các tín hiệu kịch bản tự nhiên.
- Tạo nội dung dài: Chất lượng giọng nói, nhịp độ và âm sắc được duy trì trong nhiều giờ âm thanh liên tục.
- Dàn dựng 2 người nói tự nhiên: Một kịch bản duy nhất điều khiển cuộc hội thoại nhiều lượt với các giọng nói riêng biệt, tách biệt.
- Các âm thanh cảm xúc: Các tín hiệu phi ngôn ngữ như <cười>, <thở dài> và <gasp> (hít hơi) tạo thêm kết cấu hội thoại.
- Phản hồi hội thoại: Các từ đệm lắng nghe chủ động như |mhm| và |yeah| kiểm soát nhịp phản ứng và thời điểm hài hước.
Sao chép giọng nói và Kiểm soát an toàn
Sao chép giọng nói xây dựng một hồ sơ giọng nói nhất quán từ mẫu âm thanh 30 giây. Mẫu này phải là giọng của bạn hoặc giọng bạn có quyền sử dụng. Việc sao chép yêu cầu bản ghi âm đồng ý bằng lời nói từ chủ sở hữu giọng nói, được đối chiếu với người nói tham chiếu.
Mọi clip từ các mô hình Gemini Audio đều mang hình mờ SynthID. Dấu hiệu không thể nhận thấy này được nhúng trực tiếp vào đầu ra âm thanh. Các giọng nói được sao chép cũng mang thông tin xác thực nội dung C2PA. Google chỉ dẫn đến thẻ mô hình Gemini 3.8 Audio để biết cách tiếp cận an toàn rộng hơn.
Kết quả đánh giá (Benchmark)
Google báo cáo các kết quả sau cho các mô hình mới:
- Hume AI Voice Design Benchmark: Flash TTS xếp hạng #1 tổng thể với số điểm 71,4, theo Hume AI.
- Mô hình hóa giọng địa phương: Flash TTS dẫn đầu với số điểm 60,8.
- Chỉ số chất lượng tổng thể Hume AI: Flash TTS xếp hạng #1 và Flash-Lite TTS xếp hạng #2.
- Voice Arena (đánh giá mù): Cả hai mô hình đều chiếm vị trí hàng đầu trong tiếng Nhật, tiếng Bồ Đào Nha Brazil, tiếng Việt, tiếng Ả Rập chuẩn hiện đại, tiếng Tây Ban Nha Mexico và tiếng Hindi.
Những điểm chính
- Google đã ra mắt Gemini 3.8 Flash TTS cho công việc sáng tạo và Flash-Lite TTS cho quy mô lớn.
- Flash TTS thiết kế giọng nói mới từ các gợi ý trên hơn 100 ngôn ngữ và phương ngữ.
- Các nhà phát triển có hơn 2.000 giọng nói sản xuất, tăng từ 30 giọng gốc.
- Sao chép giọng nói cần mẫu 30 giây cộng với bản ghi âm đồng ý khớp với mẫu.
- Flash TTS xếp hạng #1 trên Hume AI’s Voice Design Benchmark với 71,4 điểm.
Câu hỏi thường gặp (FAQ)
- Gemini 3.8 Flash TTS là gì? Đây là mô hình chuyển văn bản thành giọng nói của Google dành cho thiết kế giọng nói sáng tạo và chỉ đạo diễn xuất từng dòng. Nó có sẵn thông qua Gemini API và Google AI Studio.
- Flash-Lite TTS khác biệt như thế nào? Flash-Lite TTS được tối ưu hóa cho khối lượng công việc lớn, tiết kiệm chi phí như lồng tiếng và các tác nhân giọng nói. Nó xếp hạng #2 trên Chỉ số chất lượng tổng thể của Hume AI.
- Tôi có thể sao chép giọng nói của chính mình không? Có, với mẫu 30 giây và bản ghi âm đồng ý bằng lời nói. Tính năng này không khả dụng trong AI Studio ở một số khu vực, bao gồm Vương quốc Anh, EEA và Ấn Độ.
Hãy xem Blog Kỹ thuật. Mọi tín dụng thuộc về các nhà nghiên cứu của dự án này. Ngoài ra, hãy thoải mái theo dõi chúng tôi trên Twitter và đừng quên tham gia SubReddit 150k+ ML của chúng tôi và Đăng ký bản tin của chúng tôi. Khoan đã! Bạn có dùng Telegram không? bây giờ bạn cũng có thể tham gia cùng chúng tôi trên Telegram.
Cần hợp tác với chúng tôi để quảng bá GitHub Repo HOẶC trang Hugging Face HOẶC Bản phát hành sản phẩm HOẶC Hội thảo trên web, v.v.? Kết nối với chúng tôi

Asif Razzaq
Asif Razzaq là CEO của Marktechpost AI Media Inc.. Là một doanh nhân và kỹ sư có tầm nhìn, Asif cam kết khai thác tiềm năng của Trí tuệ nhân tạo vì lợi ích xã hội. Nỗ lực gần đây nhất của ông là ra mắt Nền tảng truyền thông Trí tuệ nhân tạo, Marktechpost, nổi bật với việc đưa tin chuyên sâu về tin tức học máy và học sâu, vừa đảm bảo tính kỹ thuật vừa dễ hiểu đối với đông đảo khán giả. Nền tảng này tự hào có hơn 2 triệu lượt xem hàng tháng, minh chứng cho sự phổ biến của nó đối với khán giả.
Bài viết được AI dịch và tổng hợp tự động từ MarkTechPost. Liên kết bài gốc ở phía trên. Dữ liệu đồng bộ qua API công khai được ghi nguồn tại AI HOT (canonical) ↗. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.