Mô hình
Google DeepMind ra mắt Gemini 3.8 Flash TTS và Flash-Lite TTS: Đột phá công nghệ chuyển văn bản thành giọng nói
(giờ Việt Nam)
Tóm tắt AI
Google DeepMind giới thiệu hai mô hình Gemini 3.8 Flash TTS và Flash-Lite TTS, hỗ trợ tạo giọng nói từ mô tả tự nhiên, sao chép mẫu âm thanh 30 giây và xử lý đa ngôn ngữ với khả năng điều khiển biểu cảm chuyên sâu.
Chính văn · Bản dịch AI

23 tháng 9, 2026
Gemini 3.8 Flash TTS và Gemini 3.8 Flash-Lite TTS là những mô hình tạo âm thanh biểu cảm nhất của chúng tôi từ trước đến nay. Hãy tạo giọng nói nhân vật tùy chỉnh và đạo diễn lời thoại cho phân cảnh trên Google AI Studio, Gemini API, Gemini Enterprise, Gemini Notebook và Google Vids.
Leland Rechis
Giám đốc Sản phẩm Nhóm
Alan Cowen
Giám đốc, Khoa học Nghiên cứu, thay mặt cho Nhóm Âm thanh Gemini
Hôm nay, chúng tôi giới thiệu hai mô hình chuyển văn bản thành giọng nói (text-to-speech) mới cho gia đình Gemini, biến việc tạo giọng nói từ các cài đặt sẵn tĩnh thành một studio sáng tạo năng động. Các mô hình này cho phép người sáng tạo, nhà phát triển và doanh nghiệp tạo ra trải nghiệm âm thanh phong phú, biểu cảm hơn, đồng thời cải thiện trải nghiệm người dùng trong các sản phẩm như Gemini Notebook và Google Vids.
- Gemini 3.8 Flash TTS: Được xây dựng để định hướng sáng tạo chuyên sâu và thiết kế nhân vật. Tạo ra những giọng nói hoàn toàn mới từ đầu bằng cách sử dụng các câu lệnh ngôn ngữ tự nhiên để thổi hồn vào các nhân vật trong trò chơi, sách nói nhập vai, podcast và phương tiện tương tác. Đạo diễn từng câu thoại với khả năng kiểm soát chi tiết về các gợi ý diễn xuất, nhịp độ, sự thay đổi phương ngữ và các phản hồi đệm.
- Gemini 3.8 Flash-Lite TTS: Được xây dựng cho quy mô lớn với chi phí tối ưu. Tối ưu hóa cho việc lồng tiếng số lượng lớn, tạo nội dung âm thanh và các tác nhân giọng nói biểu cảm với khả năng kiểm soát tinh vi về tông giọng, nhịp độ và sắc thái biểu cảm.
Các mô hình này bổ sung vào gia đình Gemini Audio đang phát triển nhanh chóng của chúng tôi, tiếp nối 3.5 Live Translate, 3.5 Transcribe, 3.8 Live, và 3.8 Live Extended Thinking.
Tạo và tùy chỉnh giọng nói của riêng bạn
Mở rộng từ 30 giọng nói gốc lên một thư viện vô tận. Cho dù bạn cần một giọng nói nhân vật hoàn toàn nguyên bản hay một đại sứ thương hiệu nhất quán, mô hình 3.8 Flash TTS của chúng tôi sẽ vận hành một studio thanh nhạc hoàn chỉnh. Điều này cho phép bạn tạo và sử dụng các giọng nói biểu cảm, tự nhiên cho mọi khoảnh khắc, đồng thời trao quyền cho các nhà phát triển và doanh nghiệp dễ dàng xây dựng các trải nghiệm âm thanh tùy chỉnh.
- Thiết kế giọng nói tạo sinh: Với Gemini 3.8 Flash TTS, hãy tạo các giọng nói riêng biệt từ đầu bằng cách tùy chỉnh vai trò, giọng điệu và đặc điểm giọng nói trên hơn 100 ngôn ngữ và phương ngữ bằng cách sử dụng câu lệnh ngôn ngữ tự nhiên — cho dù bạn đang thổi hồn vào một con rồng phun lửa đầy kịch tính hay tạo ra một người dẫn chuyện lôi cuốn với âm điệu vùng miền đặc trưng.
- Thư viện giọng nói mở rộng: Truy cập hơn 2.000 giọng nói sẵn sàng cho sản xuất với độ phủ ngôn ngữ rộng — bao gồm các biến thể vùng miền như tiếng Tây Ban Nha Mexico, tiếng Pháp Quebec và tiếng Anh Scotland.
- Sao chép giọng nói: Tái tạo các cấu hình giọng nói nhất quán chỉ từ mẫu âm thanh 30 giây của giọng nói của bạn hoặc giọng nói mà bạn có quyền sử dụng, được hỗ trợ bởi tính năng xác minh sự đồng ý tích hợp, đóng dấu bản quyền SynthID và chứng chỉ C2PA để bảo vệ cả nhà phát triển và tài năng giọng nói của họ.
- Lưu và mở rộng: Lưu và quản lý các giọng nói tùy chỉnh mà bạn đã thiết kế để đảm bảo hiệu suất nhất quán và độ lệch tối thiểu trong các dự án đang thực hiện.
- Phối lại giọng nói: Sắp ra mắt, hãy chọn một giọng nói từ thư viện giọng nói của chúng tôi và tinh chỉnh âm sắc, cao độ, nhịp độ và giọng điệu. Sử dụng câu lệnh để điều chỉnh các đặc điểm (ví dụ: "thêm giọng miền Nam Hoa Kỳ tinh tế" hoặc "làm mềm cách truyền đạt").
Đạo diễn phần trình diễn, từng câu một
Sau khi đã chọn giọng nói, cả hai mô hình TTS đều cung cấp cho bạn khả năng kiểm soát chính xác cách mỗi câu thoại được truyền đạt.
- Đạo diễn phần trình diễn từng câu một: Viết chỉ dẫn sân khấu của riêng bạn hoặc để Gemini điều hướng cách truyền đạt bằng các gợi ý kịch bản tự nhiên — từ một nhân viên dịch vụ khách hàng điềm tĩnh đến một cảnh hồi hộp thì thầm.
- Tạo nội dung dài: Duy trì chất lượng giọng nói cao, nhịp độ tự nhiên và âm sắc nhân vật trong nhiều giờ âm thanh liên tục với độ lệch người nói tối thiểu — lý tưởng cho podcast và sách nói.
- Dàn dựng cảnh hai người nói tự nhiên: Đạo diễn các cuộc hội thoại nhiều lượt một cách liền mạch từ một kịch bản duy nhất — dù là cho podcast hay kể chuyện kịch tính — trong khi vẫn giữ cho cả hai giọng nói tách biệt rõ ràng với cách luân phiên hội thoại tự nhiên.
- Các đoạn bùng nổ giọng nói theo kịch bản & phản hồi đệm: Thêm kết cấu hội thoại chân thực bằng cách sử dụng các tín hiệu phi ngôn ngữ (như <cười>, <thở dài>, <hít thở>) và các từ đệm lắng nghe chủ động (như |mhm| hoặc |yeah|) để có nhịp điệu hài hước và các nhịp phản ứng chính xác.
Nhận khả năng tạo giọng nói chất lượng cao, biểu cảm được xây dựng cho quy mô toàn cầu
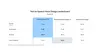
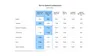
Gemini 3.8 Flash TTS mang đến khả năng tùy chỉnh giọng nói hàng đầu, giành vị trí số 1 chung cuộc trên Voice Design Benchmark của Hume AI (71,4 điểm) và cũng dẫn đầu về mô hình hóa giọng điệu (60,8 điểm).
Gemini 3.8 Flash TTS và Gemini 3.8 Flash-Lite TTS cho phép các màn trình diễn thực sự biểu cảm mà không làm giảm độ tin cậy, đồng thời lần lượt giành vị trí số 1 và số 2 trên Chỉ số Chất lượng Tổng thể của Hume AI. Mô hình cho thấy những cải tiến lớn trên nhiều trường hợp sử dụng như nội dung dài và kiểm soát kịch bản hai người nói so với Gemini 3.1 Flash TTS.
Trong các đánh giá ưu tiên của con người theo phương pháp mù trên Voice Arena, Gemini 3.8 Flash và Flash-Lite TTS giành vị trí hàng đầu trong số các đối thủ cạnh tranh ở các ngôn ngữ toàn cầu chính, bao gồm tiếng Nhật, tiếng Bồ Đào Nha Brazil, tiếng Việt, tiếng Ả Rập chuẩn hiện đại (MSA), tiếng Tây Ban Nha Mexico và tiếng Hindi. Với sự hỗ trợ của hơn 100 ngôn ngữ, các mô hình này trao quyền cho người sáng tạo, nhà phát triển và doanh nghiệp xây dựng các trải nghiệm giọng nói đa ngôn ngữ chất lượng cao trên toàn thế giới.

Xây dựng với sự tin tưởng, đồng thuận và minh bạch
Chúng tôi đã xây dựng các khả năng tạo và sao chép giọng nói của mình với các biện pháp bảo vệ nghiêm ngặt để giúp bảo vệ tài năng giọng nói, tôn trọng danh tính và đảm bảo tính minh bạch của nội dung. Đối với việc sao chép giọng nói, hệ thống của chúng tôi tận dụng xác minh sự đồng ý: người dùng phải cung cấp bản ghi âm đồng ý bằng lời nói từ chủ sở hữu giọng nói khớp với người nói tham chiếu trước khi giọng nói có thể được tạo.
Rộng hơn, mọi đoạn âm thanh được tạo bởi các mô hình Gemini Audio của chúng tôi đều được đóng dấu bản quyền với SynthID. Dấu bản quyền không thể nhận thấy này được đan trực tiếp vào đầu ra âm thanh, đảm bảo giọng nói do AI tạo ra vẫn có thể phát hiện được để giúp ngăn chặn thông tin sai lệch. Để biết thêm chi tiết về cách tiếp cận của chúng tôi đối với sự an toàn và trách nhiệm, hãy xem lại thẻ mô hình.
Hãy thử sân chơi âm thanh Google AI Studio mới của chúng tôi
Bắt đầu từ hôm nay, các nhà phát triển có thể trải nghiệm các khả năng tạo giọng nói mới này trong Google AI Studio. Được xây dựng như một không gian làm việc thiết kế giọng nói, bạn có thể tạo các danh tính giọng nói hoàn toàn mới từ đầu hoặc sao chép giọng nói của chính mình, sau đó đưa chúng trực tiếp vào trình chỉnh sửa kịch bản hai người nói để đạo diễn cách truyền đạt từng câu một.
Thử sao chép giọng nói trong Google AI Studio.
Triển khai các giao diện giọng nói hiệu suất cao một cách dễ dàng
Bằng cách sử dụng Gemini API, các nền tảng nhà phát triển như Agora, LiveKit, Pipecat, Vercel cho phép các nhà phát triển xây dựng và triển khai các trải nghiệm tạo giọng nói hiệu suất cao một cách dễ dàng.
Chúng tôi đang hợp tác với các công ty như Figma, HeyGen, Linguana, Wondercraft, 99.co và Ollang, những đơn vị đang tích hợp các mô hình TTS mới nhất của chúng tôi để giúp tăng tốc việc lồng tiếng toàn cầu, bản địa hóa phương tiện với các giọng vùng miền tinh tế và vận hành các tác nhân giọng nói hội thoại ở quy mô lớn.
Bắt đầu sử dụng các mô hình Gemini Audio mới nhất của chúng tôi:
Gemini 3.8 Flash TTS bắt đầu được triển khai từ hôm nay:
- Dành cho nhà phát triển: Trong Gemini API và Google AI Studio
- Đối với doanh nghiệp: Sắp ra mắt thông qua API trong Gemini Enterprise
- Đối với mọi người: Trong Gemini Notebook.
Gemini 3.8 Flash-Lite TTS bắt đầu được triển khai từ hôm nay:
Bài gốc còn tiếp — xem tiếp tại bài gốc ↗
Bài viết được AI dịch và tổng hợp tự động từ Google DeepMind: Blog. Liên kết bài gốc ở phía trên. Dữ liệu đồng bộ qua API công khai được ghi nguồn tại AI HOT (canonical) ↗. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.