Thủ thuật
vLLM tối ưu hóa Kimi K3: Đạt tốc độ 435 tok/s nhờ mô hình giải mã dự đoán DSpark trên NVL72
(giờ Việt Nam)
Tóm tắt AI
Đội ngũ vLLM đã sử dụng hệ thống GB300 NVL72 để huấn luyện mô hình DSpark cho Kimi K3, giúp tăng tốc độ suy luận toán học lên gấp 4 lần và cải thiện thông lượng đầu ra tới 3,5 lần.
Bản dịch AI
Vào tháng 6, DeepSeek đã phát hành DSpark, một phần mở rộng cho thuật toán giải mã suy đoán (speculative decoding) cấp khối DFlash. Thuật toán mới này hứa hẹn mang lại sự mạch lạc giữa các token tốt hơn, từ đó cải thiện độ dài chấp nhận (acceptance length). Tuy nhiên, câu hỏi thực sự đối với cộng đồng mã nguồn mở vẫn luôn là: liệu bạn có thể huấn luyện, đóng gói và triển khai nó mà không cần một nghiên cứu sinh tiến sĩ phải túc trực để quản lý các checkpoint hay không?
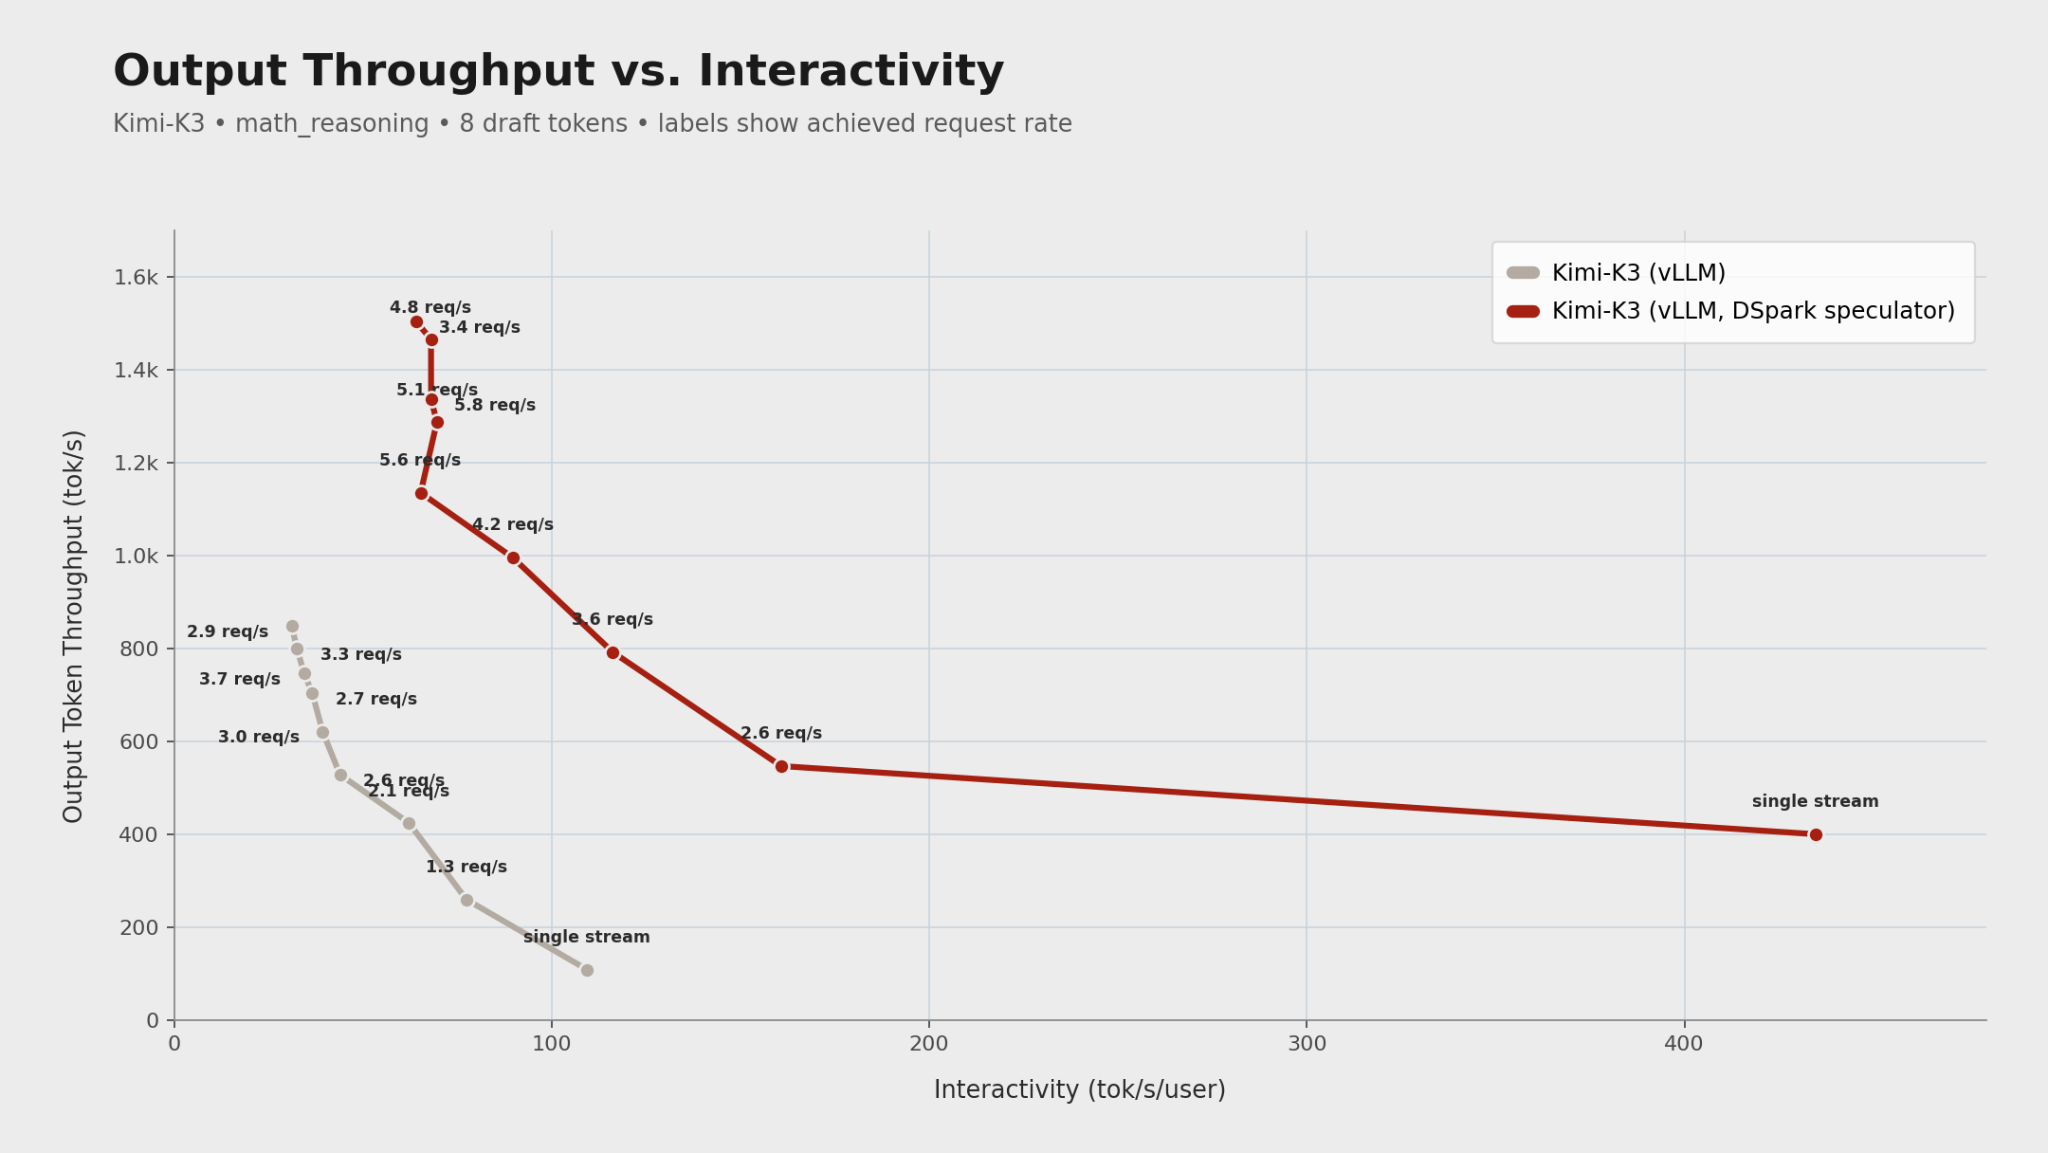
Nhờ thư viện huấn luyện Speculators của Dự án vLLM, câu trả lời là hoàn toàn có thể! Với Speculators, việc huấn luyện, đóng gói và triển khai các mô hình dự thảo DSpark trở nên dễ dàng trong định dạng tiêu chuẩn, tương thích với Hugging Face mà vLLM có thể tải trực tiếp. Quá trình triển khai đã được xác thực trên Qwen3.6-35B-A3B, Gemma-4-31B-it, GLM-5.2 và nhiều mô hình khác. Bài viết này khám phá cách chúng tôi mở rộng thư viện huấn luyện của mình để hỗ trợ Kimi K3, một mô hình tiên phong với 2,8 nghìn tỷ tham số. Bộ suy đoán DSpark mới của chúng tôi giúp tăng khả năng tương tác luồng đơn từ khoảng 110 lên khoảng 435 tok/s/người dùng đối với các tác vụ suy luận toán học, đồng thời mang lại thông lượng đầu ra cao hơn tới khoảng 3,5 lần trong điều kiện tải đồng thời với mức tương tác tương đương.
Hình 1. Bộ suy đoán DSpark cho Kimi K3 giúp tăng cả khả năng tương tác luồng đơn và tổng thông lượng đầu ra trên các khối lượng công việc suy luận toán học.
DSpark là gì?
Các mô hình ngôn ngữ lớn tạo văn bản theo từng token trong mỗi lần truyền tiến (forward pass). Giải mã suy đoán giúp tăng tốc quá trình này bằng cách sử dụng một mô hình dự thảo (drafter) nhẹ để đề xuất nhiều token, sau đó mô hình mục tiêu đầy đủ sẽ cùng xác minh các token đó.
EAGLE-3 là một mô hình cơ sở mạnh mẽ, nhưng nó vẫn dự thảo theo kiểu tự hồi quy (autoregressive): bảy token được đề xuất yêu cầu bảy bước dự thảo tuần tự. Ngược lại, DFlash dự đoán toàn bộ một khối trong một lần truyền qua cấu trúc backbone phi nhân quả (non-causal), mang lại tốc độ tăng tốc cao hơn tới 2,5 lần so với EAGLE-3.
Sự đánh đổi ở đây là các vị trí song song không thể phụ thuộc vào nhau. Đối với câu lệnh “Thank you!”, mô hình có thể độc lập ưu tiên các phản hồi “Of” và “No” ở vị trí thứ nhất, và cả “course” và “problem” ở vị trí tiếp theo, tạo ra các kết quả không khớp như “Of problem.” Vì quá trình xác minh dừng lại ở token bị từ chối đầu tiên, một lỗi sai cũng sẽ làm mất hiệu lực của phần hậu tố còn lại—một vấn đề mà bài báo về DSpark gọi là suy giảm hậu tố (suffix decay).
DSpark bảo toàn cấu trúc backbone song song của DFlash trong khi bổ sung hai thành phần nhẹ:
Do đó, DSpark giữ được ưu điểm chính của việc dự thảo song song bằng cách kế thừa cơ chế truyền qua backbone đơn lẻ, đồng thời khôi phục một phần sự mạch lạc của quá trình tạo văn bản tự hồi quy. Trên các mô hình mục tiêu Qwen3, nó báo cáo độ dài chuỗi được chấp nhận dài hơn 16–18% so với DFlash và dài hơn 27–31% so với EAGLE-3. Trong môi trường vận hành thực tế của DeepSeek-V4, nó đã cải thiện tốc độ tạo văn bản trên mỗi người dùng thêm 60–85% so với mô hình cơ sở MTP-1 trước đó ở cùng mức thông lượng.
Hình 2. DSpark kết hợp một khối song song với hiệu chỉnh tuần tự và lập lịch tiền tố nhận biết phần cứng trước khi thực hiện xác minh bởi mô hình mục tiêu.
Hiệu năng trong quá trình suy luận
Thiết kế bán tự hồi quy của DSpark chỉ cải thiện quá trình suy luận khi công việc tuần tự bổ sung vẫn rẻ hơn nhiều so với một lần truyền tiến của mô hình dự thảo. Bộ suy đoán DSpark cho Kimi K3 được phát hành sử dụng mô hình dự thảo năm lớp với năm tỷ tham số và đề xuất tám token cho mỗi bước giải mã.
Trên chín lĩnh vực đánh giá, nó đạt độ dài chấp nhận trung bình vĩ mô là 4,11 token cho mỗi vòng xác minh. Hiệu năng mạnh mẽ nhất trên các tác vụ có cấu trúc: 6,42 token cho suy luận toán học, 4,96 cho HumanEval và 4,65 cho dịch thuật. Tốc độ tăng đặc biệt đáng kể khi số lượng yêu cầu thấp.
Mô hình này hoạt động đặc biệt hiệu quả với các câu lệnh có ngữ cảnh dài. Trên một tập dữ liệu chuyên biệt đầy thách thức như LongBench-v2, Kimi K3 DSpark của chúng tôi đạt tới 5,31 token đầu ra cho mỗi lần lặp giải mã trên một câu lệnh dài 378K token. Ngay cả trên khối lượng công việc rộng hơn, 10% yêu cầu hàng đầu cũng đạt ít nhất 3,76 token mỗi lần lặp, chứng minh rằng các lượt suy đoán sâu vẫn khả thi ở độ dài ngữ cảnh thực sự lớn.
Nó mở rộng hiệu quả khi có nhiều yêu cầu đến cùng lúc. Việc tăng mức độ đồng thời từ 1 lên 16 giúp tăng tổng thông lượng đầu ra từ 177 lên 683 token mỗi giây.
Quan trọng là, thời gian phản hồi ban đầu vẫn nhanh ngay cả khi chịu tải. Mặc dù phục vụ số lượng yêu cầu đồng thời gấp 16 lần, thời gian trung vị để có token đầu tiên chỉ tăng thêm 100 mili giây, từ 379 lên 479 mili giây.
Việc triển khai rất dễ dàng. Hãy làm theo công thức vLLM chính thức cho phần cứng và trường hợp sử dụng của bạn:
Thiết lập phần cứng
Mô hình này được huấn luyện trên một rack GB300 do Verda hào phóng cung cấp. Verda là một đơn vị điện toán đám mây AI châu Âu sở hữu toàn bộ hạ tầng từ trung tâm dữ liệu đến các dịch vụ quản lý, và vận hành bằng 100% năng lượng tái tạo. Verda là một trong những nhà cung cấp đầu tiên tại châu Âu triển khai các rack GB300 NVL72. Phòng thí nghiệm AI nội bộ của họ cũng thực hiện nghiên cứu suy luận trên chính các rack này.
Rack GB300 giữ nguyên thiết kế tham chiếu của NVIDIA và chạy trên phần cứng trần (bare metal), không ảo hóa, sử dụng Ubuntu 24.04.4 LTS trên nhân 6.14 với trang 64K của NVIDIA.
Verda tập trung nỗ lực tối ưu hóa vào các lựa chọn cấu hình cấp hệ thống quan trọng nhất, mang đến cho các nhà nghiên cứu quyền truy cập vào môi trường đẳng cấp tiên phong. Hệ thống sử dụng trình điều khiển GPU nhân mở 610.57.04 của NVIDIA (R610). CUDA 13.4.0 Developer Preview được cài đặt cùng với CUDA 13.1 và 12.9, trong khi NCCL 2.31.2 khả dụng trên toàn hệ thống.
CUDA 13.4.0 được chọn vì các tính năng lập trình Blackwell mới và vì đây là bộ công cụ đầu tiên hỗ trợ Rubin (sm_107). Điều này giúp đảm bảo rằng mã được viết và lập hồ sơ trên GB300 ngày hôm nay có thể được xây dựng cho thế hệ phần cứng tiếp theo mà không gặp các vấn đề tương thích bất ngờ. Việc lập hồ sơ GPU dựa trên bộ đếm phần cứng cũng khả dụng mà không cần quyền root, cho phép mọi nhà nghiên cứu lập hồ sơ cho cả khối lượng công việc huấn luyện và suy luận.
Chúng tôi đã hợp tác với Verda để giúp hạ tầng huấn luyện và suy luận mã nguồn mở mở rộng quy mô sang các kiến trúc GPU mới nhất, với trọng tâm hiện tại là các hệ thống quy mô rack trải dài từ GB300 đến VR200. Chúng tôi rất vui mừng khi thấy kết quả của sự hợp tác này đang dần hình thành.
Một phần lý do khiến các mô hình dự thảo giải mã suy đoán mạnh mẽ dù có kích thước nhỏ là vì chúng thường lấy các trạng thái ẩn (hidden states) từ mô hình mục tiêu làm đầu vào để cung cấp thông tin cho các dự đoán của mình. Điều này cải thiện đáng kể ngữ cảnh làm việc và giúp các mô hình dự thảo có thể căn chỉnh chặt chẽ các dự đoán của chúng với mô hình mục tiêu.
Điểm cần lưu ý là việc huấn luyện các mô hình dự thảo này đòi hỏi một tập dữ liệu gồm các đầu vào trạng thái ẩn và đầu ra xác suất log của mô hình mục tiêu. Rất may, vLLM có một hệ thống trích xuất trạng thái ẩn cho phép lấy các trạng thái ẩn nội bộ của mô hình mục tiêu theo yêu cầu cho các mẫu dữ liệu. Hệ thống này sử dụng một mô hình dự thảo giả (dummy draft model), tái sử dụng hệ thống ống dẫn của mô hình dự thảo trong vLLM để nhận các trạng thái ẩn mục tiêu và chèn chúng vào bộ nhớ đệm KV của một lớp chú ý giả. Từ đó, một lớp triển khai giao diện KVConnector có thể truy xuất và chuyển các trạng thái ẩn ra khỏi vLLM. Hiện tại, vLLM đi kèm với ExampleHiddenStatesConnector thực hiện chính xác điều đó, ghi các trạng thái ẩn vào đĩa một cách bất đồng bộ.
Hệ thống này hoạt động tốt cho các cấu hình vLLM-và-huấn luyện trên một nút duy nhất. Ví dụ, một nửa số GPU của nút có thể dành cho việc huấn luyện, trong khi nửa còn lại phục vụ mô hình mục tiêu trong vLLM và trích xuất trạng thái ẩn theo yêu cầu. Hệ thống này đã được hỗ trợ tốt trong cả Speculators và vLLM trong nhiều tháng. Tuy nhiên, với một mô hình 2,8 nghìn tỷ tham số như Kimi K3, ngay cả các bộ tăng tốc hiện đại nhất cũng bắt đầu gặp giới hạn VRAM mặc dù đã lượng tử hóa 4-bit cho trọng số mô hình. Chúng ta cần một hệ thống mở rộng vượt ra ngoài việc huấn luyện trên một nút và cho phép huấn luyện cũng như trích xuất trạng thái ẩn phân tán.
Hình 3. Bộ kết nối Mooncake tách biệt đường dẫn điều khiển khỏi đường dẫn dữ liệu trạng thái ẩn, sử dụng RDMA hoặc TCP để truyền tải giữa vLLM và trình tải dữ liệu Speculators.
Với những yêu cầu này, chúng tôi đã xây dựng MooncakeHiddenStatesConnector, sử dụng công cụ truyền tải Mooncake làm backend để truyền phát trạng thái ẩn giữa các tiến trình và giữa các nút. Hệ thống mới sử dụng một tiến trình proxy Mooncake chính để quản lý giao tiếp với vLLM và các thực thể huấn luyện đăng ký làm khách hàng. Sau khi thiết lập, các tiến trình huấn luyện có thể gửi yêu cầu đến frontend vLLM và nhận lại khóa lưu trữ Mooncake. Khóa đó sau đó được cung cấp cho Mooncake chính, đóng vai trò môi giới việc truyền dữ liệu từ engine vLLM sang trình tải dữ liệu Speculators. Tất cả những điều này diễn ra tự động, được quản lý bởi máy chủ Mooncake, và—tùy thuộc vào cấu hình—sử dụng truyền tải RDMA tốc độ cao hoặc TCP thông thường để gửi dữ liệu giữa các tiến trình trên cùng một nút hoặc các nút khác nhau.
Huấn luyện Kimi K3 DSpark
Hình 4. Mỗi tập hợp bốn nút dành một nút bốn GPU cho việc huấn luyện và hai nút bốn GPU cho suy luận vLLM, với Mooncake thực hiện truyền trạng thái ẩn.
Với MooncakeHiddenStatesConnector mới trong tay, chúng ta hiện có một hệ thống có khả năng mở rộng sang việc huấn luyện mô hình lớn, đa nút. Ngay cả khi Kimi K3 được lượng tử hóa xuống 4 bit, mô hình vẫn cần ít nhất hai nút GB300 (mỗi nút bốn GPU) để phục vụ. Chúng tôi đã thử nghiệm với các cấu hình huấn luyện và vLLM khác nhau và nhận thấy rằng các tập hợp ba nút—hai cho suy luận và một cho huấn luyện—mang lại thông lượng tốt nhất. Một ưu điểm khác của Speculators với bộ kết nối Mooncake là sự dễ dàng trong việc mở rộng hoặc thu hẹp độc lập từng thành phần để đạt hiệu năng tốt nhất.
Kết luận
Speculators là một thư viện mã nguồn mở để xây dựng, huấn luyện, đánh giá và chia sẻ các mô hình giải mã suy đoán tích hợp trực tiếp với các engine suy luận như vLLM. Cho dù bạn đang huấn luyện một mô hình dự thảo mới, khám phá các thuật toán như DFlash, DSpark hoặc DFlash2, hay cải thiện hiệu năng suy luận trong sản xuất, chúng tôi đều hoan nghênh ý tưởng và đóng góp của bạn. Hãy tham gia vLLM Community Slack và tìm chúng tôi tại #speculators và #feat-spec-decode để đặt câu hỏi, chia sẻ kết quả, thảo luận về các thuật toán mới và cộng tác với cộng đồng. Mọi đóng góp về mã nguồn, tài liệu, ví dụ, hỗ trợ mô hình và công cụ đánh giá đều được hoan nghênh.
Bài viết được AI dịch và tổng hợp tự động từ vLLM Blog. Liên kết bài gốc ở phía trên. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.