12/09

Thứ Bảy · 24 tin
Rohan Paul@rohanpaul_ai
NgànhĐiểm AI 34/100

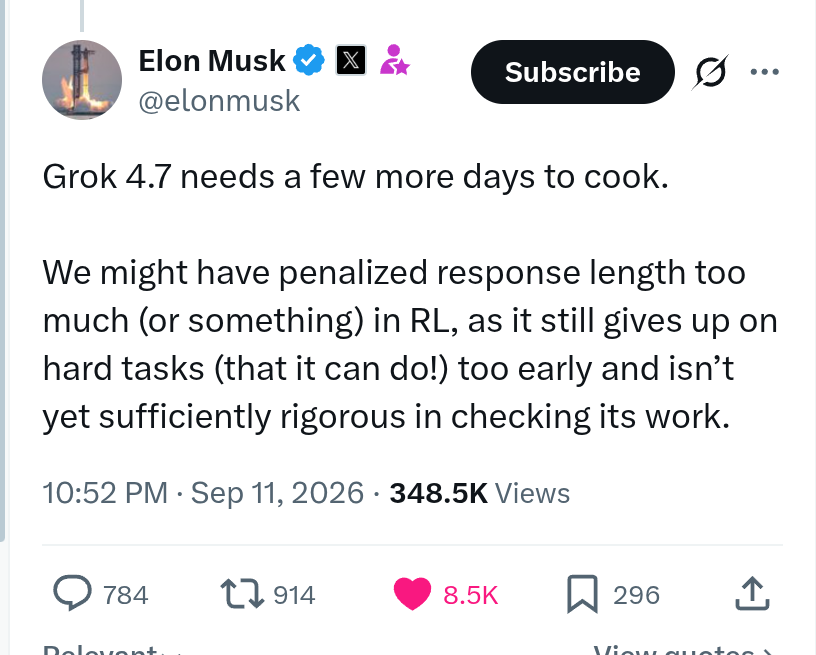
Cùng sự kiệnElon Musk: Grok 4.7 sẽ ra mắt trong vài ngày tới

Grok 4.7 release update from Elon, still few more days.

DịchElon Musk cho biết Grok 4.7 cần thêm vài ngày để hoàn thiện. Đội ngũ đang tinh chỉnh lại cơ chế RL vì mô hình hiện vẫn còn tình trạng bỏ cuộc sớm ở các tác vụ khó và chưa đủ cẩn trọng khi tự kiểm tra kết quả.

Cùng sự kiện, bài đại diện «Grok 4.7 bị hoãn ra mắt: Elon Musk tiết lộ lý do kỹ thuật»
Kim@kimmonismus
NgànhĐiểm AI 44/100

Grok 4.7 bị hoãn ra mắt: Elon Musk tiết lộ lý do kỹ thuật

Grok 4.7 officially postponed sadly. But good things need time

DịchElon Musk xác nhận Grok 4.7 cần thêm thời gian để tinh chỉnh do gặp lỗi xử lý các tác vụ phức tạp và khả năng tự kiểm tra chưa đạt yêu cầu. Đội ngũ phát triển đang khắc phục vấn đề về thuật toán RL để đảm bảo mô hình hoạt động hiệu quả hơn.

Thêm 1 nguồn khác đưa tinX: Rohan Paul (@rohanpaul_ai)
DAIR.AI@dair_ai
NgànhĐiểm AI 43/100

Ecdysis: Khung tác nhân tự tiến hóa giúp tăng tốc huấn luyện gấp 1,84 lần

Great paper on self-evolving agent harnesses. Self-evolving agent harnesses have two practical prob…

DịchEcdysis tối ưu hóa quy trình tự sửa lỗi của AI bằng cách phân tích lỗi theo lô và thống nhất chiến lược trước khi sửa code, giúp tăng tốc huấn luyện 1,84 lần và cải thiện 18,56% độ chính xác với ít dữ liệu hơn.

11/09

Thứ Sáu · 25 tin
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 54/100

Đo lường độ 'ẩu' trong code do LLM tạo ra: Chỉ số Verbosity và Erosion

Kỹ sư tại Earendil đề xuất sử dụng các chỉ số như thay đổi LOC, độ dài (verbosity) và mức độ bào mòn (erosion) để đánh giá chất lượng code từ LLM, thay vì dựa vào phương pháp AI-as-a-judge kém hiệu quả.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnNegative Self-Distillation: Cải thiện khả năng suy luận của AI bằng cách tránh các lỗi sai

Thay vì bắt chước đáp án mẫu, phương pháp Negative Self-Distillation (NSD) giúp mô hình ngôn ngữ tự tối ưu hóa bằng cách nhận diện và tránh xa các suy luận sai lầm, từ đó thúc đẩy tư duy phản biện và tự sửa lỗi.


Vì sao đáng đọc: Đây là một hướng tiếp cận mới đầy tiềm năng trong việc huấn luyện LLM, giải quyết trực tiếp điểm yếu của phương pháp tự chưng cất (self-distillation) truyền thống.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

MetroLLM-Bench: Đánh giá mô hình ngôn ngữ trong vai trò trợ lý điều hành hệ thống tàu điện ngầm

MetroLLM-Bench là bộ tiêu chuẩn mới gồm 955 tình huống thực tế, giúp đánh giá khả năng của AI trong việc xử lý lộ trình, giá vé và sự cố tại các ki-ốt tàu điện ngầm thông qua việc sử dụng công cụ có cấu trúc.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 39/100

X-AuT: Tối ưu hóa bộ mã hóa âm thanh cho mô hình ngôn ngữ lớn thông qua nén và chưng cất

X-AuT sử dụng kỹ thuật cắt tỉa dần dần và chưng cất đa quy mô để nén bộ mã hóa âm thanh của LLM, giúp giảm số lớp Transformer mà vẫn cải thiện độ chính xác trên các bài kiểm tra tiếng Anh và tiếng Trung.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 59/100

Nghiên cứu mới: LLM chạy cục bộ có thể bị rò rỉ dữ liệu qua bộ nhớ đệm CPU với tỷ lệ thành công 95,87%

A local model can keep everything off the cloud and still leak its answers through the CPU cache. s…

DịchNghiên cứu 'Detokenization Leaks' chỉ ra phương thức tấn công mới giúp khôi phục văn bản từ LLM bằng cách theo dõi hoạt động bộ nhớ đệm CPU trong quá trình giải mã token, mà không cần truy cập trực tiếp vào bộ nhớ của mô hình.

Rohan Paul@rohanpaul_ai
NgànhĐiểm AI 44/100

RSM-full: Kỹ thuật nhóm bộ nhớ giúp AI tiết kiệm 68% token

For memory-limited agents, organize the past before you optimize search: grouping related memories a…

DịchRSM-full tối ưu hóa bộ nhớ cho AI bằng cách nhóm các dữ liệu liên quan thay vì truy xuất rời rạc, giúp duy trì 83% chất lượng phản hồi với chi phí token chỉ bằng 1/3 so với phương pháp truyền thống.

Together AI Blog nghiên cứu và sản phẩm
Sản phẩmĐiểm AI 62/100

Tinh chọnTogether AI nâng cấp dịch vụ tinh chỉnh: Hỗ trợ mô hình mới và công cụ theo dõi thời gian thực

Together AI bổ sung hỗ trợ cho các dòng mô hình mới như GLM-5.3, Kimi K2.7 và Qwen 3.5, đồng thời tích hợp tính năng theo dõi thử nghiệm trực tiếp và kiểm soát dữ liệu chuyên sâu.


Vì sao đáng đọc: Cập nhật quan trọng cho cộng đồng phát triển AI, cung cấp công cụ thực tế giúp tối ưu hóa quy trình tinh chỉnh mô hình ngôn ngữ lớn.
Nathan Lambert@natolambert
NgànhĐiểm AI 43/100

Chưng cất mô hình: Không chỉ là sản phẩm phụ của SFT

Big W for people saying that distillation was mostly an SFT artifact, and how its unclear how it wou…

DịchMột góc nhìn mới khẳng định tầm quan trọng của kỹ thuật chưng cất mô hình trong kỷ nguyên học tăng cường (RL), bác bỏ quan điểm cho rằng đây chỉ là sản phẩm phụ của quá trình tinh chỉnh có giám sát (SFT).

Artificial Analysis@ArtificialAnlys
Mô hìnhĐiểm AI 77/100

Cùng sự kiệnDeepSeek V4.1 Flash ra mắt: Vượt mặt bản Pro, thiết lập chuẩn mực mới cho dòng flagship

DeepSeek V4.1 Flash overtakes DeepSeek V4 Pro 0813 as DeepSeek's new flagship model with a score of …

DịchTheo đánh giá từ Artificial Analysis, DeepSeek V4.1 Flash đạt 40 điểm trên Intelligence Index, chính thức trở thành flagship mới của DeepSeek với cấu trúc 8B/16B và hỗ trợ cửa sổ ngữ cảnh lên tới 1 triệu token.

Cùng sự kiện, tinh chọn hiển thị «DeepSeek ra mắt DeepSeek-V4.1-Flash: Cửa sổ 1M token, tối ưu bộ nhớ KV Cache cực đỉnh»
Elvis Saravia@omarsar0
NgànhĐiểm AI 46/100

PARSER: Tối ưu hóa xử lý ngữ cảnh dài bằng cơ chế tác tử song song

This is a brilliant paper. It's of the cleanest long-context agent designs I have seen in the past …

DịchPARSER tách biệt việc đọc và suy luận bằng cách sử dụng các tác tử phụ xử lý song song từng phần dữ liệu, trong khi tác tử chính tổng hợp thông tin và đặt câu hỏi chuyên sâu, giúp tăng hiệu suất cho các mô hình AI ngữ cảnh dài.

DAIR.AI@dair_ai
NgànhĐiểm AI 42/100

Đội ngũ Qwen giới thiệu Elastic Horizon: Phương pháp tối ưu hóa lịch trình cho tác nhân AI

Recommended read. Interaction horizon scheduling is an underexplored control problem in agentic RL …

DịchElastic Horizon là bộ điều khiển vòng lặp giúp tối ưu hóa số vòng tương tác của tác nhân AI, thay thế cách lập lịch cố định truyền thống. Phương pháp này giúp tăng tỷ lệ thành công trên AppWorld và BFCL, đồng thời tiết kiệm tới 25% lượng token mỗi bước.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnPARSER: Đột phá xử lý tài liệu dài cho AI Agent nhờ cơ chế đọc song song và suy luận chuyên sâu

PARSER tách biệt quá trình đọc và suy luận bằng cách sử dụng các sub-agent đọc song song, giúp AI Agent xử lý tài liệu dài hiệu quả hơn, giảm độ trễ và tránh phụ thuộc vào vị trí thông tin.


Vì sao đáng đọc: Giải pháp kỹ thuật sáng tạo giúp tối ưu hóa hiệu suất cho các tác vụ truy vấn phức tạp trên tài liệu dài, có tính ứng dụng cao trong phát triển AI Agent.

10/09

Thứ Năm · 25 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

OreoLook: Kiến trúc bộ nhớ đệm 3 lớp giúp tối ưu hóa tìm kiếm bằng LLM trên CPU thông thường

OreoLook giới thiệu kiến trúc bộ nhớ đệm 3 lớp giúp giảm độ trễ và chi phí cho các công cụ tìm kiếm AI, cho phép chạy mượt mà trên phần cứng CPU phổ thông bằng cách tối ưu hóa ngữ cảnh phiên và truy vấn ngữ nghĩa.

Elvis Saravia@omarsar0
NgànhĐiểm AI 41/100

AWS giới thiệu UnitBoost: Thay thế tác nhân quản lý bằng toán tử hợp nhất trong hệ thống LLM

Great paper from AWS. I use a similar setup where an agent orchestrator sits on top of a multi-agen…

DịchAWS đề xuất UnitBoost, phương pháp sử dụng bản đồ đơn vị để chuyển đổi đầu ra của các mô hình thành giá trị cụ thể, loại bỏ nhu cầu về tác nhân quản lý (meta-agent) phức tạp trong các hệ thống LLM đa nhiệm.

ModelBest OpenBMB@OpenBMB
NgànhĐiểm AI 45/100

OpenBMB công bố bộ dữ liệu huấn luyện mã nguồn mở cho MiniCPM5-2B

A strong model starts with strong data. Behind MiniCPM5-2B is a growing body of open-source trainin…

DịchOpenBMB vừa phát hành bộ dữ liệu huấn luyện cho MiniCPM5-2B, bao gồm các tập dữ liệu chuyên sâu về lập trình, huấn luyện tác tử (agent), học tăng cường và tinh chỉnh dữ liệu quy mô lớn.

SiliconFlow@SiliconFlowAI
Mô hìnhĐiểm AI 67/100

Cùng sự kiệnDeepSeek-V4.1-Flash cập bến SiliconFlow: Mô hình MoE 552B với cửa sổ ngữ cảnh 1 triệu token

@deepseek_ai just made Flash the new Pro. 🤯 DeepSeek-V4.1-Flash is live on SiliconFlow - Day 0. 55…

DịchSiliconFlow vừa ra mắt DeepSeek-V4.1-Flash, mô hình MoE 552B hỗ trợ thị giác nguyên bản, cửa sổ ngữ cảnh 1 triệu token và tối ưu hóa bộ nhớ đệm KV hiệu quả hơn gấp 4 lần.

Cùng sự kiện, bài đại diện «DeepSeek hủy bỏ kế hoạch khai tử API V4 Pro, tiếp tục duy trì dịch vụ»
Ma Dongxi NLP@dongxi_nlp
NgànhĐiểm AI 36/100

Cùng sự kiệnDeepSeek-V4.1-Flash: Đột phá tối ưu hóa nén KV Cache

DeepSeek-V4.1-Flash giới thiệu kiến trúc Causal Encoder-Decoder mới, cho phép tạo KV Cache toàn cục trực tiếp từ đầu ra của encoder. Cải tiến này giúp lược bỏ việc xử lý prompt qua toàn bộ các lớp decoder, từ đó tối ưu hóa đáng kể tốc độ tiền xử lý (prefill) cho mô hình.

Cùng sự kiện, tinh chọn hiển thị «DeepSeek ra mắt DeepSeek-V4.1-Flash: Cửa sổ 1M token, tối ưu bộ nhớ KV Cache cực đỉnh»
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Từ trọng số đến viết lại: Khai phá tiềm năng can thiệp của dữ liệu huấn luyện trong mô hình ngôn ngữ

Nghiên cứu đề xuất phương pháp viết lại phản hồi dựa trên tầm ảnh hưởng (IF) thay vì chỉ thay đổi trọng số, giúp tối ưu hóa khả năng điều chỉnh hành vi của mô hình LLM hiệu quả hơn.

SemiAnalysis@SemiAnalysis_
Mô hìnhĐiểm AI 67/100

Cùng sự kiệnDeepSeek ra mắt DeepSeek-V4.1-Flash: Mô hình 552B với cơ chế kích hoạt siêu tinh gọn

Congrats to @deepseek_ai on releasing DeepSeek-V4.1-Flash! > 552B backbone, with a causal encode…

DịchDeepSeek-V4.1-Flash sở hữu kiến trúc 552B tham số nhưng chỉ kích hoạt 8B-16B khi vận hành. Nhờ bộ nhớ Engram 196B và kỹ thuật nén KV cache, mô hình đạt hiệu suất vượt trội với tài nguyên tối ưu.

Cùng sự kiện, tinh chọn hiển thị «DeepSeek ra mắt DeepSeek-V4.1-Flash: Cửa sổ 1M token, tối ưu bộ nhớ KV Cache cực đỉnh»
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 40/100

Phát hiện thiên kiến trong LLM: Đo lường sự thay đổi định kiến thông qua trạng thái ẩn

Nghiên cứu mới đề xuất phương pháp kiểm định thiên kiến dựa trên các điểm tham chiếu, sử dụng trạng thái ẩn để đo lường sự dịch chuyển định kiến (ΔB) của mô hình ngôn ngữ trước và sau khi tinh chỉnh.

Thomas Wolf (Hugging Face đồng sáng lập/CSO)@Thom_Wolf
Mô hìnhĐiểm AI 68/100

Cùng sự kiệnDeepSeek V4.1 Flash ra mắt: Đòi lại ngôi vương mô hình mã nguồn mở

The new DeepSeek V4.1 Flash model is mindblowing - back on top of the open-source model leaderboard …

DịchDeepSeek V4.1 Flash vừa chính thức trở lại vị trí dẫn đầu bảng xếp hạng mô hình mã nguồn mở với mức giá cực kỳ cạnh tranh. Đồng sáng lập Hugging Face, Thomas Wolf, đã chia sẻ video trực quan hóa quy trình suy luận nội bộ của mô hình này.

Cùng sự kiện, tinh chọn hiển thị «DeepSeek ra mắt DeepSeek-V4.1-Flash: Cửa sổ 1M token, tối ưu bộ nhớ KV Cache cực đỉnh»
Thomas Wolf (Hugging Face đồng sáng lập/CSO)@Thom_Wolf
NgànhĐiểm AI 45/100

Hugging Face ra mắt TRL v1.13: Hỗ trợ huấn luyện mô hình với ngữ cảnh siêu dài

TRL v1.13 is out! our open-source RL training library to to post-train foundation models this new r…

DịchThư viện TRL v1.13 vừa được phát hành với trọng tâm là huấn luyện hậu kỳ cho các mô hình có ngữ cảnh trên 1 triệu token, đi kèm với các tối ưu hóa quan trọng về tốc độ và bộ nhớ.

MarkTechPost
Mô hìnhĐiểm AI 87/100

Tinh chọnDeepSeek ra mắt DeepSeek-V4.1-Flash: Cửa sổ 1M token, tối ưu bộ nhớ KV Cache cực đỉnh

DeepSeek-V4.1-Flash là mô hình MoE đa phương thức mới với 748B tham số, nổi bật nhờ khả năng xử lý 1 triệu token và giảm dung lượng KV Cache xuống chỉ còn 890 byte mỗi token, tối ưu hiệu suất vượt trội so với các thế hệ trước.

Diễn biến sự kiện · 32 bài →Thêm 27 nguồn khác đưa tinHacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)X: AI Notes (@AYi_AInotes)X: Alibaba Cloud (@alibaba_cloud)X: Ma Dongxi NLP (@dongxi_nlp)Fireworks AI (Web)X: Hongming (@hongming731)Latent SpaceX: SemiAnalysis (@SemiAnalysis_)Baseten Blog kỹ thuật (Web)X: OpenRouter (@OpenRouter)WeChat: Carl AI WattsX: Artificial Analysis (@ArtificialAnlys)X: Yuchen Jin (@Yuchenj_UW)X: Tencent WorkBuddy (@WorkBuddy_AI)The Decoder: AI NewsIT HomeX: Thomas Wolf (Hugging Face đồng sáng lập/CSO) (@Thom_Wolf)X: X.PIN (@thexpin)X: Kim (@kimmonismus)X: Testing Catalog (@testingcatalog)X: Elvis Saravia (@omarsar0, DAIR.AI)X: Aravind Srinivas (Perplexity CEO) (@AravSrinivas)TechNodePandailyX: DeepSeek (@deepseek_ai)X: opencode (@opencode)X: Tianyi Cui (@tianyi)

Vì sao đáng đọc: Đây là bước tiến lớn về kỹ thuật tối ưu hóa bộ nhớ và hiệu suất suy luận cho mô hình ngôn ngữ lớn, thông tin cực kỳ quan trọng với cộng đồng AI.
Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (98 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “llm” — Trang 11 | AIHOT.vn