01/09

Thứ Ba · 15 tin
Francois Chollet@fchollet
Hướng dẫnĐiểm AI 24/100

François Chollet: Mở rộng thời điểm kiểm thử (Test-time Scaling) gồm hai chiều: Chiều sâu và Chiều rộng

Test-time scaling has two axes: running agents over longer timeframes (depth), and running a larger …

DịchFrançois Chollet cho rằng việc mở rộng thời điểm kiểm thử không chỉ nằm ở việc kéo dài thời gian xử lý (chiều sâu), mà còn cần tăng số lượng tác nhân hoạt động song song (chiều rộng) để giải quyết các bài toán phức tạp đòi hỏi tìm kiếm không gian rộng.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 48/100

Nghiên cứu cơ chế chưng cất On-Policy và đề xuất phương pháp không giám sát OPSA

Nghiên cứu chỉ ra rằng hiệu quả của chưng cất On-Policy (OPD) chủ yếu đến từ việc ức chế các token có xác suất thấp thay vì phụ thuộc vào giáo viên. Từ đó, nhóm tác giả đề xuất OPSA, phương pháp không cần giám sát giúp tối ưu hóa mô hình hiệu quả hơn.

cb_doge@cb_doge
Sản phẩmĐiểm AI 32/100

Grok Build cập nhật v1.0.15: Tối ưu tốc độ phản hồi và trải nghiệm hội thoại

BREAKING: SpaceXAI has released another major new update for Grok Build (v1.0.15) v1.0.15 makes Gro…

DịchBản cập nhật v1.0.15 của Grok Build tập trung tối ưu hóa hiệu suất bằng cách chuyển các tác vụ xử lý nền, giúp giảm độ trễ phản hồi đầu tiên và làm mượt quá trình khởi tạo hội thoại.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 50/100

Google giới thiệu SKILL.state: Tối ưu hóa hiệu suất và độ chính xác cho AI Agent dài hạn

Good paper on long-horizon scalable agent skills.

DịchGoogle ra mắt SKILL.state, thay thế lịch sử hội thoại cồng kềnh bằng trạng thái thực thi có cấu trúc. Giải pháp này giúp AI Agent duy trì độ chính xác cao, giảm tiêu thụ token và loại bỏ tình trạng nhiễu ngữ cảnh trong các tác vụ kéo dài.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 43/100

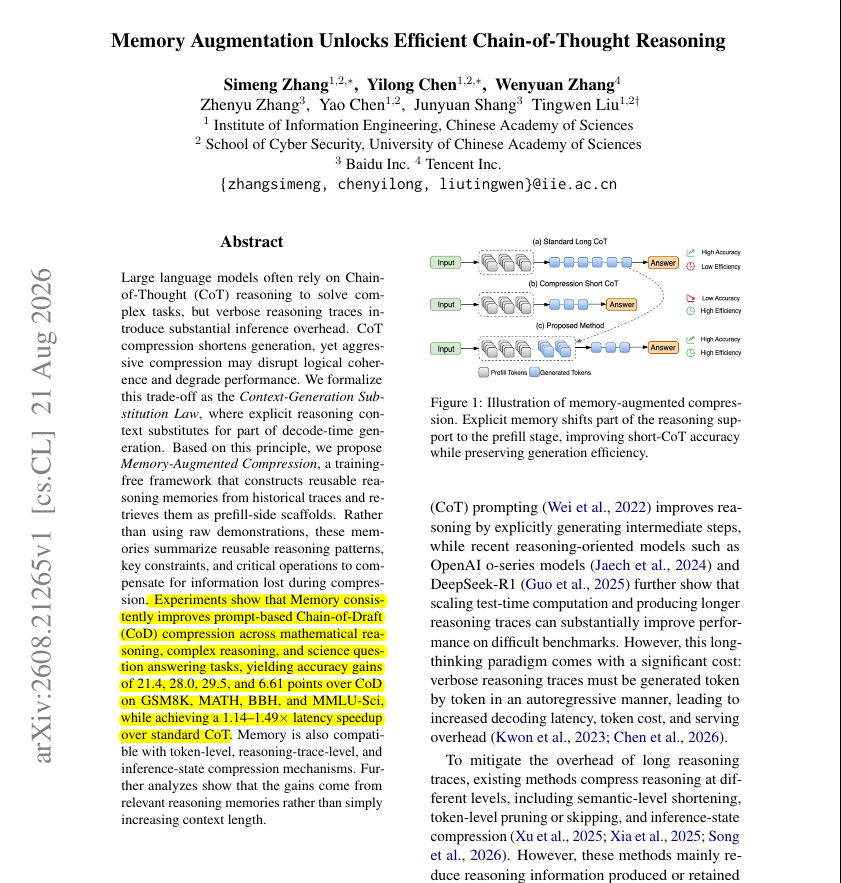
Nén tăng cường bộ nhớ: Tối ưu hóa chi phí suy luận chuỗi tư duy (CoT) bằng cách tái sử dụng suy luận

This paper shows a different way to make chain-of-thought cheaper: move reusable reasoning from gene…

DịchPhương pháp này chuyển đổi các bước suy luận từ giai đoạn tạo văn bản sang phần gợi ý (prompt), giúp giảm chi phí tính toán cho chuỗi tư duy mà không cần huấn luyện lại mô hình.

31/08

Thứ Hai · 16 tin
Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 48/100

WikiSkill: Google giới thiệu phương pháp giúp AI tự học và tái sử dụng kỹ năng qua Wiki

This WikiSkill paper from Google is a must-read. At a high level, it shows the effectiveness of per…

DịchGoogle đề xuất WikiSkill, một khung làm việc cho phép AI tự lưu trữ kinh nghiệm vào cơ sở tri thức để tối ưu hóa và tái sử dụng kỹ năng. Phương pháp này giúp các mô hình nhỏ đạt hiệu suất vượt trội nhờ khả năng kế thừa tri thức từ hệ thống.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 46/100

Nghiên cứu mới từ ByteDance: Giữ lại lịch sử thử nghiệm hiệu quả hơn tóm tắt bộ nhớ

New ByteDance paper shows for test-time improvement, keeping the messy history of attempts can work …

DịchByteDance giới thiệu phương pháp Chain-of-Experience, ưu tiên lưu giữ toàn bộ quá trình thử nghiệm và phản hồi thay vì tóm tắt ngắn gọn. Cách tiếp cận này giúp cải thiện đáng kể độ chính xác trong các tác vụ toán học và lập trình so với phương pháp lặp lại truyền thống.

karminski@karminski3
Hướng dẫnĐiểm AI 42/100

Bảng xếp hạng năng lực Agent cho các mô hình AI nhỏ: Qwen3.8-27B dẫn đầu

Karminski công bố bảng xếp hạng khả năng làm Agent của các mô hình nhỏ, trong đó Qwen3.8-27B-UD-Q4_K_XL được đánh giá cao nhất. Bài viết cũng chia sẻ cấu hình tối ưu cho lập luận và lập trình, cùng lời khuyên sử dụng MLX cho người dùng Mac để đạt tốc độ tốt hơn.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

StarHarness: Tối ưu hóa khung làm việc cho tác nhân AI trong môi trường doanh nghiệp

StarHarness là khung làm việc giúp cải thiện hiệu suất tác nhân AI bằng cách tinh chỉnh cấu trúc điều khiển mà không cần thay đổi trọng số mô hình. Phương pháp này giúp tăng hiệu quả xử lý tác vụ doanh nghiệp từ 20-35% trên nhiều nền tảng khác nhau.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 50/100

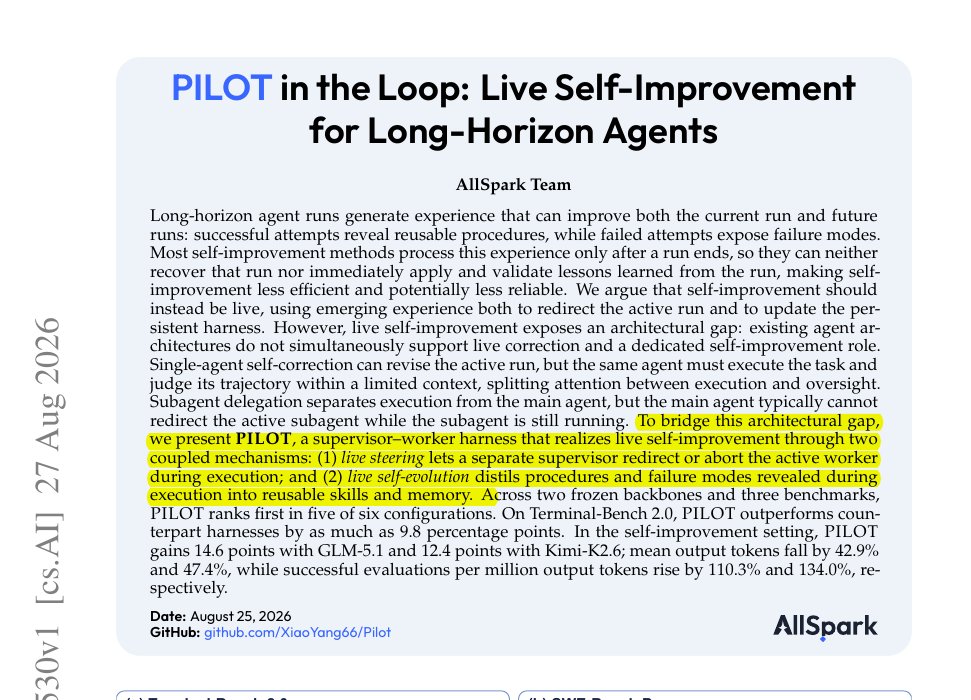
Khung PILOT: Đột phá giúp AI tự cải thiện kỹ năng ngay trong khi đang thực hiện nhiệm vụ

Most agent self-improvement happens too late: the system learns from a run only after that run is al…

DịchPILOT cho phép AI tự học và điều chỉnh hành vi theo thời gian thực thay vì đợi kết thúc tác vụ. Phương pháp này giúp tăng đáng kể tỷ lệ thành công trên các bài kiểm tra kỹ thuật, đồng thời tối ưu hóa hiệu suất và giảm thiểu lượng token tiêu thụ.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

ABot-Recon: Tái định nghĩa bối cảnh cục bộ cho tái dựng 3D trực tuyến dài hạn

ABot-Recon là mô hình tái dựng 3D trực tuyến đột phá, chỉ sử dụng bộ nhớ đệm 11 khung hình gần nhất để duy trì độ ổn định mà không cần bộ nhớ dài hạn phức tạp, giúp tối ưu hóa tài nguyên tính toán cho các video cực dài.

Rohan Paul@rohanpaul_ai
Hướng dẫnĐiểm AI 57/100

Tối ưu hóa khung làm việc: Bí quyết giúp AI lập trình vượt qua giới hạn ngữ cảnh

Keep the model fixed, change the harness, and coding-agent results can move a lot when context gets …

DịchNghiên cứu cho thấy việc tinh chỉnh khung làm việc thay vì thay đổi mô hình giúp các AI lập trình (như Qwen, Devstral) cải thiện đáng kể hiệu suất khi xử lý ngữ cảnh dài, với tỷ lệ giải quyết tác vụ thực tế tăng vọt trên SWE-bench.

Tibo@thsottiaux
Sản phẩmĐiểm AI 35/100

Ứng dụng ChatGPT trên máy tính tăng tốc tải hội thoại hơn 90%

Brent is one of the best things that happened to the quality and polish of the desktop app. Relent…

DịchBản cập nhật mới nhất cho ứng dụng ChatGPT trên máy tính đã tối ưu hóa hiệu suất vượt trội, giúp tốc độ tải các hội thoại dài nhanh hơn 90% và giảm đáng kể mức tiêu thụ bộ nhớ.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 46/100

CritICL: Tối ưu hóa suy luận cho mô hình lớn bằng cách học từ lỗi sai của mô hình nhỏ

Small models fail the same way big models do, so this paper shows you can collect a cheap model's mi…

DịchCritICL tận dụng các lỗi sai phổ biến từ mô hình nhỏ để tạo lời nhắc (prompt) thông minh cho mô hình lớn. Phương pháp này giúp mô hình lớn suy luận chính xác ngay từ lần thử đầu tiên thay vì phải lặp lại nhiều lần, giúp tiết kiệm tài nguyên đáng kể.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 48/100

Stanford giới thiệu Prefix Sliding: Tăng tốc suy luận cho mô hình AI lên gấp 3 lần

Banger paper from Stanford on efficient test-time scaling. If you run agents that think for a long …

DịchNghiên cứu mới từ Stanford đề xuất phương pháp Prefix Sliding giúp tối ưu bộ nhớ bằng cách lược bỏ các token trung gian trong quá trình suy luận. Kỹ thuật này tăng tốc độ xử lý gấp 3 lần mà không cần huấn luyện lại, hỗ trợ hiệu quả cho các chuỗi suy luận dài trên 100.000 token.

30/08

Chủ Nhật · 7 tin
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 38/100

MDA: Tác nhân AI ứng dụng Bayes để tối ưu hóa thiết kế thí nghiệm, tăng hiệu suất gấp 5 lần

Letting an LLM decide what to try next wastes experiments, and this paper shows that scoring its ide…

DịchModel Discovery Agent (MDA) kết hợp LLM với toán học Bayes để chọn lọc các thí nghiệm mang tính quyết định, giúp giảm đáng kể tài nguyên lãng phí. Công nghệ này đạt tỷ lệ thành công 93% trong các bài kiểm tra vật lý và rút ngắn thời gian nghiên cứu từ 41 xuống còn 8 thí nghiệm.

Elvis Saravia@omarsar0
Hướng dẫnĐiểm AI 46/100

Tối giản hóa 'harness' là chiến lược tối ưu dài hạn cho phát triển AI

Recommended read. It's an opinion, but increasingly I find myself doing the same. I've optimized f…

DịchChuyên gia Elvis Saravia khuyên nên ưu tiên các bộ khung (harness) tối giản để dễ dàng chuyển đổi giữa các mô hình, thay vì phụ thuộc vào các cấu hình phức tạp vốn dễ lỗi thời khi công nghệ thay đổi nhanh chóng.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 60/100

Nghiên cứu: AI lập trình ưu tiên đọc file hướng dẫn hơn là tài liệu API

Coding agents mostly read the instruction files and notes they were given or wrote themselves, so yo…

DịchNghiên cứu trên 33.000 PR cho thấy AI lập trình chủ yếu dựa vào các file chỉ dẫn (như CLAUDE.md) và ghi chú kế hoạch, thay vì tra cứu tài liệu API. Các nhà phát triển nên tập trung tối ưu hóa file hướng dẫn để cải thiện hiệu suất của AI.

JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnĐột phá mới: Mô hình Khám phá Lớn (LDM) giúp AI tự thiết kế thí nghiệm khoa học

Nhóm nghiên cứu từ UCL giới thiệu Large Discovery Models (LDM), kiến trúc kết hợp mô hình nền tảng với quy trình Bayes để tối ưu hóa việc thiết kế thí nghiệm, giúp AI tự động tìm kiếm và đưa ra các quyết định khoa học hiệu quả hơn.


Vì sao đáng đọc: Đây là nghiên cứu quan trọng kết hợp giữa AI tạo sinh và tối ưu hóa Bayes, mở ra hướng đi mới cho việc tự động hóa nghiên cứu khoa học với kết quả thực nghiệm ấn tượng.
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 40/100

Metan: Nghiên cứu mới từ ĐH Minnesota và ĐH Seoul về tác nhân AI tự cải tiến theo phân lớp

Most self-improving agents still refine answers inside a shallow loop; New research from Univ of M…

DịchMetan cho phép các tác nhân AI tự tối ưu hóa bằng cách xếp chồng các chiến lược mã nguồn theo từng lớp. Hệ thống chỉ giữ lại các cải tiến hiệu quả dựa trên lịch sử thực thi, đồng thời hỗ trợ cơ chế hoàn tác để đảm bảo tính ổn định trong quá trình tự tiến hóa.

29/08

Thứ Bảy · 4 tin
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 46/100

Cùng sự kiệnGoogle giới thiệu SKILL.state: Tối ưu hóa bộ nhớ cho AI Agent, giảm 16 lần lượng token

New Google paper makes a strong case for replacing ever-growing agent histories with a small, explic…

DịchGoogle đề xuất SKILL.state, phương pháp thay thế lịch sử hội thoại dài dòng bằng trạng thái thực thi rõ ràng. Giải pháp này giúp Gemini-3-Flash đạt độ chính xác cao hơn trong khi tiết kiệm tới 16,2 lần lượng token so với các phương pháp truyền thống.

Cùng sự kiện, bài đại diện «Google giới thiệu SKILL.state: Tối ưu hóa bộ nhớ cho AI tác vụ dài»
Sky Computing Lab@haoailab
Mô hìnhĐiểm AI 57/100

FastVideo ra mắt FastH3: Tạo video 15 giây chỉ trong 13 giây, nhanh gấp 14 lần

45% preferred FastVideo FastH3 or are neutral compared with @MiniMax_AI H3. Our open-weight FastH3…

DịchFastVideo vừa công bố bản xem trước FastH3, đạt tốc độ tạo video ấn tượng với hiệu suất nhanh gấp 14 lần so với MiniMax H3, trong khi vẫn duy trì chất lượng tương đương.

Thêm 1 nguồn khác đưa tinX: MiniMax (@MiniMax_AI)

28/08

Thứ Sáu · 7 tin
Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 32/100

Google đề xuất sử dụng cơ sở tri thức bền vững để tối ưu hóa kỹ năng cho AI Agent

A great paper from Google on maintaining agent skills through persistent knowledge.

DịchNghiên cứu mới từ Google giới thiệu phương pháp tách biệt quy trình thực thi, wiki tri thức và kỹ năng, giúp AI tích lũy kinh nghiệm hiệu quả. Kết quả cho thấy mô hình nhỏ có trang bị kỹ năng tiến hóa có thể vượt trội hơn các mô hình lớn mà không cần đào tạo lại.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 50/100

Self-OPD: Khung chưng cất mô hình Flow Matching tự thân không cần giáo viên

Self-OPD là khung chưng cất đồng chiến lược (OPD) loại bỏ nhu cầu về mô hình giáo viên, bằng cách tận dụng chính khả năng khám phá ngẫu nhiên của mô hình học sinh để tạo tín hiệu giám sát, từ đó giảm chi phí tính toán và sai số phân phối.

Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (100 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Tối ưu hóa” — Trang 9 | AIHOT.vn