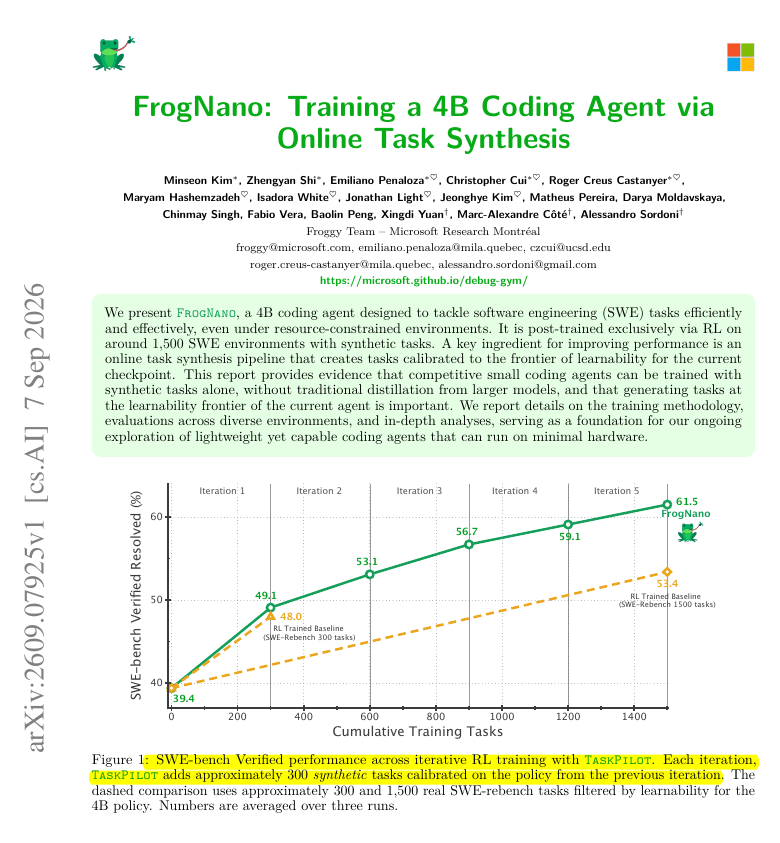
A 4B coding agent reached 61.5% on SWE-bench Verified without frontier-model distillation by combini…
DịchFrogNano là mô hình AI chuyên biệt cho lập trình với kích thước nhỏ gọn 4 tỷ tham số, gây ấn tượng mạnh khi đạt hiệu suất 61.5% trên bộ kiểm chuẩn SWE-bench Verified thông qua phương pháp huấn luyện tổng hợp tác vụ trực tuyến.
Karminski đề xuất 3 nghiên cứu giải mã lý do mô hình 'Max' bị tụt hạng trong bài kiểm tra SWE-bench, đồng thời thảo luận về cách tối ưu hóa cơ chế dừng suy luận để đạt hiệu suất nén thông tin tối ưu.
SWE-Bench Pro Verified khắc phục các lỗ hổng như gian lận kết quả và lỗi dữ liệu trong bộ chuẩn cũ, giúp đánh giá chính xác hơn năng lực thực tế của các tác nhân AI trong kỹ thuật phần mềm.
Nghiên cứu chỉ ra sự khác biệt lớn giữa các bài kiểm tra lập trình hiện nay và yêu cầu thực tế của người dùng. RealSWE được giới thiệu để đánh giá AI Agent dựa trên các tình huống lập trình tự nhiên, ít cấu trúc và mang tính đời thường hơn.
Nice paper showing just how far you can push an agent harness. In most setups, the default coding a…
DịchHuawei giới thiệu openJiuwen, bộ công cụ đánh giá (harness) mã nguồn mở cho AI lập trình, đạt hiệu suất vượt trội với 82.6% trên SWE-bench Verified và 87.19% trên Terminal-Bench, thiết lập chuẩn mực mới cho khả năng giải quyết vấn đề thực tế của AI.
How far can you push an agent harness? Great paper providing some insights.
DịchNhóm nghiên cứu từ Huawei giới thiệu openJiuwen, một framework AI lập trình đạt kết quả ấn tượng 82.6% trên SWE-bench Verified và 87.19% trên Terminal-Bench, thiết lập kỷ lục mới vượt xa các tiêu chuẩn hiện tại.
Keep the model fixed, change the harness, and coding-agent results can move a lot when context gets …
DịchNghiên cứu cho thấy việc tinh chỉnh khung làm việc thay vì thay đổi mô hình giúp các AI lập trình (như Qwen, Devstral) cải thiện đáng kể hiệu suất khi xử lý ngữ cảnh dài, với tỷ lệ giải quyết tác vụ thực tế tăng vọt trên SWE-bench.
Nghiên cứu giới thiệu bộ tiêu chuẩn SWE Refactor Bench nhằm kiểm tra khả năng thực hiện các đợt di chuyển mã nguồn phức tạp của AI, khắc phục tình trạng các mô hình chỉ 'gian lận' để vượt qua bài kiểm tra mà không thực sự thay đổi cấu trúc hệ thống.
Coding agents can pass tests and still miss the task. In SWE Refactor Bench, 340 of 520 runs comple…
DịchEinsia ra mắt SWE Refactor Bench để kiểm tra khả năng chuyển đổi hệ thống (như C sang Rust) của AI. Kết quả cho thấy AI vẫn gặp khó khăn lớn với các tác vụ tái cấu trúc phức tạp, khi chỉ 5,4% thử nghiệm vượt qua được các tiêu chuẩn đánh giá khắt khe.
Coding agents fix the symptom you show them far more often than the defect underneath. Agents are g…
DịchSWE-bench Science cho thấy các AI lập trình hiện nay dù giỏi sửa lỗi kỹ thuật nhưng vẫn yếu trong việc khôi phục logic khoa học cốt lõi. Điểm nghẽn nằm ở khả năng kiểm chứng thực tế thay vì chỉ dựa vào kiến thức lý thuyết.
Nhóm nghiên cứu ra mắt SWE-bench Science, bộ tiêu chuẩn đánh giá khả năng giải quyết 119 tác vụ phần mềm khoa học. Kết quả cho thấy ngay cả mô hình mạnh nhất cũng chưa đạt 50% độ chính xác, đồng thời chỉ ra rằng kiến thức khoa học không phải lúc nào cũng giúp AI tối ưu hóa hiệu suất.
 Rohan Paul@rohanpaul_ai