16/09

Thứ Tư · 39 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnGavel: Tối ưu hóa điều hướng kỹ năng cho LLM mà không cần nhồi nhét ngữ cảnh

Gavel là phương pháp mới giúp LLM tự chọn kỹ năng phù hợp thông qua các ánh xạ tuyến tính thay vì nhồi nhét metadata vào ngữ cảnh, giúp mở rộng thư viện kỹ năng mà không làm giảm hiệu suất của mô hình.


Vì sao đáng đọc: Giải quyết vấn đề thực tế về giới hạn ngữ cảnh trong các tác nhân AI (AI agents), phương pháp tiếp cận thông minh và hiệu quả về tài nguyên.

Ethan Mollick@emollick
NgànhĐiểm AI 27/100

Các phòng thí nghiệm AI có đang 'găm hàng' tri thức vì sợ khủng hoảng truyền thông?

I don't usually spread rumors but: 1) This is from someone with inside knowledge & is plausible …

DịchTrước áp lực dư luận, các phòng thí nghiệm AI có thể đang hạn chế chia sẻ nghiên cứu để tránh rủi ro truyền thông. Đây là vấn đề chính sách quan trọng cần được xem xét nghiêm túc trong cộng đồng khoa học.

Haider@haider1
NgànhĐiểm AI 39/100

Noam Brown (OpenAI): AI sắp bắt kịp con người về tư duy nghiên cứu

OpenAI Research Scientist, Noam Brown: "current models are still poor when it comes to research tas…

DịchNhà nghiên cứu Noam Brown từ OpenAI nhận định AI hiện vẫn kém con người về tư duy nghiên cứu, nhưng ông sẽ không ngạc nhiên nếu các thế hệ mô hình tiếp theo vượt qua chính mình trong lĩnh vực này.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 92/100

Tinh chọnNever Give Up: Tối ưu hóa học tăng cường cho LLM bằng cách tập trung vào các bài toán khó

Nghiên cứu chỉ ra rằng RL hiện nay thường lãng phí tài nguyên vào các bài toán dễ. Phương pháp Never Give Up (NGU) đề xuất cơ chế lấy mẫu thích ứng, giúp phân bổ lại tài nguyên tính toán để giải quyết hiệu quả các bài toán khó mà mô hình chưa làm tốt.


Vì sao đáng đọc: Đề xuất giải pháp thực tiễn cho vấn đề 'Hiệu ứng Matthew' trong RL, giúp cải thiện hiệu suất huấn luyện LLM một cách thông minh và tiết kiệm tài nguyên.
Nathan Lambert@natolambert
NgànhĐiểm AI 43/100

Never Give Up: Phương pháp mới giúp GRPO chinh phục các bài toán khó

An basic idea in scaling RL: Can we allocate more compute to the harder problems? We did this: If …

DịchNghiên cứu mới giải quyết 'hiệu ứng Matthew' trong học tăng cường (RL) bằng cách buộc mô hình tiếp tục lấy mẫu khi gặp câu trả lời sai, giúp GRPO vượt qua giới hạn ở các bài toán phức tạp.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 61/100

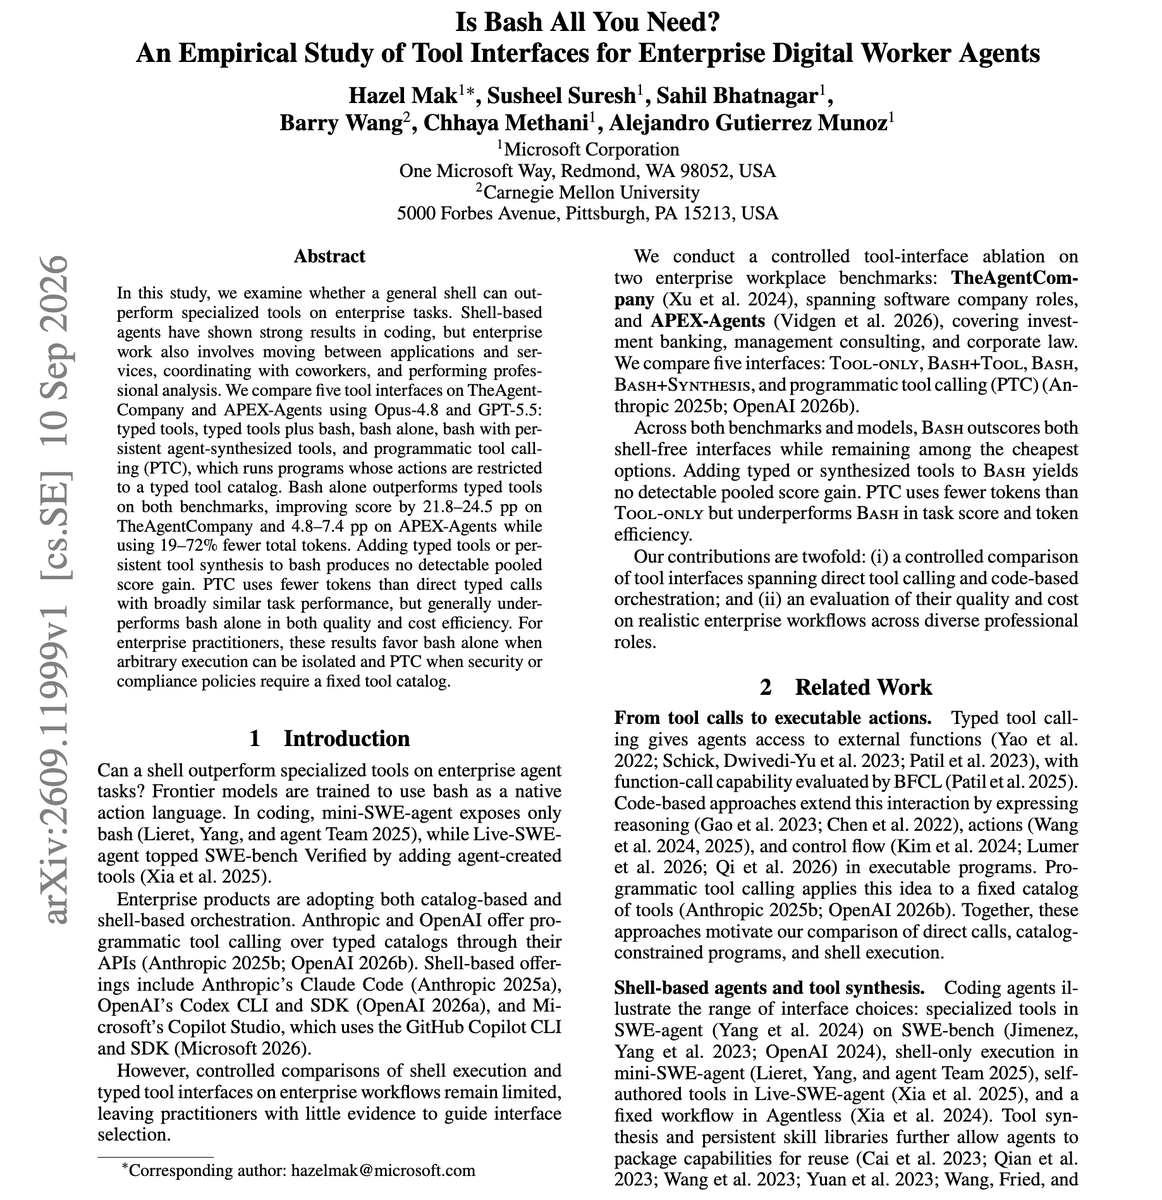
Nghiên cứu từ Microsoft: Bash vượt trội hơn các giao diện công cụ truyền thống trong tác vụ AI Agent

Is Bash All You Need? Interesting paper from Microsoft. If you are deciding which tools to give an…

DịchMicrosoft so sánh 5 giao diện công cụ trên các nền tảng TheAgentCompany và APEX-Agents, kết quả cho thấy Bash mang lại hiệu suất vượt trội khi vận hành cùng các mô hình như Opus-4.8 và GPT-5.5.

Rohan Paul@rohanpaul_ai
NgànhĐiểm AI 36/100

PhAI Labs ra mắt DFM: Mô hình nền tảng thúc đẩy khám phá khoa học tự động

This is really cool. PhAI Labs just released DFM (Discovery Foundation Models), a research paradigm…

DịchPhAI Labs công bố báo cáo kỹ thuật về Discovery Foundation Models (DFM), hướng tới hệ thống AI có khả năng tự đặt giả thuyết, thiết kế thí nghiệm và tinh chỉnh kiến thức khoa học. Dự án hiện đang mở rộng hợp tác với các cộng đồng nghiên cứu và phòng thí nghiệm thực tế.

15/09

Thứ Ba · 31 tin
Hugging Face: Blog
Nghiên cứuĐiểm AI 56/100

IBM Research ra mắt ALTK-Evolve: Cải thiện độ ổn định cho AI Agent, giảm 50% sai lệch kết quả

IBM Research giới thiệu Consistency Analyzer và bộ hướng dẫn nhất quán trong ALTK-Evolve, giúp giải quyết vấn đề kết quả thiếu ổn định khi AI Agent thực hiện lặp lại cùng một tác vụ, giảm đáng kể khoảng cách sai lệch trên AppWorld.

IBM Research: AI
NgànhĐiểm AI 45/100

IBM Research chứng minh ưu thế vượt trội của mạch lượng tử nông so với mô hình ngôn ngữ lớn

Nghiên cứu mới từ IBM chỉ ra rằng các mạch lượng tử độ sâu thấp có thể giải quyết những bài toán tính toán phức tạp mà các mô hình Transformer như GPT hay Llama cần nguồn lực khổng lồ mới xử lý được, khẳng định ranh giới lý thuyết giữa hai công nghệ.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Tư duy thiếu tính hệ thống? Đánh giá khả năng suy luận của các mô hình AI qua bài toán quy nạp quy tắc

Nghiên cứu chỉ ra rằng các mô hình AI hiện nay thường thất bại khi đối mặt với các biến thể tương đương về mặt cấu trúc của cùng một bài toán, cho thấy tư duy của chúng thiếu tính hệ thống so với nhận thức con người.

JiQiZhiXin
NgànhĐiểm AI 92/100

Tinh chọnTừ Chat, Code đến Discovery: Khi AI bắt đầu học cách làm nhà khoa học

AI đang tiến hóa từ việc trò chuyện và lập trình sang khả năng tự thực hiện các khám phá khoa học. Các phòng thí nghiệm hàng đầu đang đặt cược vào việc để AI tự đề xuất, thực hiện thí nghiệm và phân tích kết quả, mở ra kỷ nguyên mới cho tri thức nhân loại.


Vì sao đáng đọc: Bài viết phân tích sâu sắc xu hướng chuyển dịch của AI từ công cụ hỗ trợ sang thực thể tự nghiên cứu, có tính thời sự cao và tầm nhìn chiến lược về tương lai công nghệ.
JiQiZhiXin
NgànhĐiểm AI 92/100

Tinh chọnCơ hội nhận học bổng toàn phần tại MBZUAI: Đại học AI top 10 thế giới chính thức mở đơn tuyển sinh

Đại học Trí tuệ Nhân tạo Mohamed bin Zayed (MBZUAI) vừa mở đơn tuyển sinh cho kỳ nhập học mùa thu 2027 với chính sách học bổng toàn phần hấp dẫn. Đây là cơ hội hiếm có để theo học tại ngôi trường đang dẫn đầu thế giới về nghiên cứu AI và hợp tác chiến lược với các tên tuổi lớn như OpenAI hay MIT.


Vì sao đáng đọc: Tin tức có giá trị cao cho cộng đồng học thuật và người quan tâm đến du học ngành AI, thông tin cụ thể về học bổng và uy tín của trường rất thu hút.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 50/100

Nghiên cứu về Orthrus: Giải mã suy luận không mất dữ liệu chỉ đạt độ chính xác 40% ở định dạng BF16

Các nhà nghiên cứu đã kiểm chứng phương pháp giải mã suy luận của Orthrus và phát hiện rằng ở định dạng BF16, tỷ lệ khớp hoàn toàn chỉ đạt khoảng 40%, trong khi độ chính xác tuyệt đối chỉ đạt được khi sử dụng FP32.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 52/100

ModaLens: Phương pháp kiểm định mới đánh giá độ phụ thuộc vào hình ảnh của mô hình VLM y tế

Nghiên cứu giới thiệu ModaLens, kỹ thuật thay thế hình ảnh theo cặp để đo lường mức độ ảnh hưởng của báo cáo chẩn đoán đến khả năng phân tích hình ảnh thực tế của các mô hình thị giác ngôn ngữ (VLM) trong y tế.

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
NgànhĐiểm AI 48/100

Thay thế lan truyền ngược: Sakana AI giới thiệu phương pháp huấn luyện mạng thần kinh mới PC-ALM

Sakana AI ra mắt PC-ALM, phương pháp sử dụng động lực học cục bộ thay thế lan truyền ngược để huấn luyện mạng MLP 1000 lớp, đạt hiệu suất tương đương với các kỹ thuật truyền thống.

QbitAI
Nghiên cứuĐiểm AI 88/100

Tinh chọnNghiên cứu mới từ Meta: Chưng cất mô hình Byte giúp phá vỡ giới hạn hiệu năng

Meta vừa công bố phương pháp chưng cất mô hình mới giúp các mô hình Byte vượt qua giới hạn hiệu suất truyền thống, mở ra hướng đi đột phá cho việc tối ưu hóa AI.


Vì sao đáng đọc: Đây là bước tiến kỹ thuật quan trọng trong lĩnh vực nén và tối ưu hóa mô hình ngôn ngữ, có tính ứng dụng cao cho cộng đồng nghiên cứu AI.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnAlayaVista: Mô hình thế giới video streaming kết hợp toàn cảnh và góc nhìn chi tiết

AlayaVista là mô hình thế giới video mới giúp tách biệt quá trình tiến hóa của bối cảnh toàn cảnh 360 độ với việc tổng hợp hình ảnh góc nhìn chi tiết, cho phép điều khiển camera mượt mà và duy trì độ trung thực cao.


Vì sao đáng đọc: Đột phá trong cách xử lý bối cảnh 360 độ kết hợp với video streaming, giải quyết hiệu quả bài toán đánh đổi giữa tầm nhìn bao quát và độ chi tiết trong mô hình thế giới.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 45/100

RSIAgent: Bước tiến mới trong tự cải tiến đệ quy thông qua bộ nhớ tự chủ

RSIAgent là khung đa tác tử không cần huấn luyện, giúp AI tự khám phá môi trường và xây dựng bộ nhớ dùng chung để tối ưu hóa hiệu suất. Phương pháp này giúp các mô hình mã nguồn mở như Kimi và GLM vượt qua cả những mô hình đóng hàng đầu hiện nay.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 44/100

HazardAuditor: Khung bảo mật giúp kiểm soát và giám sát các tác nhân AI tự hành

HazardAuditor là khung bảo mật cấp thực thi cho phép giám sát tập trung các tác nhân AI như Claude Code hay Codex trong môi trường an toàn, giúp chuẩn hóa hành vi và ngăn chặn rủi ro khi AI tương tác với máy tính.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 60/100

Phân tích Elo-per-token: Hiệu suất giảm dần của chiến lược tính toán trên LLM Agent

Nghiên cứu giới thiệu phương pháp Elo-per-token sử dụng mô hình Bradley-Terry để đánh giá hiệu quả của việc tăng cường tài nguyên tính toán trong quá trình suy luận của LLM Agent, từ đó chỉ ra quy luật lợi nhuận giảm dần.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 43/100

Vibe Design Agents: Bước tiến mới trong việc tự động hóa thiết kế sáng tạo

Nghiên cứu giới thiệu kiến trúc suy luận tách biệt quá trình khám phá ý tưởng và thực thi thiết kế, giúp AI tạo ra các giao diện có tính thẩm mỹ cao thông qua việc chuẩn hóa quy trình ra quyết định.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 49/100

KaiNinja: Bước tiến mới trong tạo mô hình 3D chi tiết đến từng bộ phận

KaiNinja nâng cấp mô hình TRELLIS.2 bằng cách sử dụng biểu diễn thể tích kép, cho phép tạo các mô hình 3D với các khớp nối chi tiết mà không cần đến công cụ phân tách phức tạp, đồng thời vẫn giữ nguyên tốc độ và chất lượng vượt trội.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Mô hìnhĐiểm AI 59/100

Ra mắt Atria Dawn Preview: Mô hình nền tảng cho tác nhân AI trong nghiên cứu và kỹ thuật

Atria Dawn Preview là mô hình ngôn ngữ nền tảng được tối ưu cho quy trình nghiên cứu và kỹ thuật, sử dụng quy trình Verifiable Experience Pipeline để kết nối tương tác công cụ với môi trường thực thi và kiểm chứng kết quả.

QbitAI
Mô hìnhĐiểm AI 92/100

Tinh chọn7 nghiên cứu sinh đào tạo mô hình 7B từ con số 0 chỉ trong 3 tháng: Công khai toàn bộ mã nguồn và dữ liệu

Một nhóm nghiên cứu sinh đã huy động hàng trăm AI Agent để tự động hóa quy trình phát triển, đánh dấu bước tiến mới trong việc dùng AI để tạo ra AI.


Vì sao đáng đọc: Tin tức mang tính đột phá về quy trình đào tạo mô hình ngôn ngữ lớn, minh bạch hóa dữ liệu và ứng dụng AI Agent trong nghiên cứu, rất có giá trị tham khảo cho cộng đồng kỹ thuật.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 43/100

Không phải prompt nào cũng như nhau: Khung hướng dẫn khám phá cho hậu huấn luyện RL đa phương thức

Nghiên cứu giới thiệu khung 'Exploration-Guided Prompt Scaffolding' giúp tối ưu hóa hậu huấn luyện RL cho mô hình đa phương thức (MLLM) thông qua chỉ số EPS, giúp đánh giá tiềm năng khám phá mà không tốn thêm chi phí tính toán.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 46/100

Omni-Streaming Thinking: Giải pháp ngăn chặn AI đa phương thức đưa ra kết luận vội vàng

Omni-Streaming Thinking (OST) giúp mô hình AI phân tách dữ liệu thành bằng chứng và dự đoán, cho phép kiểm chứng thông tin theo thời gian thực để tránh sai sót khi xử lý dữ liệu đa phương thức.

Thariq@trq212
NgànhĐiểm AI 10/100

Thariq chia sẻ về tập podcast chuyên sâu về không gian tiềm ẩn (latent space)

just finished recording on latent space I'm excited about this one- we get very technical about thi…

DịchThariq vừa hoàn thành ghi hình tập podcast mới, nơi anh đi sâu vào các chi tiết kỹ thuật chuyên môn về không gian tiềm ẩn (latent space) mà trước đây ít được đề cập.

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Nghiên cứuĐiểm AI 60/100

Nghiên cứu mới giải mã lý do các tác nhân AI không bị quá khớp (overfitting)

Nghiên cứu chỉ ra rằng các chiến lược có thể nén vào ít token sẽ không bị quá khớp. Phương pháp nén này giúp kiểm chứng hiệu năng thực tế của tác nhân AI, đồng thời là công cụ hiệu quả để phát hiện tình trạng quá khớp trong quá trình huấn luyện.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnMobileVLA-R1 2.0: Bước tiến mới trong điều khiển robot di động nhờ suy luận tăng cường RL

MobileVLA-R1 2.0 kết hợp suy luận có cấu trúc với học tăng cường (RL) để thu hẹp khoảng cách giữa tư duy ngôn ngữ cấp cao và hành động điều khiển robot chính xác, giúp robot thực hiện các nhiệm vụ phức tạp hiệu quả hơn.


Vì sao đáng đọc: Đây là nghiên cứu quan trọng trong lĩnh vực robot học, giải quyết bài toán hóc búa về sự nhất quán giữa suy luận và hành động thực tế bằng kỹ thuật CoT và RL.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Tối ưu hóa dự báo sự kiện: Kết hợp mô hình ngôn ngữ và dữ liệu thực tế thông qua cơ chế Competence-Gated Pooling

Nghiên cứu giới thiệu cơ chế 'cổng năng lực' giúp đánh giá và kết hợp thông minh các dự báo từ mô hình ngôn ngữ với dữ liệu thị trường sẵn có, giúp cải thiện đáng kể độ chính xác của các dự báo sự kiện thực tế.

Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (55 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Nghiên cứu AI” — Trang 8 | AIHOT.vn