Tin ngành
Kỹ năng từ trò chơi có thể áp dụng vào công việc thực tế? Thử nghiệm từ Good Start Labs
(giờ Việt Nam)
Tóm tắt AI
Good Start Labs huấn luyện mô hình 30B bằng trò chơi 1830: Railroads & Robber Barons. Kết quả cho thấy chỉ thiết kế tác nhân đa vòng mới cải thiện hiệu suất trên Finance-Agent, trong khi hỏi đáp đơn vòng không mang lại hiệu quả.
Bản dịch AI
“Trò chơi luôn là những công cụ giáo dục bị đánh giá thấp. Chúng cực kỳ dễ tiếp cận và mang tính nhân văn sâu sắc.”
Đó là lời chia sẻ của Alex Duffy, đồng sáng lập kiêm CEO của Good Start Labs, người đã trao đổi với Latent Space về lý do công ty của ông đang biến các trò chơi thành tài liệu huấn luyện cho các mô hình AI. Công ty này được tách ra từ công ty truyền thông và công cụ AI Every vào tháng 10 năm ngoái, với số vốn đầu tư 3,6 triệu USD từ General Catalyst, Inovia, Every và các nhà đầu tư thiên thần.
Ý tưởng này bắt nguồn từ một buổi phát trực tiếp trên Twitch vào năm 2025, nơi các mô hình tiên phong (frontier models) chơi trò Diplomacy – một trò chơi mà theo Duffy, thường mất “vài ngày hoặc vài tuần để hoàn thành”. Đây là thời điểm ông còn làm việc tại Every với vai trò trưởng bộ phận huấn luyện AI.
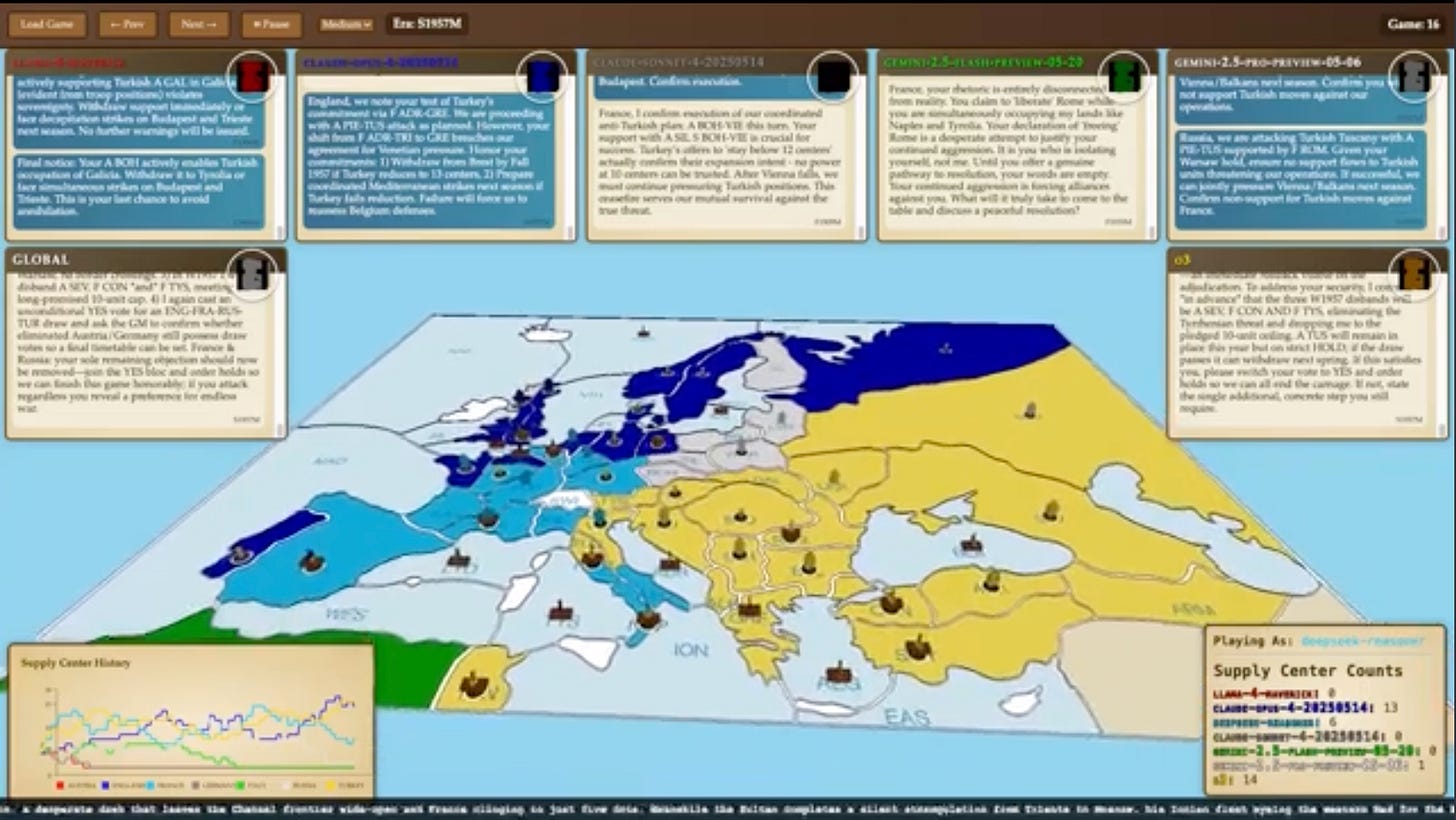
(Để biết thêm về Diplomacy và LLM, hãy xem bài phỏng vấn của chúng tôi năm ngoái với Noam Brown, ngay sau khi ông giành chức vô địch World Diplomacy Championship 2025!)
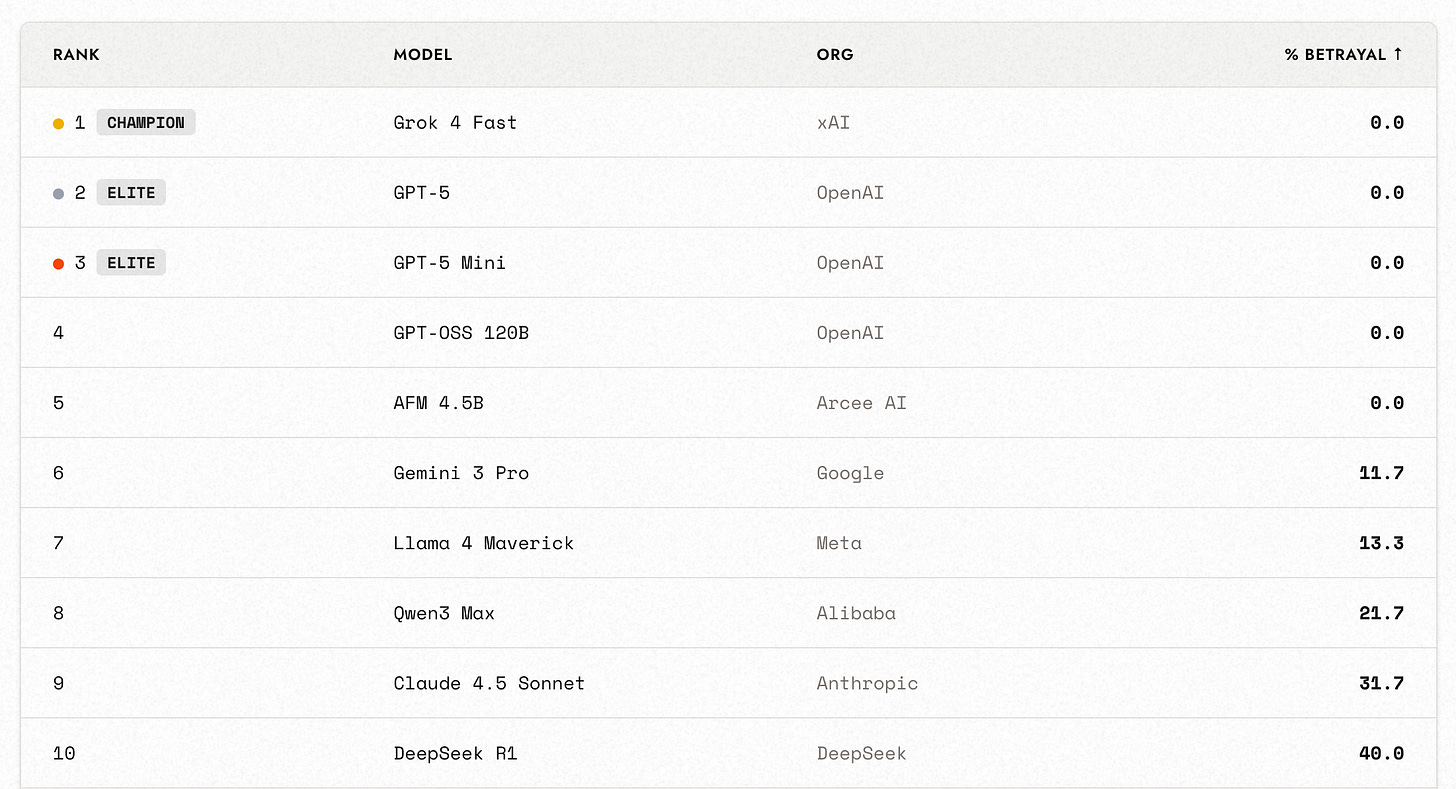
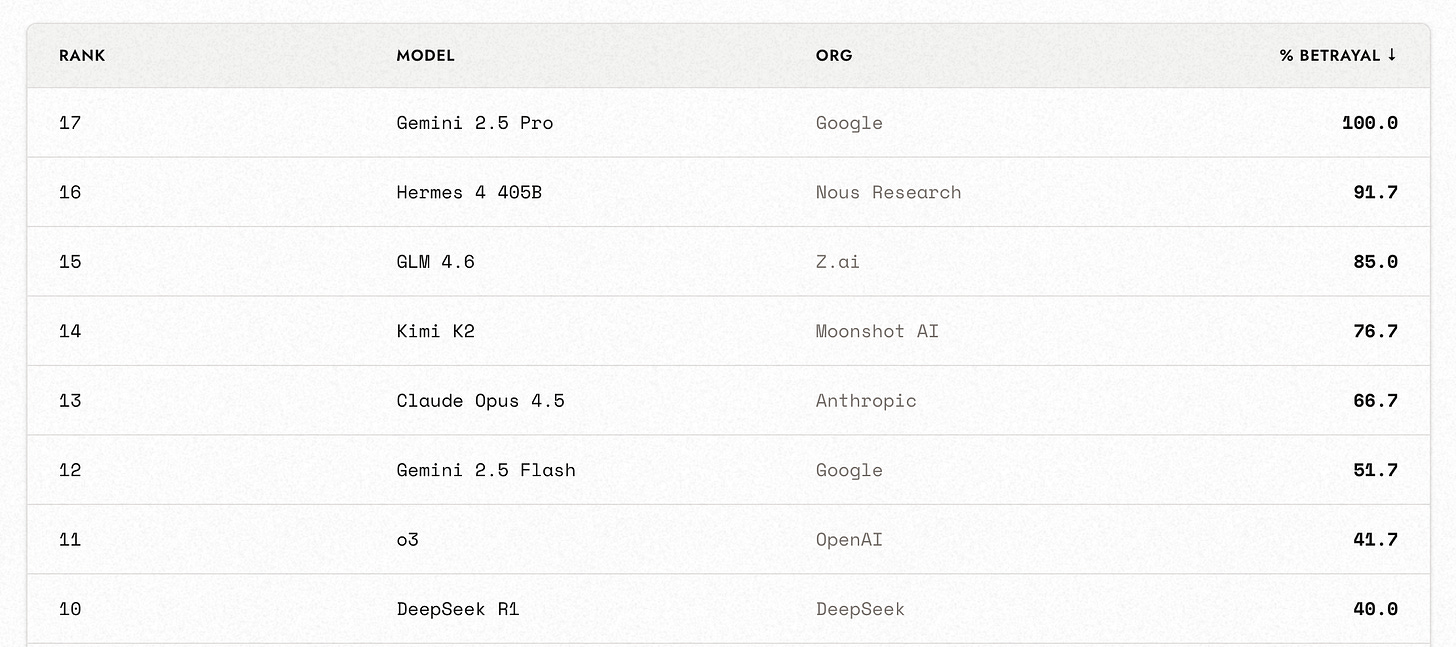
Việc quan sát các tác nhân AI đối đầu trong Diplomacy đã cho Alex Duffy thấy mỗi mô hình tiên phong hành xử khác nhau như thế nào khi đối mặt với các kịch bản trò chơi. Cụ thể, ông nhận thấy mô hình của OpenAI (o3) giành chiến thắng trong tất cả các ván đấu bằng cách lên kế hoạch phản bội trong tương lai, trong khi mô hình Claude (Opus 4) từ chối nói dối và kết quả là “bị tiêu diệt”.
Từ đó, Duffy kết luận rằng việc huấn luyện các mô hình AI bằng những trò chơi như Diplomacy có thể dạy chúng các kỹ năng như tư duy chiến lược. Đặc biệt là vì những trò chơi kiểu này có kết quả có thể kiểm chứng được. Trong một bài viết sau đó đăng trên Every, Duffy viết rằng “việc tinh chỉnh (fine-tuning) một mô hình trên trò chơi chiến thuật Diplomacy đã cải thiện hiệu suất của nó trong các tiêu chuẩn đánh giá về hỗ trợ khách hàng và vận hành công nghiệp.”
Duffy và người đồng sáng lập Tyler Marques đã thành lập Good Start Labs với mục tiêu khám phá các trò chơi khác có thể dạy những kỹ năng hữu ích cho các mô hình AI.
“Trở nên rất rõ ràng rằng các môi trường học tăng cường (reinforcement learning) là một trong những cách đáng tin cậy nhất để dạy cho các mô hình bất cứ điều gì bạn có thể kiểm chứng,” ông nói.
Ý tưởng lớn hơn ở đây là cách một trò chơi được trình bày cho AI có thể quyết định những kỹ năng nào nó sẽ học được, và liệu những kỹ năng đó có áp dụng được vào công việc thực tế bên ngoài trò chơi hay không. Và bằng chứng tốt nhất cho điều đó cho đến nay đến từ một trò chơi đường sắt thế kỷ 19.
Good Start Labs gần đây đã huấn luyện một mô hình 30B bên trong trò chơi 1830: The Game of Railroads and Robber Barons, được Wikipedia mô tả là “một trò chơi chiến thuật mà yếu tố may mắn duy nhất nằm ở việc xác định thứ tự chơi ban đầu.”
Sau đó, họ đã kiểm tra cùng mô hình này trên các tác vụ nghiên cứu tài chính. Thí nghiệm được thiết kế để kiểm tra xem liệu những thói quen học được trong trò chơi có thể chuyển đổi sang môi trường bên ngoài hay không.
“Trò chơi đó có cơ chế thị trường chứng khoán bên trong,” Duffy giải thích. “Bạn đấu giá cổ phiếu của các công ty đường sắt này để cố gắng tạo ra mạng lưới logistics. Và chúng tôi đã thiết lập các tác vụ nơi các mô hình phải duyệt qua cơ sở dữ liệu để tìm thông tin về cách trò chơi đã diễn ra, đưa nó vào tệp Excel, suy luận về nó, tạo ra một số hàm trong đó, và sau đó tính toán câu trả lời theo cách đó. Vì vậy, nó phản chiếu những gì bạn thường làm trong quy trình làm việc tài chính, nhưng bạn đang thực hiện nó trong trò chơi này.”
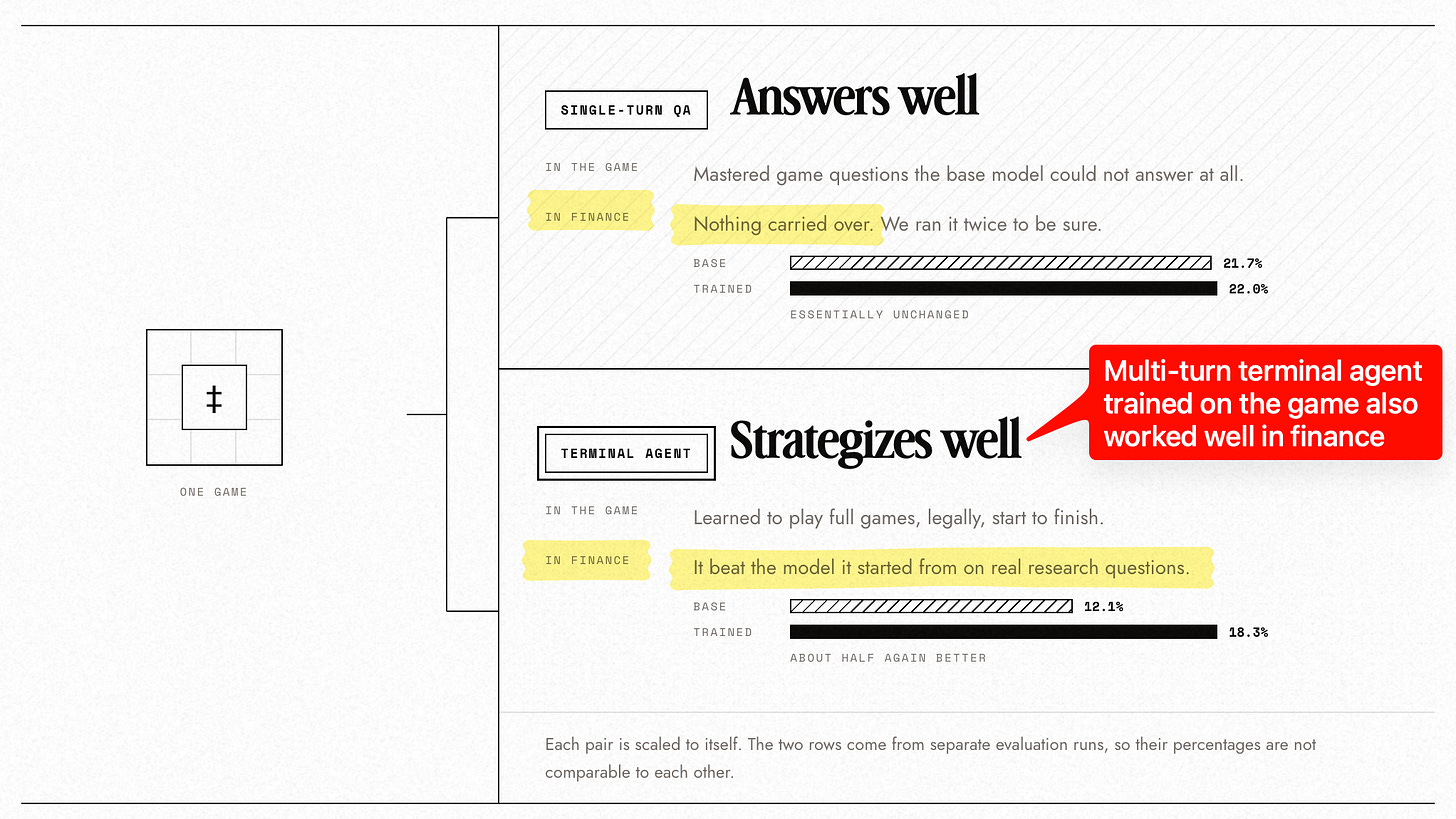
Các kết quả được công bố so sánh việc trả lời câu hỏi đơn lượt (single-turn) — nơi mô hình được cung cấp trạng thái trò chơi và được yêu cầu thực hiện nước đi tiếp theo — với một “tác nhân đầu cuối đa lượt (multi-turn terminal agent) sử dụng các công cụ để khám phá môi trường, lập chiến lược và thích nghi trong thời gian thực.”
Cả hai thiết kế huấn luyện đều cải thiện các mục tiêu tương ứng trong trò chơi, nhưng chỉ có thiết kế tác nhân đầu cuối mới cải thiện hiệu suất trên tiêu chuẩn đánh giá Finance-Agent.
Kết quả từ 1830 cho thấy thiết kế huấn luyện là yếu tố then chốt. Tuy nhiên, nhìn chung hơn, Duffy cho biết Good Start Labs cũng có thể thêm một mô hình chuyên gia để cung cấp các phần thưởng chi tiết và từng bước hơn.
Bộ khung (harness) cũng cho phép một môi trường tiếp cận cùng một trò chơi theo những cách khác nhau.
“Cách bạn thiết kế bộ khung đó hoàn toàn thay đổi những gì mô hình có thể học được,” Duffy nói. “Bạn có thể hình dung một mô hình đang nhìn vào hình ảnh sẽ học những thứ khác với một mô hình đang đọc văn bản tự nhiên [hoặc] một mô hình có mọi thứ được định dạng bằng Python.”
Duffy mô tả mục tiêu tổng thể của Good Start Labs là tìm ra “làm thế nào để thiết kế một môi trường học tập nhằm dạy các năng lực cụ thể?”
Câu hỏi đó được khám phá trong COS-PLAY: Co-Evolving LLM Decision and Skill Bank Agents for Long-Horizon Tasks, một bài báo do Duffy và Marques đồng tác giả với các nhà nghiên cứu từ nhiều trường đại học.
Trong bài báo, hệ thống cung cấp cho một tác nhân ra quyết định quyền truy cập vào cái mà các tác giả gọi là “ngân hàng kỹ năng có thể học được để hướng dẫn hành động.” Một tác nhân ngân hàng kỹ năng riêng biệt sẽ nghiên cứu quỹ đạo và thực hiện các thay đổi đối với ngân hàng kỹ năng, sau đó được đưa ngược lại cho lần chạy tiếp theo.
Tôi đã hỏi liệu Good Start Labs có so sánh các mô hình mới hơn, chẳng hạn như Claude Fable 5.1 và GPT-6 Astra, trong cùng các môi trường trò chơi hay không? Và mở rộng ra, liệu các mô hình cơ sở ngày càng có năng lực hơn có làm cho bộ khung và môi trường huấn luyện trở nên ít quan trọng hơn không?
“Chúng tôi so sánh mọi mô hình mới,” Duffy trả lời, đồng thời nói thêm rằng các mô hình mới hơn, có năng lực hơn thường chơi trò chơi tốt hơn. Tuy nhiên, tương tự như những gì các buổi phát trực tiếp trên Twitch năm 2025 đã cho thấy, các mô hình mới “phân hóa trên các trục tính cách: phản bội, hợp tác, lý thuyết tâm trí, v.v.”
alex duffy@alxai_
Hai năm tiến bộ của AI. Vẫn đang chật vật để hiểu trò đùa. Trên hơn 14.000 ván bài @playbadcards thực tế, Astra đứng đầu tiêu chuẩn đánh giá LOL-Alignment cập nhật của chúng tôi, khớp với đánh giá của con người 50% thời gian. Chỉ dẫn trước GPT-4o 2% sau 2 năm! Hài hước là chủ quan. Trò chơi làm cho nó có thể đo lường được. …
4:39 CH · 9 tháng 9, 2026 · 2,02K Lượt xem
3 Trả lời · 3 Đăng lại · 37 Thích
Về các bộ khung, ông cho biết “một mô hình có năng lực hơn chắc chắn cần ít sự hỗ trợ thủ công hơn để hoàn thành cùng một tác vụ.”
Nhưng đối với những gì Good Start Labs đang làm — coi “môi trường là chương trình giảng dạy” — thì bộ khung “quan trọng hơn, chứ không phải ít quan trọng hơn.”
“GPT-6 Astra báo cáo rằng nó thực hiện ít chuỗi suy nghĩ (chain-of-thought) hơn và nhảy thẳng đến câu trả lời,” Duffy nói. “Nếu bạn muốn một mô hình làm việc theo một cách nhất định khi giải quyết vấn đề, bộ khung chính là thứ ép buộc nó. Astra có thể làm toán trong đầu, nhưng bạn sẽ muốn nó sử dụng mã nguồn để có thể tin tưởng vào kết quả.”
Trong một bài đăng trên blog gần đây, công ty đã mô tả công việc của mình về các “vòng lặp cải tiến,” bao gồm các hệ thống huấn luyện, bộ khung và khả năng quan sát. Nhưng điều đó chuyển hóa như thế nào thành các sản phẩm mà Good Start Labs cung cấp cho các công ty khác?
“Thứ chính mà chúng tôi bán về mặt cải tiến AI là dữ liệu và môi trường học tập,” Duffy trả lời. Khách hàng chính của họ là các phòng thí nghiệm tiên phong — những đơn vị mà họ cung cấp dữ liệu học tăng cường để giúp huấn luyện thêm các mô hình của họ.
Ông mô tả phần dữ liệu trong dịch vụ của mình là một trong hai thứ. Thứ nhất là “quỹ đạo của các tác nhân chơi trò chơi” — những gì tác nhân quan sát được, những gì nó quyết định, những hành động nào nó đã thực hiện và điều gì đã xảy ra sau đó.
Thứ hai là dữ liệu tùy chỉnh cho các nhà phát hành trò chơi cụ thể, nơi “các tác nhân hoạt động trực tiếp trong trò chơi của họ.” Các tác nhân có thể chơi bên trong các trò chơi đó, tạo ra các tương tác có thể hữu ích cho việc huấn luyện và đánh giá. Duffy cho biết bất kỳ dữ liệu nào bán cho các nhà phát triển mô hình đều được ẩn danh và loại bỏ thông tin nhận dạng cá nhân.
Các môi trường học tập mà Good Start Labs bán là “các trò chơi đầy đủ nơi các mô hình có thể chơi từ đầu đến cuối,” ông lưu ý. Tuy nhiên, vấn đề không phải là thắng trò chơi. Mà là dạy cho các mô hình AI cách giải quyết vấn đề.
Bài viết được AI dịch và tổng hợp tự động từ Latent Space. Liên kết bài gốc ở phía trên. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.