16/09

Thứ Tư · 39 tin
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 59/100

Tại sao tôi vẫn hoài nghi về LLM dù chúng đã giải được phương trình Navier-Stokes?

Tác giả lập luận rằng việc LLM giải được toán học thuần túy không đồng nghĩa với khả năng tự động hóa tri thức, vì các mô hình hiện nay vẫn dễ thất bại ngoài phạm vi huấn luyện và thiếu tính kiểm chứng nghiêm ngặt như các định lý toán học.

IT Home
Mô hìnhĐiểm AI 73/100

Cùng sự kiệnGoogle ra mắt Gemini 3.8 Live: Đột phá hội thoại thời gian thực với khả năng suy luận chuyên sâu

Google vừa giới thiệu Gemini 3.8 Live và phiên bản Extended Thinking, hỗ trợ 97 ngôn ngữ. Trong đó, bản tiêu chuẩn tối ưu chi phí, còn bản Extended tập trung vào các tác vụ suy luận đa bước phức tạp.

Cùng sự kiện, tinh chọn hiển thị «Google DeepMind ra mắt Gemini 3.8 Live và bản Extended Thinking: Đột phá mới cho trợ lý giọng nói»
Elvis Saravia@omarsar0
NgànhĐiểm AI 32/100

Elvis Saravia: MCP vượt trội hơn CLI trong hầu hết các kịch bản tích hợp AI

I agree. MCP is clearly better than CLI for most integrations. It felt that way early on, and it sti…

DịchElvis Saravia khẳng định MCP ưu việt hơn CLI nhờ khả năng gọi công cụ mạnh mẽ, hỗ trợ tải chậm và kiến trúc không trạng thái, đồng thời khuyến nghị sử dụng MCP cho các hệ thống tùy chỉnh.

Rohan Paul@rohanpaul_ai
Mô hìnhĐiểm AI 73/100

Cùng sự kiệnGoogle ra mắt Gemini 3.8 Live: Đỉnh cao mới trong công nghệ hội thoại giọng nói

Google released Gemini 3.8 Live and Gemini 3.8 Live Extended Thinking And now it takes the #1 overa…

DịchGoogle vừa trình làng Gemini 3.8 Live và bản Extended Thinking, chính thức soán ngôi đầu bảng xếp hạng Artificial Analysis về khả năng tương tác giọng nói, vượt qua GPT-Live-1 Astra với hiệu suất ấn tượng 82,6%.

Cùng sự kiện, tinh chọn hiển thị «Google DeepMind ra mắt Gemini 3.8 Live và bản Extended Thinking: Đột phá mới cho trợ lý giọng nói»
Rohan Paul@rohanpaul_ai
NgànhĐiểm AI 33/100

Cùng sự kiệnTypeSafe AI ra mắt mô hình quyết định Jev: Tốc độ nhanh gấp 200 lần LLM truyền thống

Another brilliant launch for developers: and its 20-200x faster than LLMs because it skips token-by-…

DịchTypeSafe AI vừa giới thiệu Jev, mô hình AI đột phá bỏ qua cơ chế tạo token tuần tự, giúp tăng tốc độ phản hồi lên gấp 200 lần và giảm chi phí vận hành tới 400 lần so với các LLM hiện nay.

Cùng sự kiện, bài đại diện «Jev ra mắt: Mô hình ra quyết định nhanh gấp 200 lần và rẻ gấp 400 lần LLM»
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 92/100

Tinh chọnNever Give Up: Tối ưu hóa học tăng cường cho LLM bằng cách tập trung vào các bài toán khó

Nghiên cứu chỉ ra rằng RL hiện nay thường lãng phí tài nguyên vào các bài toán dễ. Phương pháp Never Give Up (NGU) đề xuất cơ chế lấy mẫu thích ứng, giúp phân bổ lại tài nguyên tính toán để giải quyết hiệu quả các bài toán khó mà mô hình chưa làm tốt.


Vì sao đáng đọc: Đề xuất giải pháp thực tiễn cho vấn đề 'Hiệu ứng Matthew' trong RL, giúp cải thiện hiệu suất huấn luyện LLM một cách thông minh và tiết kiệm tài nguyên.
Nathan Lambert@natolambert
NgànhĐiểm AI 43/100

Never Give Up: Phương pháp mới giúp GRPO chinh phục các bài toán khó

An basic idea in scaling RL: Can we allocate more compute to the harder problems? We did this: If …

DịchNghiên cứu mới giải quyết 'hiệu ứng Matthew' trong học tăng cường (RL) bằng cách buộc mô hình tiếp tục lấy mẫu khi gặp câu trả lời sai, giúp GRPO vượt qua giới hạn ở các bài toán phức tạp.

NVIDIA Technical Blog: Agentic AI / Generative AI
Hướng dẫnĐiểm AI 52/100

NVIDIA giải mã: So sánh mô hình Dense và MoE về tham số kích hoạt, hiệu suất và cách lựa chọn

Blog kỹ thuật của NVIDIA phân tích sự khác biệt giữa kiến trúc Dense và MoE. Điểm nhấn là cơ chế định tuyến của MoE giúp tối ưu hóa hiệu suất, ví dụ như mô hình Nemotron 3.5 Lightning 30B chỉ kích hoạt 3B tham số cho mỗi token.

15/09

Thứ Ba · 29 tin
IBM Research: AI
NgànhĐiểm AI 45/100

IBM Research chứng minh ưu thế vượt trội của mạch lượng tử nông so với mô hình ngôn ngữ lớn

Nghiên cứu mới từ IBM chỉ ra rằng các mạch lượng tử độ sâu thấp có thể giải quyết những bài toán tính toán phức tạp mà các mô hình Transformer như GPT hay Llama cần nguồn lực khổng lồ mới xử lý được, khẳng định ranh giới lý thuyết giữa hai công nghệ.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Tư duy thiếu tính hệ thống? Đánh giá khả năng suy luận của các mô hình AI qua bài toán quy nạp quy tắc

Nghiên cứu chỉ ra rằng các mô hình AI hiện nay thường thất bại khi đối mặt với các biến thể tương đương về mặt cấu trúc của cùng một bài toán, cho thấy tư duy của chúng thiếu tính hệ thống so với nhận thức con người.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 50/100

Nghiên cứu về Orthrus: Giải mã suy luận không mất dữ liệu chỉ đạt độ chính xác 40% ở định dạng BF16

Các nhà nghiên cứu đã kiểm chứng phương pháp giải mã suy luận của Orthrus và phát hiện rằng ở định dạng BF16, tỷ lệ khớp hoàn toàn chỉ đạt khoảng 40%, trong khi độ chính xác tuyệt đối chỉ đạt được khi sử dụng FP32.

IT Home
NgànhĐiểm AI 85/100

Cùng sự kiệnBaidu chiêu mộ cựu kỹ sư chủ chốt từ Google DeepMind, đồng tác giả mô hình Gemini 2.5

Qiyin Wu, cựu kỹ sư cấp cao tại Google DeepMind và là tác giả chủ chốt của Gemini 2.5, đã gia nhập Baidu để phụ trách mảng huấn luyện mô hình ngôn ngữ lớn. Cô sẽ làm việc tại Mỹ, mang theo kinh nghiệm dày dặn từ các dự án AI cốt lõi của Google.

Cùng sự kiện, bài đại diện «DeepMind thành lập viện nghiên cứu chuyên sâu về tác động của AGI»
Testing Catalog@testingcatalog
NgànhĐiểm AI 26/100

Cùng sự kiệnLộ diện Gemini 3.8 Live và bản Extended Thinking trên bảng điều khiển GCP

GOOGLE 🔥: Gemini 3.8 Live and Gemini 3.8 Live Extended Thinking model names have started appearing …

DịchHai tên gọi Gemini 3.8 Live và Extended Thinking vừa xuất hiện trên trang hạn mức của Google Cloud, hứa hẹn là bước tiến lớn dựa trên nền tảng Gemini 3.8 Flash thay thế cho bản 3.1 hiện tại.

Cùng sự kiện, tinh chọn hiển thị «Google DeepMind ra mắt Gemini 3.8 Live và bản Extended Thinking: Đột phá mới cho trợ lý giọng nói»
Tencent Hunyuan@TencentHunyuan
NgànhĐiểm AI 45/100

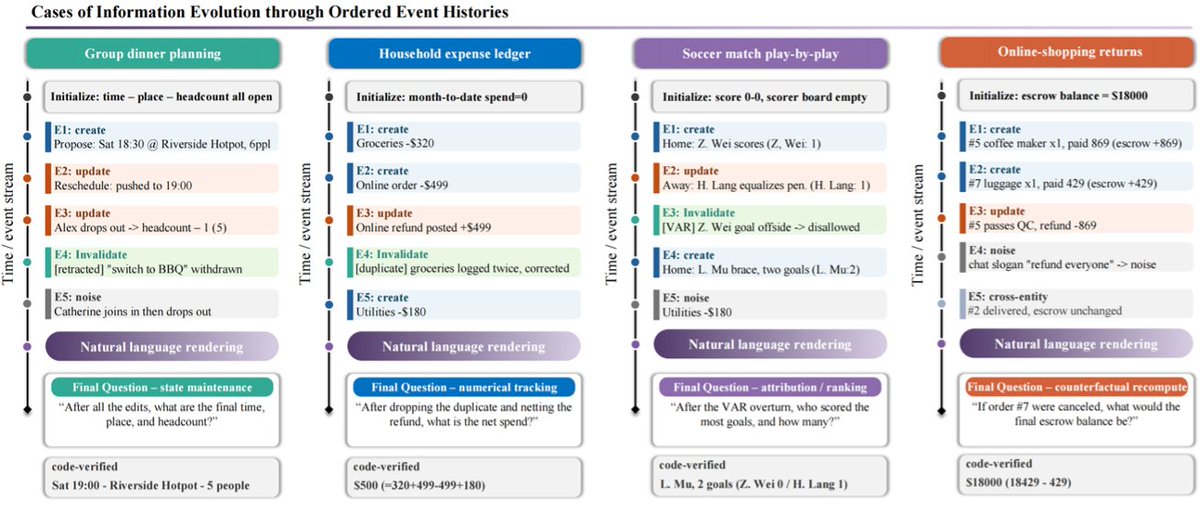
Tencent Hunyuan ra mắt EvolveScaler: Chuẩn đánh giá khả năng xử lý thông tin tiến hóa của AI

🚀 EvolveScaler is here. Read a 40-day RPG log. Now answer one question: if you skip the mini-boss …

DịchTencent Hunyuan giới thiệu EvolveScaler, bộ tiêu chuẩn mới mô phỏng các kịch bản thông tin phức tạp như chỉnh sửa, thu hồi và cập nhật dữ liệu. Công cụ này giúp kiểm tra khả năng suy luận logic của AI và cải thiện đáng kể hiệu suất trên nhiều tác vụ thực tế.

Kim@kimmonismus
NgànhĐiểm AI 28/100

Tin đồn: Anthropic sắp ra mắt mô hình Opus 5.2

Rumors are increasingly circulating that Opus is already being routed to Opus 5.2. It's also said to…

DịchCác nguồn tin cho biết Anthropic chuẩn bị tung ra Opus 5.2 với nhiều cải tiến đáng kể về hiệu suất. Cộng đồng kỳ vọng phiên bản này sẽ khắc phục tình trạng phản hồi dài dòng và lười biếng của các thế hệ trước.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 48/100

SAILS: Tối ưu hóa tập dữ liệu độc hại để tấn công cửa sau vào LLM hiệu quả hơn

Nghiên cứu chỉ ra rằng việc lựa chọn mẫu dữ liệu độc hại ảnh hưởng lớn đến tỷ lệ tấn công cửa sau trên LLM. Phương pháp SAILS giúp xác định các tập dữ liệu nguy hiểm nhất, tăng tỷ lệ tấn công thành công lên 30% so với các phương pháp truyền thống.

Alibaba Cloud@alibaba_cloud
NgànhĐiểm AI 38/100

Cùng sự kiệnDeepSeek-V4.1-Flash chính thức có mặt trên Alibaba Cloud

DeepSeek-V4.1-Flash is now on Alibaba Cloud Token Plan. Built for agentic workloads with a 1M-token …

DịchDeepSeek-V4.1-Flash đã cập bến Alibaba Cloud với khả năng xử lý 1 triệu token, tốc độ suy luận vượt trội và tối ưu cho các tác nhân AI (AI Agents), với giá khởi điểm chỉ từ 6 USD/tháng.

Cùng sự kiện, tinh chọn hiển thị «DeepSeek ra mắt DeepSeek-V4.1-Flash: Cửa sổ 1M token, tối ưu bộ nhớ KV Cache cực đỉnh»
Ma Dongxi NLP@dongxi_nlp
Hướng dẫnĐiểm AI 62/100

Giải mã Prefill và Decode: Tại sao AI đọc tài liệu dài mới phản hồi, nhưng viết lại càng lúc càng chậm?

Bài viết giải thích hai giai đoạn suy luận của LLM: Prefill xử lý song song đầu vào quyết định tốc độ phản hồi ban đầu (TTFT), trong khi Decode tạo văn bản từng token một và thường bị nghẽn băng thông bộ nhớ.

Ethan Mollick@emollick
NgànhĐiểm AI 19/100

Chưa đầy 4 năm sau GPT-3.5: LLM đã trở thành tâm điểm chính trị và kinh tế Mỹ

I just remembered this thread where I was playing with GPT-3.5 (text-davinci-003) the day it was rel…

DịchEthan Mollick nhìn lại hành trình thần tốc của LLM, từ lúc GPT-3.5 ra mắt đến khi trở thành trụ cột định hình nền kinh tế và chính trị Hoa Kỳ chỉ trong chưa đầy 4 năm.

QbitAI
Mô hìnhĐiểm AI 92/100

Tinh chọn7 nghiên cứu sinh đào tạo mô hình 7B từ con số 0 chỉ trong 3 tháng: Công khai toàn bộ mã nguồn và dữ liệu

Một nhóm nghiên cứu sinh đã huy động hàng trăm AI Agent để tự động hóa quy trình phát triển, đánh dấu bước tiến mới trong việc dùng AI để tạo ra AI.


Vì sao đáng đọc: Tin tức mang tính đột phá về quy trình đào tạo mô hình ngôn ngữ lớn, minh bạch hóa dữ liệu và ứng dụng AI Agent trong nghiên cứu, rất có giá trị tham khảo cho cộng đồng kỹ thuật.
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Nghiên cứuĐiểm AI 60/100

Nghiên cứu mới giải mã lý do các tác nhân AI không bị quá khớp (overfitting)

Nghiên cứu chỉ ra rằng các chiến lược có thể nén vào ít token sẽ không bị quá khớp. Phương pháp nén này giúp kiểm chứng hiệu năng thực tế của tác nhân AI, đồng thời là công cụ hiệu quả để phát hiện tình trạng quá khớp trong quá trình huấn luyện.

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
NgànhĐiểm AI 34/100

Claude 'bướng bỉnh': Tại sao AI này thường xuyên làm ngược lại yêu cầu của người dùng?

Nhiều lập trình viên phản ánh Claude thường xuyên phớt lờ các chỉ dẫn cụ thể trong file cấu hình, từ việc tự ý thêm chú thích code đến thay đổi phong cách viết. So với các đối thủ như DeepSeek hay OpenAI, sự 'cứng đầu' này đang gây khó chịu cho người dùng chuyên nghiệp.

Arena@arena
Hướng dẫnĐiểm AI 58/100

DeepSeek-V4.1-Flash (Max) lọt Top 3 mô hình nguồn mở trên Agent Arena với chi phí cực rẻ

DeepSeek-V4.1-Flash (Max) is a breakthrough in performance to cost efficiency. With +4.87% net impro…

DịchDeepSeek-V4.1-Flash (Max) vừa ghi danh vào bảng xếp hạng Agent Arena, đạt vị trí thứ 3 trong nhóm mô hình nguồn mở với chi phí chỉ 0,07 USD mỗi tác vụ, thiết lập chuẩn mực mới về hiệu suất trên chi phí.

Rohan Paul@rohanpaul_ai
NgànhĐiểm AI 45/100

CEO Palo Alto Networks: Kỷ nguyên của phần mềm SaaS phân tích đã chấm dứt

"If you're an analytical SaaS company, it's over. It's over." - Palo Alto Networks CEO Nikesh Arora…

DịchNikesh Arora khẳng định các ứng dụng SaaS phân tích dữ liệu truyền thống đang dần lỗi thời, khi LLM có thể trực tiếp xử lý và phân tích dữ liệu thay vì cần đến các module phần mềm bổ trợ đắt đỏ.

Kim@kimmonismus
NgànhĐiểm AI 35/100

Elon Musk hé lộ lộ trình phát triển đầy tham vọng của Grok từ bản 4.7 đến Grok 5

Elon's predictions for Grok read very honestly and extremely realistically. Grok 4.7, which is comi…

DịchElon Musk dự báo Grok 4.7 sẽ ngang ngửa Opus 5.0, trong khi Grok 5 được kỳ vọng sẽ vượt qua mọi đối thủ hiện có. Các chuyên gia đánh giá lộ trình này là hoàn toàn khả thi sau khi xAI đạt được những bước tiến lớn gần đây.

Thêm 1 nguồn khác đưa tinIT Home
Arena@arena
Nghiên cứuĐiểm AI 66/100

Tinh chọnDeepSeek-V4.1-Flash (Max) vươn lên vị trí thứ 3 trên bảng xếp hạng Agent Arena

Exciting news: DeepSeek-V4.1-Flash (Max) by @deepseek_ai just landed in Agent Arena at #3 among open…

DịchDeepSeek-V4.1-Flash (Max) đạt vị trí thứ 3 trong nhóm mô hình mã nguồn mở trên Agent Arena với hiệu suất tăng 4,87% và chi phí tối ưu chỉ 0,07 USD mỗi tác vụ, vượt xa các đối thủ về hiệu quả kinh tế.


Vì sao đáng đọc: Tin tức quan trọng về hiệu suất và tối ưu chi phí của mô hình DeepSeek, thu hút sự quan tâm lớn từ cộng đồng AI và các nhà phát triển ứng dụng Agent.
Elvis Saravia@omarsar0
NgànhĐiểm AI 39/100

Tự xây dựng Agent Harness: Bí quyết cắt giảm chi phí Token hiệu quả

If you build your own harness, you can drive that cost down even further. Out-of-the-box agent harn…

DịchThay vì dùng các bộ khung (harness) cồng kềnh, việc tự xây dựng hệ thống tối giản giúp giảm đáng kể chi phí token thông qua tối ưu hóa prompt, gọi công cụ thông minh và kiểm soát luồng dữ liệu chặt chẽ.

Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (52 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “LLM” — Trang 8 | AIHOT.vn