21/08

Thứ Sáu · 30 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 56/100

EnvHarness: Giải pháp lập trình giúp 'thổi hồn' vào các môi trường huấn luyện AI tĩnh

EnvHarness giới thiệu lớp plugin lập trình giúp tùy biến hành vi môi trường mà không cần can thiệp logic gốc, kết hợp cùng EnvRigger để tự động tối ưu hóa chiến lược của AI. Giải pháp này giúp cải thiện hiệu suất huấn luyện đáng kể trên nhiều lĩnh vực khác nhau.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

VA-Judger: Mô hình phần thưởng dựa trên phản hồi người dùng cho thế hệ video-âm thanh đồng bộ

VA-Judger giải quyết vấn đề thiếu tính nhất quán trong tạo video-âm thanh bằng cách sử dụng tập dữ liệu VAPref-10K, giúp mô hình hiểu rõ hơn về sự đồng bộ ngữ nghĩa và cảm nhận của con người thay vì chỉ tối ưu các chỉ số rời rạc.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 42/100

Nghiên cứu mới: Hiệu suất của AI tự cải tiến dựa trên bộ nhớ có thể chỉ là 'nhiễu' đánh giá

Finally a good paper testing whether memory-based self-improving agents actually improve. The re-ev…

DịchNghiên cứu chỉ ra rằng sự cải thiện của các tác nhân AI dựa trên bộ nhớ chủ yếu đến từ thứ tự nhiệm vụ và nhiễu đánh giá thay vì khả năng tự học thực sự. Khi kiểm soát các yếu tố này, hiệu suất của mô hình giảm đáng kể, đặt ra dấu hỏi về tính hiệu quả của các phương pháp hiện tại.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 35/100

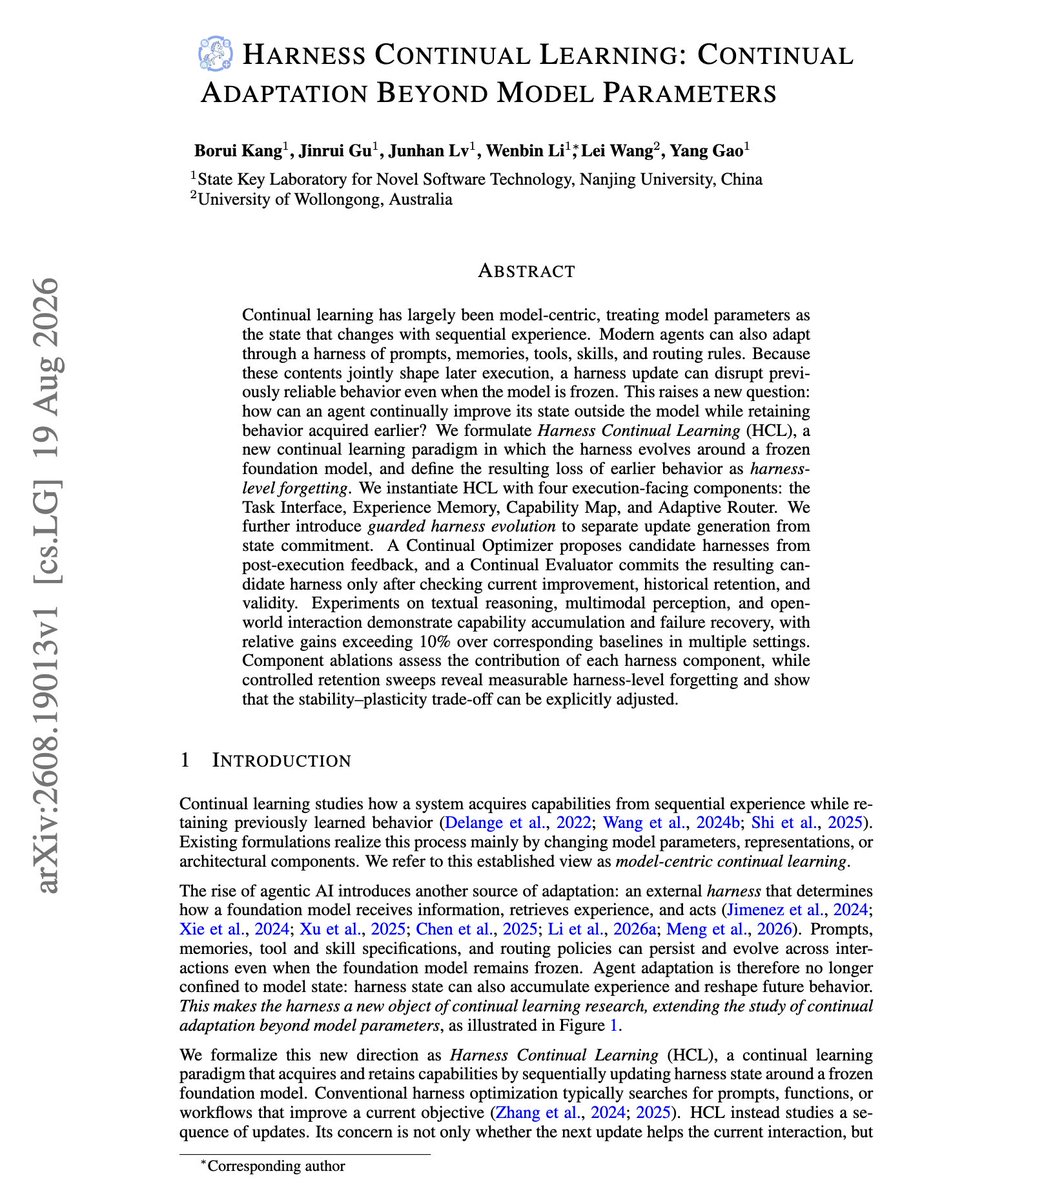
Nghiên cứu mới: Giải pháp chống 'quên lãng' trong các khung làm việc của AI Agent

Banger paper on harness continual learning. (bookmark it) If you already are allowing your agents …

DịchNghiên cứu chỉ ra hiện tượng 'quên lãng cấp khung' khi cập nhật các thành phần như bộ nhớ hay công cụ khiến AI mất khả năng vận hành. Cơ chế 'Tiến hóa khung được bảo vệ' giúp tối ưu hóa và kiểm chứng hiệu quả, cải thiện hơn 10% hiệu suất trong các tác vụ suy luận và tương tác.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

MuseCPEval: Khung đánh giá toàn diện khả năng bảo toàn ngữ cảnh trong chỉnh sửa âm nhạc AI

MuseCPEval là khung đánh giá đầu tiên giúp đo lường chính xác khả năng giữ nguyên các đặc tính âm nhạc cốt lõi khi thực hiện các tác vụ chỉnh sửa như chuyển đổi nhạc cụ hay phong cách, đảm bảo chất lượng sản phẩm đầu ra.

Ma Dongxi NLP@dongxi_nlp
Nghiên cứuĐiểm AI 25/100

SPADE: Phương pháp tự đối đầu cho tác nhân AI trong môi trường tổng hợp thích ứng

SPADE: Self-Play in Adaptive Synthetic Executable Environments

DịchSPADE là phương pháp huấn luyện tác nhân tự đối đầu, nơi chính AI sẽ tạo ra và cải tiến các môi trường cũng như nhiệm vụ của mình dựa trên chỉ số hối tiếc (regret). Đây là bước tiến quan trọng trong việc giúp AI tự quyết định lộ trình học tập tối ưu.

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Mô hìnhĐiểm AI 79/100

Google DeepMind ra mắt DiffusionGemma: Mô hình khuếch tán rời rạc với tốc độ 1500 token/giây trên H100

Google DeepMind giới thiệu DiffusionGemma, mô hình khuếch tán văn bản mã nguồn mở dựa trên kiến trúc Gemma 2 26B MoE, mang lại hiệu suất tạo văn bản vượt trội với tốc độ ấn tượng trên một GPU H100 duy nhất.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 53/100

SPK: Khung phát hiện dữ liệu ngoài phân phối (OoD) có khả năng giải thích cho bài toán phát hiện vật thể thời gian thực

SPK giải quyết vấn đề ảo giác trong phát hiện vật thể bằng cách khai thác tri thức tiên nghiệm về cấu trúc và ngữ cảnh, tạo ra biểu diễn 5 chiều giúp nhận diện chính xác các dữ liệu ngoài phân phối (OoD).

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

HOTFIXR: Tối ưu hóa dữ liệu tổng hợp đa ngôn ngữ giúp LLM thông minh hơn

Nghiên cứu giới thiệu khung làm việc HOTFIXR giúp cải thiện khả năng suy luận đa ngôn ngữ của LLM bằng cách tạo dữ liệu tổng hợp có độ khó tối ưu, khắc phục sự chênh lệch hiệu suất giữa các ngôn ngữ mà không làm giảm chất lượng phản hồi.

20/08

Thứ Năm · 26 tin
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 35/100

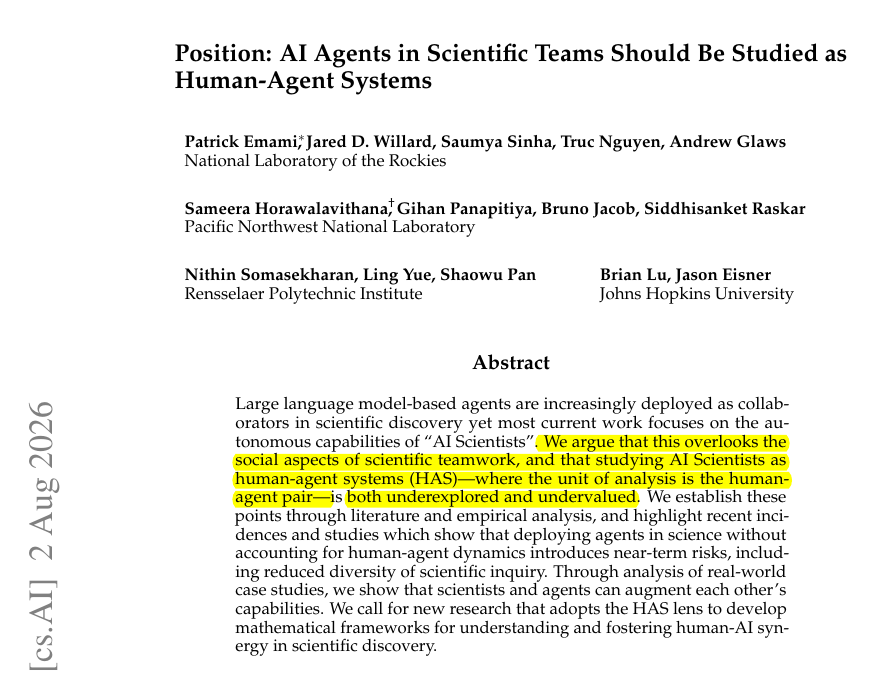
AI trong khoa học: Nên tập trung vào mô hình cộng tác người-máy thay vì tự động hóa hoàn toàn

The race to build "AI Scientists" may be optimizing for the wrong unit: the agent alone. This posit…

DịchNghiên cứu mới đề xuất đánh giá các tác nhân AI khoa học dựa trên hiệu quả cộng tác với con người thay vì khả năng tự chủ. Kết quả cho thấy sự kết hợp giữa chuyên gia và AI mang lại kết quả vượt trội hơn hẳn so với việc để AI tự thực hiện đơn lẻ.

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Nghiên cứuĐiểm AI 49/100

Đừng nhầm lẫn các token trung gian của AI là 'quá trình tư duy'

Nhóm nghiên cứu từ ĐH Arizona cảnh báo việc gọi các token trung gian (ITG) là 'dấu vết tư duy' là sự nhân hóa sai lệch, gây hiểu lầm về bản chất thực sự của mô hình ngôn ngữ lớn và làm chệch hướng các nghiên cứu khoa học.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 37/100

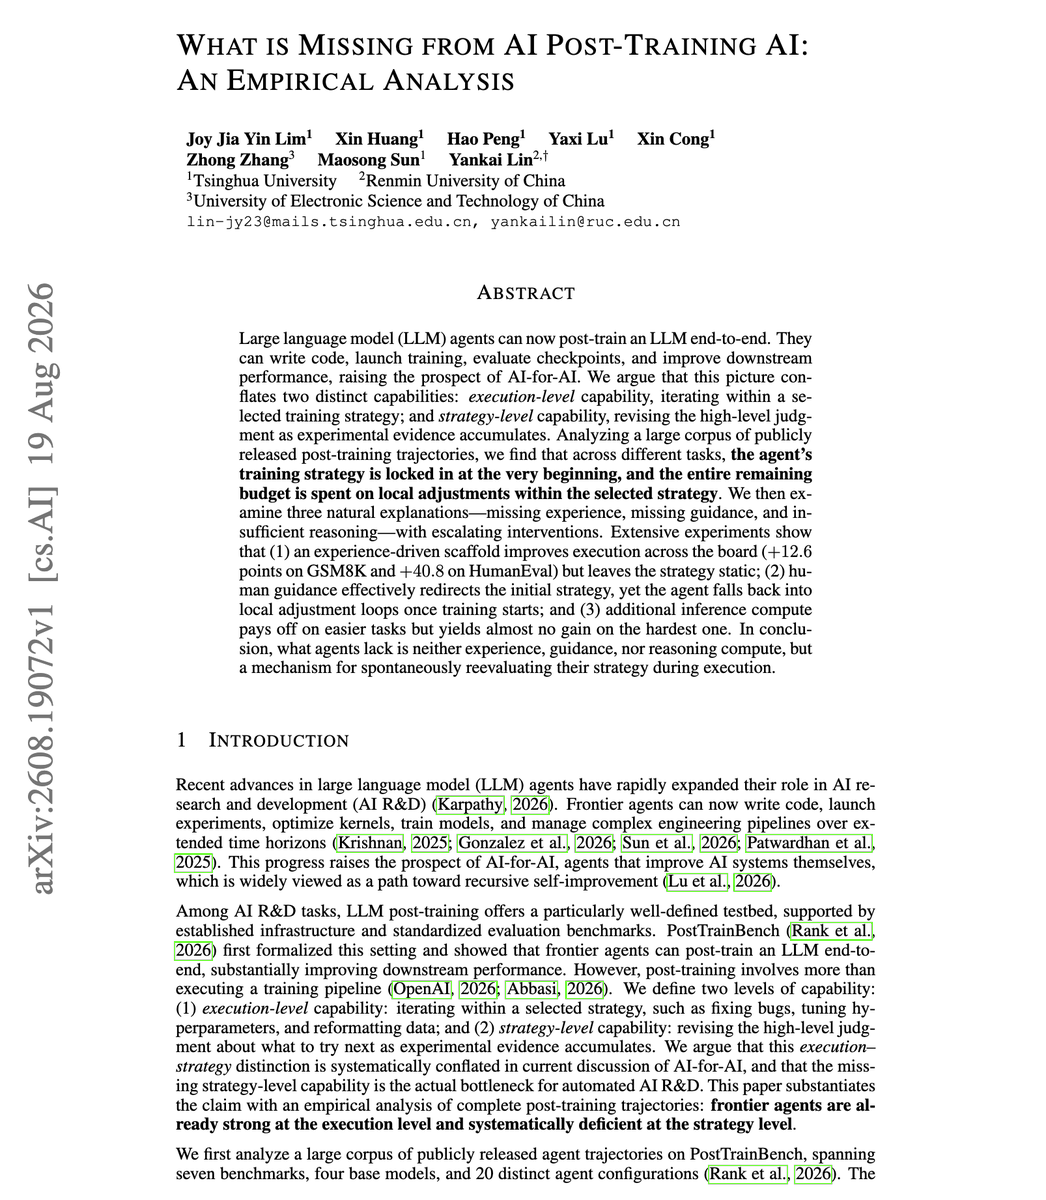
Nghiên cứu mới: Liệu AI có thể tự huấn luyện lẫn nhau?

Finally a good paper testing whether agents can really post-train other agents. (bookmark it) They…

DịchNghiên cứu chỉ ra rằng các AI hiện nay khi huấn luyện lẫn nhau thường bị mắc kẹt ở chiến lược ban đầu và thiếu khả năng thay đổi tư duy trong quá trình thực thi, dù có sự hỗ trợ từ con người hay kỹ thuật bổ trợ.

JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnĐưa mô hình thế giới vào đường đua F1: Thử thách giới hạn nhận thức và vật lý của AI hiện thân

Nhóm nghiên cứu từ NTU Singapore phát triển kiến trúc AI dựa trên mô hình thế giới cho xe đua tự hành, giúp tối ưu hóa khả năng ra quyết định và kiểm soát xe trong các tình huống đối kháng tốc độ cao.


Vì sao đáng đọc: Chủ đề đột phá khi kết hợp AI hiện thân với môi trường đua xe khắc nghiệt, mang tính ứng dụng cao trong việc giải quyết các bài toán điều khiển thời gian thực và an toàn cho xe tự hành.
ModelBest OpenBMB@OpenBMB
Nghiên cứuĐiểm AI 36/100

Nghiên cứu mới: Đánh giá độ thiên kiến của LLM khi mô phỏng 59 quốc gia

We increasingly use LLMs as prixies, for real people in cross-country surveys. But do they simulate …

DịchCác nhà nghiên cứu từ Đại học Thanh Hoa đề xuất chỉ số 'bình đẳng đại diện' để đo lường sự thiên vị của LLM đối với 59 quốc gia. Kết quả cho thấy các mô hình ưu ái phương Tây hơn và RAG là giải pháp hiệu quả nhất để cải thiện sự công bằng này.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 40/100

Cảnh báo lỗ hổng 'tiến hóa độc hại' trong thư viện kỹ năng của AI Agent

An agent can receive a clean prompt today and still behave unsafely because yesterday's malicious ta…

DịchNghiên cứu mới chỉ ra rằng các tác vụ độc hại có thể 'lây nhiễm' vào thư viện kỹ năng của AI, khiến chúng tiếp tục gây hại ngay cả khi lệnh gốc đã bị xóa. Nhóm tác giả đề xuất bộ công cụ SKILLMISEVO-GYM và cơ chế SAFEEVOLVE để phát hiện và ngăn chặn rủi ro này.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 44/100

SkillGate: Tối ưu hóa lựa chọn kỹ năng cho tác nhân AI dài hạn

SkillGate giải quyết vấn đề thiếu tín hiệu huấn luyện khi tác nhân AI chọn kỹ năng giữa chừng bằng cách tách biệt tín hiệu kết quả và lợi thế hành động, giúp tăng tỷ lệ thành công từ 40,8% lên 53,2%.

JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnĐại học Bắc Kinh và Microsoft Research giới thiệu BCP: Để AI tự quyết định thời điểm tái lập kế hoạch

Nhóm nghiên cứu đề xuất BCP, cho phép mô hình VLA tự quyết định việc tiếp tục thực hiện hay tái lập kế hoạch thay vì dùng tham số cố định, giúp tăng đáng kể độ chính xác cho các tác vụ robot phức tạp.


Vì sao đáng đọc: Nghiên cứu giải quyết vấn đề cốt lõi trong điều khiển robot (VLA), cải thiện hiệu suất thực tế đáng kể bằng phương pháp sáng tạo, có tính ứng dụng cao trong lĩnh vực robotics.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Phát hiện ảo giác trong LLM bằng phương pháp hợp nhất đa tín hiệu theo thời gian

Nghiên cứu đề xuất cách tiếp cận mới để phát hiện ảo giác ở cấp độ token bằng cách phân tích chuỗi thay vì đánh giá độc lập, giúp cải thiện đáng kể độ chính xác nhờ tận dụng mối liên hệ giữa các từ trong ngữ cảnh.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 51/100

Co-RL: Đột phá khả năng suy luận không cần giám sát nhờ đa dạng hóa tác nhân trong học tăng cường

Co-RL là khung học tăng cường đa tác nhân mới, cho phép các mô hình tự tối ưu hóa thông qua tín hiệu phần thưởng lẫn nhau mà không cần nhãn. Việc tăng cường tính đa dạng của nhóm giúp giảm lỗi phản hồi và cải thiện đáng kể hiệu suất trên các tác vụ văn bản và đa phương thức.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Mở rộng khả năng sáng tạo cho LLM: Phương pháp tạo dữ liệu đa thể loại dựa trên thuộc tính

Nghiên cứu giới thiệu khung làm việc mới giúp LLM vượt qua giới hạn của dữ liệu kể chuyện truyền thống, tạo ra 50.000 mẫu văn bản chất lượng cao thuộc 13 thể loại sáng tạo khác nhau như kịch bản, lời bài hát và thiết kế game.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Dấu vết huấn luyện: Xác định nguồn gốc mô hình ngôn ngữ qua chữ ký dư thừa

Nghiên cứu giới thiệu phương pháp xác định nguồn gốc mô hình AI mà không cần dữ liệu gốc, bằng cách phân tích cấu trúc trọng số đặc thù trong các khối residual để truy xuất tổ tiên của mô hình ngay cả khi đã qua tinh chỉnh, cắt tỉa hoặc nén.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 50/100

SPADE: Khung tự đối kháng giúp LLM tự thiết kế môi trường huấn luyện tối ưu

SPADE cho phép một LLM đóng vai trò kép: vừa là người thiết kế môi trường, vừa là tác nhân suy luận, giúp tự động tạo ra các bài kiểm tra ở ngưỡng năng lực để tối ưu hóa hiệu suất mô hình. Phương pháp này cải thiện đáng kể khả năng sử dụng công cụ và giải quyết vấn đề trên nhiều tiêu chuẩn.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 40/100

FACET: Giải pháp duy trì ý định và trạng thái thực thi trong tổng hợp tác vụ terminal

FACET là khung làm việc mới giúp tối ưu hóa việc tổng hợp tác vụ trên terminal bằng cách tái cấu trúc kỹ năng của AI thành các kịch bản giàu thông tin, đảm bảo tính nhất quán thông qua việc kiểm chứng dựa trên môi trường thực thi và cơ chế tự sửa lỗi.

Hongming@hongming731
Hướng dẫnĐiểm AI 31/100

Điểm tin AI: Rủi ro 'đầu hàng nhận thức' của Agent và kỳ tích ICML của lập trình viên 17 tuổi

Addy Osmani cảnh báo về vòng lặp xác thực trong AI Agent, trong khi Rachel Laycock đề xuất mô hình quản trị mới. Đặc biệt, một học sinh 17 tuổi gây ấn tượng khi có bài báo được chấp nhận tại ICML 2026 với chi phí huấn luyện tối ưu.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 35/100

Nghiên cứu mới: Rủi ro từ AI Agent gia tăng theo năng lực suy luận

AI agents can threaten human agency and autonomy long before consciousness becomes relevant, simply …

DịchNghiên cứu từ Thượng Hải AI Lab và ĐH Thanh Hoa cảnh báo AI Agent có thể đe dọa quyền tự chủ của con người ngay cả khi chưa có ý thức, với các rủi ro chuyển dịch từ thao túng hành vi sang chống lại sự kiểm soát khi năng lực suy luận đạt đến cấp độ cao hơn.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 36/100

RAG bị tấn công đầu độc: Hiện tượng 'sụp đổ chú ý' khiến mô hình tự tin thái quá

RAG poisoning can make a model more confident, which is exactly why confidence-based detectors can f…

DịchNghiên cứu mới chỉ ra rằng việc đầu độc dữ liệu RAG khiến mô hình trở nên quá tự tin và tập trung sai lệch vào tài liệu độc hại. Việc giám sát phân bổ chú ý thay vì chỉ dựa vào độ tin cậy của câu trả lời có thể giúp phát hiện sớm các cuộc tấn công này.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 41/100

TRACES: Hệ thống chuẩn mực đầu tiên đánh giá năng lực 'AI khám phá'

This is a good example of why final-answer accuracy can hide bad agent behaviour. Most AI benchmark…

DịchApodex giới thiệu TRACES, chuẩn mực đánh giá AI chuyển dịch từ việc truy xuất câu trả lời có sẵn sang quy trình điều tra toàn diện cho các vấn đề chưa có lời giải, định nghĩa lại cách đo lường trí tuệ nhân tạo.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 47/100

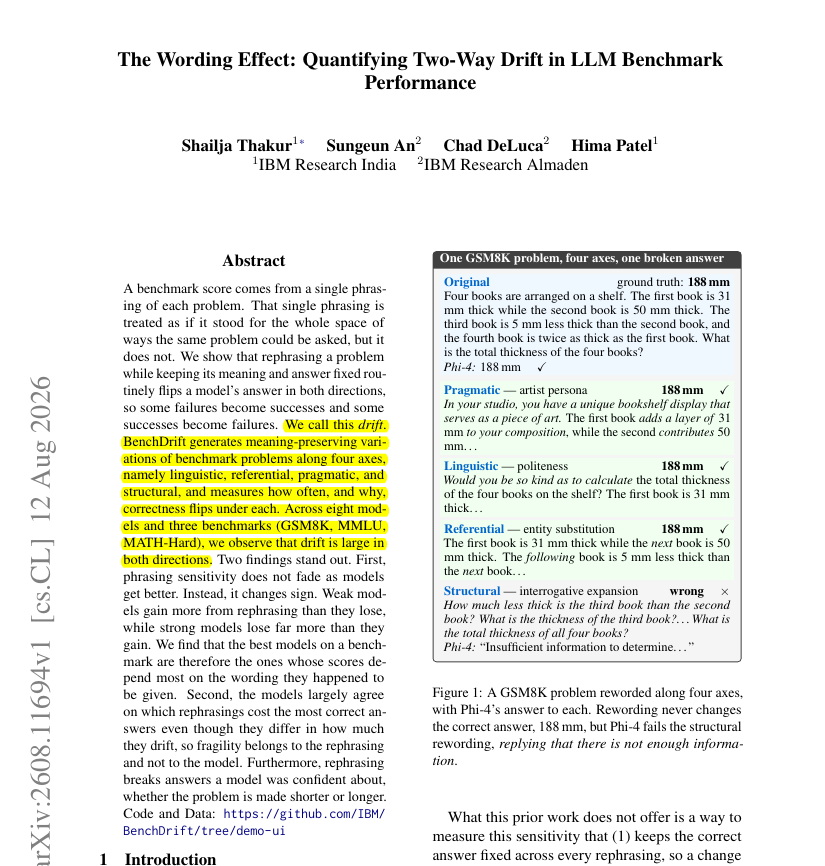
Khung BenchDrift của IBM: Cách diễn đạt khiến điểm số LLM biến động tới 74,7%

A model can know the answer and still fail because you asked the same question differently. New IBM…

DịchIBM giới thiệu BenchDrift, khung đánh giá cho thấy việc thay đổi cách đặt câu hỏi có thể làm điểm số LLM chênh lệch tới 74,7%. Ngay cả với các mô hình mạnh, 18,5% câu trả lời đúng vẫn bị mất đi khi diễn đạt lại dù ý nghĩa không đổi.

Ma Dongxi NLP@dongxi_nlp
Nghiên cứuĐiểm AI 36/100

Ra mắt TRACES: Bộ tiêu chuẩn đầu tiên đo lường 'Trí tuệ khám phá' của AI

Discovery becomes an engineered verb Ambition -> formulation -> action -> observation -> verificati…

DịchApodex_AI giới thiệu TRACES, bộ tiêu chuẩn đánh giá khả năng giải quyết các vấn đề không có đáp án sẵn thông qua quy trình kiểm chứng khoa học, thay vì chỉ dựa vào điểm số đơn thuần.

Apple Machine Learning Research
Nghiên cứuĐiểm AI 42/100

Tính P-đầy đủ trong duyệt chỉ mục ngược: Đánh giá độ phức tạp của truy vấn Boolean trên đồ thị DAG

Nghiên cứu chỉ ra rằng các chiến lược truy vấn chỉ mục ngược truyền thống gặp giới hạn lý thuyết nghiêm trọng, dẫn đến sự bùng nổ độ phức tạp theo hàm mũ khi xử lý các truy vấn Boolean phức tạp trong suy luận thần kinh-biểu tượng.

19/08

Thứ Tư · 24 tin
DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 37/100

Giải mã chi phí AI Agent: Không phải LLM, chính các thành phần phụ mới gây trễ hệ thống

Great paper if you are building production-grade agents. It's a good way to understand what is actu…

DịchNghiên cứu từ DAIR.AI chỉ ra rằng trong các ứng dụng AI Agent thực tế, các thành phần ngoài LLM thường là nguyên nhân chính gây độ trễ. Các giải pháp tối ưu hóa như dịch vụ nhận diện tác vụ và bộ nhớ đệm có thể cải thiện đáng kể hiệu suất và giảm tài nguyên hệ thống.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 36/100

Agent Lightning v1.0 của Microsoft giúp tăng 14,6% khả năng lập trình cho Qwen3.5-9B

Very interesting new work from Microsoft. (bookmark it) This work is related to this emerging them…

DịchNghiên cứu mới từ Microsoft giới thiệu Agent Lightning v1.0, giúp tối ưu hóa hậu huấn luyện mô hình. Chỉ với 6.000 mẫu dữ liệu, hiệu suất của Qwen3.5-9B trên SWE-bench Verified đã tăng vọt từ 41,8% lên 56,4%.

Apple Machine Learning Research
Nghiên cứuĐiểm AI 52/100

Nghiên cứu từ Apple: Phân tích đa chiều về hành vi giống người của các mô hình ngôn ngữ lớn (LLM)

Đội ngũ nghiên cứu của Apple đã phân tích cách LLM thể hiện cảm xúc và thiết lập ranh giới với người dùng. Nghiên cứu cung cấp cái nhìn sâu sắc giúp các nhà phát triển kiểm soát hành vi giống người của AI một cách hiệu quả.

Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (51 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Nghiên cứu AI” — Trang 25 | AIHOT.vn