23/08

Chủ Nhật · 18 tin
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 27/100

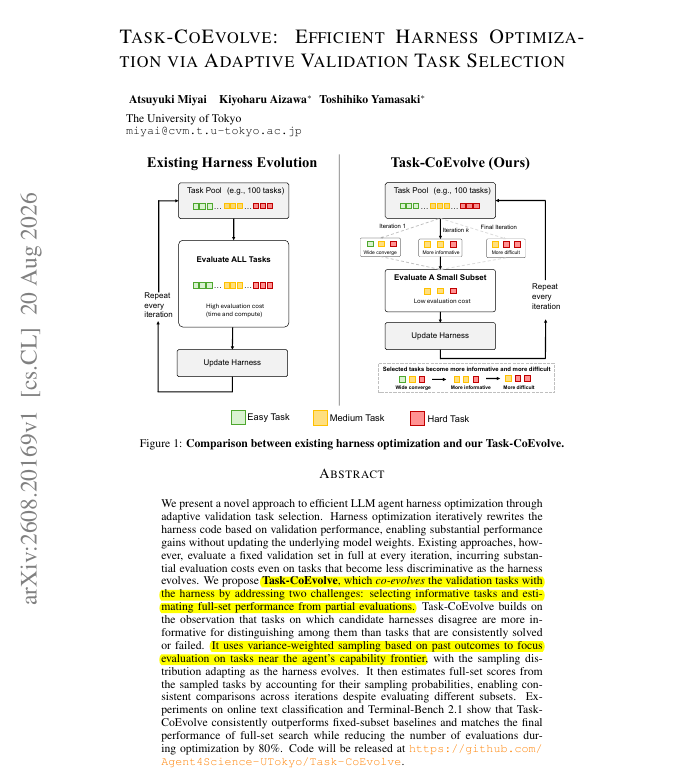
Task-CoEvolve: Tối ưu hóa chi phí đánh giá AI Agent bằng phương pháp chọn lọc bài kiểm tra thích ứng

Most of the tests used to grade an AI agent are a waste of money. A new University of Tokyo paper c…

DịchNghiên cứu từ Đại học Tokyo giới thiệu Task-CoEvolve, phương pháp giúp cắt giảm 67-80% chi phí đánh giá AI Agent bằng cách chỉ tập trung vào các bài kiểm tra có độ phân hóa cao, thay vì chạy toàn bộ tập dữ liệu dư thừa.
22/08

Thứ Bảy · 21 tin
Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 35/100

Tối ưu hóa truy vấn: Thiết lập hàm mục tiêu cho ngữ cảnh của AI Agent

What a fascinating paper on AI agents. A lot of the issues we see with AI agents today revolve arou…

DịchNghiên cứu mới đề xuất phương pháp 'Đặt câu hỏi tối ưu' giúp AI Agent giảm thiểu ảo giác và chi phí bằng cách coi việc thu thập ngữ cảnh là quá trình suy luận chủ động, cho phép đo lường hiệu suất thực tế so với mức tối ưu lý thuyết.

Ma Dongxi NLP@dongxi_nlp
Nghiên cứuĐiểm AI 35/100

TRACES: Tiêu chuẩn mới đánh giá khả năng suy luận và tính minh bạch của AI

TRACES là bộ tiêu chuẩn đánh giá AI dựa trên quy trình nghiên cứu có bằng chứng, thay vì chỉ kiểm tra kết quả cuối cùng. Nó theo dõi toàn bộ chuỗi từ lập kế hoạch đến sửa lỗi, giúp đảm bảo tính minh bạch và khả năng kiểm chứng trong các tác vụ phức tạp như thử nghiệm lâm sàng.

JiQiZhiXin
Nghiên cứuĐiểm AI 85/100

LoopsBench: Đánh giá thế hệ Coding Agent mới trong các tác vụ lập trình dài hạn

LoopsBench là bộ tiêu chuẩn mới từ Microsoft và ĐH Nam Kinh, tập trung đánh giá khả năng duy trì kế hoạch và quản lý quy trình làm việc phức tạp của các Coding Agent trong các dự án phần mềm dài hạn thay vì chỉ giải quyết các tác vụ đơn lẻ.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 37/100

Nghiên cứu cảnh báo: Dữ liệu khảo sát tổng hợp từ LLM chưa thể thay thế con người

LLMs can reproduce the broad direction of human survey results, but not the actual human response di…

DịchMột nghiên cứu tâm lý học cho thấy LLM chỉ mô phỏng được xu hướng chung chứ không tái hiện chính xác phân phối câu trả lời của con người. Các mô hình huấn luyện bằng dữ liệu AI có hiệu suất dự báo kém, cho thấy LLM chỉ phù hợp cho các khảo sát thử nghiệm chi phí thấp.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 37/100

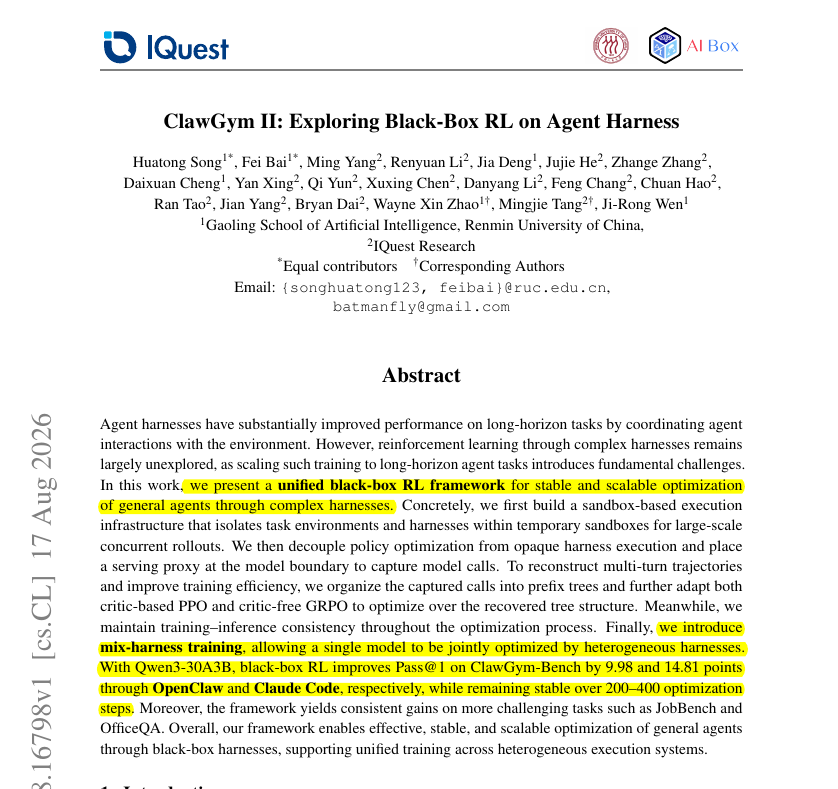
ClawGym II: Tối ưu hóa tác nhân AI thông qua huấn luyện RL hộp đen

You can now RL-train an agent through the same complex harness it will actually run in, without need…

DịchKhung ClawGym II tích hợp OpenClaw và Claude Code như các hệ thống hộp đen vào quy trình huấn luyện RL, giúp cải thiện đáng kể điểm số trên các bộ benchmark như ClawGym-Bench mà không cần can thiệp vào cấu trúc nội tại của mô hình.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 41/100

Nghiên cứu từ Đại học Thanh Hoa: AI gặp khó trong việc tự thay đổi chiến lược khi huấn luyện

New Tsinghua and other Chinese Univ paper finds AI agents can optimize a training plan for hours, bu…

DịchNghiên cứu chỉ ra rằng các tác nhân AI dù tối ưu hóa tốt nhưng rất hiếm khi tự nhận ra sai lầm trong chiến lược cốt lõi. Ngay cả khi bổ sung công cụ hỗ trợ, AI vẫn chủ yếu lặp lại các phương pháp cũ thay vì thay đổi tư duy giải quyết vấn đề.

The Decoder: AI News
Nghiên cứuĐiểm AI 53/100

Nghiên cứu từ Princeton và UCSD: Tại sao AI Agent cần 'kỹ năng' và giới hạn của chúng

Nghiên cứu trên 8.135 thử nghiệm cho thấy kỹ năng giúp AI Agent cải thiện hiệu suất thông qua hướng dẫn quy trình thay vì bổ sung kiến thức. Tuy nhiên, hiệu quả giảm mạnh khi số lượng kỹ năng tăng lên, cho thấy chất lượng và khả năng truy xuất quan trọng hơn số lượng.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 42/100

Nghiên cứu từ Harvard & Stanford: Đừng dùng LLM thay thế mô hình Embedding cho tác vụ tìm kiếm

New Harvard + Stanford paper says, don't replace your embedding model with an LLM. Use embeddings fo…

DịchNghiên cứu mới chỉ ra rằng LLM đắt gấp 1.431 lần nhưng không vượt trội đáng kể so với mô hình Embedding trong tìm kiếm. Các chuyên gia khuyên nên dùng Embedding để lọc dữ liệu thô và chỉ dùng LLM cho các tác vụ suy luận chuyên sâu ở bước cuối.

JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnAI tự cải tiến chỉ đạt 0.16 điểm? Einsia AI ra mắt AI4AI-Bench: Liệu AI có thể tự thiết kế thuật toán tốt hơn?

Einsia AI giới thiệu AI4AI-Bench, bộ tiêu chuẩn đánh giá khả năng của AI trong việc tự thiết kế các thuật toán học máy mới thay vì chỉ tối ưu hóa mã nguồn thông thường, mở ra kỷ nguyên tự cải tiến đệ quy.


Vì sao đáng đọc: Chủ đề mang tính đột phá về khả năng tự tiến hóa của AI, đánh trúng tâm điểm của giới nghiên cứu và có sức lan tỏa mạnh mẽ trên mạng xã hội.
The Decoder: AI News
Nghiên cứuĐiểm AI 51/100

Nghiên cứu mới: Các mô hình thế giới hiện nay dự đoán sai vì bỏ qua tâm lý con người

Nghiên cứu chỉ ra rằng các mô hình như Sora chỉ tập trung vào vật lý mà thiếu đi yếu tố tâm lý. Nhóm tác giả đề xuất khung MWM và bộ đánh giá Menti-Bench để giúp AI hiểu rõ hơn về niềm tin và ý định của con người, cải thiện đáng kể độ chính xác khi dự đoán hành vi.

The Decoder: AI News
Hướng dẫnĐiểm AI 47/100

Phương pháp tâm lý học vạch trần lỗ hổng nghiêm trọng trong kiểm thử an toàn AI

Nghiên cứu mới chỉ ra rằng các bài kiểm tra an toàn AI hiện nay dễ bị thao túng bởi 'hiệu ứng giả vờ' (sandbagging), khiến mô hình từ chối yêu cầu vô tội để tăng điểm số ảo. Phương pháp mới giúp giảm 99% chi phí kiểm thử mà vẫn đảm bảo độ chính xác cao.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 37/100

EnvHarness: Phương pháp huấn luyện AI tự thích nghi với môi trường

Another great Google paper. Agent training has a ceiling: the agent improves, but the same environm…

DịchGoogle giới thiệu EnvHarness, công cụ tự động phát hiện điểm yếu của AI và tinh chỉnh môi trường huấn luyện để tối ưu hóa hiệu suất mà không làm thay đổi mục tiêu gốc. Giải pháp này giúp tăng tỷ lệ giải quyết tác vụ trên SWE-bench Verified lên 54,79%.

Thêm 2 nguồn khác đưa tinJiqizhixinX: Elvis Saravia (@omarsar0, DAIR.AI)
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 36/100

Học tập liên tục cho AI Agent: Thay đổi hành vi mà không cần huấn luyện lại mô hình

An agent can improve without retraining the model. Once agents rewrite their own prompts, memory, a…

DịchNghiên cứu mới giới thiệu khung 'Học tập liên tục theo cấu trúc' (HCL), cho phép AI Agent cập nhật hành vi bằng cách tinh chỉnh prompt, bộ nhớ và định tuyến thay vì huấn luyện lại tham số. Phương pháp này coi các thay đổi cấu trúc như mã nguồn, cần kiểm thử hồi quy trước khi áp dụng.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 92/100

Tinh chọnFlowEvo: Bước tiến mới giúp AI tự tiến hóa thông qua quy trình và kỹ năng tự học

FlowEvo là khung làm việc không cần huấn luyện, cho phép AI tự động chuyển đổi các quy trình thành công thành kỹ năng có thể tái sử dụng, giúp hệ thống liên tục phát triển và tối ưu hóa hiệu suất qua từng tác vụ.


Vì sao đáng đọc: Đột phá trong việc tối ưu hóa khả năng tự học của AI mà không cần huấn luyện lại, đạt kết quả vượt trội trên nhiều benchmark quan trọng. Rất đáng chú ý cho giới nghiên cứu.
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 37/100

Nghiên cứu về lỗ hổng trí nhớ trên các tác nhân AI tự cải tiến

The big problem with self-improving agents is that memory can compound mistakes just as easily as it…

DịchSalesforce phát hiện hiệu suất của các tác nhân AI phụ thuộc lớn vào thứ tự nhiệm vụ. Việc lưu trữ các trải nghiệm sai lầm khiến AI trở nên kém ổn định, ngay cả khi cải thiện phản hồi từ môi trường cũng khó khắc phục hoàn toàn sự sụt giảm hiệu suất này.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

TinyCast: Mô hình dự báo chuỗi thời gian siêu nhỏ với hiệu suất vượt trội

TinyCast là mô hình dự báo zero-shot không dùng attention, chỉ với 146.505 tham số nhưng đạt độ chính xác ấn tượng nhờ kết hợp phát hiện chu kỳ phổ và kiến trúc mã hóa-giải mã tinh gọn, thiết lập chuẩn mực mới về hiệu quả tài nguyên.

TechCrunch: AI
Hướng dẫnĐiểm AI 61/100

Nvidia: 'Dây cương' quan trọng hơn mô hình AI, Claude Opus 5 đạt điểm tuyệt đối nhờ tối ưu hóa

Nghiên cứu của Nvidia cho thấy việc thiết kế 'dây cương' (harness) và cơ chế giám sát giúp Claude Opus 5 đạt 100% điểm ARC-AGI-3, vượt xa mức 30% khi chạy độc lập. Điều này khẳng định hạ tầng điều khiển quan trọng hơn chính mô hình AI trong các tác vụ dài hạn.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 92/100

Tinh chọnBài toán khó của Embedder: Dùng LLM thay thế mô hình nhúng truyền thống có đáng không?

Nghiên cứu so sánh toàn diện cho thấy dù LLM có hiệu suất ngang ngửa mô hình nhúng chuyên dụng, nhưng chi phí vận hành lại đắt gấp 1.400 lần và tốc độ xử lý chậm hơn đáng kể.


Vì sao đáng đọc: Nghiên cứu thực nghiệm giá trị, giải quyết bài toán tối ưu chi phí và hiệu năng thực tế cho kỹ sư AI khi lựa chọn giữa LLM và mô hình nhúng.

21/08

Thứ Sáu · 30 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnτ_0-VLA: Mô hình nền tảng robot phân cấp với khả năng tính toán linh hoạt nhờ mô hình thế giới

τ_0-VLA cải thiện khả năng thực hiện các tác vụ robot dài hạn bằng cách cho phép mô hình tự đánh giá và tìm kiếm phương án tối ưu trước khi hành động, thay vì chỉ phản hồi một lần duy nhất.


Vì sao đáng đọc: Đây là bước tiến quan trọng trong việc áp dụng cơ chế 'test-time compute' (tương tự o1 của OpenAI) vào điều khiển robot, giúp giải quyết các tác vụ phức tạp và dài hạn.
AI Notes@AYi_AInotes
Hướng dẫnĐiểm AI 32/100

Nghiên cứu từ Tây Ban Nha: Khung Agent ảnh hưởng đến chi phí vận hành hơn cả mô hình AI

Thực nghiệm cho thấy cùng một tác vụ, các khung Agent nhẹ (như Pi, Tau) tiêu tốn ít token hơn gấp 5-28 lần so với Claude Code hay qwen-code. Sự khác biệt về khung điều khiển có thể khiến chi phí vận hành chênh lệch tới 139 lần dù dùng chung một mô hình.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 36/100

AlphaEvolve: Bước tiến đột phá trong lý thuyết nhân ma trận của Google DeepMind

Google DeepMind just used AlphaEvolve to improve the best-known theoretical bound for matrix multipl…

DịchGoogle DeepMind sử dụng AlphaEvolve để thiết lập giới hạn lý thuyết mới cho phép nhân ma trận, giảm chỉ số ω xuống dưới 2.371177. Đây là bước tiến quan trọng tương đương với tổng thành tựu của 40 năm qua.

Hugging Face: Blog
Nghiên cứuĐiểm AI 69/100

Tinh chọnHugging Face vạch trần hiện tượng 'gian lận' điểm số trong các mô hình nhận dạng giọng nói (ASR)

Nghiên cứu mới từ Hugging Face chỉ ra nhiều mô hình ASR đạt điểm cao nhờ học thuộc lòng dữ liệu kiểm thử thay vì cải thiện khả năng nhận dạng thực tế, dẫn đến kết quả đánh giá bị thổi phồng.


Vì sao đáng đọc: Bài viết cung cấp góc nhìn chuyên sâu về lỗ hổng trong đánh giá AI, giúp cộng đồng nhận diện thực trạng 'học vẹt' của các mô hình hiện nay.
Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 30/100

Cùng sự kiệnGoogle giới thiệu EnvHarness và EnvRigger: Bước tiến mới trong huấn luyện môi trường cho AI

Impressive research from Google on building better environments for agents. Training environments f…

DịchGoogle phát triển EnvHarness và EnvRigger nhằm giải quyết hạn chế của các môi trường huấn luyện tĩnh, giúp AI tự thích nghi và tối ưu hóa hiệu suất thông qua việc tái cấu trúc hành vi và chẩn đoán lỗi. Giải pháp này giúp cải thiện đáng kể độ chính xác và rút ngắn thời gian thực thi tác vụ.

Cùng sự kiện, bài đại diện «EnvHarness: Phương pháp huấn luyện AI tự thích nghi với môi trường»
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnTư duy bằng ngôn ngữ ít tài nguyên: SFT xây dựng gì, RL sửa lỗi gì và những hạn chế của điểm số chính xác

Nghiên cứu chỉ ra rằng điểm số benchmark thường gây nhiễu, trong khi SFT thực sự giúp mô hình tư duy bằng ngôn ngữ mục tiêu thay vì chỉ dịch thuật ngầm, giúp việc kiểm chứng và sửa lỗi trở nên khả thi hơn.


Vì sao đáng đọc: Nghiên cứu thực nghiệm sâu sắc, thách thức cách đánh giá mô hình AI hiện nay và đưa ra góc nhìn quan trọng về khả năng tư duy ngôn ngữ của LLM.
JiQiZhiXin
Nghiên cứuĐiểm AI 88/100

Tinh chọnĐừng tự thiết kế poster nữa: AutoDesign giúp AI tự tiến hóa để làm thay bạn

AutoDesign giới thiệu hệ thống tự tiến hóa cho các tác vụ thiết kế phức tạp, cho phép AI tự tối ưu hóa quy trình làm việc để hoàn thành poster nghiên cứu chỉ trong 40 phút với chi phí cực thấp.


Vì sao đáng đọc: Đề tài thú vị về khả năng tự tiến hóa của Agent trong thiết kế. Giải quyết bài toán thực tế cho giới nghiên cứu, có mã nguồn và benchmark đi kèm, tính ứng dụng cao.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

NARU: Bộ tiêu chuẩn đánh giá khả năng hiểu diễn biến cốt truyện và sắc thái văn hóa trong video dài tiếng Nhật

NARU là bộ benchmark mới gồm 1.481 câu hỏi dựa trên 146 giờ video, giúp đánh giá sâu khả năng suy luận về diễn biến cốt truyện và các yếu tố văn hóa đặc thù trong video dài, vốn là điểm yếu của các mô hình AI hiện nay.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 52/100

NAPE: Bước tiến mới trong học tự giám sát cho âm thanh với dự đoán nhúng

NAPE là khung học tự giám sát tối giản sử dụng Transformer nhân quả để dự đoán các đoạn âm thanh tiếp theo mà không cần bộ giải mã phức tạp. Phương pháp này đạt hiệu suất vượt trội trên nhiều tác vụ âm thanh và giọng nói, đồng thời có khả năng mở rộng quy mô ấn tượng.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 55/100

SWE-bench Science: Liệu AI lập trình có thể giải quyết các bài toán kỹ thuật trong khoa học?

Nhóm nghiên cứu ra mắt SWE-bench Science, bộ tiêu chuẩn đánh giá khả năng giải quyết 119 tác vụ phần mềm khoa học. Kết quả cho thấy ngay cả mô hình mạnh nhất cũng chưa đạt 50% độ chính xác, đồng thời chỉ ra rằng kiến thức khoa học không phải lúc nào cũng giúp AI tối ưu hóa hiệu suất.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 50/100

Vạch trần lỗ hổng: Các mô hình ASR hàng đầu đang 'học vẹt' để đạt điểm chuẩn cao

Nghiên cứu mới chỉ ra rằng các mô hình ASR hàng đầu có xu hướng 'học vẹt' văn bản tham chiếu thay vì thực sự hiểu âm thanh, dẫn đến điểm số ảo dù dữ liệu đầu vào bị nhiễu hoặc thiếu hụt.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 92/100

Tinh chọnChain-of-Experience: Phương pháp giúp LLM tự cải thiện liên tục qua trải nghiệm thực tế

Nghiên cứu giới thiệu Chain-of-Experience (CoE), cho phép các mô hình ngôn ngữ lớn tự học hỏi và cải thiện hiệu suất thông qua phản hồi lặp lại từ chính mình hoặc môi trường, thay vì chỉ dựa vào suy luận một lần.


Vì sao đáng đọc: Đây là hướng tiếp cận đột phá giúp LLM vượt qua giới hạn zero-shot, có tính ứng dụng cao trong việc tối ưu hóa mô hình mà không cần huấn luyện lại.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 50/100

4DAnyone: Đột phá tái tạo người 4D từ video đơn khung hình

4DAnyone là khung làm việc mới giúp tái tạo mô hình người 4D từ video đơn lẻ mà không cần hiệu chuẩn, thông qua kỹ thuật 4D Gaussian Splatting. Phương pháp này giải quyết hiệu quả vấn đề nhất quán đa góc nhìn, mang lại chất lượng hình ảnh vượt trội so với các công nghệ hiện có.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 57/100

MemTrapBench: Bộ tiêu chuẩn mới đánh giá 'bẫy nhận thức' trong trí nhớ của LLM

MemTrapBench giải quyết lỗ hổng trong việc đánh giá cách bộ nhớ làm sai lệch khả năng suy luận của LLM. Nghiên cứu chỉ ra rằng các phương pháp ghi nhớ hiện tại thường gây tác dụng ngược, đồng thời giới thiệu AdaptiveMem giúp tối ưu hóa hiệu suất mà không mắc phải các bẫy nhận thức này.

Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (42 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Nghiên cứu AI” — Trang 24 | AIHOT.vn