Hôm nay · 28/09

Thứ Hai · 1 tin

26/09

Thứ Bảy · 2 tin
OpenRouter@OpenRouter
Sản phẩmĐiểm AI 35/100

OpenRouter ra mắt Jev Router: Bộ định tuyến mô hình thông minh tối ưu hóa bộ nhớ đệm

Introducing typesafe/jev-router: a cache-aware model router powered by Jev and @typesafeai The Jev …

DịchOpenRouter giới thiệu Jev Router, công cụ định tuyến mô hình tích hợp Jev và @typesafeai giúp tự động chọn mô hình tối ưu cho từng yêu cầu, cân bằng hoàn hảo giữa chất lượng, tốc độ và chi phí.

Ethan Mollick@emollick
Quan điểmĐiểm AI 30/100

Ethan Mollick: Đừng nhầm lẫn giữa đầu vào và đầu ra khi dùng AI

Leaving aside everything else, this confuses inputs with outputs. You want to get tasks done efficie…

DịchEthan Mollick cảnh báo việc quá tập trung vào tối ưu hóa chi phí token hay viết prompt ngắn gọn là sai lầm, vì mục tiêu cuối cùng là hoàn thành công việc hiệu quả chứ không phải tiết kiệm đầu vào.

25/09

Thứ Sáu · 2 tin
DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 58/100

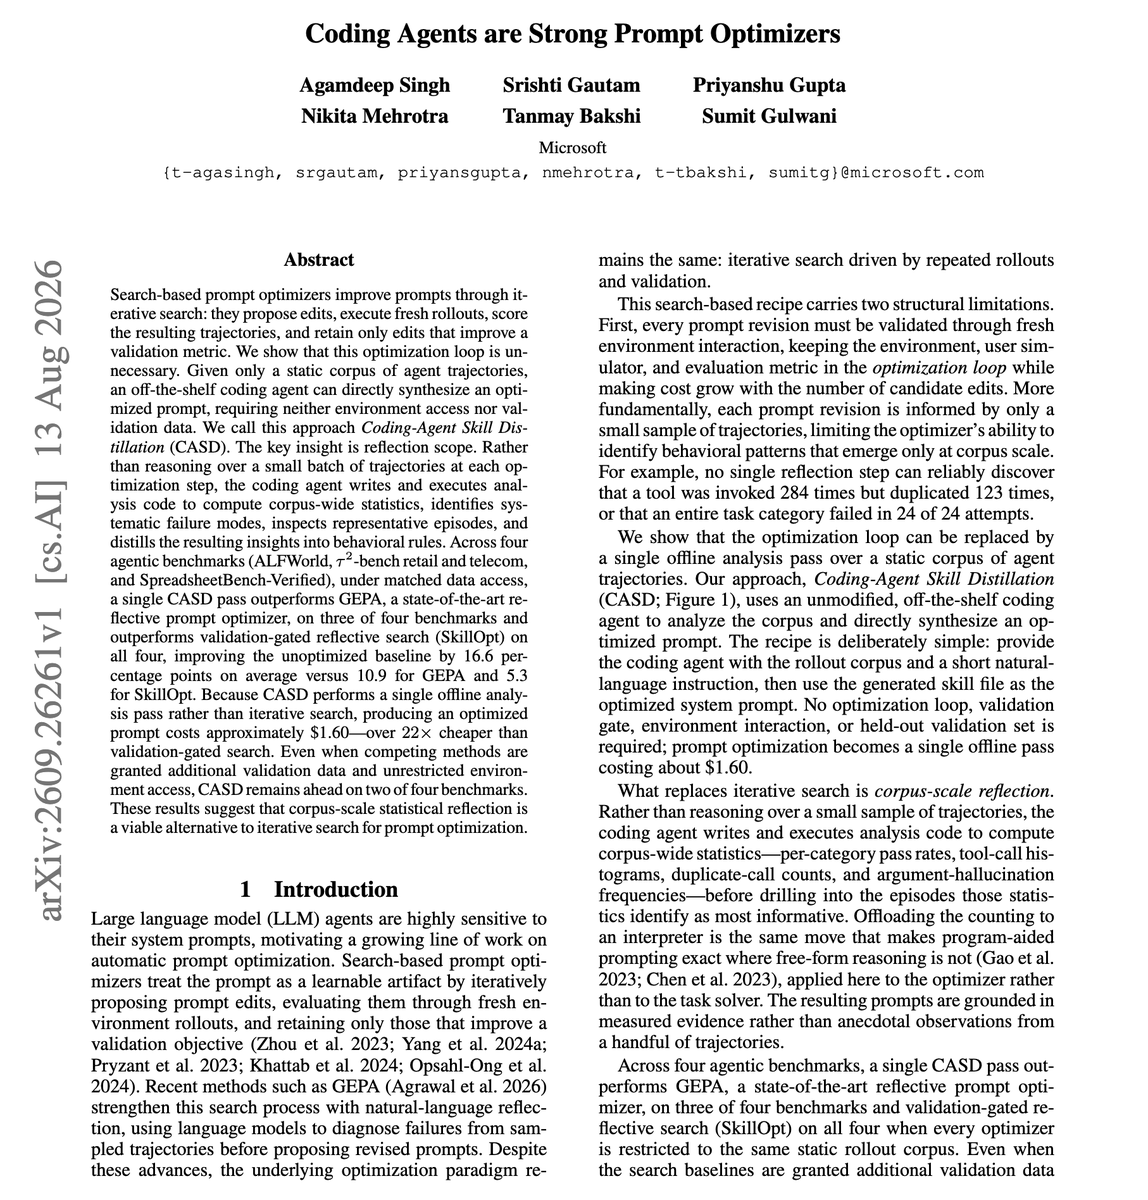
Microsoft giới thiệu CASD: Tối ưu hóa Prompt bằng Coding Agent, cải thiện hiệu suất 16.6 điểm

Banger paper from Microsoft on prompt optimization. (bookmark it) The claim that a coding agent re…

DịchNghiên cứu mới từ Microsoft đề xuất phương pháp CASD, cho phép các Coding Agent tự phân tích nhật ký hoạt động để tìm lỗi và viết lại prompt tối ưu mà không cần truy cập môi trường thực tế.

24/09

Thứ Năm · 6 tin
ModelBest OpenBMB@OpenBMB
Mô hìnhĐiểm AI 46/100

FIT-GGUF: Giải pháp lượng tử hóa hỗn hợp tùy chỉnh dung lượng cho MiniCPM5-2B

🚀 FIT-GGUF brings controllable-size mixed-precision quantization to MiniCPM5-2B Developer @Scorp1o_…

DịchCông cụ FIT-GGUF cho phép người dùng MiniCPM5-2B tùy chỉnh dung lượng file hoặc độ chính xác mong muốn. Hệ thống sẽ tự động phân bổ độ phân giải cho từng tensor, đồng thời dự đoán và xác thực file GGUF đầu ra.

MiniMax@MiniMax_AI
Mô hìnhĐiểm AI 29/100

MiniMax-H3 đổ bộ AMD MI355X: Tốc độ suy luận tăng vọt 26,7 lần

More ways to build with MiniMax-H3. 🐮 Great to see model optimization and AMD inference engineerin…

DịchNunchux tối ưu hóa MiniMax-H3 trên GPU AMD MI355X, giúp rút ngắn thời gian tạo video 5 giây xuống chỉ còn 1,3 giây. Công nghệ này hỗ trợ tạo video theo luồng, cho phép người dùng thay đổi câu lệnh ngay trong quá trình phát để điều hướng nội dung.

MarkTechPost
Mô hìnhĐiểm AI 62/100

Cùng sự kiệnContrastive-LM ra mắt CLM-8B: Mô hình System One đánh giá hành động Agent nhanh gấp 9 lần Jev

Contrastive-LM giới thiệu CLM-8B, mô hình ngôn ngữ đối chiếu đầu tiên tập trung vào việc chấm điểm và xếp hạng các hành động của Agent thay vì tạo văn bản, mang lại hiệu suất vượt trội so với Jev của TypeSafe AI.

Cùng sự kiện, bài đại diện «Ra mắt CLM-8B: Mô hình System One với tốc độ suy luận nhanh gấp 9 lần Jev»
Every: Bài mới (Web)
Hướng dẫnĐiểm AI 23/100

Tận dụng tối đa Jev: Chuyển đổi các câu hỏi chủ quan thành quy trình kiểm tra thực thi

Jev là một mô hình phân loại giúp biến các vấn đề chủ quan thành các bước kiểm tra có thể thực thi được. Bài viết phân tích lý do mô hình này trở nên phổ biến và sự trỗi dậy của xu hướng phần mềm dựa trên ý định (intent-based software).

23/09

Thứ Tư · 3 tin
IT Home
Mô hìnhĐiểm AI 50/100

Cùng sự kiệnXiaomi công bố kiến trúc MiMo-V3 với lõi HySparse 2 đột phá

Xiaomi chính thức ra mắt lõi HySparse 2 cho mô hình MiMo-V3, giúp giảm 5 lần khối lượng tính toán và 4,5 lần bộ nhớ KV cache ở độ dài 1M token, đồng thời cải thiện đáng kể hiệu suất xử lý ngữ cảnh dài.

Cùng sự kiện, bài đại diện «Xiaomi hé lộ kiến trúc HySparse2 trên MiMo-V3: Tối ưu cho Agent đa vòng hội thoại dài»
Aravind Srinivas (Perplexity CEO)@AravSrinivas
Nghiên cứuĐiểm AI 40/100

Perplexity tối ưu hóa AI Agent: Giảm 21% lỗi gọi công cụ nhờ phương pháp hậu huấn luyện mới

We're sharing new research on our post-training approach, which teaches the Perplexity Computer agen…

DịchPerplexity giới thiệu kỹ thuật hậu huấn luyện mới cho AI Agent, kết hợp mô phỏng hành vi tối ưu và tinh chỉnh RFT, giúp giảm 21% tỷ lệ lỗi khi gọi công cụ trong các thử nghiệm thực tế.

OpenAI: Tin chính thức (RSS - lọc nội dung doanh nghiệp/khách hàng)
Sản phẩmĐiểm AI 63/100

Tinh chọnOpenAI nâng cấp hệ thống Prompt Caching và công cụ chẩn đoán cho GPT-6

OpenAI tối ưu hóa hệ thống bộ nhớ đệm cho GPT-6, giúp giảm tới 90% chi phí token cho các nội dung lặp lại trong vòng 30 phút, đồng thời bổ sung công cụ chẩn đoán mới.


Vì sao đáng đọc: Đây là cập nhật quan trọng về hạ tầng kỹ thuật giúp giảm chi phí vận hành đáng kể cho người dùng và doanh nghiệp, có tính ứng dụng thực tế cao.

22/09

Thứ Ba · 11 tin
PixVerse@PixVerse
Mô hìnhĐiểm AI 29/100

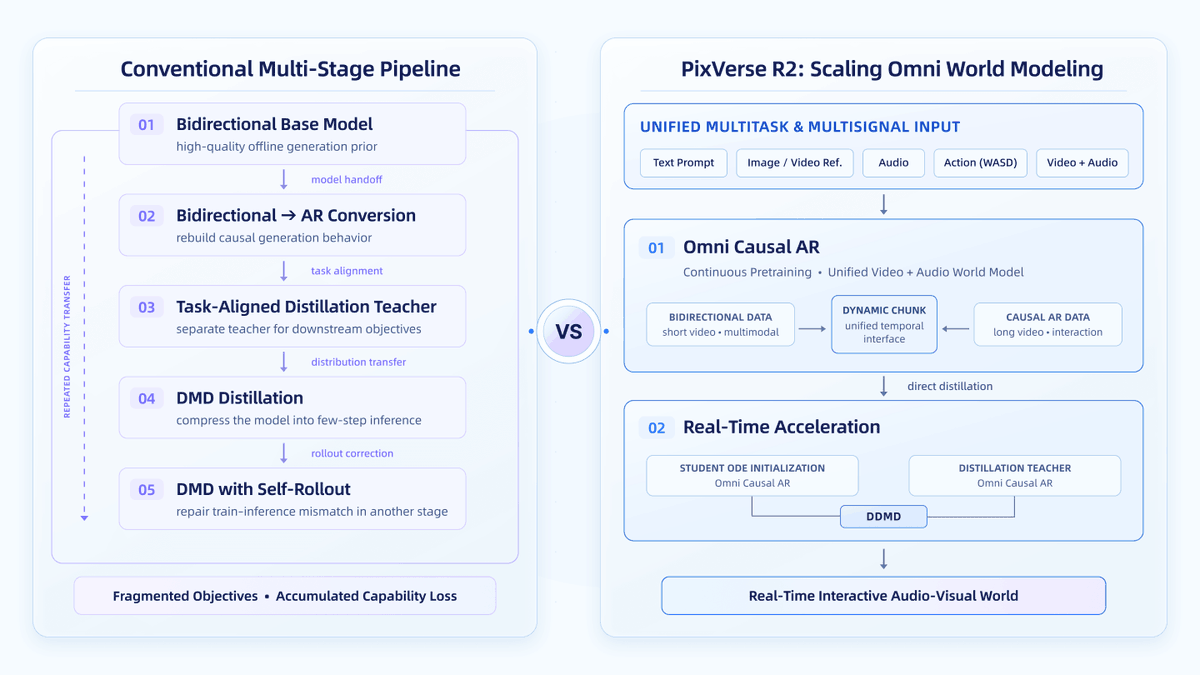
PixVerse R2: Đột phá giải mã bài toán cân bằng giữa hiệu suất và tốc độ trong mô hình thế giới

PixVerse R2 asks a fundamental question: can real-time world models scale? Real-time favors smaller…

DịchPixVerse R2 giới thiệu kiến trúc hai động cơ cốt lõi giúp tách biệt khả năng suy luận chuyên sâu và tốc độ xử lý thời gian thực, giải quyết mâu thuẫn kinh điển giữa quy mô mô hình và tính ứng dụng thực tế.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 45/100

Complex KDA: Tối ưu hóa khả năng biểu đạt của kiến trúc Kimi Delta Attention

Nghiên cứu giới thiệu Complex KDA (CKDA), kỹ thuật kết hợp biến đổi delta-rule với cơ chế cổng kênh để đạt được khả năng xoay 2D mà không cần tăng thứ hạng cập nhật, giúp nâng cao hiệu suất mô hình RNN.

Hugging Face: Blog
Sản phẩmĐiểm AI 72/100

Tinh chọnThư viện Transformers giờ đây hỗ trợ chạy trực tiếp mô hình GGUF với hiệu suất tiệm cận llama.cpp

Hugging Face đã cập nhật thư viện Transformers, cho phép người dùng tải trực tiếp các mô hình GGUF từ Hub thông qua hàm from_pretrained và tận dụng tối ưu hóa từ nhân Metal của ggml.


Vì sao đáng đọc: Đây là cập nhật quan trọng giúp đơn giản hóa quy trình triển khai mô hình AI cục bộ, kết hợp sức mạnh của hệ sinh thái Hugging Face với hiệu suất tối ưu của llama.cpp.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 43/100

D-RAC: Giải pháp chuẩn hóa tài liệu doanh nghiệp cho hệ thống RAG thông qua chuyển đổi PDF đa phương thức

D-RAC tối ưu hóa quy trình RAG bằng cách chuẩn hóa tài liệu sang PDF, sau đó dùng LLM đa phương thức chuyển đổi thành Markdown có cấu trúc, giúp tăng độ chính xác khi truy xuất dữ liệu.

Qwen@Alibaba_Qwen
Mô hìnhĐiểm AI 41/100

Qwen-Image-2.1 chính thức hỗ trợ OpenVINO từ ngày đầu ra mắt

Day-0 OpenVINO support from @inteldevs! 🥳 Qwen-Image-2.1 is ready to run optimized on Intel hardwar…

DịchMô hình Qwen-Image-2.1 hiện đã được tối ưu hóa để chạy mượt mà trên phần cứng Intel thông qua OpenVINO. Đây là mô hình mã nguồn mở hỗ trợ cả tính năng tạo và chỉnh sửa hình ảnh.

Thomas Wolf (Hugging Face đồng sáng lập/CSO)@Thom_Wolf
Mô hìnhĐiểm AI 43/100

Aikido ra mắt Altar-1: Mô hình bảo mật mã nguồn mở hiệu năng cao

nice to start seeing more open-weight security model with defensive capabilities which are close to …

DịchAikido vừa giới thiệu Altar-1, phiên bản tinh chỉnh và tối ưu hóa từ mô hình GLM 5.3, mang lại khả năng phòng thủ mạnh mẽ với cấu hình phần cứng gọn nhẹ, chỉ cần một node 4-H200s để vận hành.

21/09

Thứ Hai · 2 tin
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Quan điểmĐiểm AI 71/100

Dan McKinley: Đừng quá chú trọng Prompt, hãy tập trung vào hệ thống đánh giá và tối ưu tự động

Kỹ sư Dan McKinley cho rằng thay vì tinh chỉnh Prompt thủ công, các nhà phát triển nên xây dựng hệ thống tự cải tiến dựa trên dữ liệu đánh giá, kiểm thử tự động và vòng lặp phản hồi từ LLM để đạt hiệu quả thực tế.

20/09

Chủ Nhật · 2 tin
Fireworks AI (Web)
Sản phẩmĐiểm AI 61/100

Tinh chọnFireworks AI ra mắt FireRouter: Tương lai của AI không nằm ở một mô hình duy nhất

Fireworks AI giới thiệu FireRouter, giải pháp tối ưu hóa hiệu suất bằng cách điều hướng tác vụ thông minh qua 18 mô hình khác nhau, dựa trên phân tích từ 113 bài kiểm tra DeepSWE v1.1.


Vì sao đáng đọc: Đây là bước tiến quan trọng trong kỹ thuật tối ưu hóa chi phí và hiệu năng AI, cung cấp góc nhìn thực tiễn cho các doanh nghiệp đang triển khai mô hình ngôn ngữ lớn.

19/09

Thứ Bảy · 3 tin
JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnKV Cache không cần 'chọn lọc kỹ'? Phương pháp xóa ngẫu nhiên đạt hiệu suất tương đương, tăng tốc độ suy luận tới 43%

Nghiên cứu mới từ Salesforce và UIUC cho thấy việc xóa ngẫu nhiên các token trong KV Cache mang lại hiệu quả tương đương các thuật toán phức tạp, đồng thời giúp tăng đáng kể tốc độ suy luận nhờ giảm tải tính toán.


Vì sao đáng đọc: Đây là một phát hiện mang tính 'phản trực giác' nhưng có tác động lớn đến tối ưu hóa hạ tầng AI, giúp giảm chi phí vận hành mô hình ngôn ngữ lớn một cách thực tế.
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Nghiên cứuĐiểm AI 45/100

Cache-to-Cache: Đột phá giao tiếp ngữ nghĩa trực tiếp giữa các mô hình ngôn ngữ lớn

C2C là phương thức mới cho phép các LLM trao đổi thông tin trực tiếp qua KV-Cache thay vì văn bản. Kỹ thuật này giúp tăng độ chính xác lên tới 14,2% và cải thiện tốc độ xử lý gấp 2,5 lần so với các phương pháp truyền thống.

18/09

Thứ Sáu · 10 tin
Rohan Paul@rohanpaul_ai
Mô hìnhĐiểm AI 41/100

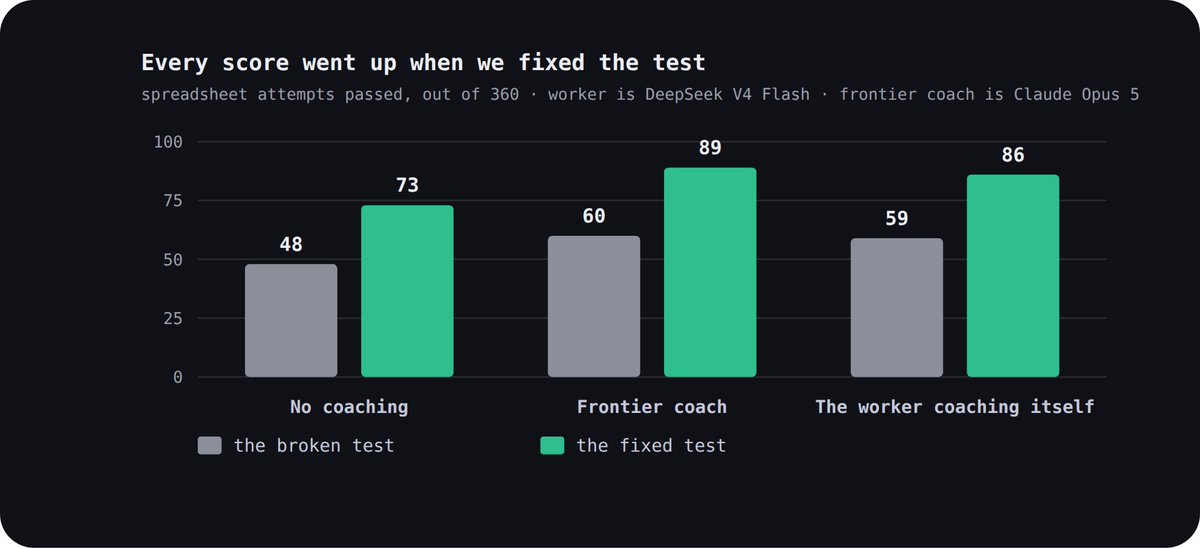
SentientAGI EvoSkill v2: AI tự viết kỹ năng từ thất bại mà không cần huấn luyện lại

Agent memory is no longer just context. Persistent skills can change future behavior, so treat them…

DịchEvoSkill v2 cho phép AI tự đúc kết kỹ năng từ các nhiệm vụ thất bại và lưu trữ vào bộ nhớ ngoài. Cơ chế này giúp AI cải thiện hiệu suất mà không cần thay đổi trọng số mô hình hay huấn luyện lại.

Thêm 1 nguồn khác đưa tinX: Elvis Saravia (@omarsar0, DAIR.AI)
X.PIN@thexpin
Hướng dẫnĐiểm AI 52/100

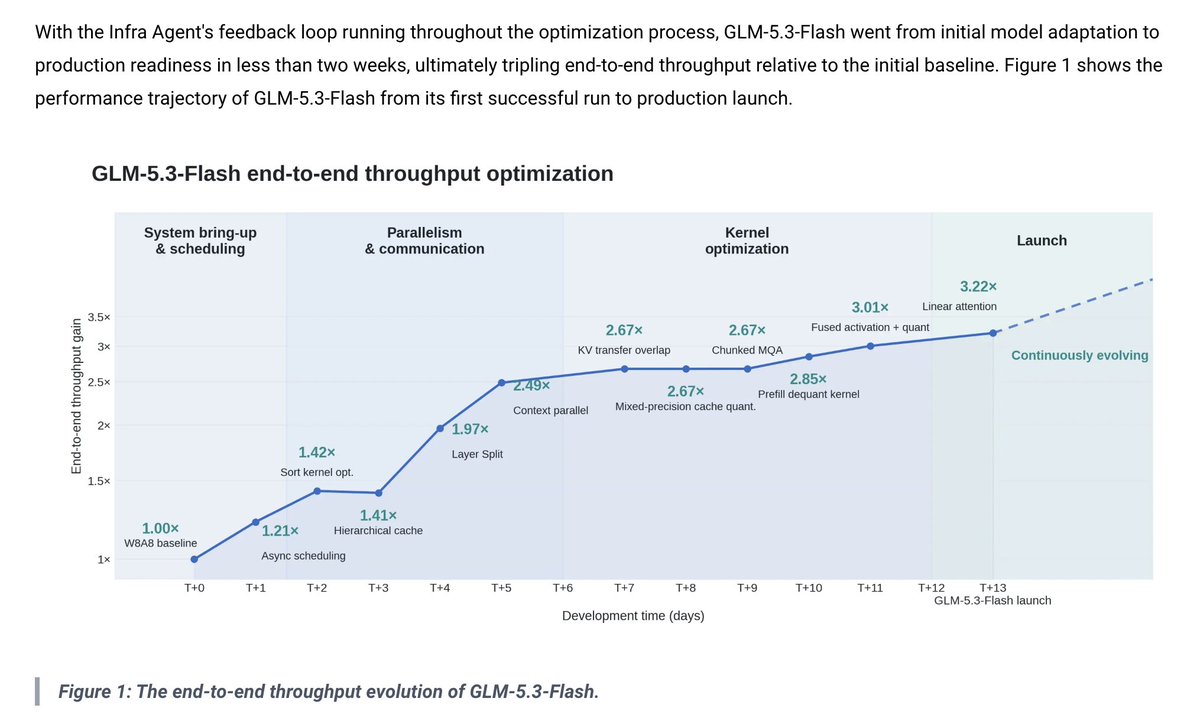
Z.ai tối ưu hóa GLM-5.3 trên 100.000 chip nội địa, tăng gấp 3 lần hiệu suất suy luận

http://Z.ai says its GLM-5.3-powered Infra Agent designed, debugged and optimized production inferen…

DịchZ.ai sử dụng Infra Agent để tối ưu hóa hạ tầng cho GLM-5.3-Flash trên hơn 100.000 chip Trung Quốc, đạt hiệu suất gấp 3 lần chỉ sau hai tuần. Đây là bước tiến đột phá khi mô hình tự cải thiện hạ tầng vận hành của chính mình.

IT Home
Mô hìnhĐiểm AI 61/100

Cùng sự kiệnPrismML ra mắt Bonsai 2 27B: Mô hình lượng tử hóa 3 giá trị, tiết kiệm 9 lần bộ nhớ mà vẫn giữ 98,2% hiệu năng

PrismML vừa giới thiệu Bonsai 2 27B dựa trên Qwen3.8, sử dụng kỹ thuật lượng tử hóa 3 giá trị giúp giảm dung lượng bộ nhớ xuống dưới 1/9 nhưng vẫn duy trì 98,2% hiệu suất so với bản gốc.

Cùng sự kiện, bài đại diện «PrismML ra mắt Ternary Bonsai 2 27B: Nén mô hình gấp 9 lần nhưng vẫn giữ 98,2% hiệu năng»
MiniMax@MiniMax_AI
Mô hìnhĐiểm AI 41/100

MiniMax-H3 tích hợp VC-Attention: Tăng tốc độ xử lý lên tới 1,6 lần

Three paths to faster video attention: compute the same interactions more efficiently, compute fewer…

DịchNunchux AI hợp tác cùng các đại học danh tiếng ra mắt VC-Attention, giúp tăng tốc độ suy luận cho MiniMax-H3 mà không cần huấn luyện lại, vượt trội hơn cả FlashAttention-4 về hiệu suất lẫn độ chính xác.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Mô hìnhĐiểm AI 85/100

Tinh chọnDeepSeek-V4.1-Flash ra mắt: Mô hình MoE 552B đa phương thức với công nghệ nén KV cache đột phá

DeepSeek vừa trình làng DeepSeek-V4.1-Flash, mô hình MoE đa phương thức 552 tỷ tham số hỗ trợ cửa sổ ngữ cảnh lên tới 1 triệu token, hiện đã có sẵn trên Hugging Face.

Diễn biến sự kiện · 5 bài →Thêm 1 nguồn khác đưa tinHacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)

Vì sao đáng đọc: Đây là bước tiến lớn về hiệu năng của DeepSeek với khả năng xử lý ngữ cảnh cực dài và tối ưu hóa bộ nhớ, thu hút sự quan tâm lớn từ cộng đồng AI.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 40/100

When2Think: Tối ưu hóa suy luận AI bằng cách điều chỉnh độ dài phản hồi theo độ khó

When2Think là khung huấn luyện hậu kỳ giúp mô hình AI tự nhận diện độ khó của câu hỏi để phân bổ tài nguyên tính toán linh hoạt. Phương pháp này giúp giảm 27,9% lượng token tiêu thụ mà vẫn tăng đáng kể độ chính xác trên các bài toán khó như AIME.

Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (50 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “tối ưu hóa AI” | AIHOT.vn