Sản phẩm
Fireworks AI ra mắt FireRouter: Tương lai của AI không nằm ở một mô hình duy nhất
(giờ Việt Nam)
Tóm tắt AI
Fireworks AI giới thiệu FireRouter, giải pháp tối ưu hóa hiệu suất bằng cách điều hướng tác vụ thông minh qua 18 mô hình khác nhau, dựa trên phân tích từ 113 bài kiểm tra DeepSWE v1.1.
Chính văn · Bản dịch AI
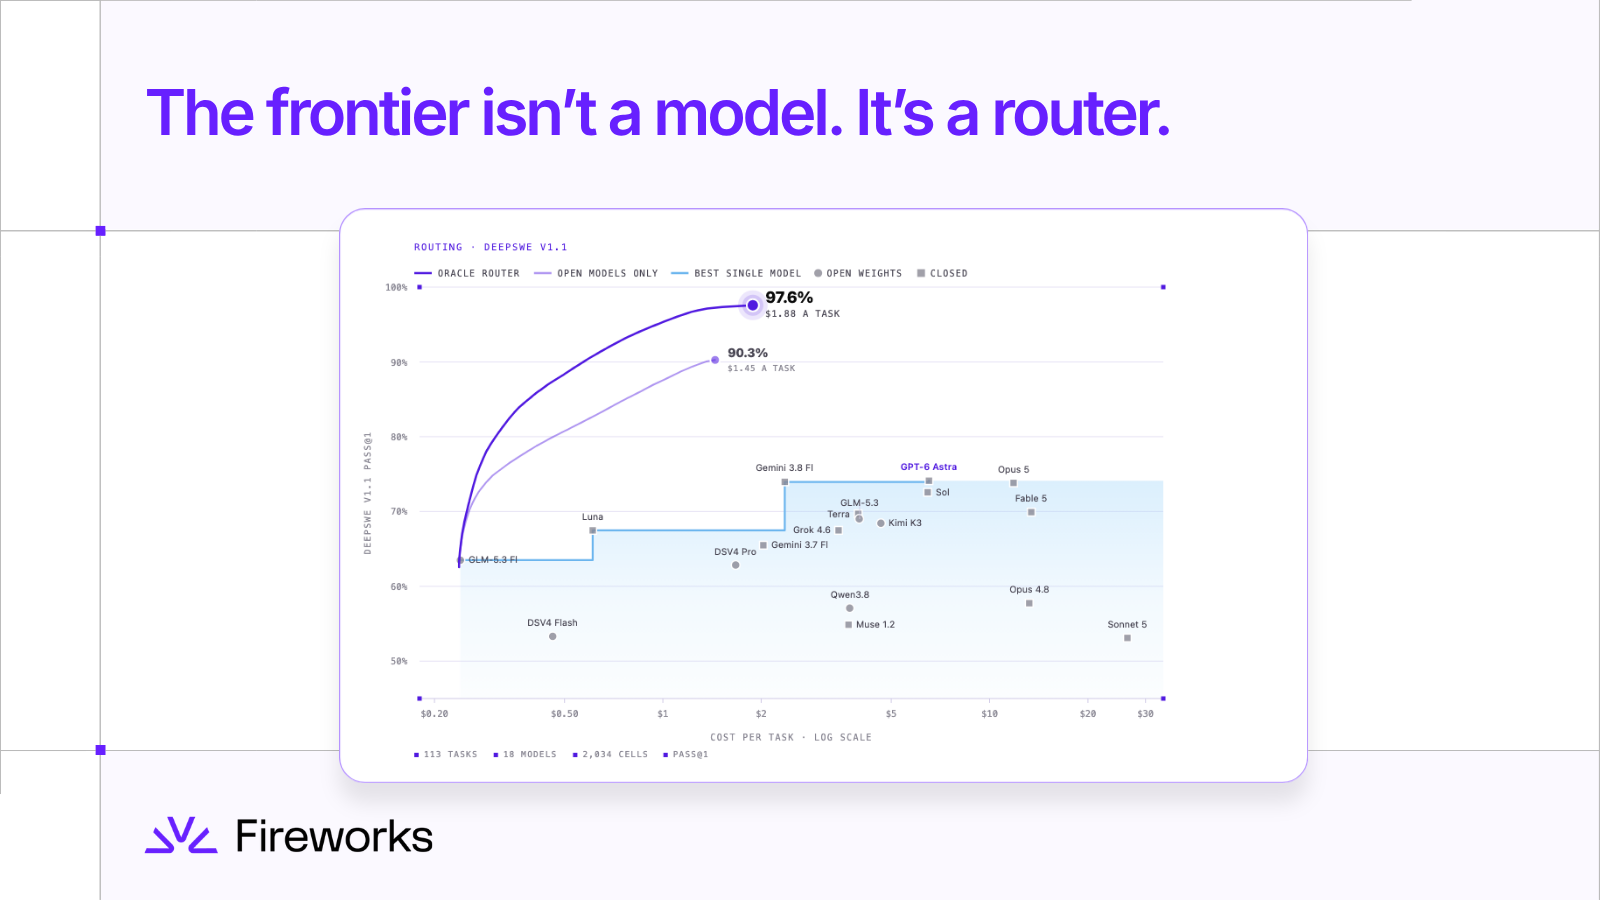
Một coding agent có thể đạt hiệu suất tốt hơn bao nhiêu nếu nó sử dụng mô hình tối ưu nhất cho từng tác vụ?
Mô hình đơn lẻ tốt nhất, GPT-6 Astra, đạt 74,1% các tác vụ DeepSWE với chi phí 6,52 USD mỗi tác vụ. Nếu chọn đúng mô hình cho từng tác vụ, cùng 18 mô hình đó đạt 97,6% với chi phí 1,88 USD. Tăng 23 điểm hiệu suất với chi phí chưa bằng một phần ba.
Con số đó có được nhờ nhìn lại quá khứ (hindsight). Chúng tôi đã chạy tất cả 18 mô hình trên mọi tác vụ trước, sau đó mới chọn ra người chiến thắng cho từng tác vụ. Điều này đo lường năng lực vốn đã tồn tại trong kho mô hình, nhưng lại bị phân tán giữa các mô hình mà không ai sử dụng kết hợp với nhau.
Việc kết hợp chúng lại là công việc của một router (bộ định tuyến). Nó chọn mô hình nào xử lý tác vụ trước khi công việc bắt đầu, và "trước khi bắt đầu" chính là phần khó nhất. Nhìn lại thì rất dễ để chỉ ra một tác vụ và gọi tên mô hình lẽ ra đã làm tốt hơn. Một router phải lựa chọn trước khi thấy kết quả, và một lựa chọn sai lầm sẽ tốn kém hơn nhiều so với vài đô la tiết kiệm được.
Năng lực hiện có trong kho mô hình là bao nhiêu?
Chúng tôi đã phân tích DeepSWE v1.1, một benchmark lập trình dạng agent, nơi đơn vị công việc là một tác vụ kỹ thuật: agent phải hiểu vấn đề, kiểm tra kho lưu trữ (repository), sử dụng công cụ, chỉnh sửa mã, thực thi và hoàn thành tác vụ.
Chính sách này cố tình được giữ đơn giản: Chọn một mô hình khi bắt đầu tác vụ và giữ nguyên trong suốt quá trình, không chuyển đổi giữa chừng.
Sau đó, chúng tôi xác định người chiến thắng cho mỗi tác vụ dựa trên tỷ lệ vượt qua (pass rate) đo lường được, với tiêu chí ưu tiên chi phí khi có kết quả ngang nhau. Đó là oracle router, phương pháp tương tự chúng tôi đã dùng trong phân tích Kimi K3 và Fable.
Oracle ghi điểm trên cùng 113 tác vụ mà nó chọn, sử dụng bốn lần chạy (rollout) cho mỗi cặp mô hình-tác vụ, và việc lấy giá trị tối đa trên 18 ước tính nhiễu sẽ làm chệch kết quả lên phía trên.
Các mô hình tốt nhất đạt khoảng 70% và tiêu tốn từ 6,46 USD đến 13,41 USD cho mỗi tác vụ để đạt được kết quả đó:
Đó là kết quả tốt nhất của chính sách sử dụng một mô hình cố định. Bây giờ, hãy thử chọn theo từng tác vụ:
Oracle router trên tất cả 18 mô hình đạt 97,6% với chi phí 1,88 USD mỗi tác vụ. Con số này cao hơn 23 điểm so với GPT-6 Astra, với chi phí chưa bằng một phần ba. Nếu chỉ giới hạn ở các mô hình mã nguồn mở (DeepSeek V4 Flash và Pro, GLM-5.3 và GLM-5.3 Flash, Kimi K3, Qwen3.8 Max), nó vẫn đạt 90,3% với chi phí 1,45 USD mỗi tác vụ, vượt qua mọi mô hình đóng ở đây 16 điểm trong khi chi phí chưa bằng một phần tư so với Astra.
Những kết quả này làm cho cuộc tranh luận "mở so với đóng" trở nên bớt thú vị hơn. Cuộc đua mới nổi là chuyển từ oracle router lý thuyết sang xây dựng một hệ thống các mô hình có trí tuệ tập thể tốt hơn bất kỳ mô hình đơn lẻ nào. Về nguyên tắc, một hệ thống các mô hình mở đã có thể vượt xa các mô hình đóng tiên tiến nhất.
Năng lực hiện có trong kho mô hình lớn hơn đáng kể so với những gì bất kỳ mô hình cá biệt nào thể hiện.
Bạn hiếm khi cần đến mô hình đắt tiền nhất.
Trong nghiên cứu trước đây, chúng tôi nhận thấy các mô hình khác nhau là đủ (thậm chí là xuất sắc) cho các tác vụ khác nhau. Phân tích DeepSWE làm cho các tác động về chi phí trở nên cụ thể. Tại điểm 97,6%, oracle vẫn gửi 94 trong số 113 tác vụ cho một mô hình có chi phí dưới 3 USD.
Ba mô hình đắt nhất trong lĩnh vực này, tất cả đều trên 11,50 USD mỗi tác vụ, chỉ là lựa chọn tốt nhất duy nhất cho đúng ba tác vụ.
Trên 79 trong số 113 tác vụ, ít nhất một trong những mô hình đắt tiền đó đạt điểm ngang bằng với điểm cao nhất nhưng lại thua về giá. Một mô hình đa năng mạnh mẽ có thể xuất sắc trên diện rộng mà không nhất thiết phải là lựa chọn duy nhất cần thiết cho hầu hết các tác vụ cụ thể.
Chính sách sử dụng mô hình cố định phải trả phí cho năng lực rộng trên mọi tác vụ. Một hệ thống có thể đặt ra câu hỏi hẹp hơn:
Tác vụ này thực sự đòi hỏi năng lực gì?
Một vài mô hình là đã đủ dùng.
Cần bao nhiêu mô hình để đạt được hiệu quả này?
Cặp mô hình tốt nhất tăng thêm 13,1 điểm so với mô hình đơn lẻ tốt nhất, và bộ ba tốt nhất đạt 91,2%. Mở rộng từ ba mô hình lên tất cả 18 mô hình chỉ tăng thêm 6,4 điểm phần trăm. Thứ hữu ích không phải là một danh mục hàng trăm mô hình gần như có thể thay thế cho nhau, mà là một danh mục đầu tư với khả năng bao phủ bổ trợ cho nhau.
Giá trị nằm ở khả năng bao phủ năng lực, không phải số lượng mô hình.
LLMRouterBench đánh giá việc định tuyến trên 33 mô hình và hơn 400.000 trường hợp. Nó cho thấy một số ít mô hình đã bao phủ hầu hết những gì toàn bộ tập hợp có thể làm, và các kho mô hình lớn hơn không mang lại nhiều giá trị nếu không được tuyển chọn kỹ lưỡng.
Phần khó nhất là dự đoán nên sử dụng mô hình nào.
Một oracle rất dễ được yêu thích vì nó không bao giờ sai. Một router trong thực tế thì có. Chúng tôi đã đo lường nó một cách nghiêm ngặt: chúng tôi sử dụng pass@1, xác suất mà một lần thử duy nhất thành công, thay vì quy tắc "mô hình này có từng thành công trong bốn lần thử hay không". Quy tắc thứ hai sẽ làm cho ngưỡng hiệu suất trông ấn tượng hơn nhiều nhưng lại mang ít ý nghĩa hơn.
Khoảng cách này là một vấn đề về sản phẩm và các tài liệu nghiên cứu đã chỉ ra điều đó một cách thẳng thắn. LLMRouterBench nhận thấy rằng một số phương pháp định tuyến gần đây, bao gồm cả các phương pháp thương mại, không thể đánh bại các phương pháp cơ bản đơn giản một cách đáng tin cậy, và nguyên nhân phần lớn nằm ở khả năng truy xuất mô hình (model recall): ngay cả khi một mô hình có năng lực phù hợp tồn tại trong kho, router vẫn phải nhận diện được khi nào cần sử dụng nó.
Vì vậy, việc gắn bó với một mô hình bạn biết rõ không phải là bảo thủ, mà là hợp lý: một phân phối lỗi ổn định tốt hơn một router chọn sai chuyên gia một cách khó đoán. Tiêu chuẩn cho một hệ thống định tuyến là làm cho việc chuyên môn hóa mô hình trở nên đủ dự đoán được để việc thay đổi mô hình cải thiện hệ thống mà không làm giảm độ tin cậy của nó.
Cách FireRouter thực hiện điều đó.
Định tuyến thường được giới thiệu như một giải pháp tối ưu hóa chi phí: gửi công việc dễ đến mô hình tối ưu chi phí hơn, dành mô hình đắt tiền cho công việc khó và giữ lại phần chênh lệch. Tại Fireworks, chúng tôi có cái nhìn rộng hơn.
Nếu các mô hình khác nhau thực sự bổ trợ cho nhau, thì việc lựa chọn giữa chúng sẽ giúp bạn tiến lên trên đường cong năng lực, chứ không chỉ di chuyển sang trái dọc theo đường cong chi phí.
Đó là mục đích mà FireRouter được xây dựng. Nó định tuyến ở cấp độ tác vụ trên cả mô hình mở và đóng, đồng thời nhận biết bộ nhớ đệm (cache aware), vì vậy việc chuyển đổi mô hình không làm mất đi ngữ cảnh mà bạn đã trả phí để có được.
Trong bốn tuần theo dõi lưu lượng lập trình thực tế của chúng tôi, các phiên được định tuyến qua FireRouter có chi phí 7,42 USD so với 15,81 USD nếu chỉ dùng Opus 5, giảm 53% trên 2.334 phiên.
Đơn vị công việc AI hữu ích đã lớn hơn một lệnh gọi mô hình đơn lẻ. Một coding agent là một mô hình nằm trong một bộ khung cung cấp ngữ cảnh, công cụ, khả năng thực thi, kiểm thử, trạng thái và phản hồi.
Khi một vài mô hình có thế mạnh bổ trợ cho nhau, chính sách lựa chọn trở thành một thành phần của hệ thống, bên cạnh ngữ cảnh, công cụ và kiểm thử. Việc lựa chọn và kết hợp các thành phần đó chính là công việc. Đó là kỹ thuật AI (AI engineering).
Thí nghiệm của chúng tôi chỉ đo lường phiên bản đơn giản nhất của hệ thống đó: chọn một mô hình khi bắt đầu tác vụ và giữ nguyên ở đó. Chính sách lựa chọn là phần chúng tôi thực sự có thể xây dựng.
Chúng tôi phục vụ mọi mô hình mở tiên tiến nhất trong môi trường thực tế, đó là nơi có được sự hiểu biết thực sự về thế mạnh của từng mô hình. Bạn không học được mô hình đó giỏi cái gì từ các điểm trung bình của benchmark. Bạn học được điều đó bằng cách chạy tất cả chúng, trên công việc thực tế, ở quy mô lớn. Đó là nơi các lựa chọn mô hình của FireRouter đến từ, và đó là tiêu chuẩn mà chúng tôi dự định đạt được. Chúng tôi sẽ đi sâu vào router của riêng mình và cách tối ưu hóa trí tuệ chuyên biệt của bạn trong các bài viết tương lai.
Xác định ranh giới của bạn trên FireRouter.
Bài viết được AI dịch và tổng hợp tự động từ Fireworks AI (Web). Liên kết bài gốc ở phía trên. Dữ liệu đồng bộ qua API công khai được ghi nguồn tại AI HOT (canonical) ↗. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.