08/09

Thứ Ba · 13 tin
Elvis Saravia@omarsar0
NgànhĐiểm AI 18/100

Prompt từ Anthropic giúp nâng tầm chất lượng viết của Fable và GPT-5.6

A few days ago, Anthropic shared this brilliant prompt. I was surprised by how it significantly im…

DịchMột bộ prompt mới từ Anthropic đã cho thấy hiệu quả bất ngờ khi cải thiện đáng kể khả năng viết lách của cả Fable 5.1 và GPT-5.6, trở thành công thức tối ưu cho mọi tác vụ biên tập AI.

07/09

Thứ Hai · 10 tin
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 61/100

Hiện tượng 'Trí nhớ thảm họa': Tại sao các tệp chỉ dẫn AI như CLAUDE.md ngày càng phình to?

New term "catastrophic remembering" CLAUDE.md has a ratchet problem: instructions are easy to add a…

DịchNghiên cứu trên 1.867 kho lưu trữ cho thấy các tệp chỉ dẫn AI tăng trưởng trung bình 226% do các lệnh cũ không được xóa bỏ. Giải pháp gắn kèm chú thích về bối cảnh giúp giảm đáng kể lượng từ thừa mà vẫn duy trì hiệu suất mô hình.

AI Notes@AYi_AInotes
Hướng dẫnĐiểm AI 57/100

Đừng nhồi nhét kỹ năng cho AI Agent: Cách tối ưu hóa hiệu suất bằng 'kiểm toán' prompt

Việc lạm dụng plugin và kỹ năng khiến AI Agent bị quá tải ngữ cảnh, làm giảm hiệu suất phản hồi. Tác giả chia sẻ prompt giúp lọc bỏ các kỹ năng dư thừa, chỉ giữ lại những công cụ cốt lõi để tối ưu hóa khả năng xử lý của mô hình.

Rohan Paul@rohanpaul_ai
NgànhĐiểm AI 45/100

Microsoft và Cornell công bố phương pháp huấn luyện AI hiệu quả, đạt hiệu suất tương đương mô hình lớn hơn 50%

Nghiên cứu mới từ Microsoft và Đại học Cornell giới thiệu kỹ thuật tối ưu hóa giúp mô hình AI đạt kết quả tương đương các mô hình tiêu chuẩn dù được huấn luyện với ít dữ liệu hơn 50%, hứa hẹn giảm đáng kể chi phí tính toán.

06/09

Chủ Nhật · 1 tin

05/09

Thứ Bảy · 11 tin
AI Notes@AYi_AInotes
Hướng dẫnĐiểm AI 72/100

Kiến trúc sư OpenAI Codex: Cách tối ưu Coding Agent bằng cách tinh giản AGENTS.md và Skill

Kiến trúc sư OpenAI Codex cảnh báo việc lạm dụng prompt dài và tài liệu cồng kềnh đang làm lãng phí token. Bài viết đề xuất 5 quy tắc tối ưu hóa giúp Coding Agent hoạt động hiệu quả hơn, kèm theo prompt kiểm tra kho lưu trữ và mẫu ủy quyền thực thi.

Sherwin Wu@sherwinwu
Hướng dẫnĐiểm AI 58/100

Sherwin Wu: Chi phí thực tế của GPT-6 Astra thường rẻ hơn 60% so với Fable 5.1

In today's regime, token costs can actually be quite misleading. For example, even though Astra and …

DịchDựa trên kết quả từ Bug Hunt Bench, Sherwin Wu (OpenAI) cho rằng giá niêm yết theo token thường gây hiểu lầm, vì GPT-6 Astra thực tế có chi phí vận hành thấp hơn đáng kể so với Fable 5.1 dù có cùng mức giá công bố.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 37/100

Google và KAIST giới thiệu Declarative Attention: Tối ưu hóa 52% chi phí tính toán cho mô hình AI

New Google Deployment Paper shows instead of forcing an LLM to reread its entire context for every t…

DịchNghiên cứu mới đề xuất cơ chế Declarative Attention cho phép mô hình tự chọn lọc ngữ cảnh cần thiết, giúp giảm đáng kể việc đọc bộ nhớ KV cache mà không cần thêm bộ đánh giá bên ngoài.

Aravind Srinivas (Perplexity CEO)@AravSrinivas
Sản phẩmĐiểm AI 36/100

Perplexity ra mắt kiến trúc mô hình pplx-embed: Tối ưu độ trễ vượt trội so với vLLM

Join us if you want to work on hard inference and infrastructure engineering problems!

DịchPerplexity vừa công bố kiến trúc phục vụ mô hình pplx-embed, giúp tăng tốc đáng kể các tác vụ embedding và reranking trên quy mô dữ liệu khổng lồ, vượt xa hiệu năng của vLLM.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 48/100

Uno: Mô hình LLM tăng cường khuếch tán giúp tăng tốc tạo token song song lên đến 3 lần

This work introduces diffusion-augmented LLMs, a new class of models. They first suggest that specu…

DịchNghiên cứu mới giới thiệu Uno, mô hình kết hợp khuếch tán vào LLM tự hồi quy để dự đoán nhiều token cùng lúc mà không làm giảm độ chính xác, giúp tăng tốc độ tạo văn bản gấp 3 lần.

SemiAnalysis@SemiAnalysis_
Hướng dẫnĐiểm AI 27/100

SemiAnalysis: Tại sao tối ưu hóa GPU kernel cho LLM lại đáng giá hàng trăm triệu USD?

A (popcorn) kernel is a specialized seed from a variety of corn that can burst open and turn inside …

DịchSemiAnalysis giải thích rằng việc tối ưu hóa các dòng mã GPU kernel giúp tận dụng tối đa sức mạnh tính toán của Tensor Core. Ở quy mô của OpenAI, chỉ cần cải thiện vài phần trăm hiệu suất kernel cũng có thể tiết kiệm hàng trăm triệu USD chi phí hạ tầng.

Gabriel@gabriel1
Hướng dẫnĐiểm AI 22/100

Astra có thực sự tiết kiệm chi phí hơn Sol nhờ hiệu suất token vượt trội?

is astra really so token efficient that it's cheaper than sol even if per token it's 2.5x more expen…

DịchTác giả đặt nghi vấn liệu mức giá trên mỗi token của Astra cao gấp 2,5 lần Sol có được bù đắp bởi hiệu suất sử dụng token tốt hơn, giúp tổng chi phí thực tế thấp hơn hay không.

04/09

Thứ Sáu · 18 tin
Mustafa Suleyman (Microsoft AI CEO)@mustafasuleyman
Mô hìnhĐiểm AI 50/100

Microsoft AI ra mắt MAI-Image-2.6-Flash: Tốc độ nhanh gấp đôi, tối ưu chi phí vượt trội

Our new image model generates images 2x faster than GPT-Image-2, currently the best model in the wor…

DịchMicrosoft AI vừa giới thiệu mô hình tạo ảnh MAI-Image-2.6-Flash với tốc độ nhanh gấp đôi và hiệu suất GPU tăng 72% so với phiên bản tiền nhiệm, thiết lập chuẩn mực mới về hiệu năng trên giá thành.

Thêm 3 nguồn khác đưa tinIT HomeX: OpenRouter (@OpenRouter)X: Kim (@kimmonismus)
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 41/100

DRACO: Tối ưu hóa phân bổ tín dụng cho tác nhân AI dài hạn bằng tiêu chuẩn đánh giá động

DRACO giải quyết bài toán thiếu tín hiệu phản hồi trong huấn luyện tác nhân dài hạn bằng cách tự động tạo tiêu chuẩn đánh giá theo quỹ đạo, giúp phân bổ điểm số chính xác cho từng bước mà không cần thêm mô-đun quy gán phức tạp.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 43/100

HarnessEvolve: Tối ưu hóa khả năng tự tiến hóa của AI Agent thông qua quỹ đạo tham chiếu

Self-improving agents have a basic problem: when a long run fails, they often do not know which step…

DịchNghiên cứu mới từ Huawei và các đối tác giới thiệu HarnessEvolve, phương pháp giúp AI Agent tự sửa lỗi bằng cách phân tích quỹ đạo thực thi, từ đó tinh chỉnh prompt, kỹ năng và logic vận hành để đạt hiệu suất ổn định hơn.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 40/100

Scal3R: Phương pháp truy vấn tư thế tương đối đa khung hình giúp ổn định tái tạo 3D video dài

Scal3R tối ưu hóa tái tạo 3D trực tuyến bằng cách sử dụng các token học được để tinh chỉnh mô hình nền, kết hợp tối ưu hóa đồ thị tư thế giúp giảm thiểu sai số tích lũy trong các video dài.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 46/100

Compile by Training: Chuyển đổi đặc tả ngôn ngữ tự nhiên thành hàm thần kinh cục bộ

Nghiên cứu giới thiệu phương pháp 'Compile by Training', cho phép biên dịch các yêu cầu ngôn ngữ tự nhiên thành các adapter nhỏ gọn, có thể tái sử dụng, lưu trữ và kết hợp như phần mềm truyền thống mà không cần phụ thuộc vào mô hình lớn khi vận hành.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 45/100

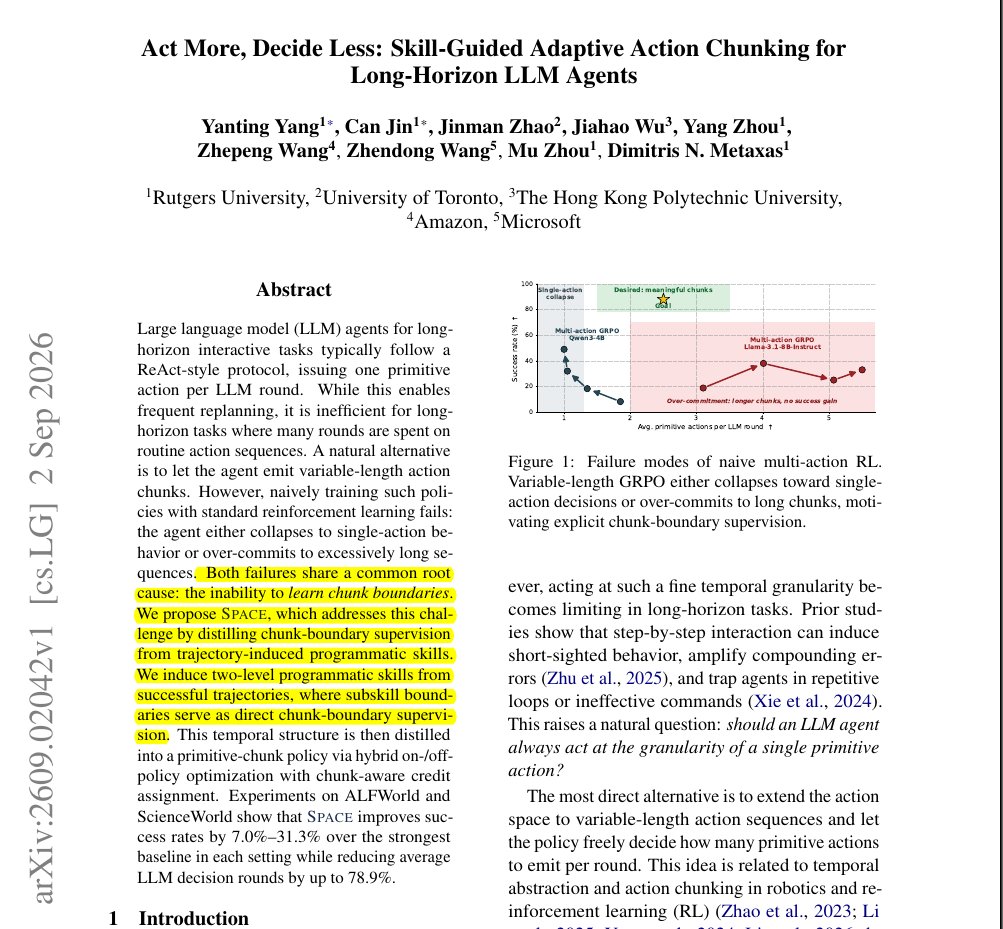
Amazon và Microsoft giới thiệu SPACE: Tối ưu hóa tác vụ cho AI Agent bằng cách nhóm các hành động

New Amazon Microsoft paper shows long-horizon agents should not need an LLM decision after every tin…

DịchPhương pháp SPACE giúp AI Agent rút ngắn quy trình ra quyết định bằng cách học cách nhóm các hành động an toàn lại với nhau thay vì xử lý từng bước nhỏ, giúp tăng hiệu suất cho các tác vụ dài hạn.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 52/100

Random Attention: Tối ưu hóa KV Cache bằng cơ chế loại bỏ ngẫu nhiên giúp tăng tốc suy luận LLM

Salesforce giới thiệu Random Attention, phương pháp thay thế việc đánh giá token bằng cách loại bỏ ngẫu nhiên trong KV cache. Kỹ thuật này giúp tăng 32-43% lưu lượng xử lý trên vLLM mà vẫn duy trì độ chính xác tương đương các phương pháp tiên tiến nhất.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 51/100

Tái tư duy về chưng cất mô hình On-Policy: Chỉ cần một mẫu dữ liệu là đủ?

Nghiên cứu khám phá vai trò của dữ liệu trong chưng cất mô hình (OPD), chứng minh rằng chỉ với một truy vấn duy nhất, mô hình có thể cải thiện hiệu suất liên tục qua hàng trăm bước và đạt được phần lớn lợi ích so với việc dùng toàn bộ tập dữ liệu.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 66/100

Nghiên cứu Trace as State: Thay đổi vị trí suy luận giúp tăng độ chính xác cho ngữ cảnh dài lên tới 50 điểm

Great tips on working with reasoning models. Normally you would append what the model figured out a…

DịchNghiên cứu mới đề xuất đặt các bước suy luận trước khối ngữ cảnh dài thay vì để ở cuối, giúp mô hình tận dụng thông tin dẫn dắt để xử lý tài liệu hiệu quả hơn, cải thiện đáng kể độ chính xác.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 46/100

SPACE: Phương pháp mới giúp AI Agent giảm 78,9% số lần gọi LLM nhờ phân đoạn hành động thông minh

Brilliant paper on long-horizon agents. They cut 78.9% of an agent's LLM calls while raising its su…

DịchNghiên cứu SPACE giới thiệu cách tối ưu hóa hành động cho AI Agent thông qua việc học các kỹ năng phân cấp, giúp giảm đáng kể tần suất gọi LLM trong các tác vụ dài hạn mà vẫn duy trì hiệu suất cao.

Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (56 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “tối ưu hóa” — Trang 7 | AIHOT.vn