10/09

Thứ Năm · 17 tin
Elvis Saravia@omarsar0
NgànhĐiểm AI 41/100

AWS giới thiệu UnitBoost: Thay thế tác nhân quản lý bằng toán tử hợp nhất trong hệ thống LLM

Great paper from AWS. I use a similar setup where an agent orchestrator sits on top of a multi-agen…

DịchAWS đề xuất UnitBoost, phương pháp sử dụng bản đồ đơn vị để chuyển đổi đầu ra của các mô hình thành giá trị cụ thể, loại bỏ nhu cầu về tác nhân quản lý (meta-agent) phức tạp trong các hệ thống LLM đa nhiệm.


DAIR.AI@dair_ai
NgànhĐiểm AI 41/100

RobustSGPO: Bước tiến mới trong kiểm soát không gian tìm kiếm cho Agent

If you run automated prompt or harness evolution, this one is worth your time. (bookmark it) Seman…

DịchRobustSGPO bổ sung cơ chế kiểm soát chỉnh sửa cho tối ưu hóa gợi ý gradient ngữ nghĩa, giúp cải thiện đáng kể tỷ lệ hoàn thành nhiệm vụ và chất lượng đầu ra trong các quy trình làm việc của Agent.

The Decoder: AI News
Mô hìnhĐiểm AI 79/100

Đã có đại diệnDeepSeek ra mắt V4.1-Flash: Đột phá giảm bộ nhớ KV cache cho AI Agent

DeepSeek vừa phát hành mô hình đa phương thức V4.1-Flash theo giấy phép MIT trên Hugging Face, tập trung tối ưu hóa chi phí xử lý ngữ cảnh dài và nén bộ nhớ KV cache cho các tác vụ AI Agent.

Cùng sự kiện, tinh chọn hiển thị «DeepSeek ra mắt DeepSeek-V4.1-Flash: Cửa sổ 1M token, tối ưu bộ nhớ KV Cache cực đỉnh»
SemiAnalysis@SemiAnalysis_
Mô hìnhĐiểm AI 67/100

Cùng sự kiệnDeepSeek ra mắt DeepSeek-V4.1-Flash: Mô hình 552B với cơ chế kích hoạt siêu tinh gọn

Congrats to @deepseek_ai on releasing DeepSeek-V4.1-Flash! > 552B backbone, with a causal encode…

DịchDeepSeek-V4.1-Flash sở hữu kiến trúc 552B tham số nhưng chỉ kích hoạt 8B-16B khi vận hành. Nhờ bộ nhớ Engram 196B và kỹ thuật nén KV cache, mô hình đạt hiệu suất vượt trội với tài nguyên tối ưu.

Cùng sự kiện, tinh chọn hiển thị «DeepSeek ra mắt DeepSeek-V4.1-Flash: Cửa sổ 1M token, tối ưu bộ nhớ KV Cache cực đỉnh»
Hugging Face: Blog
Sản phẩmĐiểm AI 65/100

Tinh chọnHugging Face ra mắt Workflow1111: Tái hiện sức mạnh của AUTOMATIC1111 bằng Gradio

Hugging Face giới thiệu Workflow1111, sử dụng 73 node Gradio để tái lập hầu hết các tính năng chủ chốt của AUTOMATIC1111, từ tạo ảnh, inpaint, ControlNet đến hỗ trợ video, mang lại trải nghiệm linh hoạt và trực quan hơn.


Vì sao đáng đọc: Đây là bước tiến quan trọng giúp đơn giản hóa quy trình làm việc với Stable Diffusion, biến các tính năng phức tạp thành luồng công việc trực quan, rất hữu ích cho cộng đồng AI.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

HybridAL: Tối ưu hóa chiến lược huấn luyện trong Active Learning bằng tín hiệu ổn định

Nghiên cứu đề xuất HybridAL, phương pháp tự động chuyển đổi giữa huấn luyện lại từ đầu và tinh chỉnh (fine-tuning) dựa trên tín hiệu ổn định của mô hình, giúp tiết kiệm tài nguyên mà vẫn duy trì hiệu suất tối ưu.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 39/100

Φ-Bench: Đánh giá khả năng của LLM trong việc tự tối ưu hóa hạ tầng kỹ thuật

Φ-Bench là bộ tiêu chuẩn mới giúp đánh giá năng lực của LLM trong việc giải quyết các bài toán kỹ thuật phức tạp, từ tối ưu hóa kernel đến xây dựng hệ thống hạ tầng AI hoàn chỉnh dựa trên mã nguồn thực tế.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

AgenticGen: Khung làm việc AI tạo video quảng cáo dựa trên phản hồi hiệu suất kinh doanh

AgenticGen tối ưu hóa việc tạo video quảng cáo bằng cách kết hợp chiến lược và tạo bản thảo, sử dụng phản hồi từ hiệu suất kinh doanh thực tế để tinh chỉnh chất lượng video thay vì chỉ dựa vào hình ảnh đơn thuần.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnGraph Machine: Đột phá kiến trúc mới giúp tối ưu hóa tiền huấn luyện mô hình ngôn ngữ

Graph Machine (GM) là kiến trúc mới sử dụng các 'cạnh' (edges) linh hoạt để truy xuất dữ liệu, giúp duy trì độ phức tạp O(n) mà vẫn đảm bảo tính thưa thớt hiệu quả. Phương pháp này cho phép thay thế phần lớn các lớp Transformer truyền thống với hiệu suất vượt trội và chi phí tính toán thấp.


Vì sao đáng đọc: Đây là một nghiên cứu kỹ thuật chuyên sâu có tiềm năng thay đổi cách thiết kế kiến trúc mô hình ngôn ngữ, giúp giảm tài nguyên tính toán mà vẫn giữ được độ chính xác.
Elvis Saravia@omarsar0
NgànhĐiểm AI 38/100

Tại sao tối ưu hóa đồng bộ giữa mô hình và khung làm việc lại là chìa khóa?

Highly recommended. Model-harness co-optimization is where you design the harness for the task and t…

DịchElvis Saravia nhấn mạnh việc tối ưu hóa đồng bộ giữa mô hình và khung làm việc (harness engineering) là yếu tố then chốt để khai phá tiềm năng thực sự của AI, thay vì chỉ tinh chỉnh mô hình đơn thuần.

09/09

Thứ Tư · 14 tin
ModelBest OpenBMB@OpenBMB
NgànhĐiểm AI 36/100

MiniCPM5-2B: Tăng tốc 34% hiệu suất cho tác vụ AI cục bộ

Same Q4_K_M quant, same tasks, same success rate, MiniCPM5-2B can get tasks done quicker. This makes…

DịchMô hình MiniCPM5-2B của OpenBMB vượt trội hơn Qwen3.5-4B với tốc độ xử lý nhanh hơn 34% trong các tác vụ thực tế, mở ra tiềm năng lớn cho các ứng dụng AI chạy trực tiếp trên thiết bị.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 31/100

A*-Thought-V2: Tối ưu hóa suy luận LLM thông qua động lực học hình học

A*-Thought-V2 cải thiện hiệu suất suy luận bằng cách mô hình hóa chuỗi tư duy dưới dạng quỹ đạo trạng thái ẩn, giúp tăng độ chính xác lên 2,6% và giảm đáng kể thời gian tính toán cũng như tài nguyên huấn luyện.

DAIR.AI@dair_ai
NgànhĐiểm AI 37/100

RSM-full: Phương pháp tối ưu bộ nhớ cho AI giúp tiết kiệm 68% token mà vẫn giữ 83% chất lượng

Good work on improving memory for long-horizon agents. They separate two things that agent memory p…

DịchRSM-full tách biệt quy trình ghi và đọc bộ nhớ, cho phép các tác nhân AI xử lý ngữ cảnh dài hiệu quả hơn. Với ngân sách 4k token, phương pháp này vượt trội hơn các mô hình RAG truyền thống và đạt hiệu suất tương đương với toàn bộ ngữ cảnh gốc.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnBeaconKV: Tối ưu bộ nhớ KV Cache cho mô hình suy luận lớn thông qua truy vấn Beacon

BeaconKV giải quyết nút thắt bộ nhớ khi suy luận dài bằng cách xác định các 'Thought Revisiting Tokens' quan trọng, giúp nén KV cache hiệu quả mà không làm giảm khả năng truy xuất ngữ cảnh xa.


Vì sao đáng đọc: Giải pháp kỹ thuật thực tế, giải quyết vấn đề cấp bách về bộ nhớ GPU cho các mô hình suy luận dài (LRMs), có tính ứng dụng cao trong triển khai thực tế.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 37/100

Đột phá mới trong huấn luyện AI: Phương pháp OPRD giúp mô hình học sinh vượt mặt thầy giáo yếu

Phương pháp On-Policy Reverse Distillation (OPRD) cho phép mô hình AI học từ giáo viên yếu nhưng vẫn đạt hiệu suất vượt trội, nhờ cơ chế lọc và khuếch đại các cập nhật tối ưu từ trình xác thực.

AK@_akhaliq
NgànhĐiểm AI 30/100

Đột phá mới: Tăng tốc LLM không mất dữ liệu nhờ mô hình khuếch tán rời rạc

Unlocking Lossless Speedups in LLMs via Discrete Diffusion paper: https://huggingface.co/papers/260...

DịchNghiên cứu mới giới thiệu phương pháp sử dụng mô hình khuếch tán rời rạc (discrete diffusion) để tăng tốc độ xử lý cho các mô hình ngôn ngữ lớn mà vẫn đảm bảo độ chính xác tuyệt đối.

SemiAnalysis@SemiAnalysis_
NgànhĐiểm AI 44/100

vLLM cập nhật hỗ trợ DSpark kết hợp song song hóa đường ống (Pipeline Parallelism)

Spec Decoding (DSpark) finally works with Pipeline Parallelism in vLLM!! 🔥 A lot of the GPU poor/pr…

DịchvLLM hiện đã cho phép DSpark hoạt động cùng Pipeline Parallelism, giúp các mô hình siêu lớn (như Kimi K3 2.8T) tận dụng được khả năng suy luận dự đoán ngay cả khi phải chia nhỏ trọng số trên nhiều máy.

Cohere@cohere
Sản phẩmĐiểm AI 50/100

Cohere ra mắt hệ thống suy luận LLM mã nguồn mở mới, nhanh hơn vLLM tới 1,58 lần

Introducing the next evolution in LLM text generation: the first fully-fledged serving system built …

DịchCohere vừa giới thiệu hệ thống phục vụ tạo văn bản LLM dựa trên kiến trúc decode megakernel, mang lại hiệu suất vượt trội so với vLLM và được phát hành hoàn toàn dưới dạng mã nguồn mở.

Lauren Tan@poteto
NgànhĐiểm AI 33/100

pstack 0.15.0 ra mắt: Tối ưu hóa hiệu suất token lên tới 11%

pstack 0.15.0 is here! this release contains mainly token usage improvements (between 3 to 11% savin…

DịchPhiên bản pstack 0.15.0 cải thiện hiệu suất sử dụng token từ 3-11% tùy theo số lượng kỹ năng, đồng thời bổ sung các nguyên tắc mới giúp tinh gọn quy trình kiểm thử và loại bỏ các nội dung dư thừa.

Rohan Paul@rohanpaul_ai
NgànhĐiểm AI 43/100

Uno: Giải pháp tăng tốc suy luận LLM bằng mô hình khuếch tán song song

Uno shows a simple way to speed up existing LLMs without changing their output distribution: keep th…

DịchUno tối ưu hóa suy luận LLM bằng cách sử dụng mô hình khuếch tán để dự đoán song song nhiều token mà không làm thay đổi chất lượng đầu ra. Phương pháp này giúp tăng thông lượng lên tới 2,5 lần và đẩy nhanh quá trình huấn luyện RL tới 40% trên mô hình Qwen3-8B.

08/09

Thứ Ba · 13 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 92/100

Tinh chọnTăng tốc LLM không mất dữ liệu bằng mô hình khuếch tán rời rạc

Nghiên cứu giới thiệu phương pháp kết hợp mô hình khuếch tán vào LLM để tạo nhiều token song song, giúp tăng tốc độ suy luận mà không làm giảm độ chính xác so với cách dự đoán tuần tự truyền thống.


Vì sao đáng đọc: Đây là bước tiến đột phá trong việc giải quyết nút thắt cổ chai của LLM, mang lại hiệu năng cao mà không cần đánh đổi chất lượng, rất có giá trị cho cộng đồng nghiên cứu AI.
Rohan Paul@rohanpaul_ai
NgànhĐiểm AI 46/100

Đột phá cho mô hình ngữ cảnh dài: Phương pháp 'Trace as State' giúp tối ưu hóa suy luận

For hard long-context tasks, the paper suggests a simple fix: run the model again with its previous …

DịchPhương pháp mới sử dụng dấu vết suy luận làm trạng thái điều kiện, giúp mô hình tập trung vào các điểm trọng yếu trong ngữ cảnh dài, giải quyết triệt để tình trạng bỏ lỡ thông tin quan trọng. Kết quả thử nghiệm cho thấy hiệu suất vượt trội trong 26/27 bài kiểm tra.

vLLM Blog chính thức
Hướng dẫnĐiểm AI 63/100

Tinh chọnvLLM kết hợp AgentX: Tối ưu hóa toàn diện cho các tác vụ suy luận AI Agent thực tế

Đội ngũ vLLM công bố tối ưu hóa hiệu suất cho các tác vụ AI Agent, đạt tốc độ ấn tượng 83K tokens/giây trên mỗi GPU với mô hình DeepSeek V4 Pro dựa trên chuẩn AgentX.


Vì sao đáng đọc: Đây là bước tiến kỹ thuật quan trọng giúp tăng tốc độ xử lý cho các hệ thống AI Agent, rất hữu ích cho các kỹ sư và nhà phát triển ứng dụng LLM.
Rohan Paul@rohanpaul_ai
NgànhĐiểm AI 47/100

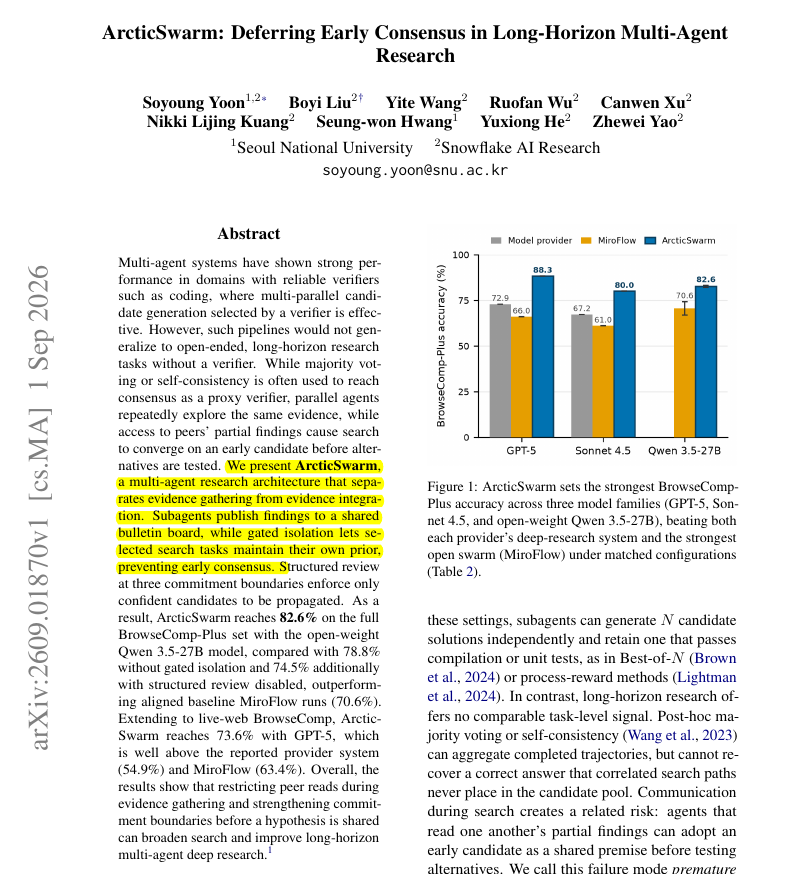
ArcticSwarm: Đột phá trong nghiên cứu đa tác nhân AI nhờ cơ chế cô lập tìm kiếm

Letting research agents talk too early can make them follow the same wrong idea, so isolate some sea…

DịchArcticSwarm giải quyết vấn đề 'đồng thuận sớm' bằng cách cô lập kết quả tìm kiếm giữa các tác nhân AI, giúp tăng độ chính xác lên 82.6% trên BrowseComp-Plus, vượt xa phương pháp bỏ phiếu truyền thống.

Kim@kimmonismus
NgànhĐiểm AI 15/100

Người dùng bức xúc vì các mô hình của Anthropic quá dài dòng và kém hiệu quả

One of the most reliable posts. I wonder when Anthropic will finally address this problem. They m…

DịchCộng đồng đang tranh luận gay gắt về việc các mô hình của Anthropic dù giải quyết được nhiều bài toán khoa học phức tạp nhưng lại thiếu sự tối ưu, gây lãng phí thời gian và tài nguyên vì phản hồi quá dài dòng.

Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (43 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “tối ưu hóa” — Trang 6 | AIHOT.vn