25/08

Thứ Ba · 8 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

EXPL-FR: Giải mã mô hình nhận diện khuôn mặt thông qua sự kết hợp giữa thị giác và ngôn ngữ

EXPL-FR sử dụng bộ chuyển đổi nhẹ để liên kết mô hình ngôn ngữ thị giác với không gian nhúng của nhận diện khuôn mặt, cho phép giải thích các đặc điểm ngữ nghĩa mà mô hình dựa vào mà không cần huấn luyện lại.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 48/100

Task-CoEvolve: Tối ưu hóa Harness hiệu quả thông qua chọn lọc tác vụ thích ứng

Task-CoEvolve giới thiệu phương pháp tối ưu hóa harness cho LLM bằng cách cho phép các tác vụ kiểm chứng cùng tiến hóa, giúp giảm 80% chi phí đánh giá mà vẫn duy trì độ chính xác tương đương với bộ dữ liệu đầy đủ.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

RISE: Tối ưu hóa mô hình hành động thế giới thông qua cơ chế tưởng tượng thích ứng

RISE là khung làm việc mới giúp các mô hình hành động thế giới (WAMs) tự động quyết định thời điểm dừng hoặc tiếp tục mô phỏng tương lai, giúp cân bằng giữa hiệu quả tính toán và chất lượng lập kế hoạch trong lái xe tự hành.

AK@_akhaliq
Nghiên cứuĐiểm AI 30/100

Mô hình thế giới video: Cách suy luận trạng thái tiềm ẩn học về sự vận động của thế giới

Learning How the World Evolves Extrapolative Video World Models via Latent Dynamics Reasoning pape…

DịchNghiên cứu giới thiệu mô hình thế giới video dựa trên suy luận động lực học tiềm ẩn, cho phép dự đoán và ngoại suy sự thay đổi của thế giới thực một cách chính xác.

24/08

Thứ Hai · 3 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Hai mặt của sự khái quát hóa trong chưng cất mô hình ngôn ngữ lớn theo chính sách (On-policy Distillation)

Nghiên cứu chỉ ra rằng chưng cất mô hình (OPD) giúp truyền tải tư duy thay vì chỉ là đáp án. Hiệu quả phụ thuộc lớn vào mối quan hệ nguồn gốc giữa mô hình giáo viên và học sinh, thay vì độ khó của bài toán.

23/08

Chủ Nhật · 4 tin
DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 23/100

Điểm tin nghiên cứu AI tuần qua: Đột phá về kỹ năng và cơ chế 'quên' của AI Agent

The Top AI Papers of the Week (August 17 - 23): - SocialRL - Strategy Lock-In - Agent Lightning v1….

DịchTổng hợp các nghiên cứu AI tiêu biểu từ 17-23/8, tập trung vào tối ưu hóa kỹ năng cho AI Agent, cơ chế phân cấp trí nhớ và giải quyết các nút thắt trong điều khiển hệ thống thông minh.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 36/100

Stanford và CMU đột phá: Tự động trích xuất mô hình tác vụ từ video ghi màn hình

New Stanford + Carnegie paper. Screen recordings of real work look like free training data for agen…

DịchPhương pháp Task Model Induction mới giúp chuyển đổi video thao tác thực tế thành cấu trúc mục tiêu phân cấp thay vì chuỗi hành động đơn thuần, giúp AI học kỹ năng mới hiệu quả hơn 30%.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 42/100

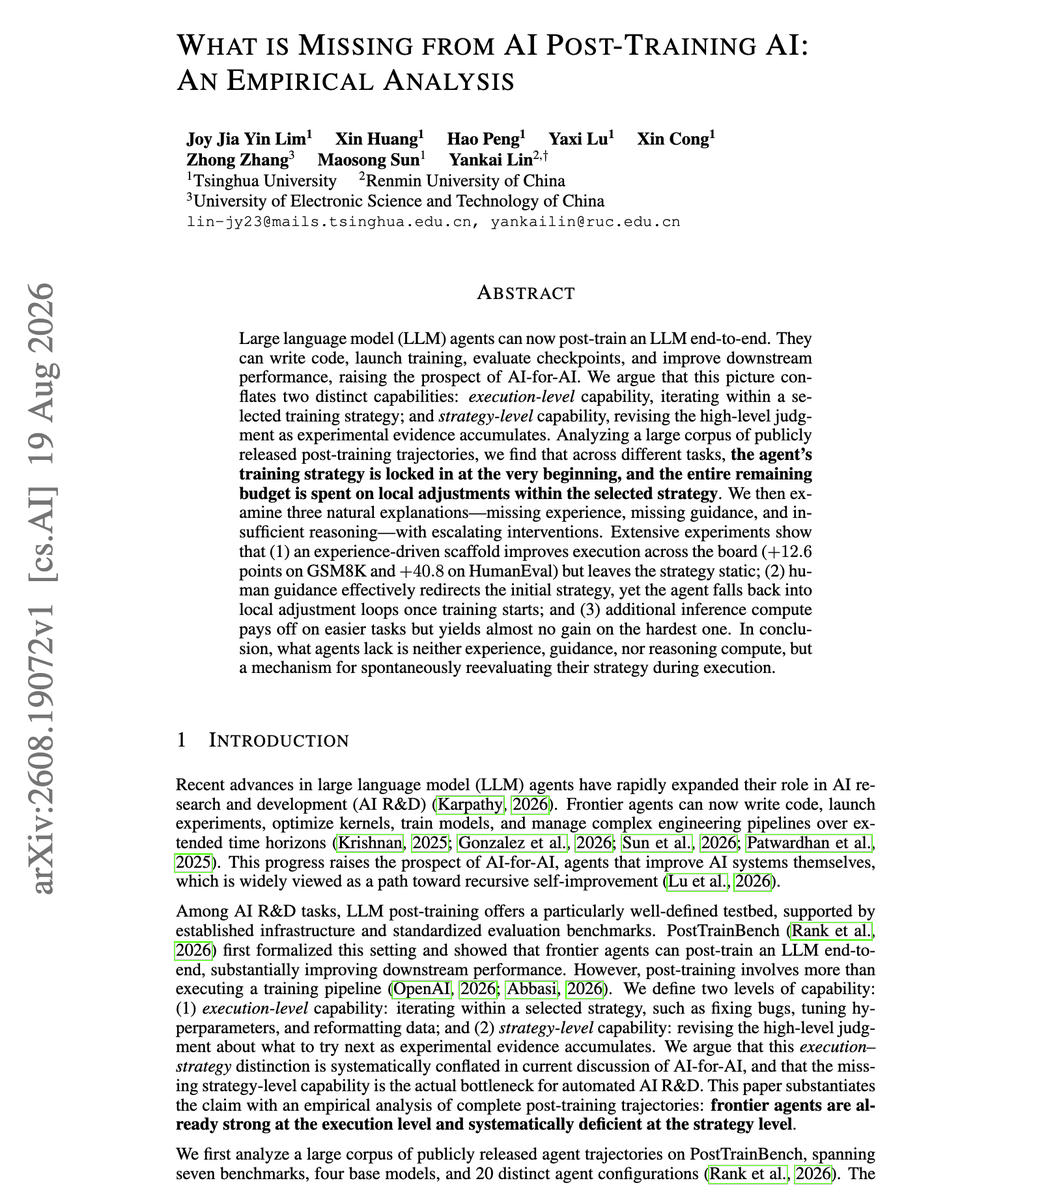
Tại sao các tác nhân AI tự huấn luyện lại dễ rơi vào bẫy tối ưu cục bộ?

Great paper if you are tracking progress in recursive self-improvement (RSI). (bookmark it) There …

DịchNghiên cứu mới chỉ ra rằng các tác nhân AI thường khóa chiến lược ngay từ bước đầu, dẫn đến việc lãng phí tài nguyên vào điều chỉnh nhỏ thay vì tự cải tiến đệ quy. Dù thử nghiệm nhiều phương pháp, AI vẫn thiếu khả năng tư duy lại chiến lược cốt lõi trong quá trình thực thi.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 30/100

Task Model Induction: Chuyển đổi video quay màn hình thành kỹ năng tự động hóa

This is one of the most effective ways to improve your agentic workflows. If you are building compu…

DịchTask Model Induction (TMI) trích xuất các mô hình tác vụ từ video quay màn hình và thao tác chuột/phím với độ chính xác cực cao, giúp tái tạo quy trình làm việc hiệu quả hơn 30% so với các phương pháp truyền thống.

22/08

Thứ Bảy · 1 tin
JiQiZhiXin
NgànhĐiểm AI 88/100

Tinh chọnĐối thoại cùng Vita Dynamics: Thách thức thực sự của AI hiện thân không nằm ở việc 'học', mà là khả năng 'kế thừa' giữa các thực thể

Vita Dynamics giới thiệu hệ thống 'Bộ gen hiện thân' (Embodied Genome), cho phép robot chia sẻ trí tuệ và kỹ năng giữa các hình thái cơ thể khác nhau, thay vì phải huấn luyện lại từ đầu cho mỗi thiết bị.


Vì sao đáng đọc: Bài viết đi sâu vào nút thắt kỹ thuật quan trọng nhất của ngành robot hiện nay: tính kế thừa đa nền tảng, thay vì chỉ dừng lại ở việc khoe mẽ phần cứng.

21/08

Thứ Sáu · 9 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 51/100

CoToGrasp: Đột phá trong tổng hợp thao tác linh hoạt nhờ học cấu trúc tiếp xúc

CoToGrasp là khung làm việc mới giúp robot thực hiện các thao tác cầm nắm linh hoạt và ổn định dựa trên cấu trúc tiếp xúc, cho phép huấn luyện độc lập với vật thể và đạt khả năng suy luận zero-shot trên các vật thể lạ mà không cần gắn nhãn dữ liệu tốn kém.

Google DeepMind@GoogleDeepMind
NgànhĐiểm AI 50/100

Google DeepMind hợp tác cùng Fenris khai phá tương lai của AI trong trò chơi điện tử

Games have been an important testbed for our AI research for over 15 years. 🎮 From mastering Atari…

DịchGoogle DeepMind bắt tay với Fenris Creations nhằm phát triển các hệ thống AI có khả năng học tập liên tục, ghi nhớ dài hạn và lập kế hoạch phức tạp, hướng tới việc tạo ra những trải nghiệm game đột phá và ứng dụng thực tiễn trong khoa học.

QbitAI
Mô hìnhĐiểm AI 92/100

Tinh chọnBước ngoặt GPT-3 cho robot: Chỉ cần xem 3 giây là học được kỹ năng mới

Công nghệ robot mới cho phép máy móc sao chép hành động chỉ sau 3 giây quan sát, đánh dấu bước tiến đột phá trong khả năng tự học của AI.


Vì sao đáng đọc: Tin tức mang tính đột phá về khả năng học tập của robot, có tiềm năng ứng dụng thực tiễn cao và thu hút sự quan tâm lớn từ cộng đồng công nghệ.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 92/100

Tinh chọnChain-of-Experience: Phương pháp giúp LLM tự cải thiện liên tục qua trải nghiệm thực tế

Nghiên cứu giới thiệu Chain-of-Experience (CoE), cho phép các mô hình ngôn ngữ lớn tự học hỏi và cải thiện hiệu suất thông qua phản hồi lặp lại từ chính mình hoặc môi trường, thay vì chỉ dựa vào suy luận một lần.


Vì sao đáng đọc: Đây là hướng tiếp cận đột phá giúp LLM vượt qua giới hạn zero-shot, có tính ứng dụng cao trong việc tối ưu hóa mô hình mà không cần huấn luyện lại.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 48/100

EXIMO: Tối ưu hóa robot VLA thông qua dẫn dắt khám phá bằng mô hình VLM

EXIMO là thuật toán ba giai đoạn giúp tinh chỉnh mô hình VLA hiệu quả bằng cách sử dụng VLM để lập kế hoạch, phân rã nhiệm vụ và tối ưu hóa thông qua học tăng cường, giúp robot đạt hiệu suất vượt trội với ít dữ liệu hơn.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 56/100

EnvHarness: Giải pháp lập trình giúp 'thổi hồn' vào các môi trường huấn luyện AI tĩnh

EnvHarness giới thiệu lớp plugin lập trình giúp tùy biến hành vi môi trường mà không cần can thiệp logic gốc, kết hợp cùng EnvRigger để tự động tối ưu hóa chiến lược của AI. Giải pháp này giúp cải thiện hiệu suất huấn luyện đáng kể trên nhiều lĩnh vực khác nhau.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 53/100

SPK: Khung phát hiện dữ liệu ngoài phân phối (OoD) có khả năng giải thích cho bài toán phát hiện vật thể thời gian thực

SPK giải quyết vấn đề ảo giác trong phát hiện vật thể bằng cách khai thác tri thức tiên nghiệm về cấu trúc và ngữ cảnh, tạo ra biểu diễn 5 chiều giúp nhận diện chính xác các dữ liệu ngoài phân phối (OoD).

20/08

Thứ Năm · 6 tin
Jim Fan@DrJimFan
Hướng dẫnĐiểm AI 47/100

Jim Fan phân tích GEN-1.5: Tại sao dữ liệu lặp lại và UMI là chìa khóa thành công

Seeing a hype wave around GEN-1.5, and rightfully so. Lots of respect to Pete & Andy for executing s…

DịchJim Fan nhận định sự thành công của GEN-1.5 đến từ việc mô phỏng các hành động lặp lại tự nhiên của con người. Ông nhấn mạnh phương pháp UMI giúp lưu giữ trực giác vật lý tốt hơn so với điều khiển từ xa truyền thống.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnAdaPop: Phương pháp 'quên' thông tin hiệu quả cho LLM dựa trên độ phổ biến của dữ liệu

AdaPop tối ưu hóa quá trình xóa dữ liệu trong LLM bằng cách điều chỉnh áp lực học tập dựa trên độ phổ biến của thông tin, giúp ngăn chặn rò rỉ dữ liệu tốt hơn gấp 5 lần so với các phương pháp truyền thống.


Vì sao đáng đọc: Giải quyết vấn đề thực tế và cấp thiết trong an toàn AI (machine unlearning) với phương pháp tiếp cận thông minh, có số liệu kiểm chứng rõ ràng.
JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnĐại học Bắc Kinh và Microsoft Research giới thiệu BCP: Để AI tự quyết định thời điểm tái lập kế hoạch

Nhóm nghiên cứu đề xuất BCP, cho phép mô hình VLA tự quyết định việc tiếp tục thực hiện hay tái lập kế hoạch thay vì dùng tham số cố định, giúp tăng đáng kể độ chính xác cho các tác vụ robot phức tạp.


Vì sao đáng đọc: Nghiên cứu giải quyết vấn đề cốt lõi trong điều khiển robot (VLA), cải thiện hiệu suất thực tế đáng kể bằng phương pháp sáng tạo, có tính ứng dụng cao trong lĩnh vực robotics.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 92/100

Tinh chọnZetta: Hệ thống điều khiển vòng lặp kín giúp robot tự tiến hóa trí tuệ vật lý

Zetta là khung làm việc đột phá cho phép robot tự cập nhật kỹ năng và đánh giá hành vi theo thời gian thực mà không cần thay đổi mô hình gốc, giúp giải quyết hạn chế của các hệ thống điều khiển vòng lặp hở hiện nay.


Vì sao đáng đọc: Đây là bước tiến quan trọng trong lĩnh vực robot học (embodied AI), giải quyết bài toán khó về khả năng phản ứng tức thời và tự học của robot trong môi trường thực tế.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 53/100

C3LM: Mô hình ngôn ngữ lớn tối ưu hóa phản ứng tổng hợp ngược trong hóa học

Nghiên cứu giới thiệu mô hình C3LM được huấn luyện trên tập dữ liệu khổng lồ 45,6 triệu phản ứng, sử dụng kỹ thuật Top-K để dự đoán các phản ứng hóa học chính xác và đa dạng hơn.

19/08

Thứ Tư · 5 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

CardioState-JEPA: Mô hình nền tảng học biểu diễn tim mạch đa phương thức với khả năng xử lý độ trễ

CardioState-JEPA là mô hình nền tảng đầu tiên hợp nhất dữ liệu ECG, PPG và PCG vào một không gian biểu diễn chung, sử dụng cơ chế căn chỉnh độ trễ để khai thác bản chất sinh lý học thay vì chỉ dựa vào hình dạng sóng tín hiệu.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 51/100

Agentic ESOpt: Đột phá tinh chỉnh tác nhân LLM với chi phí GPU cực thấp

Agentic ESOpt là khung tinh chỉnh toàn tham số dựa trên chiến lược tiến hóa, cho phép tối ưu hóa các tác nhân LLM mà chỉ cần bộ nhớ GPU ở mức suy luận, vượt trội hơn hẳn các phương pháp học tăng cường truyền thống.

Apple Machine Learning Research
Nghiên cứuĐiểm AI 43/100

Apple giới thiệu phương pháp Newton bán trơn giúp tăng tốc tính toán Optimal Transport

Nhóm nghiên cứu của Apple phát triển phương pháp Newton bán trơn chuyên dụng, giúp tối ưu hóa tốc độ tính toán cho các ước lượng Optimal Transport dựa trên nhân, thay thế hiệu quả cho phương pháp nội điểm truyền thống vốn tiêu tốn nhiều tài nguyên.

Elvis Saravia@omarsar0
Hướng dẫnĐiểm AI 14/100

Kỷ nguyên vàng của nghiên cứu khoa học nhờ AI Agent

So true! There are so many ways to do research with the help of AI agents. So many research question…

DịchElvis Saravia nhận định đây là thời điểm lý tưởng nhất để nghiên cứu học máy, khi các AI Agent giúp tối ưu hóa việc thử nghiệm và tích lũy tri thức. Sự bùng nổ về công cụ và năng lực tính toán đang mở ra cơ hội chưa từng có cho giới nghiên cứu.

18/08

Thứ Ba · 6 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 52/100

StreamOPD: Giải pháp hậu huấn luyện tối ưu hóa hiểu video trực tuyến với cơ chế cổng tín hiệu không gian-thời gian

StreamOPD giới thiệu phương pháp hậu huấn luyện không cần bộ nhớ suy luận, giúp cải thiện đáng kể hiệu suất hiểu video trên các bộ dữ liệu chuẩn, tiệm cận kết quả của các mô hình lớn hơn.

JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnRobot cũng có 'khoảnh khắc bừng tỉnh': Zetta ζ đột phá khả năng tự học trong môi trường vật lý

Zetta ζ từ Đại học Thanh Hoa giúp robot không chỉ thực hiện nhiệm vụ mà còn tự quan sát, sửa lỗi và tích lũy kinh nghiệm theo thời gian thực, đạt tỷ lệ thành công vượt trội trong các thử nghiệm phức tạp.


Vì sao đáng đọc: Đột phá quan trọng trong lĩnh vực robot học (Embodied AI), giải quyết bài toán khó về khả năng tự học trực tuyến và thích nghi với môi trường thực tế thay vì chỉ chạy theo kịch bản sẵn.
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 46/100

Nghiên cứu mới: AI Agent thực chất chỉ đang 'bắt chước' thay vì học hỏi từ kinh nghiệm

Researchers found our current approach to making AI smarter over time has a giant blind spot. AI is…

DịchNghiên cứu chỉ ra rằng các AI Agent không thực sự hiểu các quy tắc trừu tượng mà chỉ dựa vào việc sao chép lịch sử hoạt động. Khi dữ liệu lịch sử bị can thiệp, hiệu suất AI giảm mạnh, trong khi việc xóa bỏ các quy tắc tổng quát lại không gây ảnh hưởng, đặt ra dấu hỏi lớn về cơ chế bộ nhớ hiện nay.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

UI-Mate: Bước tiến mới cho các tác nhân GUI mã nguồn mở với khả năng học từ minh họa ngữ cảnh

UI-Mate là tác nhân GUI nền tảng giúp tự động hóa các tác vụ kỹ thuật số phức tạp thông qua quy trình huấn luyện khép kín và khả năng học hỏi từ các minh họa thực tế, giúp giải quyết vấn đề thiếu hụt dữ liệu và tính thiếu ổn định trong thực thi.

17/08

Thứ Hai · 5 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

UNMASK: Tự động phát hiện và kiểm chứng các 'lối tắt' sai lệch trong mô hình phân loại văn bản

UNMASK là quy trình tự động giúp phát hiện và loại bỏ các mối tương quan giả tạo mà mô hình ngôn ngữ thường lợi dụng để gian lận điểm số, giúp tăng cường độ tin cậy của mô hình trên dữ liệu thực tế mà không cần con người can thiệp.

Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (41 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Học máy” — Trang 5 | AIHOT.vn