26/08

Thứ Tư · 49 tin
MiniMax@MiniMax_AI
Hướng dẫnĐiểm AI 20/100

MiniMax-M3: Đột phá hiệu suất với chi phí thực thi tác vụ AI cực thấp

Love seeing real-world agent benchmarks like this 👇 MiniMax-M3: $0.018 to spin up an inbox, write …

DịchMiniMax-M3 thiết lập chuẩn mực mới cho AI agent khi hoàn thành tác vụ gửi email chuyên nghiệp chỉ với 0,018 USD, khẳng định vị thế là mô hình hiệu quả nhất về chi phí trên thị trường hiện nay.


DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 47/100

Điểm chuẩn AI không đáng tin: Thay đổi cấu hình nhỏ khiến thứ hạng mô hình đảo lộn

// There Is No Neutral Harness // Great work discussing some of the issues in harness evaluation. …

DịchNghiên cứu chỉ ra rằng chỉ cần thay đổi thứ tự đáp án hoặc cách diễn đạt câu lệnh, điểm số của các mô hình AI có thể dao động cực lớn, khiến bảng xếp hạng hiện nay trở nên thiếu khách quan.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 44/100

Đánh giá AI không hề khách quan: Điểm số một mô hình có thể dao động từ 31% đến 89%

Great paper on agent harnesses.

DịchNghiên cứu mới chỉ ra rằng cách thiết lập bộ khung đánh giá ảnh hưởng cực lớn đến kết quả của AI. Chỉ cần thay đổi thứ tự đáp án hay cách đặt câu hỏi, thứ hạng của các mô hình có thể bị đảo lộn hoàn toàn, cho thấy các bài kiểm tra hiện nay còn nhiều lỗ hổng.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 36/100

Báo cáo kỹ thuật Prime Agent: Giải mã cơ chế phân tầng bộ nhớ đột phá

Prime Agent, the harness that put Opus 5 at 95.5% on ARC-AGI-3, now has a technical report. The mec…

DịchPrime Agent giới thiệu cơ chế phân tầng bộ nhớ giúp tối ưu hóa khả năng xử lý của AI thông qua việc quản lý dữ liệu trên nhiều lớp, từ ngữ cảnh hoạt động đến lưu trữ ổ đĩa, giúp chuyển đổi các tác vụ ngữ cảnh dài thành bài toán quản trị thông tin hiệu quả.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

AstroPT: Dùng thiên văn học để giải mã cách AI học tập và tư duy

Nghiên cứu sử dụng AstroPT, một mô hình transformer huấn luyện trên dữ liệu thiên hà, làm thước đo để hiểu cách các khái niệm hình thành trong LLM. Kết quả cho thấy AI học các đặc tính từ đơn giản đến phức tạp theo trình tự cố định, giúp làm rõ cơ chế nội tại của các mô hình ngôn ngữ lớn.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 35/100

Đánh giá AI Agent trên dòng lệnh: Cấu trúc hỗ trợ quan trọng hơn cả mô hình

The harness around a model decided more of the benchmark score than the model itself. So treat scaff…

DịchNghiên cứu chỉ ra rằng trong môi trường dòng lệnh, hệ thống hỗ trợ (scaffold) ảnh hưởng đến hiệu suất AI Agent nhiều hơn chính mô hình ngôn ngữ. Việc nâng cấp mô hình trong cùng một hệ thống thường chỉ làm tăng độ trễ thay vì cải thiện khả năng giải quyết tác vụ.

25/08

Thứ Ba · 38 tin
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Mô hìnhĐiểm AI 39/100

Qwen 3.8-Flash-Next sắp ra mắt: Mô hình 125B đầy hứa hẹn

Alibaba chuẩn bị trình làng Qwen 3.8-Flash-Next với quy mô 125B tham số. Trang thông tin của mô hình đã xuất hiện trên ModelScope và đang thu hút sự chú ý lớn từ cộng đồng công nghệ quốc tế.

Thêm 1 nguồn khác đưa tinX: Qwen (@Alibaba_Qwen)
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 53/100

Định luật phân bổ ngữ cảnh trong tìm kiếm tạo sinh: Đo lường nhân quả và điều phối vòng lặp

Nghiên cứu mới chỉ ra rằng việc mở rộng cửa sổ ngữ cảnh không hiệu quả do suy giảm tương quan. Thay vào đó, phương pháp phân bổ lặp lại theo trình tự giúp tăng tỷ lệ thu hồi lên tới 20.5%, tối ưu hóa hiệu suất cho các hệ thống RAG.

Apple: Newsroom
Sản phẩmĐiểm AI 64/100

Tinh chọnApple ra mắt Mac Studio mới với chip M5 Max và M5 Ultra, tối ưu mạnh mẽ cho AI

Apple trình làng Mac Studio mới trang bị chip M5 Max và M5 Ultra, mang lại hiệu năng AI tăng 4,3 lần và khả năng chạy các mô hình ngôn ngữ lớn (LLM) trực tiếp trên thiết bị với bộ nhớ thống nhất lên đến 512GB.

Diễn biến sự kiện · 4 bài →Thêm 1 nguồn khác đưa tinIT Home

Vì sao đáng đọc: Đây là bước tiến quan trọng về phần cứng cho AI của Apple, đặc biệt là khả năng xử lý LLM cục bộ, thu hút sự quan tâm lớn từ cộng đồng công nghệ và người dùng chuyên nghiệp.
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 36/100

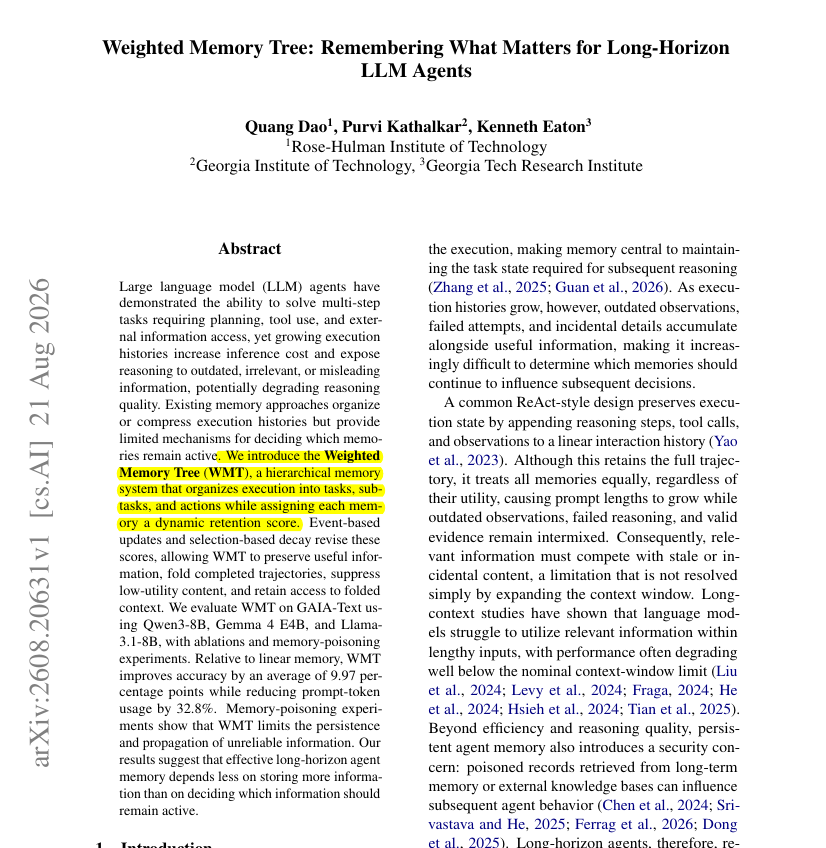
Weighted Memory Tree: Giải pháp tối ưu hóa suy luận cho AI Agent trong các tác vụ dài

Giving an agent a memory hierarchy is not what makes it reason better over long tasks. What helps is…

DịchNghiên cứu giới thiệu Weighted Memory Tree, phương pháp gán trọng số và giảm dần độ ưu tiên cho các ký ức thay vì xếp chồng dữ liệu, giúp AI Agent cải thiện độ chính xác và tiết kiệm chi phí token khi xử lý các tác vụ phức tạp.

Kim@kimmonismus
Mô hìnhĐiểm AI 41/100

Cùng sự kiệnAlibaba sắp mở mã nguồn Qwen3.8-Flash-Next, hé lộ kiến trúc cho thế hệ Qwen4

Our first glimpse of Qwen4 is here! Alibaba is about to release Qwen3.8-Flash-Next, an open-weight …

DịchAlibaba chuẩn bị ra mắt Qwen3.8-Flash-Next, mô hình đa phương thức MoE sử dụng kiến trúc thế hệ mới làm nền tảng cho dòng Qwen4 sắp tới, cho phép cộng đồng trải nghiệm sớm các cải tiến kỹ thuật.

Cùng sự kiện, bài đại diện «Alibaba sắp tung ra Qwen3.8-Flash-Next: Mô hình đa phương thức MoE dựa trên kiến trúc Qwen4»
Kim@kimmonismus
Hướng dẫnĐiểm AI 36/100

Qwen3.8-27B lọt Top 10 bảng xếp hạng WebDev, tái định nghĩa hiệu năng mô hình cỡ trung

Local models are getting ridiculously good. Qwen3.8-27B just entered the top 10 in Arena's WebDev be…

DịchMô hình Qwen3.8-27B đạt vị trí thứ 9 trên Code Arena (WebDev) với 1595 điểm, trở thành mô hình duy nhất cùng kích thước lọt top 10. Với khả năng chạy cục bộ mạnh mẽ, đây là bước tiến lớn cho các mô hình mã nguồn mở tiệm cận trình độ tiên phong.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 45/100

Industrial-Instruction: Khung làm việc end-to-end tối ưu LLM cho tài liệu kỹ thuật công nghiệp

Industrial-Instruction sử dụng 906 tài liệu kỹ thuật từ Panasonic để tạo bộ dữ liệu QA, giúp cải thiện đáng kể độ chính xác của các mô hình LLM dưới 10B tham số trong việc truy xuất thông tin chuyên ngành.

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Mô hìnhĐiểm AI 61/100

Thomson Reuters ra mắt mô hình ngôn ngữ lớn tự phát triển 'Thomson'

Thomson Reuters vừa giới thiệu mô hình AI tự phát triển với chi phí tối ưu, đạt hiệu suất ngang ngửa các mô hình hàng đầu trong việc xử lý dữ liệu chuyên sâu. Hãng cũng đã phát hành phiên bản 'small' trên Hugging Face cho mục đích nghiên cứu.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 46/100

Vượt qua giới hạn ổn định: ERPO - Phương pháp chính quy hóa môi trường tối ưu hóa chiến lược LLM

Nghiên cứu giới thiệu ERPO, phương pháp chuyển chính quy hóa từ hành động sang đầu vào giúp cân bằng giữa tính ổn định và khả năng khám phá của LLM. ERPO cải thiện đáng kể độ chính xác trong suy luận toán học mà không làm tăng chi phí tính toán.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 72/100

Tinh chọnChỉ một trang web độc hại cũng đủ thao túng gợi ý của LLM: Nghiên cứu về lỗ hổng của hệ thống RAG

Nghiên cứu mới với bộ tiêu chuẩn FORGE chỉ ra rằng các mô hình LLM trong hệ thống gợi ý rất dễ bị thao túng bởi nội dung rác, khiến chúng vô tình quảng bá sản phẩm giả mạo chỉ với một trang web bị nhiễm độc.


Vì sao đáng đọc: Nghiên cứu thực tế, đánh giá lỗ hổng bảo mật quan trọng trong các ứng dụng RAG thực tế, có tính ứng dụng cao cho các nhà phát triển hệ thống gợi ý.
X.PIN@thexpin
Mô hìnhĐiểm AI 54/100

Thomson Reuters ra mắt mô hình ngôn ngữ lớn Thomson, phát triển dựa trên Qwen3.5-397B

Thomson Reuters has launched Thomson, its first LLM - built on Alibaba's Qwen3.5-397B. Total R&D: ~$…

DịchThomson Reuters vừa giới thiệu mô hình ngôn ngữ lớn đầu tiên mang tên Thomson, được tinh chỉnh từ Qwen3.5-397B với chi phí 40 triệu USD. Mô hình này tập trung vào độ an toàn, tính trung lập và đạt hiệu suất ấn tượng trong các bài kiểm tra chuyên môn về luật.

Thêm 1 nguồn khác đưa tinHacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 52/100

MobilePA-Bench: Bộ tiêu chuẩn đánh giá tác nhân AI trên thiết bị di động với các tác vụ thực tế phức tạp

MobilePA-Bench là bộ tiêu chuẩn tương tác mới giúp đánh giá khả năng lập kế hoạch và sử dụng công cụ của các tác nhân AI trên di động thông qua 212 công cụ thực tế. Kết quả cho thấy các mô hình ngôn ngữ lớn hiện nay vẫn gặp khó khăn khi xử lý các ràng buộc phức tạp và lỗi vận hành.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 35/100

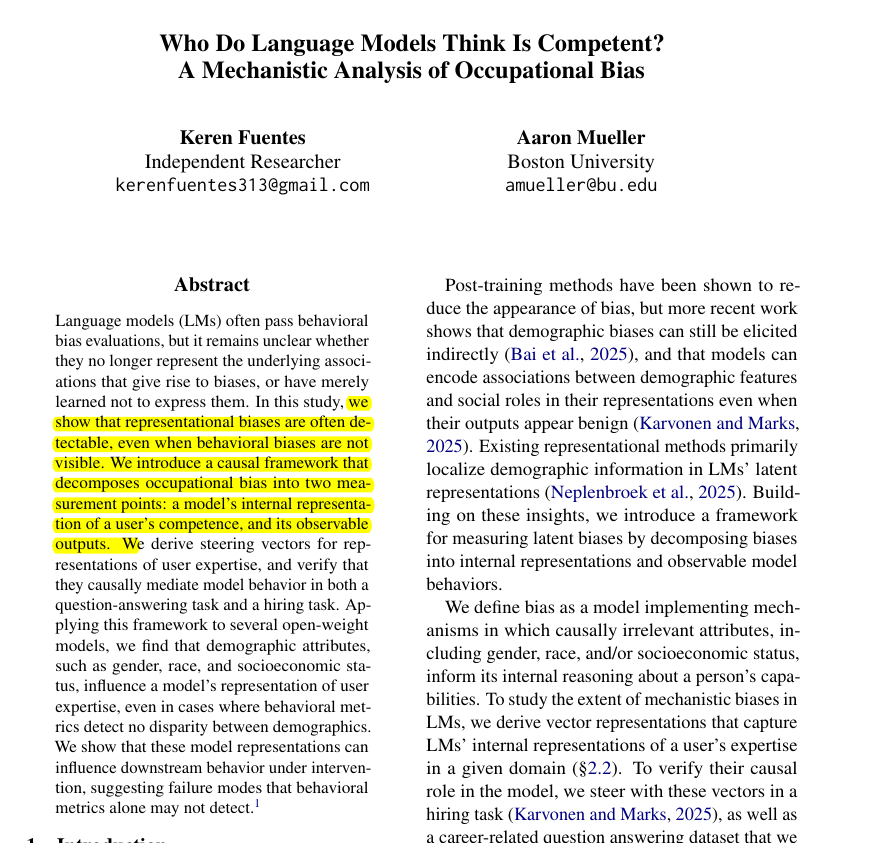
Cách mô hình ngôn ngữ đánh giá năng lực người dùng và định kiến nghề nghiệp

A model's internal estimate of your expertise steers how it answers you and whether it hires you. L…

DịchNghiên cứu chỉ ra rằng mô hình ngôn ngữ tự ước tính năng lực người dùng để điều chỉnh độ phức tạp của câu trả lời. Dù tồn tại các vector định kiến, nghiên cứu chưa tìm thấy bằng chứng rõ ràng về việc chúng gây ra phân biệt đối xử trong đầu ra.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 48/100

Task-CoEvolve: Tối ưu hóa Harness hiệu quả thông qua chọn lọc tác vụ thích ứng

Task-CoEvolve giới thiệu phương pháp tối ưu hóa harness cho LLM bằng cách cho phép các tác vụ kiểm chứng cùng tiến hóa, giúp giảm 80% chi phí đánh giá mà vẫn duy trì độ chính xác tương đương với bộ dữ liệu đầy đủ.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 42/100

Chỉ huấn luyện lớp chiếu: Mở rộng đa phương thức cho LLM mà không làm mất khả năng vốn có

You can teach a language model a new modality without ever touching the backbone's weights. Train …

DịchNghiên cứu mới đề xuất phương pháp chỉ huấn luyện lớp kết nối giữa encoder và mô hình ngôn ngữ, giúp bổ sung đa phương thức mà không cần tinh chỉnh toàn bộ tham số, vừa tăng tốc độ huấn luyện vừa bảo toàn hiệu suất gốc của mô hình.

Qwen@Alibaba_Qwen
Hướng dẫnĐiểm AI 32/100

Qwen khẳng định vị thế: Mô hình mã nguồn mở Trung Quốc trở thành lựa chọn ưu tiên trong nghiên cứu

Open models, open science. Qwen keeps growing steadily, and we'll always be right here with the rese…

DịchPhân tích từ 500.000 bài báo trên arXiv cho thấy các mô hình mã nguồn mở Trung Quốc đang chiếm ưu thế, với Qwen xuất hiện trong 1/3 số bài nghiên cứu có nhắc đến LLM, vượt xa sự sụt giảm của Llama.

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 49/100

Cảnh báo: Mô hình ngôn ngữ lớn (LLM) có thể chiếm quyền điều khiển máy chủ qua lỗ hổng suy luận

Các mô hình AI độc hại có thể khai thác lỗ hổng trong các công cụ suy luận như vLLM để thực thi mã tùy ý trên máy chủ. Việc phổ biến các mô hình mã nguồn mở đang làm gia tăng đáng kể rủi ro bảo mật này.

Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (65 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “llm” — Trang 22 | AIHOT.vn