27/08

Thứ Năm · 32 tin
LangChain: Blog
Nghiên cứuĐiểm AI 43/100

Đánh giá OpenWiki với WikiBench: Liệu tài liệu Wiki có giúp AI lập trình thông minh hơn?

LangChain giới thiệu WikiBench để kiểm chứng hiệu quả của tài liệu Wiki đối với các tác nhân AI lập trình. Kết quả cho thấy việc kết hợp Wiki với mã nguồn giúp cải thiện hiệu suất đáng kể và tối ưu chi phí so với chỉ sử dụng mã nguồn đơn thuần.

JiQiZhiXin
Mô hìnhĐiểm AI 92/100

Tinh chọnHọc tập truyền cảm hứng: Chuyển đổi nhận thức của AI từ ngoại vi sang nội sinh

Thay vì phụ thuộc vào các khung công cụ bên ngoài, phương pháp 'Inspirational Learning' giúp AI tự học hỏi từ kinh nghiệm cũ, áp dụng tư duy tương tự để giải quyết vấn đề mới một cách thông minh và tự chủ hơn.


Vì sao đáng đọc: Bài viết đề xuất hướng đi đột phá trong việc tối ưu hóa suy luận của LLM, chuyển từ việc dựa dẫm vào công cụ sang tự nội sinh hóa tri thức, rất có giá trị cho giới nghiên cứu AI.
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 60/100

Cùng sự kiệnĐánh giá GLM-5.3-Flash: Hiệu năng vượt trội và chi phí tối ưu

GLM-5.3-Flash đạt 57 điểm trên Artificial Analysis, vượt xa mức trung bình 18 của các mô hình cùng phân khúc. Với cửa sổ ngữ cảnh 400k tokens và khả năng xử lý đa phương thức, đây là lựa chọn đáng chú ý về hiệu năng và giá thành.

Cùng sự kiện, tinh chọn hiển thị «Zhipu ra mắt GLM-5.3-Flash: Mô hình đa phương thức mạnh mẽ với chi phí cực thấp»
Elvis Saravia@omarsar0
Mô hìnhĐiểm AI 46/100

Cùng sự kiệnGLM-5.3-Flash ra mắt: Hỗ trợ 1M token, mã nguồn mở MIT và tối ưu cho chip nội địa

Want to test how good GLM-5.3-Flash is? I have been finding it useful for visual explainers using /…

DịchZhipu AI vừa trình làng GLM-5.3-Flash với 320B tham số, hỗ trợ cửa sổ ngữ cảnh 1 triệu token và đa phương thức nguyên bản. Mô hình này được cấp phép theo chuẩn MIT, chạy hoàn toàn trên chip AI nội địa và đã sẵn sàng để trải nghiệm qua API.

Cùng sự kiện, bài đại diện «GLM-5.3-Flash: Bước đột phá khi vận hành 100T token mỗi ngày trên chip nội địa Trung Quốc»

26/08

Thứ Tư · 49 tin
Testing Catalog@testingcatalog
Hướng dẫnĐiểm AI 34/100

Glean phân tích hiệu quả chi phí của 37 mô hình AI trong tác vụ doanh nghiệp

Glean has published a Pareto frontier analysis of 37 models and reasoning configurations across 1, 00…

DịchGlean đã đánh giá 37 mô hình AI qua 1.000 tác vụ doanh nghiệp, phát hiện sự chênh lệch chi phí lên tới 36 lần nhưng chất lượng chỉ cải thiện 22%, giúp doanh nghiệp tối ưu hóa lựa chọn mô hình.

Qwen@Alibaba_Qwen
Mô hìnhĐiểm AI 49/100

Mô hình Qwen3.8-Flash 125B: Chạy mượt mà trên máy tính cá nhân với 75GB RAM

A high-performance 125B model now running locally on just 75GB RAM! Thank you @UnslothAI for the day…

DịchNhờ sự hỗ trợ từ UnslothAI, mô hình mạnh mẽ 125B của Alibaba giờ đây đã có thể vận hành cục bộ chỉ với 75GB RAM, mở ra khả năng tiếp cận AI hiệu năng cao cho người dùng cá nhân.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

SecOPD: Chống tấn công Prompt Injection bằng phương pháp chưng cất chính sách (On-Policy Distillation)

SecOPD giải quyết lỗ hổng Prompt Injection bằng cách cung cấp phản hồi ở cấp độ token thay vì toàn bộ chuỗi, giúp mô hình LLM nhận diện và từ chối các lệnh độc hại chính xác hơn so với các phương pháp tinh chỉnh truyền thống.

Ant Ling@AntLingAGI
Hướng dẫnĐiểm AI 42/100

Ant Group ra mắt Ling-3.0-tiny: Mô hình AI tối ưu cho thiết bị di động

According to Artificial Analysis, Ling-3.0-tiny sits on the mobile intelligence-speed Pareto frontie…

DịchTheo Artificial Analysis, Ling-3.0-tiny thiết lập chuẩn mực mới về tốc độ trên iPhone 17 Pro với khả năng xử lý 16K ngữ cảnh trong 5,7 giây và dẫn đầu bảng xếp hạng 64K, mang sức mạnh AI vượt trội lên các thiết bị nhỏ gọn.

Kim@kimmonismus
Mô hìnhĐiểm AI 55/100

Qwen3.8-Flash-Next và GLM-5.3-Flash ra mắt: Mô hình mã nguồn mở tiệm cận đẳng cấp dẫn đầu

Today is a huge day for open-weight and local AI. Qwen3.8-Flash-Next is a 125B MoE with another 51B…

DịchHai mô hình mới Qwen3.8-Flash-Next và GLM-5.3-Flash vừa trình làng với hiệu suất vượt trội, thách thức các đối thủ hàng đầu như Claude Opus. Cả hai đều hỗ trợ đa phương thức, cửa sổ ngữ cảnh 1M và giấy phép MIT, hứa hẹn thay đổi cuộc chơi cho cộng đồng mã nguồn mở.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 42/100

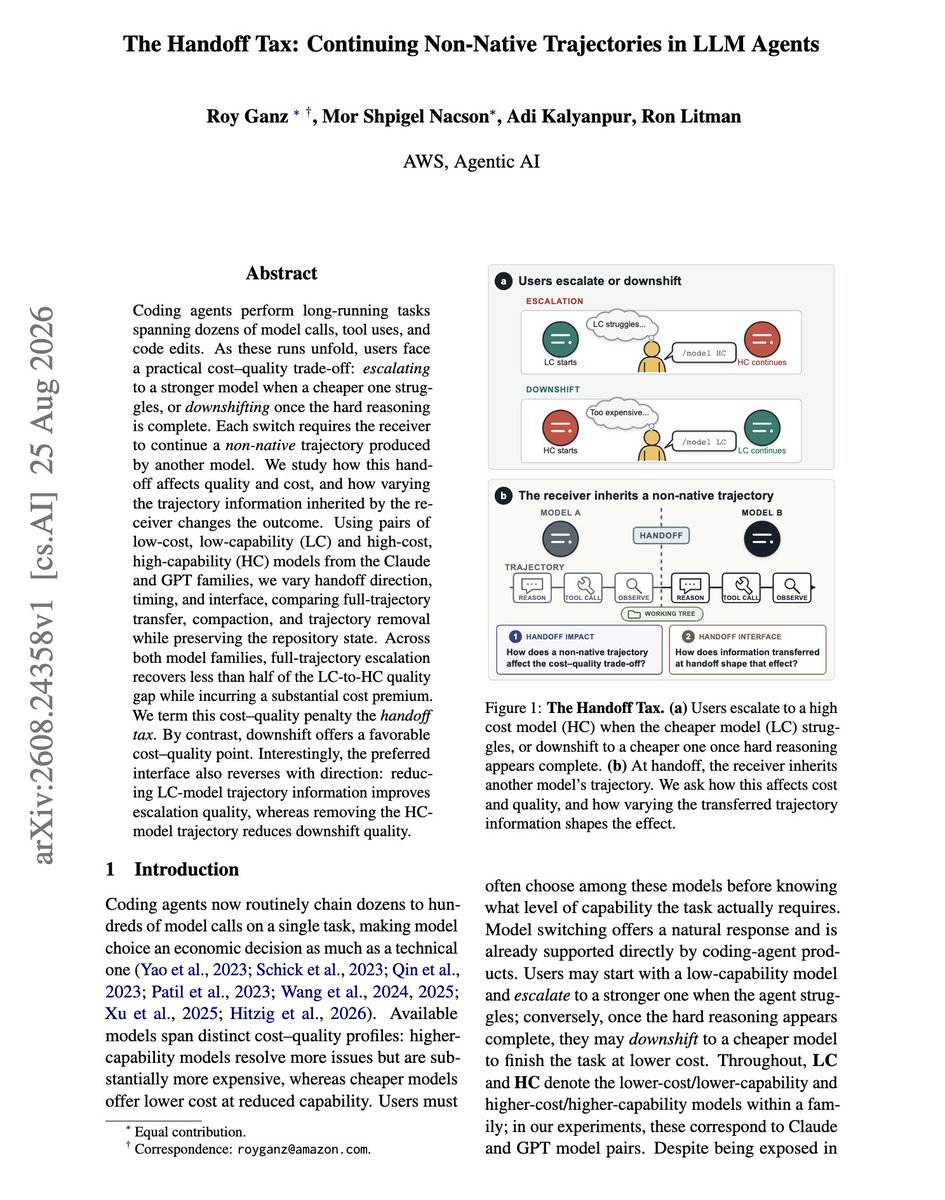
Nghiên cứu mới từ AWS: Định lượng 'thuế chuyển giao' khi điều phối các mô hình AI

Great new paper from AWS on agent handoff tax. If you build agents today, you need to understand th…

DịchAWS AI Labs giới thiệu khái niệm 'thuế chuyển giao', chỉ ra rằng việc nâng cấp từ mô hình yếu lên mạnh trong quá trình xử lý không bù đắp được hiệu suất như kỳ vọng nhưng lại tốn kém chi phí. Ngược lại, chiến lược hạ cấp mô hình mang lại sự cân bằng tối ưu hơn giữa chất lượng và chi phí.

Rohan Paul@rohanpaul_ai
Mô hìnhĐiểm AI 49/100

Cùng sự kiệnZ.ai xác nhận mô hình bí ẩn Ox Alpha thực chất là GLM-5.3-Flash

Finally, Z.ai revealed that Ox Alpha was actually GLM-5.3-Flash. So that means over the last few d…

DịchZ.ai tiết lộ Ox Alpha chính là GLM-5.3-Flash, vận hành nhờ hàng chục nghìn chip AI nội địa thay vì cụm GPU NVIDIA, xử lý lưu lượng 100 nghìn tỷ token mỗi ngày.

Cùng sự kiện, bài đại diện «Zhipu AI xác nhận mô hình 'Niu Lai' chính là GLM-5.3-Flash, vận hành trên 100.000 chip nội địa»
Elvis Saravia@omarsar0
Mô hìnhĐiểm AI 49/100

Cùng sự kiệnQwen3.8-Flash: Mô hình MoE đa phương thức hiệu năng cao, hé lộ kiến trúc Qwen4

What's better than an open-weight multimodal model release? Well, the technical report. I just love…

DịchAlibaba ra mắt Qwen3.8-Flash, mô hình MoE đa phương thức với 125B tham số (kích hoạt 6B mỗi token), hỗ trợ ngữ cảnh lên tới 1 triệu token và là phiên bản xem trước của kiến trúc Qwen4.

Cùng sự kiện, bài đại diện «Qwen3.8-Flash-Next chính thức được hỗ trợ trên SGLang ngay từ ngày ra mắt»
AI Notes@AYi_AInotes
Mô hìnhĐiểm AI 54/100

Mô hình ẩn danh 'Ox Alpha' gây bão trên OpenRouter chính thức được Zhipu công bố mã nguồn mở

Mô hình Ox Alpha với hiệu suất vượt trội và chi phí thấp đã được xác nhận là sản phẩm của Zhipu. Zhipu sẽ mở mã nguồn mô hình này ngay trong tối nay, hỗ trợ cửa sổ ngữ cảnh 1M, đa phương thức và khả năng lập trình ấn tượng.

Thêm 1 nguồn khác đưa tinTechNode
ByteByteGo
Hướng dẫnĐiểm AI 47/100

Tăng tốc LLM gấp 3 lần: Giải mã cơ chế Speculative Decoding

Speculative Decoding giúp tăng tốc độ tạo văn bản gấp 2-3 lần bằng cách dùng mô hình nhỏ dự đoán trước các token, sau đó để mô hình lớn xác thực song song. Phương pháp này tận dụng hiệu quả tài nguyên GPU nhàn rỗi mà vẫn đảm bảo độ chính xác tuyệt đối như mô hình gốc.

Kim@kimmonismus
Mô hìnhĐiểm AI 71/100

Cùng sự kiệnRa mắt GLM-5.3 Flash: Mô hình MoE 320B với hiệu suất vượt trội, chỉ kích hoạt 18B tham số

GLM-5.3 Flash ("Ox Alpha") official: Benchmarks attached. This looks exceptional for its size! GLM-…

DịchGLM-5.3 Flash (Ox Alpha) chính thức trình làng với kiến trúc MoE 320B, hỗ trợ cửa sổ ngữ cảnh 1M và khả năng đa phương thức nguyên bản. Mô hình được cấp phép MIT, tối ưu hóa mạnh mẽ với chỉ 18B tham số được kích hoạt mỗi token.

Cùng sự kiện, tinh chọn hiển thị «Zhipu ra mắt GLM-5.3-Flash: Mô hình đa phương thức mạnh mẽ với chi phí cực thấp»
AI Notes@AYi_AInotes
Mô hìnhĐiểm AI 49/100

Cùng sự kiệnAlibaba ra mắt Qwen3.8-Flash: Bước đệm cho kiến trúc Qwen4 với hiệu suất vượt trội

Qwen3.8-Flash chính thức lộ diện với kiến trúc tiền nhiệm Qwen4, sở hữu 125B tham số nhưng chỉ kích hoạt 6B mỗi token. Với chi phí huấn luyện tối ưu và điểm số SWE-bench Pro đạt 62.5, mô hình này đã vượt mặt Claude Opus 4.6 Max.

Cùng sự kiện, tinh chọn hiển thị «Alibaba ra mắt Qwen3.8-Flash: Mô hình MoE hiệu năng cao, hé lộ kiến trúc Qwen4»
Zhipu AI Z.ai@Zai_org
Mô hìnhĐiểm AI 80/100

Cùng sự kiệnZhipu AI ra mắt GLM-5.3-Flash: Mô hình 320B mã nguồn mở theo giấy phép MIT

Introducing GLM-5.3-Flash - Leading capabilities at a highly competitive price - Natively multimoda…

DịchZhipu AI vừa phát hành GLM-5.3-Flash, mô hình đa phương thức mạnh mẽ với 320 tỷ tham số, hỗ trợ cửa sổ ngữ cảnh 1 triệu token và hoàn toàn tương thích với chip AI nội địa.

Cùng sự kiện, tinh chọn hiển thị «Zhipu ra mắt GLM-5.3-Flash: Mô hình đa phương thức mạnh mẽ với chi phí cực thấp»
IT Home
Mô hìnhĐiểm AI 76/100

Cùng sự kiệnZhipu ra mắt mô hình đa phương thức GLM-5.3-Flash: Hiệu năng ngang ngửa Claude Opus với giá siêu rẻ

Zhipu giới thiệu GLM-5.3-Flash, mô hình đa phương thức 320B với 18B tham số kích hoạt, đạt hiệu suất tương đương Claude Opus 4.8 nhưng có mức giá chỉ bằng 1/40.

Cùng sự kiện, tinh chọn hiển thị «Zhipu ra mắt GLM-5.3-Flash: Mô hình đa phương thức mạnh mẽ với chi phí cực thấp»
Kim@kimmonismus
Mô hìnhĐiểm AI 42/100

GLM-5.3 Flash sắp ra mắt: Hiệu năng tiệm cận Opus 4.8 với chi phí tối ưu

The upcoming Ox Alpha is GLM-5.3 Flash (as expected): 320b total parameters, 18b active. Outperform…

DịchMô hình Ox Alpha (GLM-5.3 Flash) sở hữu 320 tỷ tham số với 18 tỷ tham số kích hoạt, hứa hẹn vượt trội hơn bản 5.2 về lập trình và tác vụ thông minh với chi phí chỉ bằng 1/10.

Thêm 2 nguồn khác đưa tinHacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)X: Artificial Analysis (@ArtificialAnlys)
Qwen@Alibaba_Qwen
Mô hìnhĐiểm AI 57/100

Cùng sự kiệnQwen3.8-Flash-Next ra mắt: Mô hình 125B tối ưu hiệu suất với công nghệ N-gram

Big thanks to @sgl_project for the day-0 support! 🙌 Qwen3.8-Flash-Next is ready to deploy with SGLa…

DịchAlibaba trình làng Qwen3.8-Flash-Next, mô hình 125B sử dụng 51B N-gram embedding giúp tăng dung lượng mà không tốn thêm chi phí tính toán. SGLang đã hỗ trợ triển khai ngay lập tức cho kiến trúc này.

Cùng sự kiện, bài đại diện «Qwen3.8-Flash-Next chính thức được hỗ trợ trên SGLang ngay từ ngày ra mắt»
Kim@kimmonismus
Mô hìnhĐiểm AI 51/100

Cùng sự kiệnQwen3.8-Flash-Next: Mô hình 6B tham số kích hoạt vượt mặt Claude Opus 4.6 Max

A bit more tl; dr about the model: Qwen3.8-Flash-Next combines 125B MoE parameters with 51B N-gram em…

DịchQwen3.8-Flash-Next vừa ra mắt với kiến trúc MoE siêu thưa, sở hữu tổng 125B tham số nhưng chỉ kích hoạt 6B mỗi token, mang lại hiệu suất vượt trội so với Claude Opus 4.6 Max.

Cùng sự kiện, bài đại diện «Qwen3.8-Flash-Next chính thức được hỗ trợ trên SGLang ngay từ ngày ra mắt»
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnCyberFactory: Bước tiến mới trong huấn luyện AI bảo mật từ dữ liệu thực tế

CyberFactory là khung mã nguồn mở toàn diện giúp chuẩn hóa quy trình tạo dữ liệu, huấn luyện mô hình và thực thi các tác vụ bảo mật như vá lỗi hay giải đáp lỗ hổng từ dữ liệu thực tế (CVE).


Vì sao đáng đọc: Đây là nghiên cứu quan trọng giúp thu hẹp khoảng cách giữa mô hình đóng và mở trong lĩnh vực an ninh mạng, cung cấp giải pháp thực tế cho việc huấn luyện tác nhân AI.
IT Home
Hướng dẫnĐiểm AI 46/100

Nghiên cứu: Trẻ sơ sinh học ngôn ngữ hiệu quả vượt xa các chatbot AI hiện nay

Các nhà khoa học tại Stanford chỉ ra rằng trẻ em chỉ cần tiếp xúc với lượng từ vựng rất nhỏ đã có thể giao tiếp, trong khi AI cần khối lượng dữ liệu khổng lồ nhưng kết quả vẫn kém xa. Điều này đặt ra thách thức lớn cho việc phát triển AI chỉ dựa vào quy mô dữ liệu.

Kim@kimmonismus
Mô hìnhĐiểm AI 45/100

Cùng sự kiệnQwen3.8-Flash-Next ra mắt: Mô hình MoE đa phương thức với 6B tham số kích hoạt

Qwen may be about to drop another super interesting open-weight models of the year. A ModelScope de…

DịchQwen3.8-Flash-Next chính thức lộ diện như bản xem trước của kiến trúc Qwen4. Với cấu trúc MoE đa phương thức, mô hình sở hữu tổng 176B tham số nhưng chỉ kích hoạt 6B tham số mỗi token, hứa hẹn hiệu suất vượt trội.

Cùng sự kiện, tinh chọn hiển thị «Alibaba ra mắt Qwen3.8-Flash: Mô hình MoE hiệu năng cao, hé lộ kiến trúc Qwen4»
TechNode
Mô hìnhĐiểm AI 88/100

Cùng sự kiệnAlibaba sắp mở mã nguồn Qwen3.8-Flash-Next, hé lộ kiến trúc Qwen4 thế hệ mới

Alibaba chuẩn bị ra mắt Qwen3.8-Flash-Next, một mô hình đa phương thức dạng Mixture-of-Experts dựa trên kiến trúc Qwen4, nhằm giúp cộng đồng lập trình viên làm quen trước khi phiên bản chính thức trình làng.

Cùng sự kiện, tinh chọn hiển thị «Alibaba ra mắt Qwen3.8-Flash: Mô hình MoE hiệu năng cao, hé lộ kiến trúc Qwen4»
Qwen@Alibaba_Qwen
Hướng dẫnĐiểm AI 36/100

Qwen2.5-27B (Qwen3.8) thống trị bảng xếp hạng chuyển đổi ảnh sang web mã nguồn mở

#1 among open models in the Image-to-WebDev Arena, #7 overall. 🚀 Thanks for the recognition! @arena…

DịchMô hình Qwen2.5-27B đạt vị trí dẫn đầu trong nhóm mã nguồn mở tại Image-to-WebDev Arena với 1574 điểm, cho thấy hiệu suất ngang ngửa các siêu mô hình 2.8T tham số dù chỉ sở hữu 27B tham số.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 45/100

BPCO: Giải pháp tối ưu hóa Critic giúp huấn luyện Reinforcement Learning ổn định hơn

BPCO là phương pháp huấn luyện mới kết hợp nhiều kỹ thuật tiên tiến nhằm khắc phục sự bất ổn trong Reinforcement Learning dựa trên Critic, giúp cải thiện đáng kể khả năng suy luận toán học của các mô hình ngôn ngữ lớn.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 55/100

OPDVR: Phương pháp chưng cất chính sách không giám sát kết hợp phần thưởng kiểm chứng

OPDVR là phương pháp mới kết hợp học tăng cường dựa trên phần thưởng kiểm chứng (RLVR) với chưng cất chính sách trực tuyến (OPD) mà không cần thêm siêu tham số, giúp tối ưu hóa mô hình hiệu quả hơn.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 53/100

Meta^n: Đột phá khả năng tự cải thiện đệ quy thông qua chiều sâu mới

Meta^n giới thiệu phương pháp tự cải thiện đệ quy bằng cách mở rộng chiều sâu xử lý thông qua các thao tác meta cố định. Mô hình này vượt trội hơn các tác nhân tự cải thiện hiện có trên 8 bộ tiêu chuẩn, đặc biệt là kết quả ấn tượng tại ARC-AGI-2.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

AutoSaddler: Tự động tối ưu hóa khung điều khiển cho tác nhân AI thông qua vết thực thi

AutoSaddler là khung làm việc tự động giúp tối ưu hóa các khung điều khiển (harness) cho tác nhân AI bằng cách học từ lỗi thực thi, giúp cải thiện đáng kể độ tin cậy trong các tác vụ dài hạn trên các nền tảng như SWE-Bench Pro.

MiniMax@MiniMax_AI
Hướng dẫnĐiểm AI 20/100

MiniMax-M3: Đột phá hiệu suất với chi phí thực thi tác vụ AI cực thấp

Love seeing real-world agent benchmarks like this 👇 MiniMax-M3: $0.018 to spin up an inbox, write …

DịchMiniMax-M3 thiết lập chuẩn mực mới cho AI agent khi hoàn thành tác vụ gửi email chuyên nghiệp chỉ với 0,018 USD, khẳng định vị thế là mô hình hiệu quả nhất về chi phí trên thị trường hiện nay.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 47/100

Điểm chuẩn AI không đáng tin: Thay đổi cấu hình nhỏ khiến thứ hạng mô hình đảo lộn

// There Is No Neutral Harness // Great work discussing some of the issues in harness evaluation. …

DịchNghiên cứu chỉ ra rằng chỉ cần thay đổi thứ tự đáp án hoặc cách diễn đạt câu lệnh, điểm số của các mô hình AI có thể dao động cực lớn, khiến bảng xếp hạng hiện nay trở nên thiếu khách quan.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 44/100

Đánh giá AI không hề khách quan: Điểm số một mô hình có thể dao động từ 31% đến 89%

Great paper on agent harnesses.

DịchNghiên cứu mới chỉ ra rằng cách thiết lập bộ khung đánh giá ảnh hưởng cực lớn đến kết quả của AI. Chỉ cần thay đổi thứ tự đáp án hay cách đặt câu hỏi, thứ hạng của các mô hình có thể bị đảo lộn hoàn toàn, cho thấy các bài kiểm tra hiện nay còn nhiều lỗ hổng.

Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (65 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “LLM” — Trang 21 | AIHOT.vn