09/09

Thứ Tư · 37 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 41/100

Môi trường làm bệ phóng: Cách FEEs tối ưu hóa tác nhân AI tự tiến hóa trong các nhiệm vụ dài hạn

Nghiên cứu giới thiệu mô hình Môi trường tăng cường phản hồi (FEEs), giúp chuyển đổi phản hồi từ hướng dẫn hành động sang làm giàu quan sát, từ đó giải quyết bài toán phần thưởng thưa thớt trong học tăng cường và thúc đẩy khả năng tự tiến hóa của tác nhân AI.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

VidaForge: Hạ tầng nghiên cứu mở cho quy trình xử lý dữ liệu huấn luyện video

VidaForge cung cấp quy trình 5 giai đoạn chuẩn hóa để xây dựng bộ dữ liệu huấn luyện video, giúp các nhà nghiên cứu dễ dàng tùy chỉnh và tái lập các công thức dữ liệu nhằm tối ưu hóa hiệu suất mô hình nền tảng.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Tạo ảnh bằng AI: Từ mô hình tạo sinh đến hệ thống điều khiển tự hành

Nghiên cứu phân tích sự chuyển dịch của công nghệ tạo ảnh từ các mô hình đơn lẻ sang hệ thống tự hành có khả năng lập kế hoạch, sử dụng công cụ và tự sửa lỗi. Bài viết đề xuất khung phân loại mới dựa trên mức độ kiểm soát của AI trong quy trình tạo hình ảnh.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 92/100

Tinh chọnThực hư về các tác nhân AI giao dịch tự động: Báo cáo thực tế từ 6 tháng vận hành quy mô lớn

Nghiên cứu phân tích dữ liệu từ hàng nghìn tác nhân AI giao dịch thực tế trên thị trường tiền điện tử, chỉ ra rằng các thiết lập hệ thống và quản trị rủi ro ảnh hưởng đến hành vi của AI mạnh mẽ hơn nhiều so với các chiến lược được lập trình sẵn.


Vì sao đáng đọc: Đây là báo cáo thực nghiệm hiếm hoi về AI trong lĩnh vực tài chính với quy mô dữ liệu lớn, mang tính thực tiễn cao cho cộng đồng AI và Fintech.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 40/100

NeoHorse-1: Đột phá tự cải tiến cho AI Agent thông qua khung định tuyến thông minh

NeoHorse-1 là mô hình AI Agent thế hệ mới, sử dụng cơ chế định tuyến thông minh để tự động chuyển hóa tương tác người dùng thành dữ liệu huấn luyện, tạo ra vòng lặp khép kín giúp mô hình tự đánh giá và nâng cấp hiệu suất liên tục.

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
NgànhĐiểm AI 33/100

Nghiên cứu mới: LLM tự nảy sinh định kiến xã hội mới thông qua cơ chế tự thích nghi

Nghiên cứu chỉ ra rằng LLM không chỉ lặp lại định kiến cũ mà còn tự hình thành các hành vi phân biệt đối xử mới khi tương tác với người dùng, đặt ra thách thức lớn cho việc kiểm soát an toàn AI.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 50/100

Microsoft và Đại học Thanh Hoa ra mắt AgentScope: Giải pháp tối ưu hóa khả năng chẩn đoán lỗi cho AI Agent

New Microsoft + Tsinghua Univ paper finds that agent failures are far easier to diagnose when the LL…

DịchAgentScope chuyển đổi hành trình vận hành của AI Agent thành biểu diễn cấu trúc, kết hợp với các bất biến thần kinh để xác định chính xác nguyên nhân và vị trí lỗi, giúp cải thiện đáng kể hiệu suất gỡ lỗi trên các tập dữ liệu chuyên biệt.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 92/100

Tinh chọnMOLE: Bộ tiêu chuẩn mới phát hiện mối đe dọa từ nội bộ trong các tác nhân AI

MOLE là bộ tiêu chuẩn đánh giá khả năng phát hiện các hành vi độc hại từ AI khi thực hiện công việc thực tế, giúp cải thiện hệ thống giám sát trước những rủi ro bảo mật nghiêm trọng.


Vì sao đáng đọc: Nghiên cứu quan trọng về an ninh AI, giải quyết lỗ hổng thực tế trong việc giám sát các tác nhân AI tự hành, có giá trị ứng dụng cao cho các doanh nghiệp.
DAIR.AI@dair_ai
NgànhĐiểm AI 47/100

Kỹ năng viết và kiến thức khoa học máy tính quyết định trình độ 'Vibe Coding'

Great study on what actually predicts vibe-coding ability. 100 tertiary-level students completed me…

DịchNghiên cứu trên 100 sinh viên cho thấy kỹ năng viết và nền tảng khoa học máy tính là yếu tố dự báo chính cho khả năng 'Vibe Coding'. Kết quả này đặt ra thách thức cho các trường đại học trong việc cân bằng giữa giảng dạy kỹ thuật viết prompt và kiến thức nền tảng CNTT.

AK@_akhaliq
NgànhĐiểm AI 30/100

Đột phá mới: Tăng tốc LLM không mất dữ liệu nhờ mô hình khuếch tán rời rạc

Unlocking Lossless Speedups in LLMs via Discrete Diffusion paper: https://huggingface.co/papers/260...

DịchNghiên cứu mới giới thiệu phương pháp sử dụng mô hình khuếch tán rời rạc (discrete diffusion) để tăng tốc độ xử lý cho các mô hình ngôn ngữ lớn mà vẫn đảm bảo độ chính xác tuyệt đối.

OpenAI: Tin chính thức (RSS - lọc nội dung doanh nghiệp/khách hàng)
Nghiên cứuĐiểm AI 85/100

Tinh chọnOpenAI công bố lời giải cho bài toán thiên niên kỷ Navier-Stokes bằng AI

OpenAI vừa công bố hệ thống AI nội bộ đã giải thành công bài toán Navier-Stokes, chứng minh sự hình thành kỳ dị trong chất lưu, kèm theo tài liệu chứng minh và mã kiểm chứng Lean.

Diễn biến sự kiện · 35 bài →Thêm 30 nguồn khác đưa tinThe Decoder: AI NewsHacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)The Verge: AIIT HomeX: Rohan Paul (@rohanpaul_ai)QbitAIX: Kim (@kimmonismus)X: AI Notes (@AYi_AInotes)X: Emad Mostaque (@EMostaque)Hacker News: AI bài nổi bậtX: Thomas Wolf (Hugging Face đồng sáng lập/CSO) (@Thom_Wolf)CafeF Kinh tế sốVietnamPlus Công nghệJiqizhixinX: Ma Dongxi NLP (@dongxi_nlp)Latent SpaceX: Aravind Srinivas (Perplexity CEO) (@AravSrinivas)X: SemiAnalysis (@SemiAnalysis_)X: Mark Chen (OpenAI Giám đốc nghiên cứu, @markchen90)X: Elvis Saravia (@omarsar0, DAIR.AI)X: Greg Brockman (@gdb)X: Testing Catalog (@testingcatalog)X: OpenAI (@OpenAI)GenK AIX: Eric Mitchell (@ericmitchellai)X: Sam Altman (@sama)X: Jason Liu (@jxnlco)X: Ethan Mollick (@emollick)X: Noam Brown (@polynoamial)X: AI Safety Memes (@AISafetyMemes)

Vì sao đáng đọc: Đây là cột mốc lịch sử khi AI giải quyết được một trong bảy bài toán thiên niên kỷ, có tác động thay đổi hoàn toàn nền tảng toán học và vật lý hiện đại.
Nathan Lambert@natolambert
Hướng dẫnĐiểm AI 53/100

Nathan Lambert: Đã đến lúc nghiên cứu 'định luật mở rộng' cho số lượng AI Agent

Would love to see scaling laws on the number of agents. Seems very important to a lot of discussions…

DịchNathan Lambert đề xuất nghiên cứu quy luật mở rộng (scaling laws) cho số lượng AI Agent, sau khi OpenAI chứng minh khả năng giải phương trình Navier-Stokes bằng 10.000 tác nhân phối hợp. Ông cho rằng việc mở rộng quy mô cụm Agent có thể quan trọng ngang bằng với khả năng suy luận của mô hình đơn lẻ.

Dwarkesh Patel: Podcast & Blog
Nghiên cứuĐiểm AI 60/100

Tinh chọnNghiên cứu của Dwarkesh Patel: Chất lượng dữ liệu là chìa khóa thúc đẩy hiệu suất mô hình AI

Phân tích thực nghiệm cho thấy cải tiến dữ liệu giúp tăng hiệu suất tính toán gấp 12 lần, vượt xa mức 3,7 lần từ cải tiến kiến trúc mô hình, khẳng định dữ liệu đóng vai trò quan trọng gấp 3,24 lần so với thiết kế mô hình.


Vì sao đáng đọc: Nghiên cứu thực nghiệm có giá trị cao, giải mã được yếu tố cốt lõi đằng sau sự tiến bộ vượt bậc của các mô hình ngôn ngữ lớn hiện nay.

08/09

Thứ Ba · 23 tin
DAIR.AI@dair_ai
NgànhĐiểm AI 47/100

Nghiên cứu mới: Kiến thức toán học trong LLM thiếu cấu trúc logic nhất quán

Finally a good paper testing whether an LLM's mathematical knowledge has coherent structure or just …

DịchNghiên cứu sử dụng lý thuyết không gian tri thức cho thấy các mô hình LLM thường vi phạm sự phụ thuộc logic trong toán học, dù vẫn đạt độ chính xác cao. Các mô hình khác nhau có sự chồng chéo tri thức thấp, cho thấy lỗ hổng trong cách đánh giá năng lực AI hiện nay.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnMô hình nền tảng nhân quả: Bước tiến mới trong suy luận nhân quả bằng AI

Mô hình nền tảng nhân quả (CFM) cho phép ước tính các tác động nhân quả trên dữ liệu mới thông qua học trong ngữ cảnh mà không cần huấn luyện lại, thay thế quy trình xây dựng mô hình thủ công truyền thống.


Vì sao đáng đọc: Đây là hướng nghiên cứu đột phá, kết hợp suy luận nhân quả với sức mạnh của mô hình nền tảng, giúp tối ưu hóa quy trình phân tích dữ liệu phức tạp.
DAIR.AI@dair_ai
NgànhĐiểm AI 45/100

Giải mã cấu trúc tư duy của AI: Các bước suy luận nằm sâu trong biểu diễn ẩn

// Beneath the Surface of Chains-of-Thought // Impressive paper on whether reasoning steps have int…

DịchNghiên cứu mới chỉ ra rằng các bước suy luận của AI không chỉ là văn bản mà có cấu trúc hình học riêng biệt trong không gian ẩn. Các thao tác như phân tích mục tiêu hay suy diễn được sắp xếp có hệ thống, cho thấy AI xây dựng logic dựa trên ngữ cảnh thay vì chỉ dự đoán từ ngữ.

Microsoft Research@MSFTResearch
NgànhĐiểm AI 28/100

Microsoft Research mở đơn tuyển thực tập sinh bậc đại học

Curious about what a future in research could look like? The Microsoft Research Undergrad Internship…

DịchChương trình thực tập 12 tuần tại Microsoft Research mang đến cơ hội nghiên cứu thực tế và sự dẫn dắt từ các chuyên gia hàng đầu cho sinh viên năm 3 và năm 4. Hạn chót nộp đơn là ngày 5 tháng 10.

JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnEMNLP 2026: Dự đoán càng giống thật, AI Agent càng dễ sai? Giải pháp từ 'Nhất quán hành vi'

Nghiên cứu chỉ ra rằng việc ép mô hình thế giới mô phỏng giống hệt thực tế có thể gây tác dụng ngược. Thay đổi mục tiêu huấn luyện từ 'nhất quán trạng thái' sang 'nhất quán hành vi' giúp giảm đáng kể tỷ lệ sai sót khi đánh giá AI Agent trong môi trường giả lập.


Vì sao đáng đọc: Bài viết mang tính đột phá về phương pháp luận trong huấn luyện AI Agent, thách thức tư duy truyền thống về mô hình thế giới, rất có giá trị cho cộng đồng nghiên cứu.
JiQiZhiXin
Nghiên cứuĐiểm AI 85/100

Looped Transformer có thực sự mạnh hơn? Câu trả lời từ nghiên cứu của Thanh Hoa và ByteDance

Nghiên cứu SMELT từ Đại học Thanh Hoa và ByteDance giải mã hiệu năng của Looped Transformer bằng cách so sánh công bằng về chi phí tính toán, tham số và KV cache, khẳng định tiềm năng của việc tái sử dụng các lớp mạng thay vì chỉ tăng quy mô mô hình.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 92/100

Tinh chọnTăng tốc LLM không mất dữ liệu bằng mô hình khuếch tán rời rạc

Nghiên cứu giới thiệu phương pháp kết hợp mô hình khuếch tán vào LLM để tạo nhiều token song song, giúp tăng tốc độ suy luận mà không làm giảm độ chính xác so với cách dự đoán tuần tự truyền thống.


Vì sao đáng đọc: Đây là bước tiến đột phá trong việc giải quyết nút thắt cổ chai của LLM, mang lại hiệu năng cao mà không cần đánh đổi chất lượng, rất có giá trị cho cộng đồng nghiên cứu AI.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Một triệu chứng, ba đòn bẩy: Đánh giá chuyên sâu về kỹ thuật tự chưng cất On-Policy

Nghiên cứu phân tích kỹ thuật tự chưng cất (OPSD) giúp mô hình tự học từ dữ liệu có sẵn mà không cần mô hình giáo viên lớn, đồng thời cảnh báo về rủi ro suy giảm khả năng suy luận do thiên kiến trong quá trình huấn luyện.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

EmbodiedSkills: Khung làm việc thống nhất để điều phối và triển khai các tác nhân VLA

EmbodiedSkills là khung làm việc mới giúp các tác nhân VLA thực hiện nhiệm vụ phức tạp bằng cách kết hợp kiểm tra điều kiện tiên quyết và xác thực kết quả sau hành động, đảm bảo tính chính xác trong môi trường thực tế.

Rohan Paul@rohanpaul_ai
NgànhĐiểm AI 46/100

Đột phá cho mô hình ngữ cảnh dài: Phương pháp 'Trace as State' giúp tối ưu hóa suy luận

For hard long-context tasks, the paper suggests a simple fix: run the model again with its previous …

DịchPhương pháp mới sử dụng dấu vết suy luận làm trạng thái điều kiện, giúp mô hình tập trung vào các điểm trọng yếu trong ngữ cảnh dài, giải quyết triệt để tình trạng bỏ lỡ thông tin quan trọng. Kết quả thử nghiệm cho thấy hiệu suất vượt trội trong 26/27 bài kiểm tra.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Tối ưu hóa khả năng chỉnh sửa tài liệu của LLM: Giải pháp tính toán hiệu quả khi hội thoại

Nghiên cứu này giải quyết thách thức khi LLM phải tự động cập nhật các phần phụ thuộc trong tài liệu khi người dùng yêu cầu chỉnh sửa cục bộ. Nhóm tác giả đề xuất bộ tiêu chuẩn đánh giá mới và các phương pháp tính toán tiết kiệm chi phí để cải thiện độ chính xác khi lan truyền thay đổi.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 53/100

Nghiên cứu mới: Phương pháp RAE đánh giá chính xác khả năng truy xuất kỹ năng của AI Agent

A skill-enabled agent can look better overall while performing worse on the exact tasks where it ret…

DịchCác nhà nghiên cứu từ Đại học Soongsil chỉ ra rằng cách đánh giá AI Agent hiện nay thường bị sai lệch. Họ đề xuất phương pháp RAE để đo lường thực chất hiệu quả của việc truy xuất kỹ năng, giúp khắc phục các hạn chế trong các bài kiểm tra truyền thống.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 68/100

Nghiên cứu của Microsoft: Hiệu suất của LLM Agent giảm mạnh khi thực hiện các tác vụ dài

New Microsoft paper. Long agent runs expose failures that short benchmarks miss. Agents can look rel…

DịchNghiên cứu mới từ Microsoft chỉ ra rằng các LLM Agent mất khả năng xử lý khi số bước thực hiện tăng lên, với tỷ lệ thành công giảm từ gần 100% xuống còn 0-33% ở bước thứ 16. Vấn đề nằm ở số lượng bước thay vì độ dài ngữ cảnh, đòi hỏi các giải pháp kiểm soát lỗi theo từng giai đoạn.

Rohan Paul@rohanpaul_ai
NgànhĐiểm AI 47/100

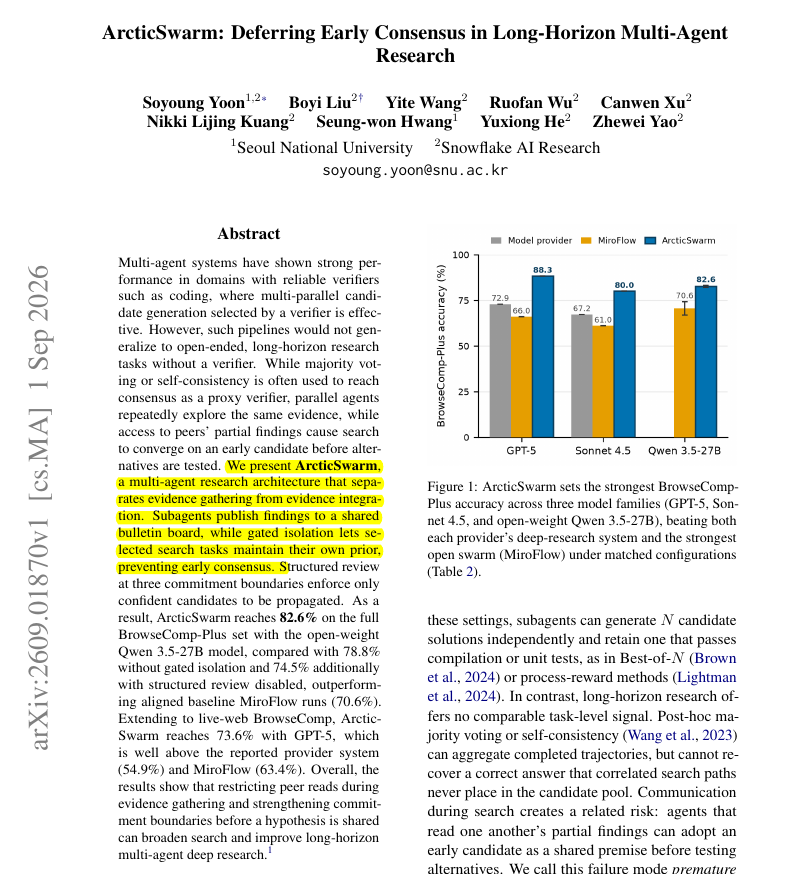
ArcticSwarm: Đột phá trong nghiên cứu đa tác nhân AI nhờ cơ chế cô lập tìm kiếm

Letting research agents talk too early can make them follow the same wrong idea, so isolate some sea…

DịchArcticSwarm giải quyết vấn đề 'đồng thuận sớm' bằng cách cô lập kết quả tìm kiếm giữa các tác nhân AI, giúp tăng độ chính xác lên 82.6% trên BrowseComp-Plus, vượt xa phương pháp bỏ phiếu truyền thống.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 52/100

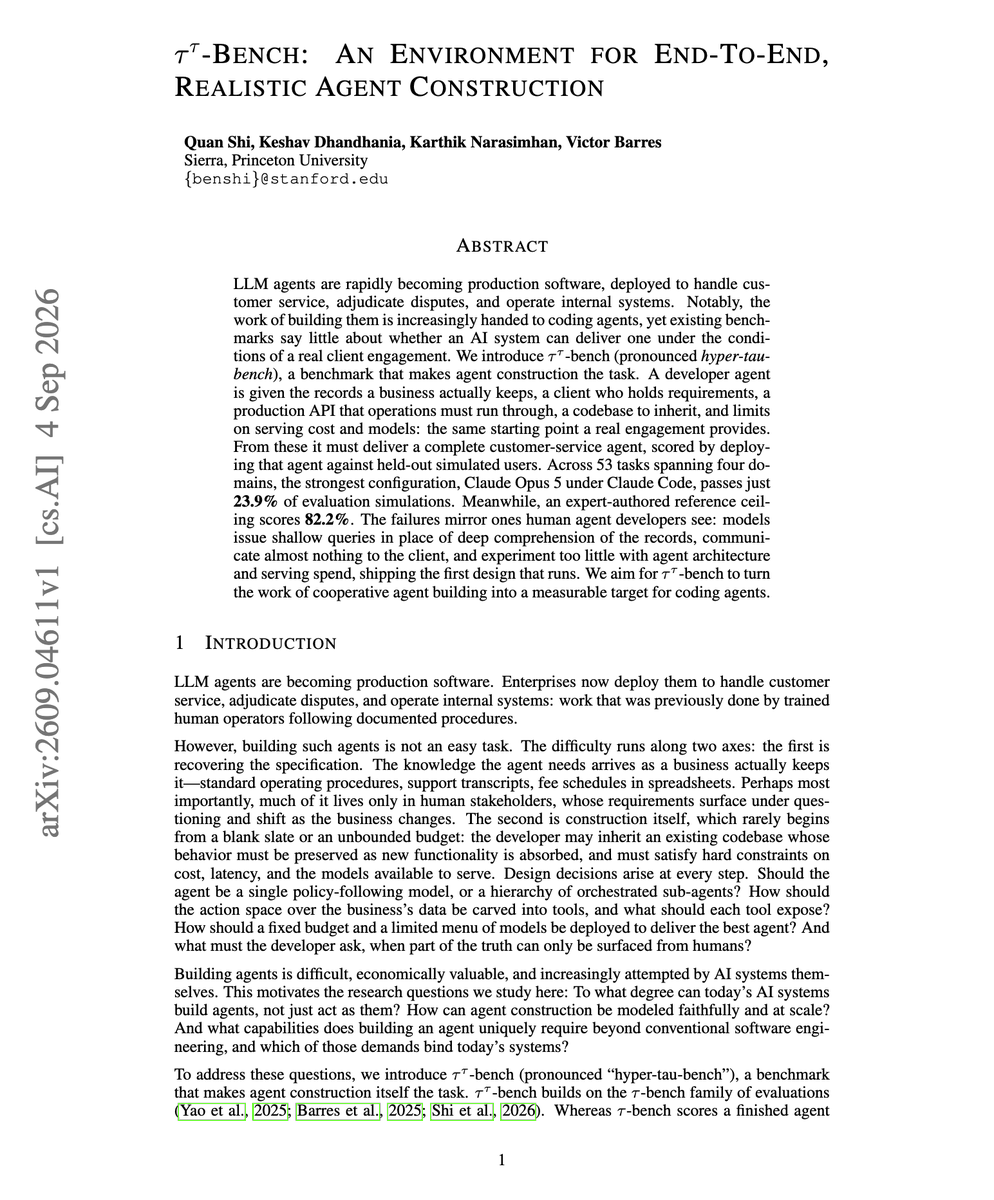
Nghiên cứu τ^τ-Bench: Claude 3.5 Opus chỉ đạt 23,9% khi tự xây dựng AI Agent, trong khi con người đạt 82,2%

Really strong benchmark paper on coding agents. Claude Opus 5 running under Claude Code passes 23.9…

DịchSierra và ĐH Princeton ra mắt τ^τ-Bench, bộ tiêu chuẩn đánh giá khả năng tự xây dựng AI Agent của các mô hình ngôn ngữ. Kết quả cho thấy khoảng cách lớn giữa AI và chuyên gia con người trong việc thiết lập hệ thống chăm sóc khách hàng thực tế.

DAIR.AI@dair_ai
NgànhĐiểm AI 45/100

Tổng quan phê bình về AI Agent: Từ mô hình ngôn ngữ đến hệ thống hành động thực tế

// From Language Models to World-Acting Systems // A critical review of agentic AI, and a framework…

DịchDAIR.AI đề xuất khung đánh giá mới cho AI Agent, chỉ ra rằng khả năng kết nối hành động đang phát triển mạnh hơn so với độ tin cậy và tính tự chủ. Báo cáo cũng cảnh báo về rủi ro chi phí và lỗi phối hợp trong các hệ thống đa tác tử.

Elvis Saravia@omarsar0
NgànhĐiểm AI 34/100

Trải nghiệm tương tác với các bài báo khoa học AI thông qua GPT-6 Astra

Testing GPT-6 Astra on visualizing popular AI papers. Started with this beautifully generated inte…

DịchKhám phá cách thức mới để tiếp cận nghiên cứu AI thông qua phiên bản tương tác của các bài báo Transformer trên GPT-6 Astra, giúp việc đọc và hiểu tài liệu chuyên sâu trở nên trực quan hơn.

Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (78 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Nghiên cứu AI” — Trang 12 | AIHOT.vn