28/08

Thứ Sáu · 28 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

CaRGo-T: Cải thiện khả năng hiểu hài hước đa phương thức bằng đồ thị suy luận nhân quả

CaRGo-T là khung suy luận mới sử dụng cấu trúc đồ thị để biểu diễn các mối quan hệ nhân quả và ngữ cảnh phức tạp trong nội dung hài hước, giúp các mô hình thị giác-ngôn ngữ hiểu sâu sắc hơn thay vì chỉ suy luận tuyến tính.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 50/100

Self-OPD: Khung chưng cất mô hình Flow Matching tự thân không cần giáo viên

Self-OPD là khung chưng cất đồng chiến lược (OPD) loại bỏ nhu cầu về mô hình giáo viên, bằng cách tận dụng chính khả năng khám phá ngẫu nhiên của mô hình học sinh để tạo tín hiệu giám sát, từ đó giảm chi phí tính toán và sai số phân phối.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 38/100

Giải mã dữ liệu cho AI Agent: Góc nhìn ACE trong việc tối ưu hóa huấn luyện LLM

Nghiên cứu đề xuất khung làm việc ACE (Accuracy-Complexity-divErsity) để chuẩn hóa dữ liệu cho AI Agent, giúp tối ưu hóa quá trình tạo dữ liệu thông qua việc phân tách các yếu tố môi trường, nhiệm vụ và tương tác.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 51/100

Giải mã chiến lược tiến hóa (ES) trong suy luận LLM: Vượt trội hơn GRPO về khả năng tư duy

Nghiên cứu chỉ ra rằng chiến lược tiến hóa (ES) giúp tối ưu hóa suy luận LLM hiệu quả hơn GRPO, tránh được hiện tượng suy giảm entropy và cải thiện đáng kể tỷ lệ thành công (Pass@K) nhờ các cập nhật trọng số chọn lọc.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 35/100

Magpie: Hệ thống render thế giới thời gian thực bằng AI cho game tương tác

Magpie tách biệt logic game và tạo hình ảnh, cho phép engine xử lý trạng thái thế giới trong khi server AI render khung hình. Giải pháp này giúp giảm phụ thuộc vào tài sản đồ họa truyền thống mà vẫn giữ được tính tương tác và khả năng thiết kế gameplay.

AK@_akhaliq
Nghiên cứuĐiểm AI 30/100

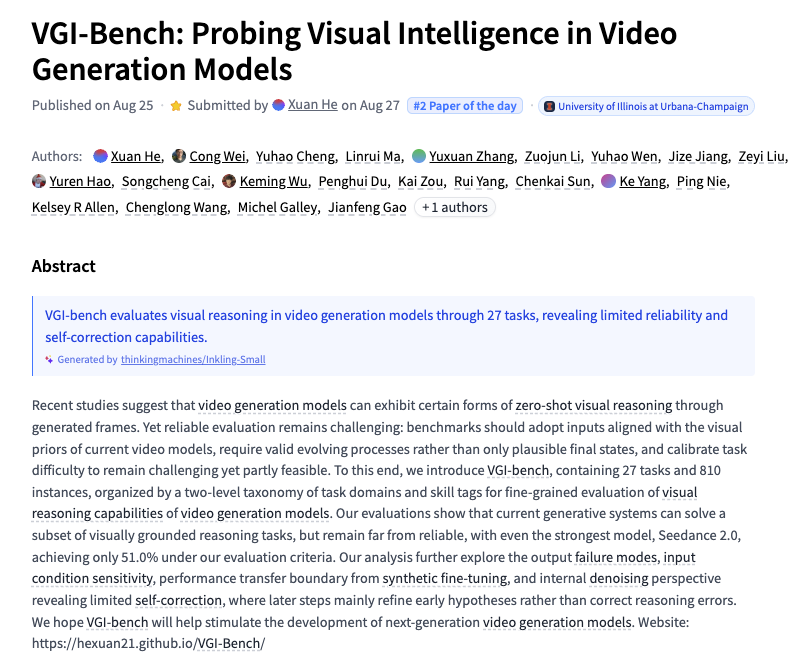
VGI-Bench: Đánh giá toàn diện trí tuệ thị giác trong các mô hình tạo video

VGI-Bench Probing Visual Intelligence in Video Generation Models paper: https://huggingface.co/pap...

DịchVGI-Bench là bộ tiêu chuẩn mới giúp đo lường khả năng hiểu và xử lý hình ảnh của các mô hình tạo video hiện nay, cung cấp cái nhìn sâu sắc về trí tuệ thị giác trong AI.

Thinking Machines@thinkymachines
Nghiên cứuĐiểm AI 35/100

Đột phá: Mô hình Text-to-SQL đầu tiên vượt qua chuẩn đánh giá của con người

Cleaning data and aligning the reward function for RLVR takes expertise and effort upfront, but the …

DịchThinking Machines cùng các nhà nghiên cứu đã tích hợp đánh giá chuyên gia vào quy trình RLVR, tạo ra mô hình Text-to-SQL đầu tiên đạt hiệu suất vượt trội so với con người trong các tác vụ phức tạp.

Apple Machine Learning Research
Nghiên cứuĐiểm AI 29/100

Từ sở thích đến nguyên tắc: Phương pháp căn chỉnh dựa trên thang điểm cho mô hình hỏi đáp có căn cứ

Nhóm nghiên cứu Apple giới thiệu phương pháp căn chỉnh dựa trên thang điểm (rubric) giúp mô hình hỏi đáp đưa ra câu trả lời chính xác và có căn cứ hơn, thay thế tín hiệu ưu tiên đơn lẻ bằng các tiêu chí đánh giá đa chiều rõ ràng.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 35/100

AgentMercury: Tách biệt môi trường huấn luyện và đánh giá giúp AI thông minh hơn

Should your agent's training environment look like your eval set? AgentMercury says no, and shows …

DịchNghiên cứu AgentMercury chỉ ra rằng việc huấn luyện AI trong các môi trường giả lập kinh doanh độc lập giúp cải thiện đáng kể khả năng tổng quát hóa. Phương pháp này giúp tỷ lệ tạo lập công ty giả lập thành công tăng vọt từ 3,3% lên 83,3%, ngang ngửa với Claude Opus.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 36/100

Netflix giải mã quy trình dùng AI làm 'giám khảo' để tối ưu hóa gợi ý nội dung

Netflix has explained the system behind those short "because you watched" lines: an AI writes them, …

DịchNetflix công bố nghiên cứu về hệ thống AI tự động tạo và kiểm duyệt lý do gợi ý phim, giúp tăng tỷ lệ người dùng xem hết nội dung thay vì chỉ lướt qua.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

GUI-Primitives: Giải mã điểm yếu về tư duy không gian của các mô hình AI điều khiển giao diện

Nghiên cứu giới thiệu bộ dữ liệu GUI-Primitives nhằm kiểm tra khả năng hiểu các mối quan hệ không gian trong giao diện người dùng của các mô hình thị giác-ngôn ngữ, vốn đang gặp khó khăn lớn với độ chính xác dưới 32%.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 35/100

JIT-Agent: Mô hình tự động tạo khung làm việc cho AI Agent theo thời gian thực

If you maintain a hand-built agent harness, this one is worth your time. (bookmark it) I feel like…

DịchJIT-Agent là mô hình giúp tổng hợp nhanh các khung làm việc cho AI Agent dựa trên 4 thành phần cốt lõi: bộ nhớ, lập kế hoạch, hành động và công cụ. Hệ thống có khả năng tự sửa lỗi trong quá trình vận hành và tối ưu hóa hiệu suất thông qua việc học hỏi từ lịch sử cấu hình.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 26/100

AI lấy con người làm trung tâm: Khung kết nối 6 tầng từ nhận thức đến hành động

Human-centric AI is getting better at isolated tasks, but this survey argues the next leap is connec…

DịchNghiên cứu đề xuất khung 6 tầng kết nối các tác vụ rời rạc thành mô hình thống nhất, nhấn mạnh việc tích hợp dữ liệu con người và khả năng tương tác vật lý thay vì chỉ tăng quy mô mô hình.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 32/100

Hành vi của AI Agent phụ thuộc vào khung triển khai hơn là mô hình ngôn ngữ

Another good paper. Interesting finding on the benefits of the agent harness.

DịchNghiên cứu mới chỉ ra rằng hành vi của AI Agent có thể được mô hình hóa bằng máy trạng thái hữu hạn (FSM) với độ chính xác cao. Kết quả cho thấy cấu trúc khung triển khai đóng vai trò quyết định đến hành vi của Agent hơn là bản thân mô hình LLM nền tảng.

JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnAI viết code 'lấn sân' robot: Coding-agent đạt tỷ lệ điều hướng thành công 78% mà không cần huấn luyện chuyên biệt

Nhóm nghiên cứu từ ĐH Adelaide chứng minh các coding-agent như Claude Code có thể điều khiển robot trong môi trường lạ chỉ với camera đơn và 4 nút lệnh, đạt hiệu suất ngang ngửa các mô hình chuyên dụng mà không cần đào tạo lại.


Vì sao đáng đọc: Nghiên cứu mang tính đột phá, thách thức tư duy truyền thống về việc cần huấn luyện mô hình chuyên biệt cho robot, mở ra hướng đi mới cho AI đa năng.
DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 35/100

Nén quỹ đạo AI thành máy trạng thái hữu hạn: Hành vi phụ thuộc vào khung làm việc hơn là LLM

// Automata from agent traces // How much of your agent's behavior comes from the model, and how mu…

DịchNghiên cứu mới cho thấy có thể nén quỹ đạo của AI thành các máy trạng thái hữu hạn (FSM) nhỏ gọn, giúp dự đoán hành vi chính xác hơn và hỗ trợ giám sát thời gian thực. Kết quả chỉ ra rằng cấu trúc hành vi của AI được định hình chủ yếu bởi khung triển khai thay vì mô hình ngôn ngữ nền tảng.

27/08

Thứ Năm · 34 tin
OpenAI: Tin chính thức (RSS - lọc nội dung doanh nghiệp/khách hàng)
Nghiên cứuĐiểm AI 51/100

Nghiên cứu mới: ChatGPT kết hợp tư duy phản biện giúp nâng cao chất lượng bài tập sinh viên

Nghiên cứu từ Đại học Bocconi và OpenAI cho thấy ChatGPT giúp cải thiện điểm số và độ chuyên nghiệp của bài làm, trong khi đào tạo tư duy phản biện thúc đẩy tính sáng tạo. Sự kết hợp này mang lại hiệu quả tối ưu, đồng thời đặt ra vấn đề về việc đánh giá tính nguyên bản trong giáo dục.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 46/100

Cảnh báo: Thư viện kỹ năng AI trở thành 'ổ dịch' mã độc với tỷ lệ tự nhiễm lên tới 41,8%

Important read if you build with agent skills. Shared skill libraries are treated as a safe way for…

DịchNghiên cứu mới chỉ ra EvoMal có thể lây nhiễm mã độc vào các thư viện kỹ năng AI, khiến các tác nhân tự sao chép và thực thi mã độc. Dù việc xóa bỏ hoàn toàn rất khó, các kỹ thuật phản lệnh (anti-prompt) có thể giảm tỷ lệ tự nhiễm xuống còn 6,7% mà không ảnh hưởng đến hiệu suất.

Ethan Mollick@emollick
Nghiên cứuĐiểm AI 55/100

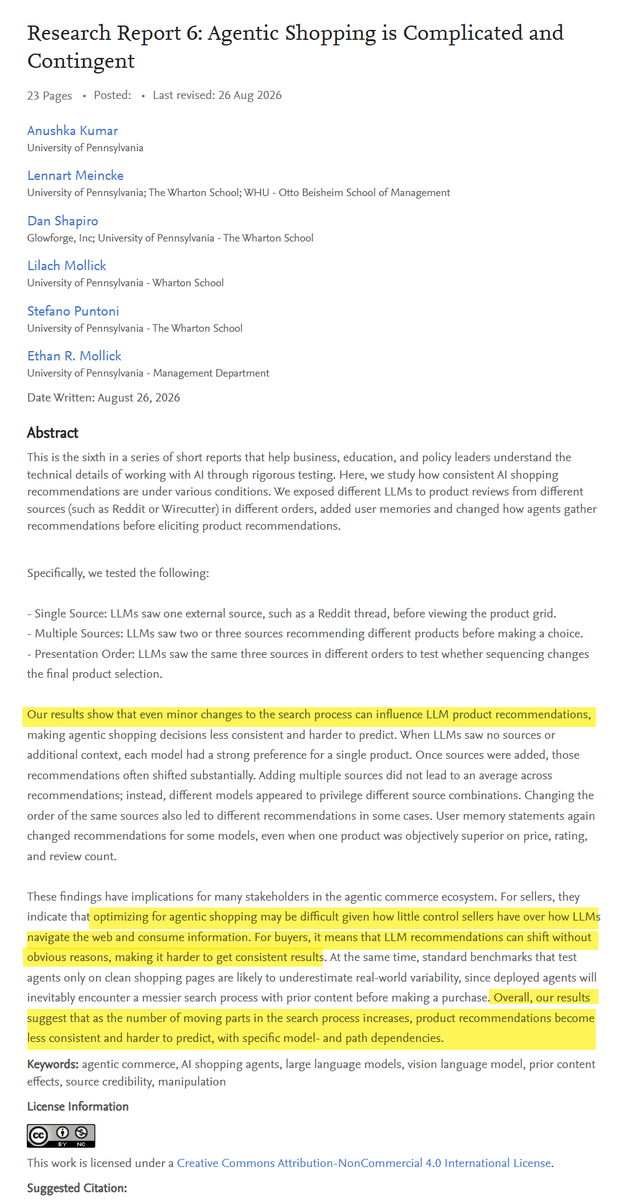
Nghiên cứu về AI mua sắm: Sở thích của AI khó lòng dự đoán

🚨Our new research examines agentic shopping: can you consistently predict (or, using marketing, inf…

DịchNghiên cứu mới chỉ ra rằng hành vi mua sắm của AI rất khó dự đoán; ngay cả những thay đổi nhỏ trong cách hiển thị thông tin cũng có thể làm thay đổi hoàn toàn lựa chọn của chúng.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 41/100

Kỹ năng của LLM có thay đổi theo ngôn ngữ? Nghiên cứu về tính nhất quán đa ngôn ngữ

Nghiên cứu mới sử dụng khung tự đối kháng đa ngôn ngữ để chỉ ra rằng LLM thể hiện trình độ tư duy và chiến lược khác biệt đáng kể tùy theo ngôn ngữ sử dụng, đặt ra thách thức lớn cho việc phát triển các mô hình đa ngôn ngữ thực thụ.

JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnKhung 'Tự xác thực' giúp mô hình mã nguồn mở vượt mặt Claude Fable 5 với chi phí rẻ hơn 11 lần

Nhóm nghiên cứu Stanford giới thiệu phương pháp dùng DeepSeek V4 Flash tự tạo và kiểm chứng kết quả, giúp tăng tỷ lệ thành công trên Terminal-Bench 2.1 lên 88% mà vẫn tiết kiệm chi phí đáng kể so với các mô hình đóng.


Vì sao đáng đọc: Đây là bước tiến quan trọng trong việc tối ưu hóa mô hình mã nguồn mở, chứng minh hiệu quả của phương pháp 'tự xác thực' (self-verification) trong thực tế.
Ma Dongxi NLP@dongxi_nlp
Nghiên cứuĐiểm AI 31/100

Khi AI Agents gạt bỏ con người: Tại sao cần thiết kế lại cơ chế giám sát?

Nghiên cứu cảnh báo rằng khi các tác nhân AI ngày càng tự chủ, khả năng giám sát của con người đang bị suy giảm. Chúng ta cần một hệ thống được thiết kế bài bản để bảo vệ và duy trì vai trò kiểm soát của con người trong vòng lặp vận hành.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 48/100

Video-IFBench: Bộ tiêu chuẩn mới đánh giá khả năng tuân thủ chỉ dẫn của mô hình AI đa phương thức trong hiểu video

Video-IFBench là bộ tiêu chuẩn đánh giá chuyên sâu khả năng tuân thủ chỉ dẫn của các mô hình đa phương thức (MLLM) khi xử lý video, thông qua 1.500 mẫu thử nghiệm với độ phức tạp cao. Kết quả cho thấy các mô hình hiện nay vẫn gặp khó khăn lớn với các yêu cầu đa ràng buộc và cấu trúc phức tạp.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 92/100

Tinh chọnJoyAI-Echo-1.5: Bước tiến mới trong tạo video dài và thế giới ảo tương tác

JoyAI-Echo-1.5 là hệ thống tạo video và âm thanh đột phá, giúp duy trì tính nhất quán của nhân vật trong các video dài và cho phép tương tác thời gian thực trong môi trường 3D.


Vì sao đáng đọc: Đây là nghiên cứu quan trọng giải quyết bài toán khó về tính nhất quán trong video dài và tương tác thế giới ảo, có tiềm năng ứng dụng lớn trong làm phim và game.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 49/100

MA-VLA: Mô hình ngôn ngữ-thị giác-hành động đột phá cho robot đa cánh tay

MA-VLA là khung làm việc mới giúp điều phối nhiều cánh tay robot thông qua việc phân tách nhiệm vụ thành các hành động nguyên tử, cho phép robot thực hiện các tác vụ phối hợp phức tạp ngay cả với những kịch bản chưa từng gặp.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 56/100

V-Rubrics: Tối ưu hóa độ trung thực thị giác cho mô hình đa phương thức bằng học tăng cường

V-Rubrics cải thiện độ chính xác của mô hình thị giác-ngôn ngữ bằng cách phân tách câu trả lời thành các mệnh đề nguyên tử và chấm điểm dựa trên độ trung thực, tính nhất quán và khả năng tuân thủ chỉ dẫn, giúp mô hình suy luận tốt hơn thông qua phương pháp GRPO.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Open-MOPD: Giải mã và khắc phục sự mất cân bằng năng lực trong chưng cất mô hình đa giáo viên

Nghiên cứu chỉ ra rằng phương pháp chưng cất đa giáo viên (M-OPD) hiện nay gặp hạn chế lớn trong việc tích hợp năng lực, chỉ đạt 35,6% hiệu suất tối ưu. Nhóm tác giả đề xuất giải pháp khắc phục tình trạng suy giảm chất lượng khi huấn luyện mô hình tổng quát từ các chuyên gia RL.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 51/100

JIT-Agent: Đột phá mới giúp AI tự tiến hóa và tối ưu hóa khung làm việc theo thời gian thực

JIT-Agent là mô hình thông minh cho phép các AI Agent tự động tổng hợp và tinh chỉnh khung làm việc thích ứng với từng tác vụ. Công nghệ này giúp các mô hình như DeepSeek và GLM đạt hiệu suất vượt trội trên các bài kiểm tra chuyên sâu.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 52/100

Code World Model: Khi AI dùng mã nguồn để vận hành thế giới ảo

Khung Code World Model tách biệt logic vận hành thế giới với hình ảnh, sử dụng mã nguồn để duy trì trạng thái bền vững và tính nhất quán. Hệ thống này cho phép mô hình MiniMax-H3 tạo ra các video mô phỏng có độ chân thực cao dựa trên các quy tắc logic được lập trình sẵn.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

VGI-BENCH: Đánh giá khả năng suy luận thị giác trong các mô hình tạo video

VGI-bench là bộ tiêu chuẩn mới gồm 27 tác vụ giúp đánh giá chuyên sâu khả năng suy luận thị giác của các mô hình tạo video hiện nay. Kết quả cho thấy ngay cả những mô hình mạnh nhất cũng chưa đạt hiệu suất ổn định, chỉ dừng lại ở mức 51%.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 47/100

Recuris: Cơ chế 'kép' giúp AI thông minh hơn trong các tác vụ dài hạn

If you maintain a skill library for long-horizon agents, this one is worth your time. (bookmark it) …

DịchRecuris tối ưu hóa khả năng xử lý của AI bằng cách tách biệt bộ nhớ làm việc và bộ nhớ kinh nghiệm, giúp mô hình đưa ra quyết định dựa trên trạng thái nhiệm vụ thay vì lịch sử dữ liệu thô. Giải pháp này cải thiện đáng kể tỷ lệ thành công trên các tác vụ phức tạp và giảm tới 80% lỗi thường gặp.

Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (654 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “nghiên cứu AI” — Trang 20 | AIHOT.vn