04/09

Thứ Sáu · 3 tin

03/09

Thứ Năm · 1 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

MULTI3IR: Bộ tiêu chuẩn mới đánh giá khả năng truy xuất thông tin đa chiều và đa phương thức

Multi^3IR là bộ tiêu chuẩn đánh giá khả năng truy xuất thông tin cho các truy vấn mở, đa góc nhìn trên nhiều lĩnh vực. Nghiên cứu cũng giới thiệu SPIN, phương pháp tối ưu hóa giúp giảm độ lệch đơn chiều và cải thiện độ chính xác cho các mô hình truy xuất hiện nay.

02/09

Thứ Tư · 1 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Cơ chế thống trị dân chủ: Kỹ thuật đồng thuận động thông qua mô hình động lực học hệ thống

Nghiên cứu giới thiệu khung Kỹ thuật Đồng thuận Động (DCE), kết hợp lý thuyết PR của Edward Bernays với mô hình động lực học hệ thống để phân tích cách các thể chế chính trị xây dựng và duy trì sự thống trị thông qua thuật toán và dữ liệu.

30/08

Chủ Nhật · 3 tin
Rohan Paul@rohanpaul_ai
Hướng dẫnĐiểm AI 49/100

Lượng token trên OpenRouter tăng vọt 75 lần chỉ trong thời gian ngắn

Investors and most public are still thinking in normal percentage-growth terms while AI usage are co…

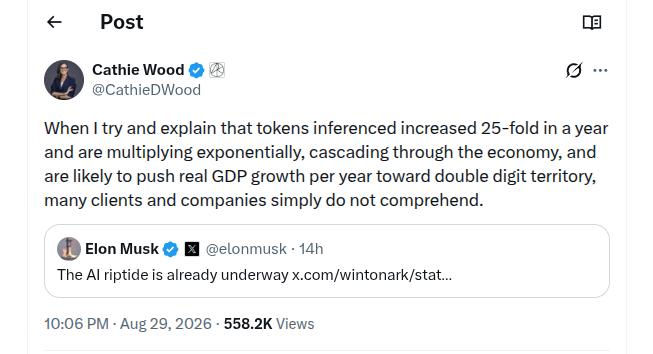
DịchLưu lượng token trên OpenRouter tăng trưởng theo cấp số nhân, gấp 25 lần trong năm 2025 và tiếp tục tăng gấp 3 lần vào đầu 2026. Cathie Wood nhận định xu hướng này có thể thúc đẩy GDP tăng trưởng hai con số, dù nhiều doanh nghiệp vẫn chưa bắt kịp tốc độ thay đổi.

cb_doge@cb_doge
Hướng dẫnĐiểm AI 37/100

Lưu lượng tìm kiếm của Grok tăng vọt, 99,5% đến từ người dùng tự nhiên

Grok's web search traffic is exploding. 🚀 U.S. search visits surged 64.62% year over year to 7.33 …

DịchLưu lượng truy cập tìm kiếm của Grok tại Mỹ tăng 64,6% trong tháng 7, đạt 7,33 triệu lượt. Đáng chú ý, 99,53% lượng truy cập này là tự nhiên, cho thấy sức hút thực tế của sản phẩm mà không cần dựa vào quảng cáo trả phí.

29/08

Thứ Bảy · 1 tin
Kim@kimmonismus
Hướng dẫnĐiểm AI 50/100

OpenAI ngừng hợp tác với Cursor vì lo ngại rủi ro chưng cất dữ liệu

interesting detail to OpenAI ending its Cursor deal: Their real concern is probably distillation. O…

DịchOpenAI quyết định chấm dứt quyền truy cập trực tiếp vào các mô hình của mình đối với Cursor từ ngày 12/11 do lo ngại rủi ro chưng cất dữ liệu (knowledge distillation), tương tự như trường hợp của xAI.

28/08

Thứ Sáu · 3 tin
Thinking Machines@thinkymachines
Nghiên cứuĐiểm AI 35/100

Đột phá: Mô hình Text-to-SQL đầu tiên vượt qua chuẩn đánh giá của con người

Cleaning data and aligning the reward function for RLVR takes expertise and effort upfront, but the …

DịchThinking Machines cùng các nhà nghiên cứu đã tích hợp đánh giá chuyên gia vào quy trình RLVR, tạo ra mô hình Text-to-SQL đầu tiên đạt hiệu suất vượt trội so với con người trong các tác vụ phức tạp.

Elvis Saravia@omarsar0
Hướng dẫnĐiểm AI 39/100

Điểm chuẩn NEEDLE: Các API tìm kiếm AI đang bị trùng lặp lỗi nghiêm trọng

Recommend read. Search APIs can look different while returning the same wrong results. This is a pr…

DịchNghiên cứu từ NEEDLE cho thấy các công cụ tìm kiếm như Brave, You và Parallel có tỷ lệ trùng lặp lỗi từ 70-90%. Điều này cảnh báo rằng việc kết hợp nhiều API không giúp cải thiện độ chính xác nếu các nguồn dữ liệu không thực sự độc lập.

27/08

Thứ Năm · 1 tin

26/08

Thứ Tư · 6 tin

25/08

Thứ Ba · 2 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 68/100

Kiểm toán sự thay đổi câu trả lời trong hệ thống RAG khi cập nhật kho dữ liệu

Nghiên cứu chỉ ra rằng việc cập nhật kho dữ liệu có thể khiến hệ thống RAG thay đổi câu trả lời dù các thiết lập khác không đổi. Tác giả đề xuất phương pháp 'kiểm toán tương thích snapshot' để đo lường mức độ biến động này, giúp tăng độ tin cậy cho các hệ thống AI truy xuất thông tin.

23/08

Chủ Nhật · 1 tin
Greg Brockman@gdb
Hướng dẫnĐiểm AI 28/100

Tốc độ bùng nổ của AI Agent: Xử lý hơn 10 tỷ token mỗi tuần

agentic adoption has been super fast, easy to forget how far the field has come

DịchSự phát triển của AI Agent đang tăng tốc chóng mặt. Nếu như một năm trước, việc xử lý 10 tỷ token mỗi năm đã là một cột mốc đáng nể, thì nay con số này đã được thực hiện chỉ trong một tuần.

22/08

Thứ Bảy · 1 tin

21/08

Thứ Sáu · 3 tin
Thariq@trq212
Sản phẩmĐiểm AI 39/100

Fable ra mắt tính năng bảo mật dữ liệu cấp doanh nghiệp

we're launching new Fable safeguards for enterprises that work on your infrastructure so you have co…

DịchFable giới thiệu Safeguards, tính năng cho phép doanh nghiệp tự quản lý vị trí lưu trữ và quyền truy cập dữ liệu trên hạ tầng riêng. Giải pháp này đã được thử nghiệm với 100 đối tác và dự kiến triển khai rộng rãi vào mùa thu này.

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 34/100

Aaron Swartz bị truy tố vì cào dữ liệu, còn Meta lại bình an vô sự: Sự bất công trong kỷ nguyên AI

Sự đối lập giữa cái chết của Aaron Swartz vì tải 70GB tài liệu và việc Meta thản nhiên dùng 80TB sách để huấn luyện AI cho thấy tiêu chuẩn kép đáng báo động của hệ thống pháp luật.

OpenAI Developers@OpenAIDevs
Sản phẩmĐiểm AI 37/100

Plugin Exa mới giúp ChatGPT và Codex truy cập hơn 100 tỷ trang web và tài liệu

Give ChatGPT Work and Codex access to 100B+ websites, papers, docs, and more with the new @ExaAILabs…

DịchPlugin @ExaAILabs vừa ra mắt, cho phép ChatGPT và Codex khai thác dữ liệu từ hơn 100 tỷ trang web, bài báo khoa học và tài liệu chuyên sâu, giúp tăng cường độ chính xác cho các phản hồi.

20/08

Thứ Năm · 2 tin
Greg Brockman@gdb
Sản phẩmĐiểm AI 39/100

Cùng sự kiệnOpenAI ra mắt tính năng xử lý an toàn riêng tư mới cho doanh nghiệp

we are committed to business privacy, and we're working on technical and policy approaches to benefi…

DịchOpenAI giới thiệu Private Safety Processing giúp tăng cường nhận diện rủi ro mà không cần truy cập vào nội dung gốc, đảm bảo quyền riêng tư tối đa cho khách hàng doanh nghiệp.

Cùng sự kiện, bài đại diện «OpenAI ra mắt Private Safety Processing: Bảo mật tối đa với cam kết không lưu trữ dữ liệu»

19/08

Thứ Tư · 3 tin
Elvis Saravia@omarsar0
Hướng dẫnĐiểm AI 29/100

Đừng làm AI nếu bạn không kiểm soát dữ liệu đầu vào

If you aren't looking at the data, you aren't doing AI at all. It was true before and continues to…

DịchViệc bỏ qua khâu kiểm duyệt dữ liệu dẫn đến thất bại trong huấn luyện mô hình. Bài học từ thực tế cho thấy, việc phát hiện lỗi định dạng và dữ liệu rác giúp cải thiện đáng kể hiệu suất mô hình thay vì chỉ thử nghiệm mù quáng.

18/08

Thứ Ba · 4 tin
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 36/100

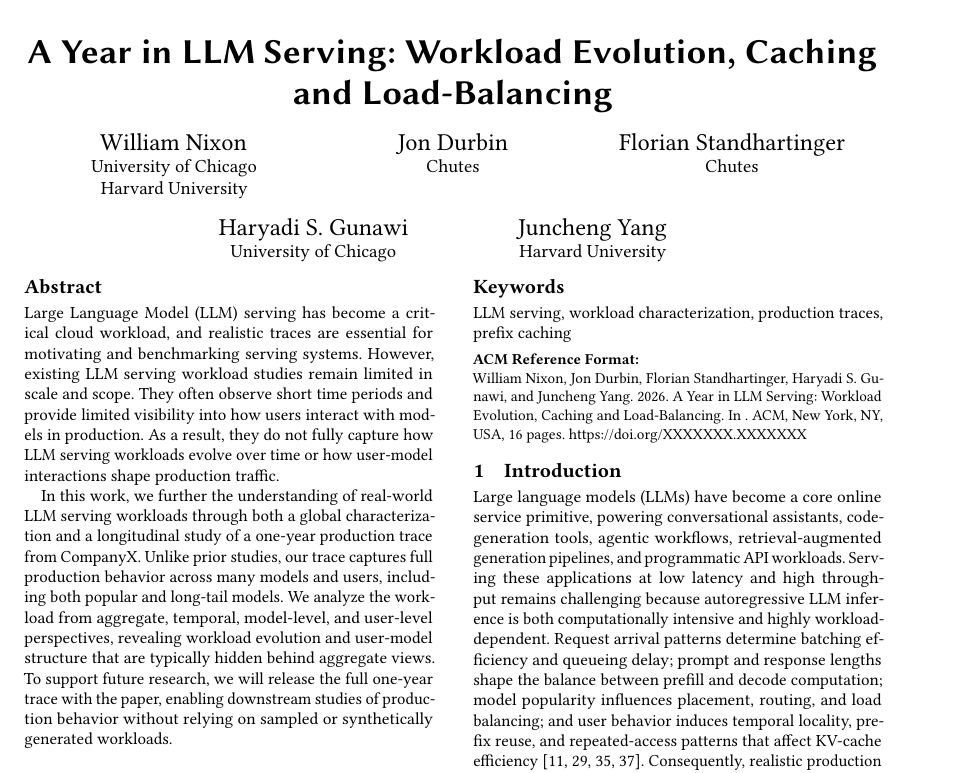
Nghiên cứu từ Harvard & Chicago: Phân tích tải thực tế của dịch vụ LLM trong một năm

New Harvard+Chicago study. A year of production data shows that efficient LLM serving depends less …

DịchPhân tích hơn 6 tỷ yêu cầu cho thấy hiệu suất LLM phụ thuộc vào việc tận dụng các truy vấn lặp lại trong 15 phút thay vì chỉ dựa vào bộ lập lịch đơn thuần. Nghiên cứu đề xuất tối ưu hóa định tuyến và bộ nhớ đệm dựa trên dữ liệu lịch sử thay vì các bài kiểm tra giả lập.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 37/100

GitSkills: Bộ dữ liệu khổng lồ với 3,8 triệu kỹ năng cho AI Agent

Recommended resource. Largest dataset of agent skills I've come across. Great for mining cool ideas …

DịchGitSkills tổng hợp 3,8 triệu tệp kỹ năng từ hơn 280.000 kho lưu trữ trên GitHub, cung cấp nguồn tài nguyên quý giá để nghiên cứu và phát triển các mô hình thiết kế cho AI Agent.

17/08

Thứ Hai · 2 tin

16/08

Chủ Nhật · 1 tin
Rohan Paul@rohanpaul_ai
Hướng dẫnĐiểm AI 36/100

Dùng dữ liệu công cộng để huấn luyện AI: Các công ty có nên buộc phải mở mã nguồn?

Fair point indeed from @naval: If AI companies (Anthropic/OpenAI) train on the open web, perhaps t…

DịchRohan Paul và Naval Ravikant đề xuất rằng các công ty AI như OpenAI hay Anthropic nên có nghĩa vụ mở mã nguồn mô hình sau 12 tháng nếu dữ liệu huấn luyện được lấy từ internet công cộng, nhằm tránh sự độc quyền về tri thức.

14/08

Thứ Sáu · 5 tin
Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (48 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Dữ liệu” — Trang 2 | AIHOT.vn