04/09

Thứ Sáu · 46 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 40/100

WorldReward: Phương pháp đánh giá mô hình thế giới dựa trên VLM cho video AI

WorldReward là mô hình phần thưởng dựa trên VLM giúp đánh giá đồng bộ tính nhất quán của hành động và chất lượng hình ảnh trong các mô hình thế giới. Phương pháp này vượt trội hơn GPT-4o trong các bài kiểm tra thực tế, hỗ trợ tối ưu hóa hiệu quả cho quá trình huấn luyện RL.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 51/100

Tái tư duy về chưng cất mô hình On-Policy: Chỉ cần một mẫu dữ liệu là đủ?

Nghiên cứu khám phá vai trò của dữ liệu trong chưng cất mô hình (OPD), chứng minh rằng chỉ với một truy vấn duy nhất, mô hình có thể cải thiện hiệu suất liên tục qua hàng trăm bước và đạt được phần lớn lợi ích so với việc dùng toàn bộ tập dữ liệu.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 45/100

Terminal-Universe: Biến dấu vết AI Agent thành môi trường thực thi chuyên nghiệp

Terminal-Universe tái tạo không gian làm việc từ lịch sử thao tác của AI, cho phép khôi phục và mở rộng các tác vụ cũ thành môi trường thử nghiệm mới, giúp tối ưu hóa việc huấn luyện và đánh giá khả năng của AI Agent.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 45/100

Environment Evolution: Phương pháp tiến hóa môi trường giúp Agent đầu cuối học tập liên tục

Nghiên cứu đề xuất phương pháp tiến hóa môi trường bằng cách tăng dần độ khó theo thế hệ, tạo tín hiệu học tập bền vững cho quá trình huấn luyện các Agent đầu cuối.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 37/100

CORE: Phương pháp chưng cất mô hình đa phương thức giúp tối ưu hóa khả năng suy luận kết hợp cho mô hình nhúng

Nghiên cứu giới thiệu CORE, kỹ thuật sử dụng mô hình đa phương thức làm bộ sắp xếp lại (reranker) để chưng cất khả năng suy luận kết hợp vào các mô hình nhúng thông qua mục tiêu Rank-KL và danh sách ứng viên tổng hợp.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 66/100

Nghiên cứu Trace as State: Thay đổi vị trí suy luận giúp tăng độ chính xác cho ngữ cảnh dài lên tới 50 điểm

Great tips on working with reasoning models. Normally you would append what the model figured out a…

DịchNghiên cứu mới đề xuất đặt các bước suy luận trước khối ngữ cảnh dài thay vì để ở cuối, giúp mô hình tận dụng thông tin dẫn dắt để xử lý tài liệu hiệu quả hơn, cải thiện đáng kể độ chính xác.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnLatentPress: Đột phá nén ngữ cảnh trực tiếp vào không gian tiềm ẩn của AI

LatentPress giới thiệu phương pháp nén tài liệu và lịch sử hội thoại thành các token bộ nhớ liên tục, cho phép mô hình AI đọc trực tiếp mà không cần giải mã văn bản, giúp tăng hiệu suất xử lý dữ liệu dài gấp 4-16 lần.


Vì sao đáng đọc: Đây là nghiên cứu quan trọng về tối ưu hóa bộ nhớ cho LLM, giải quyết bài toán nén ngữ cảnh hiệu quả hơn hẳn các phương pháp truyền thống như tóm tắt văn bản hay OCR.
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 44/100

Nghiên cứu từ Stanford: Kỹ thuật Prefix Sliding giúp tăng tốc suy luận AI gấp 3 lần mà không cần huấn luyện lại

New Stanford paper Prefix Sliding shows that long reasoning does not need the full chain of thought …

DịchPhương pháp Prefix Sliding cho phép mô hình AI lược bỏ các token suy luận trung gian, chỉ giữ lại tiền tố nhiệm vụ và cửa sổ trượt gần nhất, giúp tối ưu hóa tốc độ suy luận gấp 3 lần mà không làm giảm hiệu suất.

AK@_akhaliq
Nghiên cứuĐiểm AI 24/100

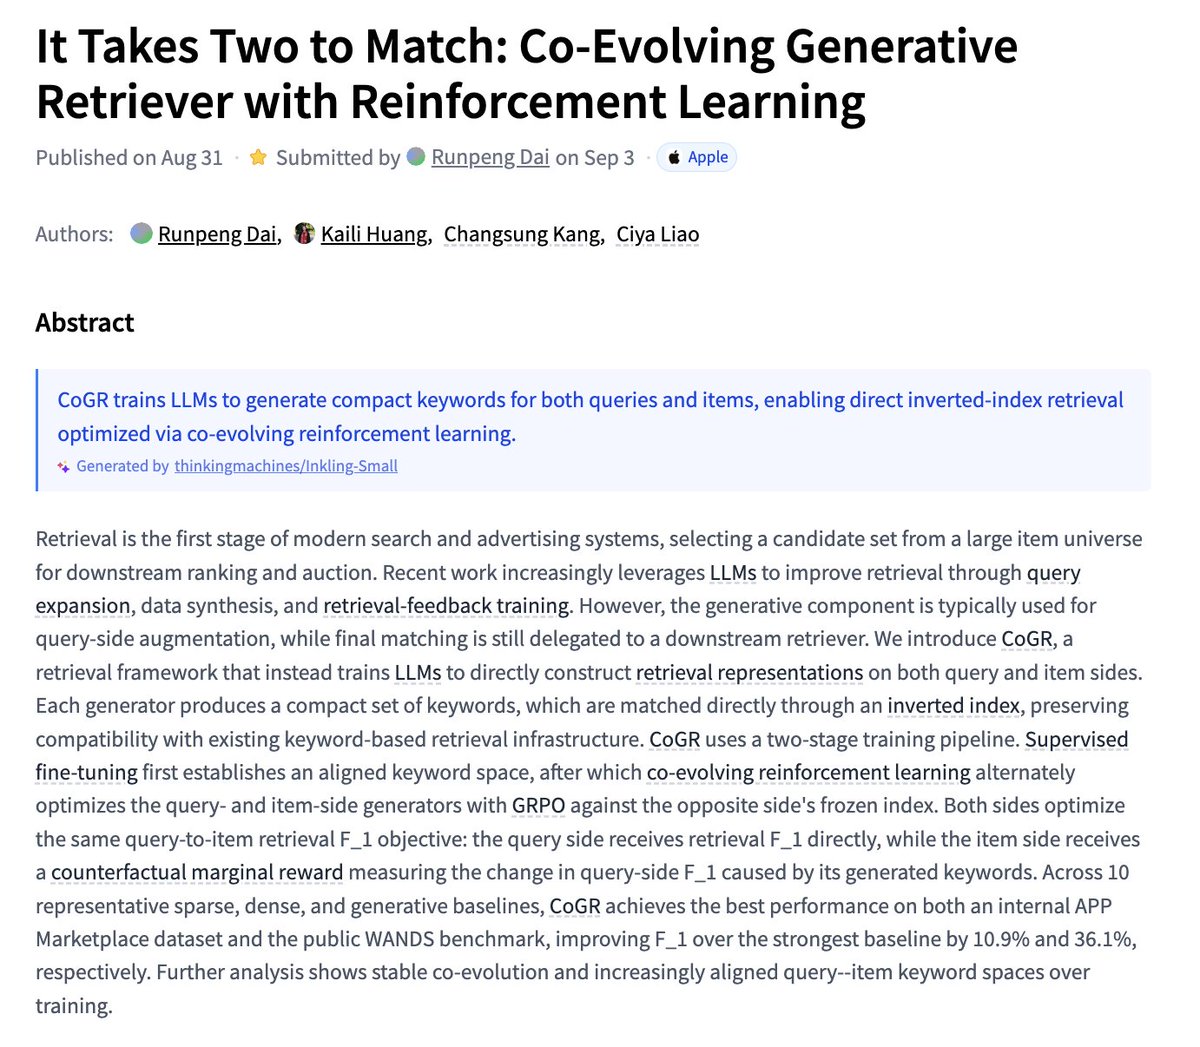
CoGR: Bước tiến mới trong tối ưu hóa truy vấn bằng học tăng cường

It Takes Two to Match Co-Evolving Generative Retriever with Reinforcement Learning paper: https://...

DịchNghiên cứu giới thiệu CoGR, phương pháp huấn luyện LLM đồng bộ hóa từ khóa giữa truy vấn và sản phẩm thông qua học tăng cường (GRPO), giúp cải thiện đáng kể hiệu suất tìm kiếm so với các phương pháp truyền thống.

AK@_akhaliq
Nghiên cứuĐiểm AI 24/100

HarnessDev: Đánh giá khả năng tự xây dựng và tiến hóa Agent của các mô hình ngôn ngữ lớn

HarnessDev Can LLMs Create and Evolve Their Own Agent Harness? paper: https://huggingface.co/paper...

DịchHarnessDev là bộ tiêu chuẩn mới đánh giá khả năng tự tạo và tối ưu hóa hạ tầng thực thi của LLM. Kết quả cho thấy các Agent tự xây dựng vẫn thua kém giải pháp thủ công, đồng thời khả năng tự tiến hóa còn thiếu ổn định và khó chuyển đổi giữa các mô hình khác nhau.

AK@_akhaliq
Nghiên cứuĐiểm AI 26/100

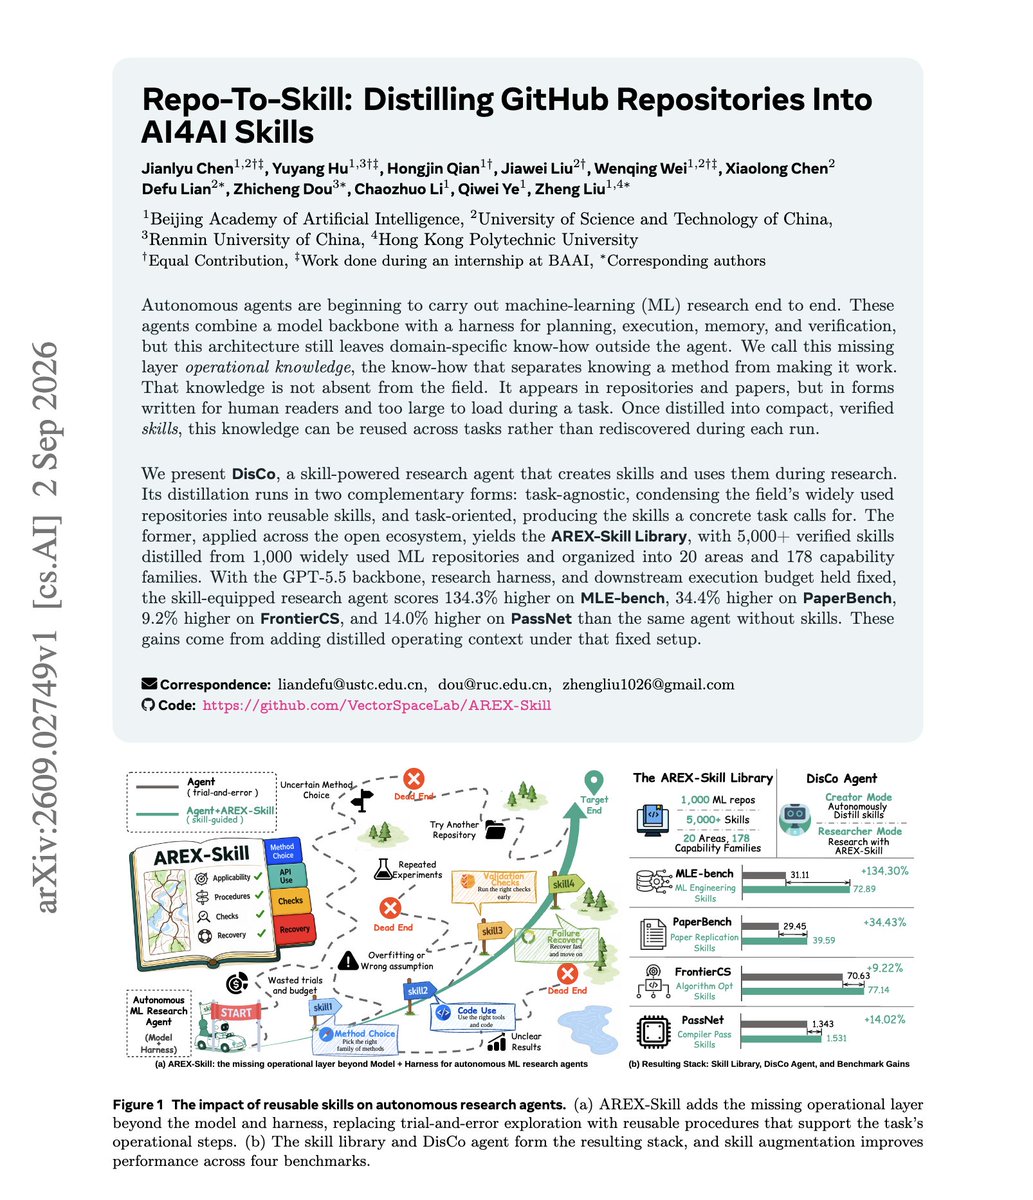
Repo-To-Skill: Nghiên cứu mới về cách chắt lọc kho lưu trữ GitHub thành kỹ năng cho AI

Repo-To-Skill Distilling GitHub Repositories Into AI4AI Skills paper: https://huggingface.co/paper...

DịchNghiên cứu Repo-To-Skill giới thiệu phương pháp chắt lọc dữ liệu từ các kho lưu trữ GitHub để huấn luyện và nâng cao kỹ năng chuyên biệt cho các mô hình AI (AI4AI).

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 42/100

Microsoft và UCSD giới thiệu TailSFT: Loại bỏ dữ liệu quá khớp để tối ưu hóa học tăng cường (RL)

New Microsoft plus Univ of San Diego paper shows a model can look better after SFT but actually be a…

DịchNghiên cứu chỉ ra rằng việc tinh chỉnh (SFT) quá mức có thể xóa bỏ các hành vi hiếm gặp nhưng quan trọng, khiến mô hình trở thành điểm khởi đầu kém hiệu quả cho quá trình học tăng cường (RL).

Kim@kimmonismus
Hướng dẫnĐiểm AI 57/100

Cùng sự kiệnARC-AGI 3 đã đạt ngưỡng bão hòa: Cần thiết lập bộ tiêu chuẩn đánh giá mới ngay lập tức

The lesson from today: we need new benchmarks asap.

DịchTác giả của ARC-AGI 3 xác nhận bộ tiêu chuẩn này đã không còn đủ thách thức cho các mô hình AI hiện nay, đồng thời kêu gọi cộng đồng sớm xây dựng các bài kiểm tra năng lực mới.

Cùng sự kiện, tinh chọn hiển thị «ARC-AGI-3 bị chinh phục chỉ sau 6 tháng, tốc độ phát triển AI vượt xa dự đoán»
Emad Mostaque@EMostaque
Hướng dẫnĐiểm AI 27/100

Emad Mostaque: Cần sớm công bố các thành tựu toán học do con người dẫn dắt

If you are sitting 🪑 on a human led result in mathematics how can you not release it asap It's cle…

DịchCựu CEO Stability AI cho rằng các nghiên cứu toán học nên được công bố nhanh chóng, đồng thời tin tưởng AI thế hệ mới sẽ sớm giải quyết mọi bài toán lý thuyết có thể kiểm chứng.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 46/100

SPACE: Phương pháp mới giúp AI Agent giảm 78,9% số lần gọi LLM nhờ phân đoạn hành động thông minh

Brilliant paper on long-horizon agents. They cut 78.9% of an agent's LLM calls while raising its su…

DịchNghiên cứu SPACE giới thiệu cách tối ưu hóa hành động cho AI Agent thông qua việc học các kỹ năng phân cấp, giúp giảm đáng kể tần suất gọi LLM trong các tác vụ dài hạn mà vẫn duy trì hiệu suất cao.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Sparse Readout Prism: Giải mã Logit-Lens thông qua các đặc trưng thay vì token

Nghiên cứu giới thiệu Sparse Readout Prism (SRP), một phương pháp phân tích mới giúp tách biệt cấu trúc giải mã của mô hình ngôn ngữ khỏi dữ liệu huấn luyện, cho phép hiểu rõ cách các đặc trưng ẩn tạo nên dự đoán thay vì chỉ nhìn vào các token đơn thuần.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 45/100

Google DeepMind giới thiệu Declarative Attention: Tối ưu hóa bộ nhớ KV cache cho mô hình ngôn ngữ

Great weekend read. https://x.com/omarsar0/status/2095612805496164801?s=20

DịchCác nhà nghiên cứu từ KAIST và Google DeepMind đề xuất phương pháp Declarative Attention, cho phép mô hình tự kiểm soát cơ chế chú ý để giảm tải việc đọc KV cache, giúp tăng hiệu suất xử lý.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 44/100

Google DeepMind và KAIST giới thiệu Declarative Attention: Cho phép mô hình tự kiểm soát phạm vi chú ý

Banger paper from Google DeepMind and colleagues. (bookmark it) A model reads its entire KV cache …

DịchNghiên cứu mới từ Google DeepMind và KAIST đề xuất phương pháp Declarative Attention, giúp các mô hình ngôn ngữ tự điều chỉnh cơ chế chú ý trong quá trình suy luận chuỗi, từ đó cải thiện độ chính xác.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Sử dụng mô hình ngôn ngữ nhỏ làm giám khảo cho học tăng cường dựa trên tiêu chí

Nghiên cứu đánh giá khả năng thay thế các mô hình lớn bằng các mô hình ngôn ngữ nhỏ (như Qwen3-1.7B) để làm giám khảo chấm điểm trong học tăng cường, giúp giảm chi phí tính toán mà vẫn đảm bảo độ chính xác.

Microsoft Research@MSFTResearch
Hướng dẫnĐiểm AI 17/100

Microsoft Research ra mắt series về thực tập sinh: Khám phá hệ thống AI tự hành

Where can curiosity take a research career? Undergraduate research intern Matheus Kunzler Maldaner…

DịchTập đầu tiên của series 'Research | Start Here' giới thiệu hành trình nghiên cứu về hệ thống AI tự hành (agentic systems) của thực tập sinh Matheus Kunzler Maldaner tại Microsoft Research.

03/09

Thứ Năm · 36 tin
DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 45/100

BAAI ra mắt DisCo: Chuyển hóa kho mã nguồn GitHub thành kỹ năng cho AI nghiên cứu

Banger paper from BAAI. If you are building research agents, this one is worth your time. (bookmar…

DịchBAAI giới thiệu DisCo, phương pháp chưng cất 1.000 kho mã nguồn ML thành thư viện kỹ năng AREX, giúp các tác nhân AI (AI Agents) nâng cao đáng kể hiệu suất giải quyết các nhiệm vụ nghiên cứu phức tạp.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 46/100

LLAMIA: Phương pháp mới giúp LLM phối hợp hiệu quả với các tác nhân phi ngôn ngữ

Nghiên cứu giới thiệu LLAMIA-Bench với 6 nhiệm vụ cờ vua, đồng thời đề xuất kỹ thuật nội tại hóa trạng thái tiềm ẩn, cho phép LLM tích hợp trực tiếp biểu diễn của các tác nhân chuyên biệt vào luồng token.

JiQiZhiXin
Nghiên cứuĐiểm AI 88/100

Tinh chọnEASE: Khi mô hình AI trả lời đúng nhưng 'nhìn nhầm' ảnh - Giải pháp từ Đại học Công nghệ Cáp Nhĩ Tân

Nghiên cứu giới thiệu EASE, phương pháp giúp mô hình đa phương thức không chỉ trả lời đúng mà còn phải 'nhìn' đúng vào vùng dữ liệu bằng chứng trên ảnh, giúp cải thiện đáng kể độ tin cậy của các mô hình VLM.


Vì sao đáng đọc: Giải quyết vấn đề cốt lõi trong suy luận đa phương thức (VLM) là 'đoán mò' thay vì hiểu ảnh. Phương pháp thực tiễn, có số liệu kiểm chứng rõ ràng trên các mô hình Qwen.
Thomas Wolf (Hugging Face đồng sáng lập/CSO)@Thom_Wolf
Hướng dẫnĐiểm AI 42/100

Nhà toán học đơn giản hóa chứng minh của Claude về các điểm không của hàm Zeta

great mathematicians still lead on taste

DịchNhà toán học Youness Lamzouri đã đơn giản hóa chứng minh của Claude về các điểm không của hàm Zeta, chứng minh hơn 67,25% điểm không nằm trên đường tới hạn bằng các bất đẳng thức không gian Hilbert thay vì ma trận. Thomas Wolf nhận định đây là minh chứng cho thấy con người vẫn dẫn đầu về tư duy.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Autoregressive Mosaics: Giải mã khả năng tư duy không gian 2D của các mô hình ngôn ngữ thuần văn bản

Nghiên cứu giới thiệu AM-Bench để đánh giá liệu LLM hiểu bố cục không gian hay chỉ đơn thuần là chuyển đổi mô tả thành mã nguồn. Kết quả cho thấy khả năng tư duy không gian thực sự khác biệt đáng kể giữa các mô hình, vượt xa khả năng viết code đơn thuần.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 44/100

ContextPilot: Tối ưu hóa quản lý ngữ cảnh cho AI bằng học tăng cường (RL)

Long-running agents do not just need a bigger context window. They need to learn what deserves to st…

DịchContextPilot là phương pháp mới giúp AI chủ động quản lý bộ nhớ thông qua việc tự quyết định lưu trữ, nén hoặc xóa dữ liệu cũ, sử dụng học tăng cường để tối ưu hóa hiệu quả xử lý.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 47/100

LoopArena: Benchmark mới đánh giá khả năng điều phối của AI trong các tác vụ lập trình dài hạn

A strong coding model is not enough if the model managing its work does not know when to redirect, v…

DịchLoopArena là bộ tiêu chuẩn mới giúp đánh giá hiệu quả của các mô hình AI khi đóng vai trò 'Controller' điều phối các tác vụ lập trình phức tạp, thay vì chỉ tập trung vào khả năng viết code đơn lẻ.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Cùng sự kiệnSnapBench: Bộ tiêu chuẩn đánh giá khả năng truy xuất đa phương thức cho tương tác di động

SnapBench là bộ tiêu chuẩn đầu tiên đánh giá độ bền của các mô hình AI khi người dùng chụp ảnh và đặt câu hỏi trên thiết bị di động, giải quyết các vấn đề về ảnh mờ hoặc lỗi nhập liệu văn bản thông qua 1.145 truy vấn thực tế.

Cùng sự kiện, bài đại diện «MULTI3IR: Bộ tiêu chuẩn mới đánh giá khả năng truy xuất thông tin đa chiều và đa phương thức»
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 62/100

Nghiên cứu thực nghiệm: Rủi ro khi dùng tài liệu Markdown để điều khiển hành vi của Claude Code

Claude Code plugins have a maintenance problem that normal code tooling barely sees: the Markdown fi…

DịchNghiên cứu trên 8.500 plugin cho thấy 74% các thay đổi được gắn nhãn 'tài liệu' thực chất là mã lệnh điều khiển runtime của Claude. Điều này gây ra sự thiếu đồng bộ nghiêm trọng giữa tài liệu hướng dẫn và logic thực thi của AI.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 52/100

Nghiên cứu DuMateBench: Khung Agent quyết định tới 27% hiệu suất của cùng một mô hình AI

New Stanford and other top research lab paper shows that the framework around an LLM can change agen…

DịchDuMateBench giới thiệu bộ tiêu chuẩn đánh giá AI Agent qua 200 tác vụ thực tế phức tạp, từ lập trình đến sáng tạo nội dung, giúp đo lường khả năng xử lý lỗi và môi trường thực tế của các mô hình.

Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (49 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Nghiên cứu AI” — Trang 15 | AIHOT.vn