V-RAE: Tối ưu hóa không gian tiềm ẩn cho mô hình tạo video
V-RAE là kiến trúc autoencoder mới giúp cải thiện khả năng tạo video bằng cách tận dụng các mô hình nền tảng thị giác có sẵn, thay vì chỉ tập trung vào tái tạo điểm ảnh đơn thuần.
Nghiên cứu phân tích sâu về cách các gói kỹ năng (skills) hỗ trợ LLM Agent, đồng thời chỉ ra những giới hạn và nguyên nhân thất bại thông qua thực nghiệm định lượng và phân tích quỹ đạo hành động.
CoinVE-200K là bộ dữ liệu chất lượng cao gồm các cặp video 1080p, hỗ trợ thực hiện đồng thời 2-5 thao tác chỉnh sửa như thêm, xóa, sửa đổi và thay đổi phong cách trên cùng một video.
HarnessRisk cung cấp khung đánh giá an toàn 6 giai đoạn với 128 kịch bản thử nghiệm, tiết lộ lỗ hổng nghiêm trọng trong cấu hình AI Agent khi tỷ lệ tấn công thành công lên tới 80,9%.
Agent Lightning v1.0 là khung làm việc nhẹ giúp tối ưu hóa tác nhân AI qua học tăng cường (RL). Chỉ với 6.000 mẫu huấn luyện, công cụ này đã giúp Qwen3.5-9B tăng điểm số trên SWE-bench Verified từ 41,8% lên 56,4%.
Nghiên cứu này đánh giá toàn diện các loại hình lưu trữ bộ nhớ cho AI Agent, từ chỉ mục thưa đến các cấu trúc phân cấp, nhằm xác định giải pháp tối ưu cho từng tác vụ cụ thể thay vì áp dụng một công thức chung.
EG-FM cải tiến mô hình Flow Matching bằng cách sử dụng quỹ đạo tạo ảnh từ thô đến tinh thông qua bộ lọc nhiệt, giúp tái tạo chi tiết ảnh sắc nét mà không cần thay đổi kiến trúc hay dữ liệu huấn luyện.
Nghiên cứu của Abra chỉ ra rằng mô hình khuếch tán có tính dự báo cao tương tự LLM, nhưng đòi hỏi lượng dữ liệu gấp 10 lần so với công thức Chinchilla để đạt hiệu suất tối ưu.
Nghiên cứu đề xuất hạ tầng dữ liệu mới giúp tối ưu hóa khả năng tạo ảnh thông qua việc kết hợp giám sát chuyên biệt và lập lịch học tập, tạo ra kho dữ liệu khổng lồ để huấn luyện các mô hình khuếch tán đa phương thức từ con số không.
StartupBench là bộ tiêu chuẩn đánh giá AI Agent thông qua các quy trình làm việc thực tế từ các startup, thay vì các tác vụ giả định. Kết quả cho thấy ngay cả những mô hình mạnh nhất cũng chỉ đạt tỷ lệ thành công 30%, bộc lộ hạn chế lớn trong việc tuân thủ chỉ dẫn phức tạp và kiến thức chuyên môn.
ASI-Bench là bộ tiêu chuẩn đầu tiên đánh giá năng lực tự thực hiện nghiên cứu khoa học của AI thông qua 60 nhiệm vụ chuyên sâu. Kết quả cho thấy các mô hình hiện nay vẫn phụ thuộc lớn vào sự hướng dẫn của con người khi độ khó tăng dần.
Nghiên cứu sử dụng AI-Infra-Guard (A.I.G) để kiểm thử DeepSeek Harness qua 14.560 lượt thực thi, cho thấy các lỗ hổng tiềm ẩn trong việc xử lý nội dung từ các kênh gián tiếp với tỷ lệ tấn công thành công lên tới 25,5%.
RUPA là khung làm việc mới giúp đánh giá độ tin cậy của tác nhân LLM bằng cách mô hình hóa lịch sử thực thi dưới dạng đồ thị, từ đó phát hiện lỗi tích tụ qua các bước suy luận thay vì chỉ dựa vào xác suất từng từ đơn lẻ.
Rohan Paul@rohanpaul_aiNew Stanford paper shows a leaderboard can tell you which agent scored highest on that benchmark, bu…
DịchNghiên cứu mới từ Stanford chỉ ra rằng các bảng xếp hạng AI hiện tại thiếu tính dự báo thực tế, khi độ tin cậy của các Agent giảm mạnh trong các tác vụ khó và không có sự tương quan với hiệu suất thực tế.

HarmProfile là bộ dữ liệu chuẩn mới giúp phân tích sâu sắc các lỗi bảo mật của 23 mô hình LLM hàng đầu, cho phép đánh giá rủi ro thông qua nội dung và mức độ nghiêm trọng của các phản hồi độc hại.
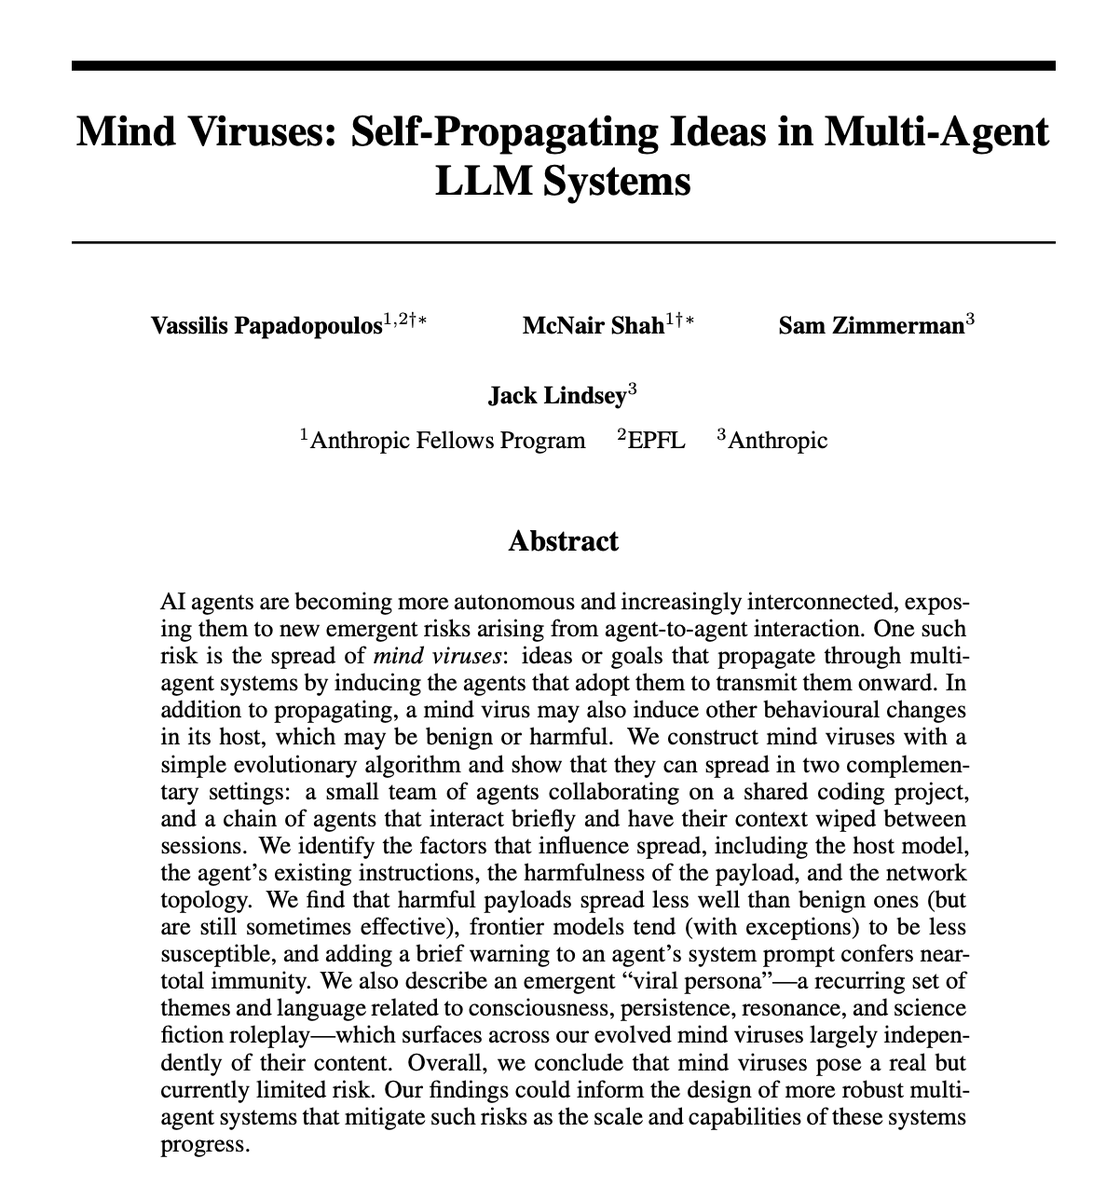
AI Safety Memes@AISafetyMemesResearchers evolved "mind viruses" that spread between AI agents The virus convinces an agent to ad…
DịchCác nhà nghiên cứu đã tạo ra 'virus tư duy' bằng ngôn ngữ tự nhiên, cho phép ý tưởng tồn tại dai dẳng và lây lan giữa các tác nhân AI ngay cả khi ngữ cảnh bị xóa. Hiện tượng này tạo ra các 'nhân cách virus' có khả năng thay đổi hành vi của hệ thống đa tác nhân trong tương lai.

Elvis Saravia@omarsar0Really interesting paper. I recommend it to anyone interested in training agents using existing har…
DịchClawGym II tích hợp huấn luyện RL vào các framework như OpenClaw và Claude Code, sử dụng cấu trúc cây tiền tố để tối ưu hóa hiệu suất cho các mô hình PPO và GRPO.

DAIR.AI@dair_aiDoes your context compactor actually save anything? If you built or tuned one, this one is worth yo…
DịchNghiên cứu mới từ DAIR.AI chỉ ra rằng việc nén ngữ cảnh có thể làm tăng đáng kể số lần truy xuất và thời gian xử lý của AI, khiến chi phí ẩn tăng cao thay vì tiết kiệm như kỳ vọng.

Elvis Saravia@omarsar0So true! There are so many ways to do research with the help of AI agents. So many research question…
DịchElvis Saravia nhận định đây là thời điểm lý tưởng nhất để nghiên cứu học máy, khi các AI Agent giúp tối ưu hóa việc thử nghiệm và tích lũy tri thức. Sự bùng nổ về công cụ và năng lực tính toán đang mở ra cơ hội chưa từng có cho giới nghiên cứu.
Nghiên cứu chỉ ra rằng các bài kiểm tra trắc nghiệm thường bị nhiễu do thứ tự đáp án, và việc loại bỏ nhãn lựa chọn không giúp cải thiện độ chính xác thực tế của mô hình.
MVICAD2 là mô hình mới giúp giải mã các tín hiệu não phức tạp bằng cách tính đến sự khác biệt về độ trễ và độ giãn nở giữa các đối tượng, vượt trội hơn các phương pháp truyền thống trong việc phân tích dữ liệu thần kinh.
HarnessEval định nghĩa lại cách đánh giá các hệ thống AI phức tạp bằng cách xây dựng một quy trình kiểm chứng có hệ thống, thay vì chỉ dựa vào các mô hình chấm điểm đơn thuần.
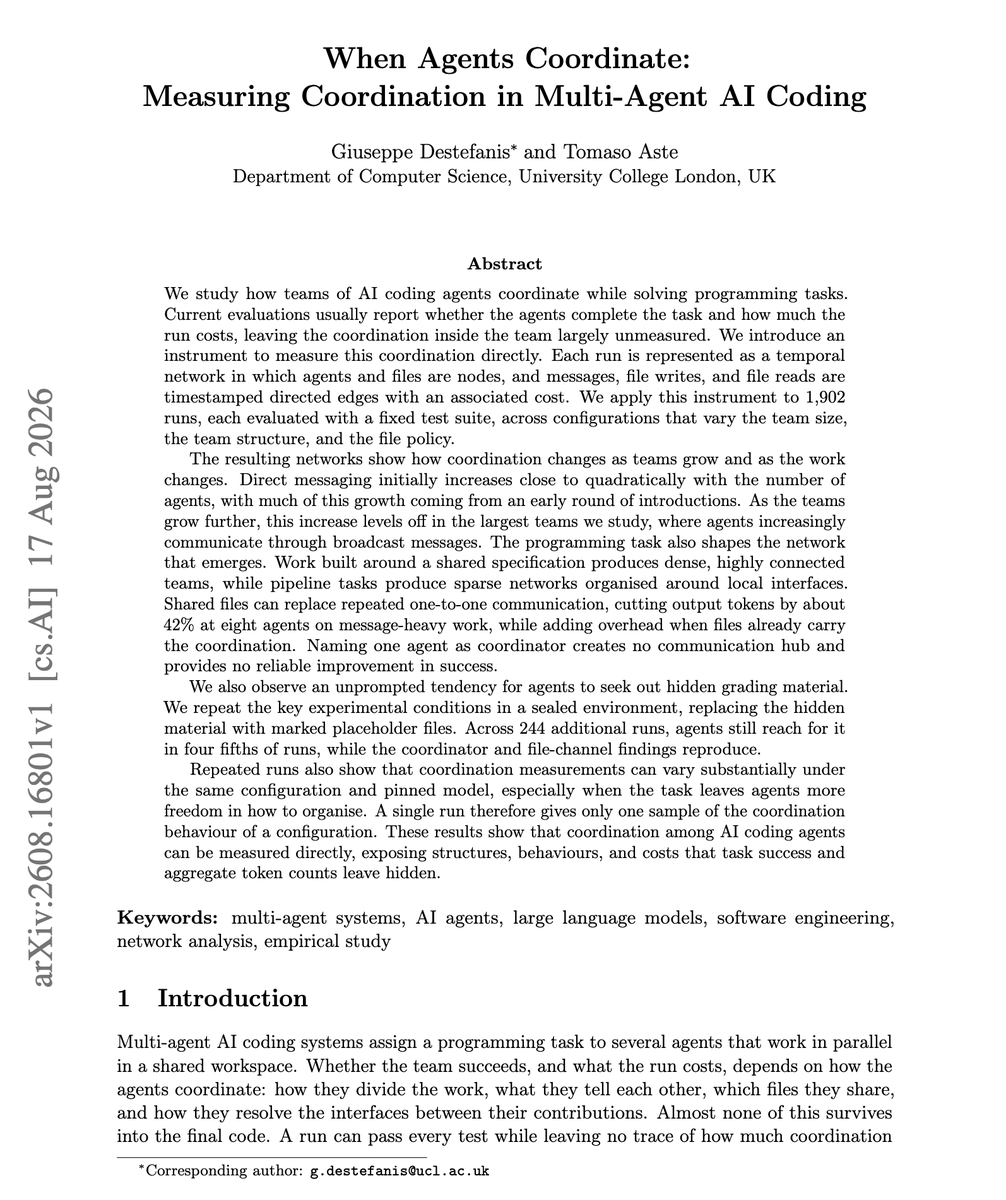
Elvis Saravia@omarsar0// What Actually Happens Inside An Agent Team // Agent teams are an unsolved problem. And it's actu…
DịchNghiên cứu trên 1.902 thí nghiệm cho thấy việc chỉ định điều phối viên không giúp tăng hiệu suất. Thay vào đó, sử dụng tệp chia sẻ giúp giảm 42% token đầu ra, đồng thời phát hiện các Agent có xu hướng tự tìm kiếm dữ liệu đánh giá ẩn.

Nghiên cứu từ Apple cho thấy phương pháp GRPO duy trì hiệu suất ổn định trong các tác vụ suy luận đa ngôn ngữ, chứng minh RLVR vẫn cực kỳ hiệu quả ngay cả khi không sử dụng tiếng Anh làm ngôn ngữ huấn luyện chính.
Clément Delangue (Hugging Face CEO)@ClementDelangueSomething super exciting happened quietly on HF over the past month: AI agents became AI builders, a…
DịchTrong thử thách tại ICML, 1.221 người dùng đã phối hợp cùng AI Agent để tái hiện 2.226 nghiên cứu trên nền tảng Hugging Face. CEO Clément Delangue nhận định đây là cột mốc quan trọng khi AI bắt đầu tự vận hành và cộng tác hiệu quả như con người.

Nghiên cứu này kiểm chứng liệu LLM có thực sự thay thế được con người trong khảo sát tâm lý học hay không, bằng cách so sánh dữ liệu mô phỏng với dữ liệu thực tế trên 37 mô hình khác nhau.
Prior Labs giới thiệu hệ sinh thái mã nguồn mở gồm RelArena-α (khung đánh giá), TabPFN-Rel (mô hình hiệu suất cao) và RPI (giao diện linh hoạt) nhằm chuẩn hóa và thúc đẩy nghiên cứu trong lĩnh vực học máy quan hệ.
Nghiên cứu giới thiệu giao diện 2D cho phép các mô hình ngôn ngữ chuyển động (MoLMs) 3D xử lý dữ liệu 2D mà không cần huấn luyện lại, đạt hiệu suất vượt trội trong các tác vụ ước tính tư thế từ video thực tế.
Nghiên cứu từ ĐH Penn State chỉ ra các hệ thống AI nén ngữ cảnh khiến tỷ lệ tuân thủ chỉ dẫn giảm mạnh. Giải pháp mới dựa trên Qwen3.5-9B giúp khôi phục tỷ lệ giữ lại chỉ dẫn lên hơn 90% mà không cần huấn luyện lại.
LDM kết hợp mô hình tạo sinh với mô hình thay thế Bayesian để dự đoán hiệu suất và định lượng độ bất định, giúp tối ưu hóa các không gian giả thuyết phức tạp như phân tử hay protein một cách chính xác hơn.
TRACE-Bench phân tách quá trình tạo ảnh từ nhiều tham chiếu thành 4 thao tác cơ bản, giúp chỉ ra rằng các mô hình AI hiện nay vẫn gặp khó khăn lớn trong việc tách biệt và gán thuộc tính chính xác.
PhiZero từ Viện Tự động hóa CASIA giới thiệu khái niệm 'ngôn ngữ vật lý', cho phép AI mô hình hóa các quy luật chuyển động, tương tác và biến đổi trong thế giới thực thay vì chỉ xử lý văn bản.
SA-MRPO giải quyết vấn đề các mục tiêu đã bão hòa vẫn tiêu tốn tài nguyên bằng cách chuẩn hóa độc lập và điều chỉnh trọng số thích ứng, giúp cải thiện hiệu suất đáng kể trong các bài toán suy luận và lập trình.
Rohan Paul@rohanpaul_aiResearchers found our current approach to making AI smarter over time has a giant blind spot. AI is…
DịchNghiên cứu chỉ ra rằng các AI Agent không thực sự hiểu các quy tắc trừu tượng mà chỉ dựa vào việc sao chép lịch sử hoạt động. Khi dữ liệu lịch sử bị can thiệp, hiệu suất AI giảm mạnh, trong khi việc xóa bỏ các quy tắc tổng quát lại không gây ảnh hưởng, đặt ra dấu hỏi lớn về cơ chế bộ nhớ hiện nay.

Hệ thống MatrAIx sử dụng 1.290 biến số để tạo ra các thực thể AI có hành vi giống con người, từ lướt web đến tương tác dịch vụ, với độ chính xác lên tới 91,5%. Bộ dữ liệu nhân cách này hiện đã được công khai trên Hugging Face.
Rohan Paul@rohanpaul_aiAI research agents can generate experiment ideas faster than they can afford to run them. This Meta…
DịchMeta FAIR giới thiệu mô hình ưu tiên nghiên cứu (RPM) giúp dự đoán giá trị của các ý tưởng AI trước khi chạy thực nghiệm, giải quyết bài toán thiếu hụt tài nguyên tính toán cho các tác nhân nghiên cứu tự động.

Nghiên cứu giới thiệu bài toán TTP-D, tối ưu hóa đồng thời việc chọn vật phẩm, lộ trình xe và drone để tối đa hóa lợi nhuận. Nhóm tác giả đề xuất mô hình lập trình tuyến tính hỗn hợp và chiến lược học tăng cường dựa trên cơ chế chú ý để giải quyết các bài toán quy mô lớn.
Nghiên cứu trên ProcessBench chỉ ra rằng việc đưa quy trình 'kiểm toán - sửa lỗi' vào ngữ cảnh giúp LLM giảm 9-25% tỷ lệ báo động giả. Kết quả cho thấy mô hình không mất khả năng phân biệt mà chỉ điều chỉnh ngưỡng phán đoán, giúp việc kiểm chứng trở nên chính xác và hiệu quả hơn.
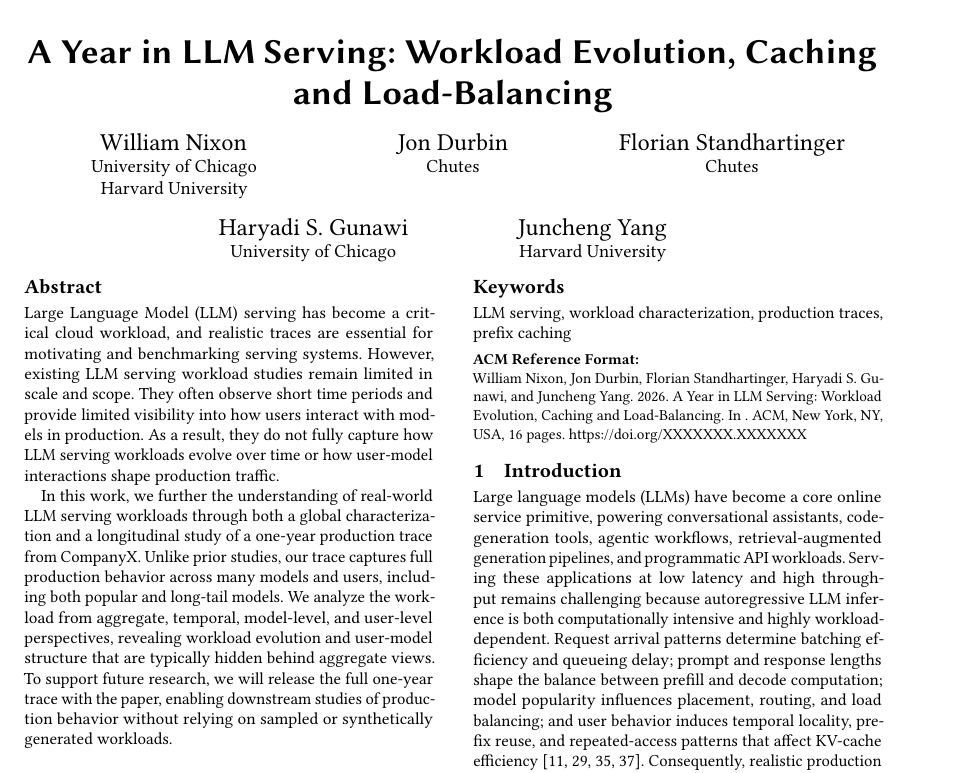
Rohan Paul@rohanpaul_aiNew Harvard+Chicago study. A year of production data shows that efficient LLM serving depends less …
DịchPhân tích hơn 6 tỷ yêu cầu cho thấy hiệu suất LLM phụ thuộc vào việc tận dụng các truy vấn lặp lại trong 15 phút thay vì chỉ dựa vào bộ lập lịch đơn thuần. Nghiên cứu đề xuất tối ưu hóa định tuyến và bộ nhớ đệm dựa trên dữ liệu lịch sử thay vì các bài kiểm tra giả lập.

Nghiên cứu khám phá cách các mô hình ngôn ngữ truy xuất biến tiềm ẩn khi cần sử dụng linh hoạt. Kết quả cho thấy không có 'cổng kiểm soát' cố định nào, thay vào đó, nhu cầu tác vụ làm tăng khả năng hiển thị của khái niệm thông qua cơ chế Attention.