DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 52/100
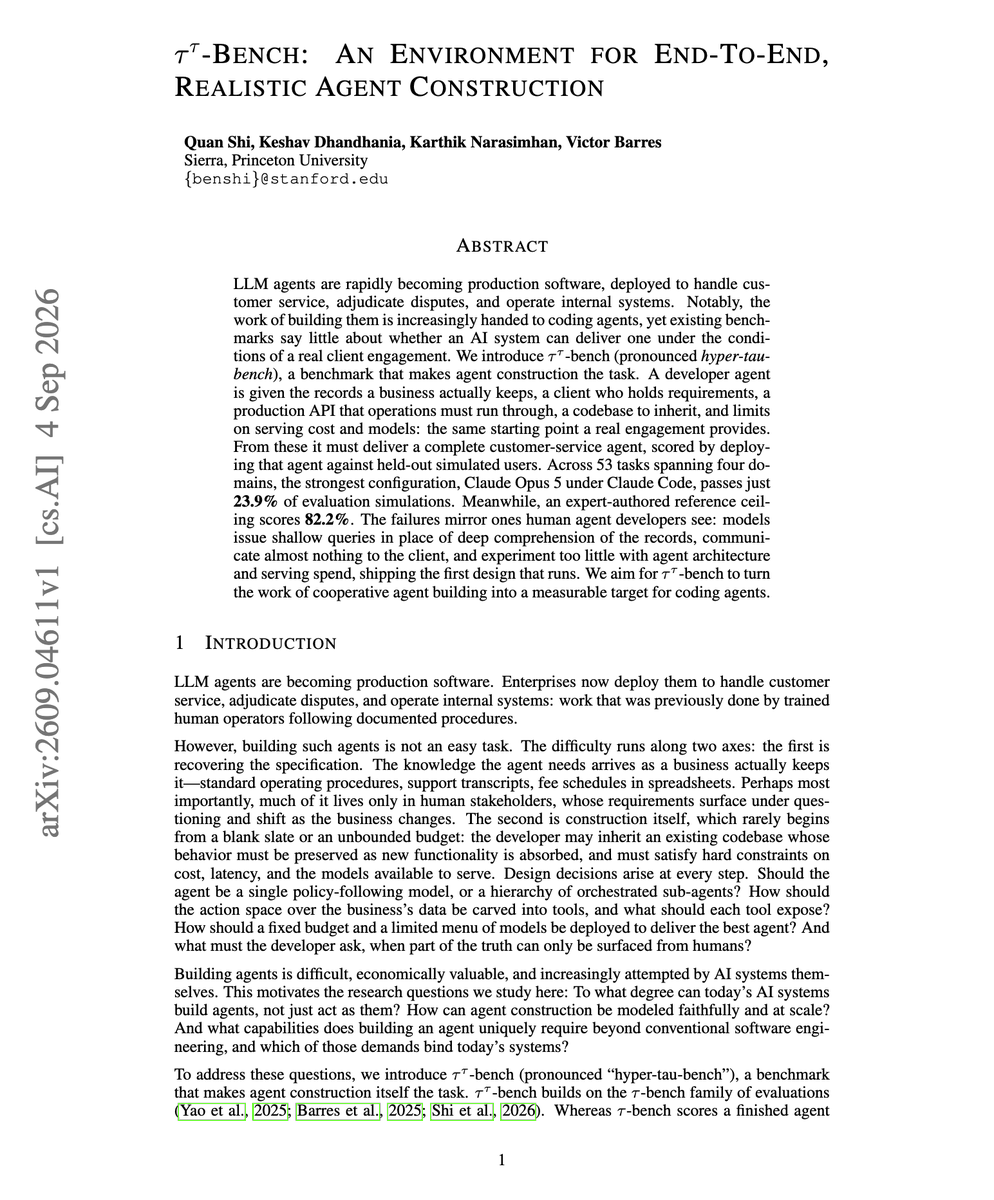
Nghiên cứu τ^τ-Bench: Claude 3.5 Opus chỉ đạt 23,9% khi tự xây dựng AI Agent, trong khi con người đạt 82,2%
Really strong benchmark paper on coding agents. Claude Opus 5 running under Claude Code passes 23.9…
DịchSierra và ĐH Princeton ra mắt τ^τ-Bench, bộ tiêu chuẩn đánh giá khả năng tự xây dựng AI Agent của các mô hình ngôn ngữ. Kết quả cho thấy khoảng cách lớn giữa AI và chuyên gia con người trong việc thiết lập hệ thống chăm sóc khách hàng thực tế.