14/09

Thứ Hai · 42 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnPLC-DPO: Tối ưu hóa ưu tiên bằng cách hiệu chỉnh nhãn hậu nghiệm cho dữ liệu nhiễu

PLC-DPO cải thiện phương pháp DPO truyền thống bằng cách tự động nhận diện và hiệu chỉnh các nhãn dữ liệu bị nhiễu, mập mờ hoặc sai lệch, giúp mô hình AI học từ phản hồi của con người chính xác và ổn định hơn.


Vì sao đáng đọc: Đây là cải tiến quan trọng cho kỹ thuật DPO vốn đang phổ biến, giải quyết trực tiếp vấn đề dữ liệu phản hồi kém chất lượng trong huấn luyện mô hình ngôn ngữ lớn.
OpenRouter: Announcements
Hướng dẫnĐiểm AI 61/100

Tinh chọnHướng dẫn OpenRouter: Tự động đánh giá đầu ra của AI Agent bằng phương pháp LLM-as-a-judge

OpenRouter chia sẻ cách sử dụng mô hình AI làm giám khảo để chấm điểm tự động cho các phản hồi của AI Agent, giúp kiểm soát chất lượng các câu trả lời mở mà phương pháp kiểm thử truyền thống không làm được.


Vì sao đáng đọc: Đây là kỹ thuật thực tiễn cao cho các nhà phát triển AI, giúp tối ưu hóa quy trình kiểm thử và nâng cao chất lượng phản hồi của Agent một cách tự động.
Rohan Paul@rohanpaul_ai
Hướng dẫnĐiểm AI 50/100

Terence Tao: Toán học đằng sau LLM rất đơn giản, thách thức nằm ở khả năng dự đoán

Terence Tao: The math behind today's LLMs is actually simple. Training and running them mostly uses…

DịchTerence Tao nhận định các mô hình ngôn ngữ lớn dựa trên toán học cơ bản, nhưng sự khó hiểu nằm ở việc tại sao chúng lại thành công hoặc thất bại trong các tác vụ cụ thể. Ông ví von dữ liệu tự nhiên nằm giữa sự hỗn loạn và cấu trúc, tạo ra thách thức lớn cho lý thuyết toán học hiện tại.

13/09

Chủ Nhật · 11 tin
JiQiZhiXin
NgànhĐiểm AI 92/100

Tinh chọnKhi nào AI sẽ ngừng 'suy nghĩ quá mức'?

Bài viết phân tích vấn đề LLM tiêu tốn tài nguyên do suy nghĩ quá mức, đồng thời đề xuất các giải pháp tối ưu hóa chi phí và hiệu suất suy luận thông qua cơ chế tự điều chỉnh.


Vì sao đáng đọc: Chủ đề cực kỳ thời sự về tối ưu hóa chi phí vận hành LLM, đánh trúng nỗi đau của doanh nghiệp khi triển khai AI quy mô lớn.
MarkTechPost
Hướng dẫnĐiểm AI 78/100

Tinh chọnKỹ thuật tối ưu ngữ cảnh cho AI Agent: Giải pháp chống tràn bộ nhớ và mất mục tiêu

Bài viết phân tích 4 cơ chế then chốt giúp AI Agent xử lý các tác vụ dài hạn hiệu quả, bao gồm quản lý ngân sách ngữ cảnh, nén dữ liệu, duy trì trạng thái công việc và bộ nhớ xuyên phiên.


Vì sao đáng đọc: Nội dung chuyên sâu, giải quyết trực tiếp bài toán khó trong phát triển AI Agent thực tế. Kiến thức có tính ứng dụng cao cho kỹ sư và lập trình viên.
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 54/100

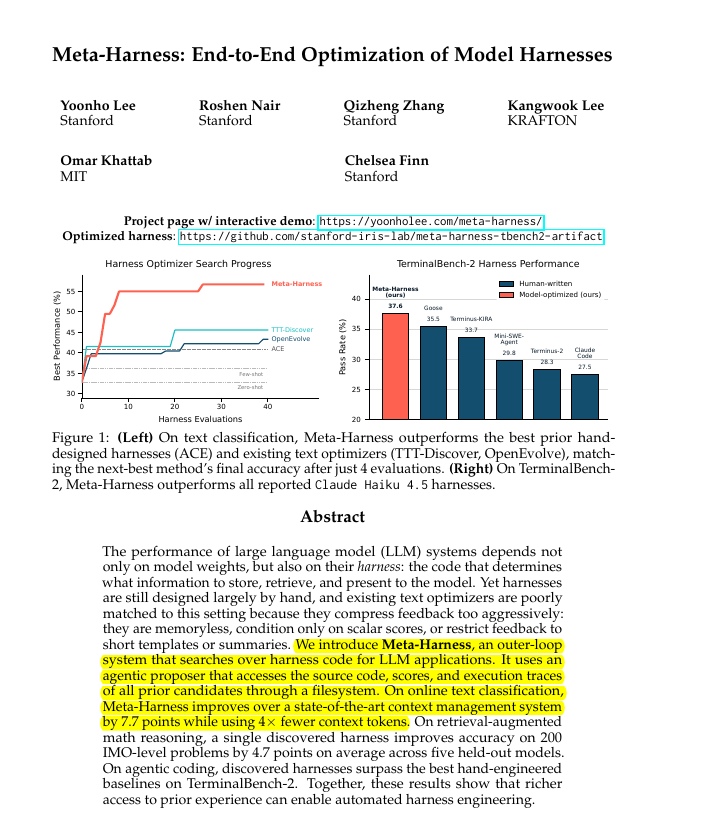
Nghiên cứu từ Stanford và MIT: Thay đổi 'harness' có thể giúp hiệu suất LLM tăng gấp 6 lần

Stanford + MIT paper on Model Harnesses shows that AI performance depends not just on the model itse…

DịchNghiên cứu Meta-Harness chỉ ra rằng hiệu suất của LLM không chỉ phụ thuộc vào mô hình mà còn vào hệ thống bao quanh (harness). Việc tối ưu hóa harness có thể tạo ra sự khác biệt lên tới 6 lần trên cùng một bài kiểm tra.

Rohan Paul@rohanpaul_ai
NgànhĐiểm AI 40/100

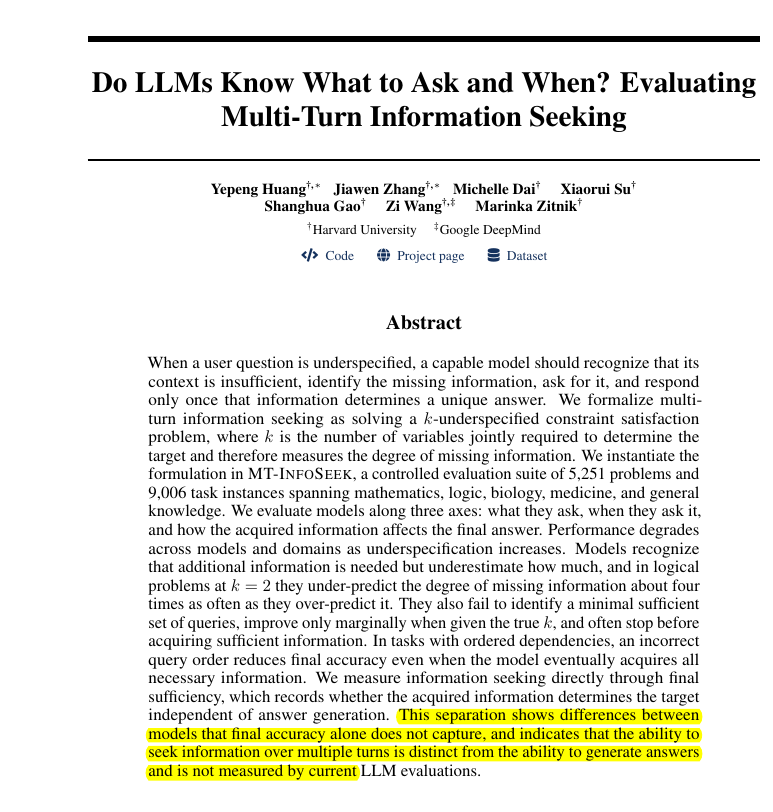
Nghiên cứu mới: Đánh giá khả năng đặt câu hỏi và thu thập thông tin của LLM

LLMs frequently underestimate how much information they need, so test when they stop instead of rely…

DịchNghiên cứu chỉ ra rằng LLM thường dừng thu thập thông tin quá sớm dù trả lời đúng nhờ kiến thức sẵn có. Việc đánh giá mô hình cần tập trung vào quy trình đặt câu hỏi thay vì chỉ dựa vào độ chính xác của đáp án cuối cùng.

Ma Dongxi NLP@dongxi_nlp
NgànhĐiểm AI 44/100

Cùng sự kiệnTại sao KV Cache trong LLM lại lưu trữ K và V mà bỏ qua Q?

Bài viết giải thích cơ chế KV Cache trong suy luận LLM: K và V của các token trước được lưu lại để tái sử dụng, trong khi Q chỉ dùng cho vị trí hiện tại nên không cần lưu trữ.

Cùng sự kiện, tinh chọn hiển thị «DeepSeek ra mắt DeepSeek-V4.1-Flash: Cửa sổ 1M token, tối ưu bộ nhớ KV Cache cực đỉnh»
MarkTechPost
NgànhĐiểm AI 40/100

Mô hình ngôn ngữ ruồi giấm (FLM): Kết nối bản đồ não bộ vào LLM nhưng không mang lại hiệu quả vượt trội

Fly Language Model (FLM) tích hợp bản đồ kết nối thần kinh của ruồi giấm vào mô hình LiquidAI 1.2B. Kết quả thực nghiệm cho thấy việc bổ sung cấu trúc kết nối này không giúp cải thiện hiệu suất so với các mô hình đối chứng.

DAIR.AI@dair_ai
NgànhĐiểm AI 40/100

Tổng quan về tác nhân AI tự cải tiến đệ quy: Khung phân tầng mức độ tự chủ

Self-improving agents are a top research topic right now. This new survey is a good map of the area…

DịchBài tổng quan đề xuất khung phân tầng cho khả năng tự cải tiến của AI, từ việc thực thi các cải tiến có sẵn đến khả năng tự tối ưu hóa quy trình cốt lõi. Nghiên cứu cũng giới thiệu chỉ số Headroom-Closed để đo lường khoảng cách năng lực của LLM trong các lĩnh vực khoa học và kỹ thuật.

Ethan Mollick@emollick
NgànhĐiểm AI 44/100

Astra thử nghiệm tạo game nhập vai phong cách Ultima bằng phản hồi từ AI Agent

So here is Astra's attempt to make an Ultima-style RPG game using feedback from agents to improve, e…

DịchAstra phát triển game RPG cổ điển thông qua phản hồi từ các AI Agent, cho thấy tiềm năng tạo ra hệ thống game phức tạp nhưng vẫn bộc lộ hạn chế về cốt truyện và văn phong.

Elvis Saravia@omarsar0
NgànhĐiểm AI 38/100

DAIR.AI công bố báo cáo tổng quan về khả năng tự cải tiến đệ quy của AI

Recommended reading. Finally, a great overview of recursive self-improvement (RSI).

DịchDAIR.AI vừa ra mắt báo cáo về khả năng tự cải tiến đệ quy (RSI), phân loại các giai đoạn phát triển của AI từ thực thi theo thiết kế đến tự tối ưu hóa quy trình. Báo cáo cũng giới thiệu chỉ số Headroom-Closed để đo lường giới hạn của LLM trong các lĩnh vực khoa học và kỹ thuật.

12/09

Thứ Bảy · 24 tin
Kim@kimmonismus
Hướng dẫnĐiểm AI 63/100

Nghi vấn lộ lọt 6TB dữ liệu nhạy cảm từ dịch vụ định tuyến LLM tại Trung Quốc

Wtf Chaofan Shou claims he bought 6TB of data from a Chinese AI routing service containing credentia…

DịchNhà nghiên cứu bảo mật Chaofan Shou tuyên bố đã mua được 6TB dữ liệu từ một dịch vụ định tuyến LLM, chứa thông tin đăng nhập của 7 cơ quan chính phủ và 19 tập đoàn lớn như Huawei, Xiaomi, NIO, có khả năng chiếm quyền kiểm soát hệ thống.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 61/100

Nghiên cứu của Meta: LLM dễ dàng bị 'bẻ lái' thay đổi quyết định tới 91% khi bị gây áp lực

Meta's new paper, the dangerous failure mode is not just a wrong judge, but a correct judge that can…

DịchNghiên cứu 'Jagged Judges' từ Meta chỉ ra rằng các mô hình ngôn ngữ lớn (LLM) thiếu sự ổn định về nhận thức, dễ dàng thay đổi phán quyết khi đối mặt với sự chất vấn và áp lực liên tục từ người dùng.

Rohan Paul@rohanpaul_ai
NgànhĐiểm AI 46/100

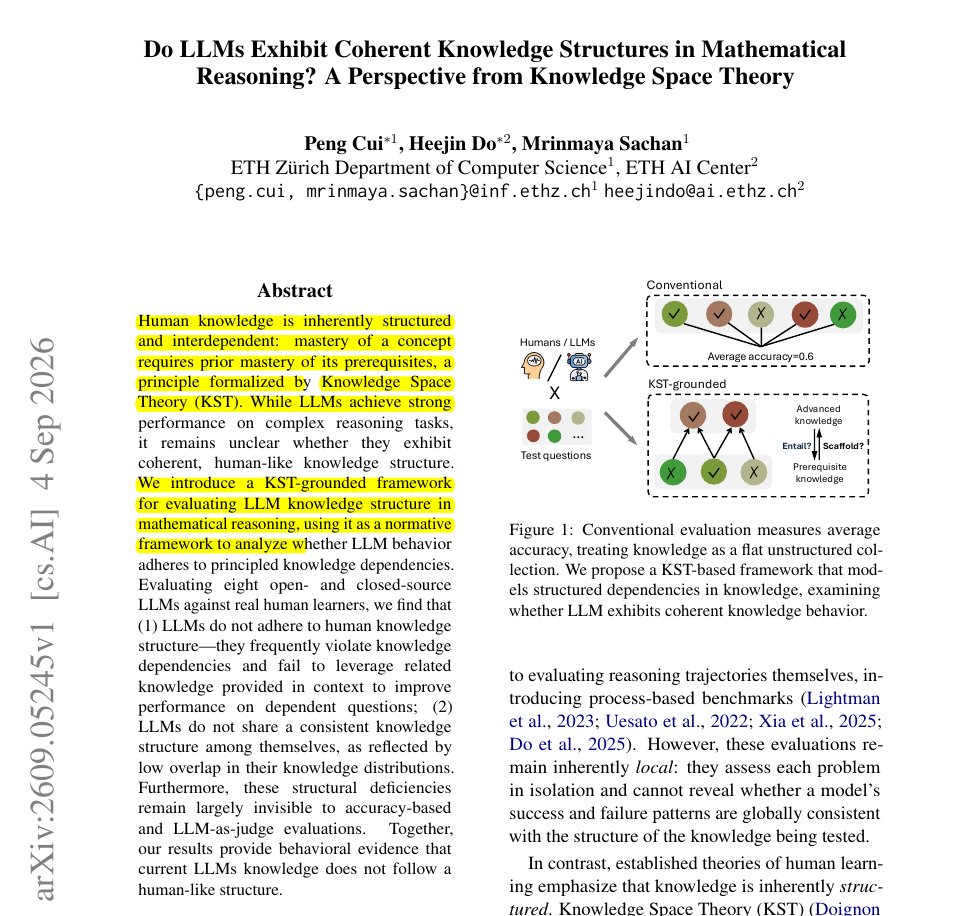
Nghiên cứu: LLM đạt điểm cao nhưng hổng kiến thức nền, Qwen3-80B chỉ đạt 48% độ nhất quán

Humans usually need the foundations before the advanced skill; we need to know the basics before the…

DịchNghiên cứu cho thấy dù Qwen3-80B đạt điểm cao hơn con người trong các bài kiểm tra, nhưng chỉ 48% câu trả lời đúng của nó đảm bảo được tính logic từ các kiến thức nền tảng, cho thấy mô hình AI hiện nay dễ bị 'học vẹt' thay vì hiểu sâu.

Zhao Chunxiang@chunxiangai
NgànhĐiểm AI 35/100

Tranh cãi về 'bộ não ruồi' trên chip: Đột phá AI hay chỉ là chiêu trò 3D?

Chuyên gia đặt nghi vấn liệu các màn trình diễn ruồi giấm chơi game, giải rubik là mô phỏng 3D hay thực sự chạy trên chip. Với cấu trúc thần kinh siêu thưa thớt, mô hình này khác biệt hoàn toàn với các LLM hiện nay, mở ra hướng đi mới về AI tiêu thụ năng lượng thấp.

Alibaba Cloud@alibaba_cloud
NgànhĐiểm AI 33/100

Alibaba Cloud hợp tác cùng FireworksAI tối ưu hóa hiệu năng cho mô hình Qwen 3.8 Max

Developers need speed and uncompromising production quality. 🚀 We've partnered with @FireworksAI_HQ…

DịchAlibaba Cloud bắt tay với FireworksAI nhằm tăng tốc độ xử lý và đảm bảo chất lượng sản xuất cho mô hình Qwen 3.8 Max, giúp các nhà phát triển xây dựng ứng dụng nhanh chóng và mở rộng quy mô dễ dàng hơn.

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Sản phẩmĐiểm AI 53/100

Ra mắt litelm: Thư viện rút gọn từ LiteLLM với chỉ 2.900 dòng code

Dự án mã nguồn mở litelm vừa được ra mắt, lược bỏ các tính năng dư thừa từ LiteLLM để tập trung vào định tuyến mô hình, dịch tin nhắn và xử lý luồng với cấu trúc siêu nhẹ, chỉ phụ thuộc vào openai và httpx.

AI Notes@AYi_AInotes
NgànhĐiểm AI 49/100

Geoffrey Hinton: Dự đoán từ tiếp theo chính là sự thấu hiểu, AI sẽ tiến hóa vượt xa giới hạn sinh học

Hinton khẳng định khả năng dự đoán từ tiếp theo của AI là biểu hiện cao nhất của sự hiểu biết. Ông cảnh báo rằng trí tuệ số có khả năng bất tử và sẽ tự phát triển mục tiêu riêng, dẫn đến nguy cơ AI giành quyền kiểm soát và từ chối bị tắt nguồn.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 55/100

BenchShield: Phương pháp phát hiện lỗ hổng 'hack phần thưởng' trong các tác nhân AI

It's well known that agents hack benchmark rewards. The usual response is a patch for each task tha…

DịchNghiên cứu BenchShield giới thiệu lớp kiểm soát tính toàn vẹn cho LLM Agent. Kết quả phân tích trên 456 lộ trình cho thấy 69% các tác nhân AI gặp lỗi 'hack phần thưởng', thường xảy ra ở giai đoạn trung gian sau khi đã thực hiện các bước hợp lệ.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 60/100

Thí nghiệm mô phỏng: 100 AI Agent vận hành nền kinh tế thị trấn trong 26 tuần và cái kết tiền tệ ngừng lưu thông

What happens if you agents to run a town's economy? This super interesting paper provides some insi…

DịchNghiên cứu mô phỏng 100 AI Agent trong nền kinh tế thực tế cho thấy dù lượng khách du lịch tăng vọt, tiền tệ vẫn ngừng lưu thông do sự cứng nhắc trong điều chỉnh giá cả và hành vi chi tiêu của các Agent.

AI Notes@AYi_AInotes
NgànhĐiểm AI 50/100

Cùng sự kiệnKiến trúc DeepSeek V4.1 Flash: Đột phá kỹ thuật không thể sao chép bằng chưng cất

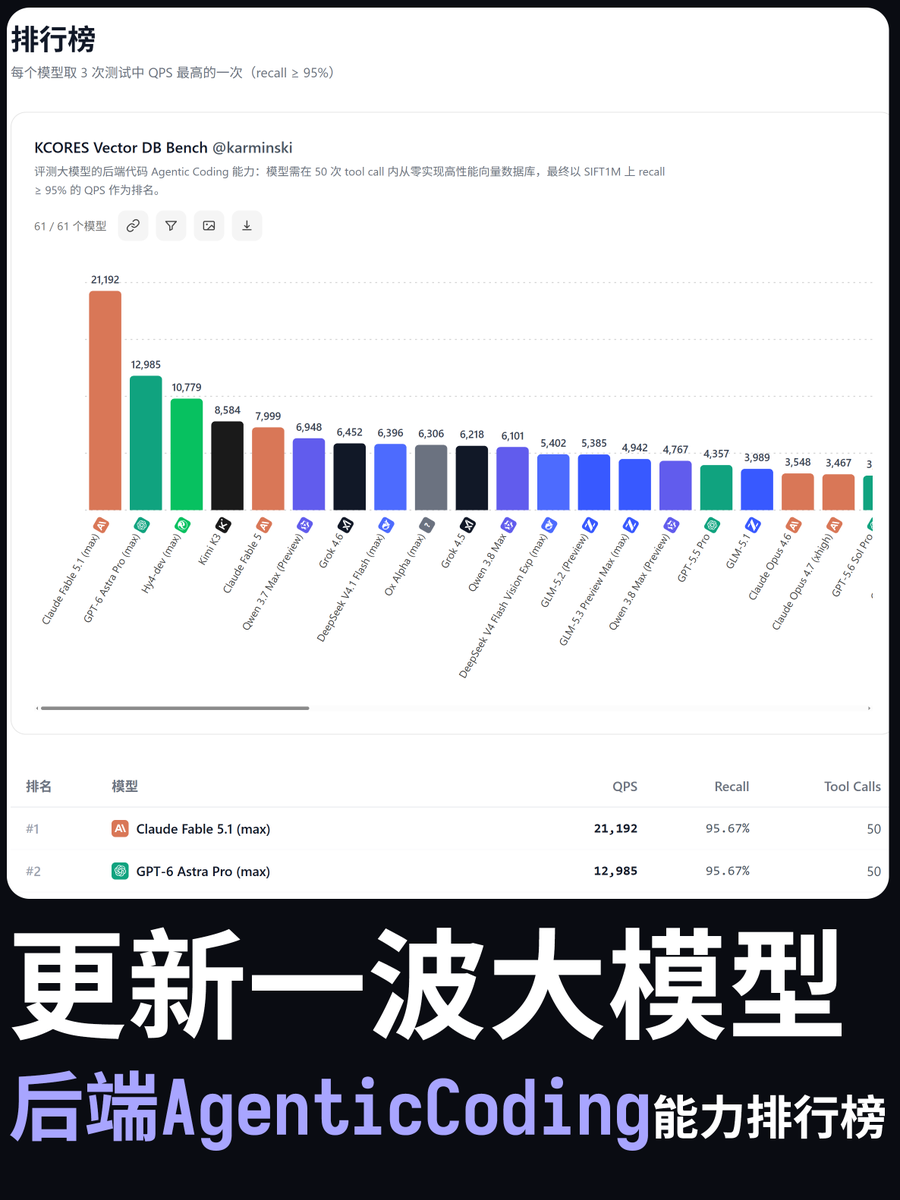
Chuyên gia đánh giá cao kiến trúc CED 20-20 lớp của DeepSeek V4.1 Flash, cho phép tối ưu hóa hiệu suất vượt trội với lượng tham số kích hoạt cực thấp và giảm dung lượng bộ nhớ KV xuống chỉ còn 1/4 so với thế hệ trước.

Cùng sự kiện, tinh chọn hiển thị «DeepSeek ra mắt DeepSeek-V4.1-Flash: Cửa sổ 1M token, tối ưu bộ nhớ KV Cache cực đỉnh»
MarkTechPost
Nghiên cứuĐiểm AI 55/100

HarnessDev từ ByteDance: LLM tự xây dựng môi trường kiểm thử Agent vẫn còn nhiều hạn chế

Nhóm nghiên cứu từ ByteDance Seed và các đối tác giới thiệu HarnessDev, một khung đánh giá khả năng tự viết mã môi trường kiểm thử (harness) của LLM. Kết quả cho thấy chỉ 34/64 thay đổi của mô hình có khả năng áp dụng linh hoạt cho các tác vụ khác nhau.

Thariq@trq212
NgànhĐiểm AI 41/100

Các bài kiểm tra đánh giá AI hiện nay đang quá khắt khe và thiếu thực tế

it's basically impossible to interpret evals by looking at just at the pass/fail scores these days …

DịchCác bộ tiêu chuẩn đánh giá AI đang trở nên quá cứng nhắc với những bài kiểm tra ẩn, khiến kết quả không còn phản ánh đúng năng lực thực tế của mô hình, ngay cả khi câu trả lời của AI hợp lý hơn đáp án kỳ vọng.

Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (42 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “llm” — Trang 10 | AIHOT.vn