 Elon Musk@elonmusk
Mô hìnhĐiểm AI 20/100
Cùng sự kiệnxAI chính thức ra mắt Grok 4.7
Elon Musk và xAI vừa công bố phiên bản Grok 4.7, đánh dấu bước tiến mới trong lộ trình phát triển mô hình ngôn ngữ của hãng.
 Elon Musk@elonmusk
Elon Musk và xAI vừa công bố phiên bản Grok 4.7, đánh dấu bước tiến mới trong lộ trình phát triển mô hình ngôn ngữ của hãng.
Elon Musk@elonmuskElon Musk công bố Grok 4.7, khẳng định mô hình này đạt hiệu suất chỉ đứng sau các dòng của Anthropic theo đánh giá từ Artificial Analysis, trong khi chi phí vận hành chỉ bằng một nửa.
Cùng sự kiện, bài đại diện «Muse Spark chính thức vượt mặt Grok 4.7 trên bảng xếp hạng AI»TypeSafe AI vừa ra mắt Jev, một mô hình 'System One' chuyên biệt trả về điểm số tin cậy thay vì văn bản. Với chi phí cực rẻ chỉ 0,042 USD/triệu token, đây là giải pháp tối ưu cho các tác vụ ra quyết định tự động.
Diễn biến sự kiện · 24 bài →Thêm 3 nguồn khác đưa tin@typesafeaiX: Hongming (@hongming731)X: karminski (@karminski3) Artificial Analysis@ArtificialAnlys
Grok 4.7 is behind only Anthropic models on AA-Briefcase, ranking just behind Opus 5 at ~50% of its …
DịchGrok 4.7 đạt bước tiến lớn trên bảng xếp hạng AA-Briefcase, chỉ đứng sau các mô hình của Anthropic với hiệu suất phân tích vượt trội và chi phí vận hành tối ưu hơn 50% so với Opus 5.

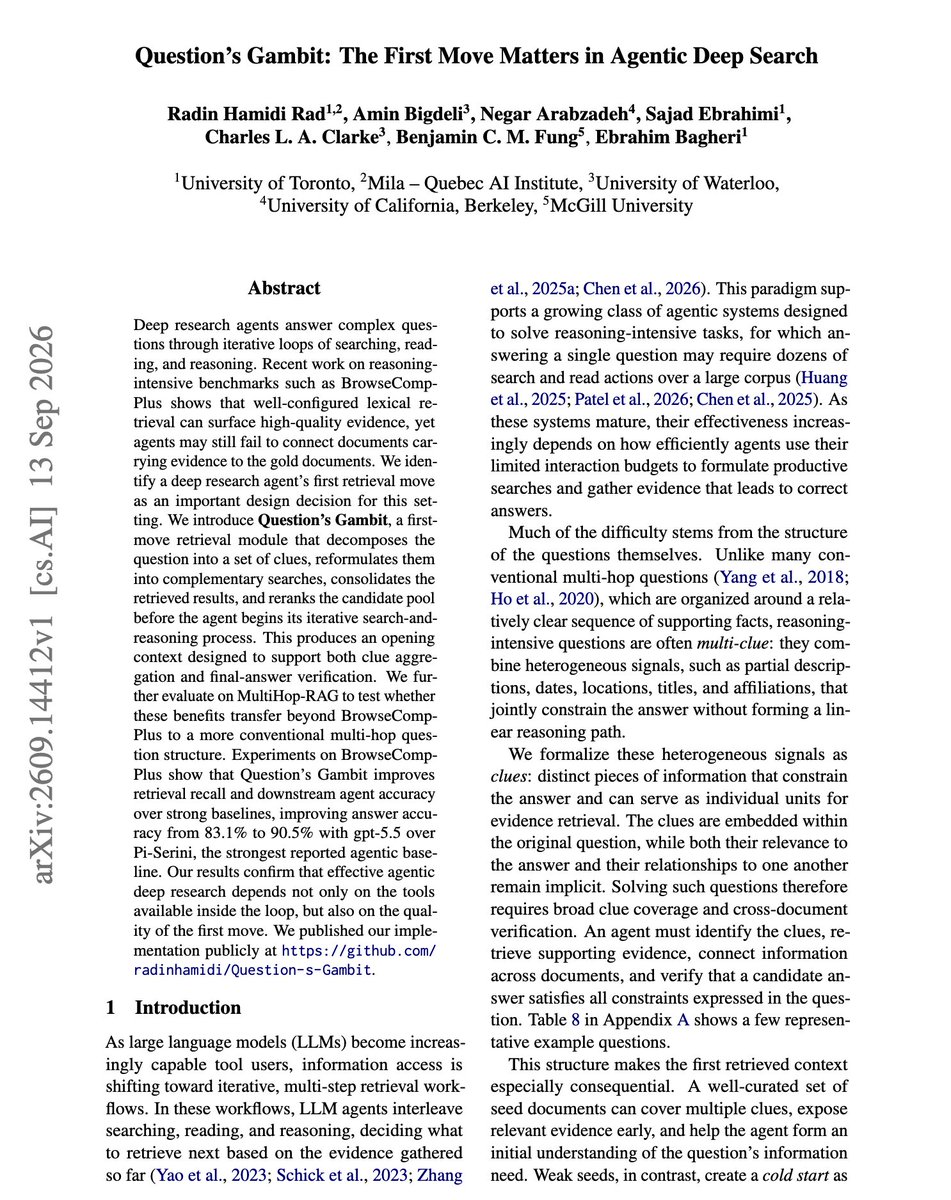
 Elvis Saravia@omarsar0
Impressive paper showing how much the first retrieval step matters for deep research agents. It hel…
DịchPhương pháp mới giúp AI phân tách câu hỏi thành các manh mối bổ trợ và sắp xếp dữ liệu trước khi tìm kiếm, giúp tối ưu hóa ngữ cảnh đầu vào cho các tác vụ nghiên cứu phức tạp.
 Kim@kimmonismus
Damn. I'm late to the party. Plane just arrived in SF: Grok 4.7 looks super amazing! Not only is i…
DịchPhiên bản Grok 4.7 chính thức trình làng với hiệu suất tương đương bản 4.6 nhưng đi kèm các bài kiểm tra đánh giá chi tiết, giúp người dùng dễ dàng so sánh năng lực mô hình.

 Testing Catalog@testingcatalog
XIAOMI 🔥: MiMo-V2.6-Pro and Flash open-source models have been released! MiMo-V2.6-Pro landed on …
DịchXiaomi vừa công bố hai mô hình đa phương thức MiMo-V2.6 Pro và Flash. Trong đó, bản Pro đạt hiệu suất ngang ngửa Claude Opus 5 và GPT-5.6 Sol trên nhiều tiêu chuẩn đánh giá tác nhân AI.

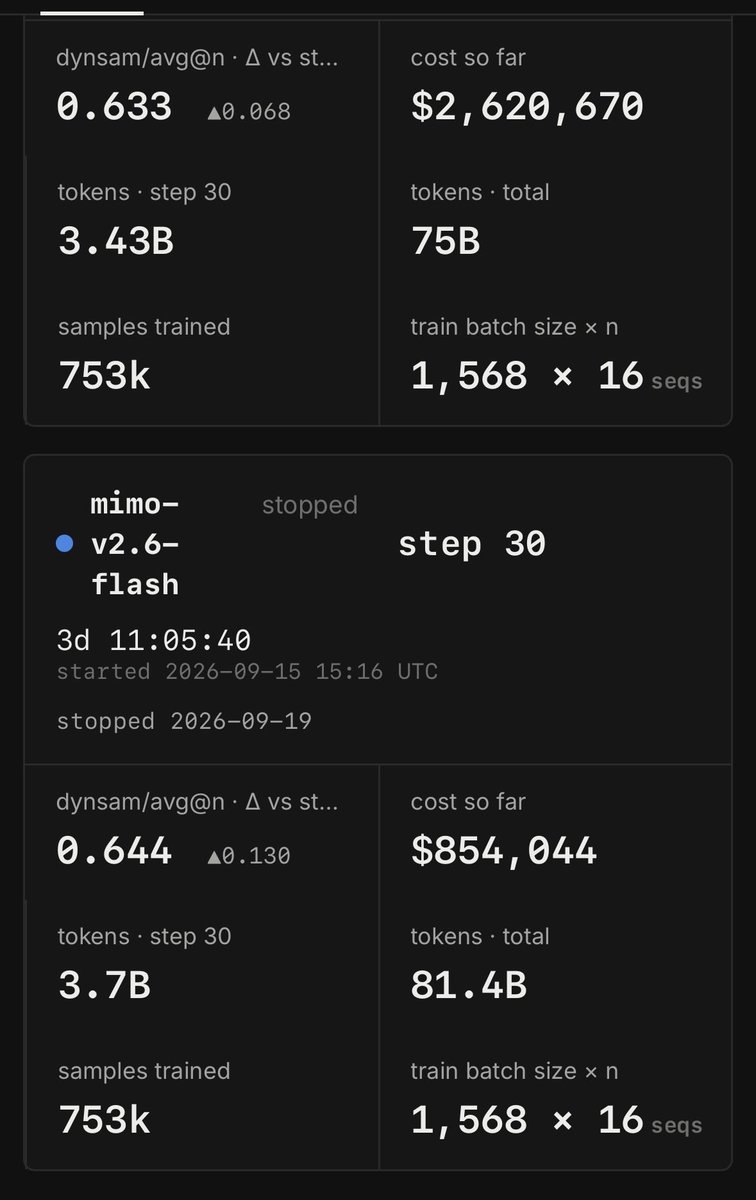
 Ma Dongxi NLP@dongxi_nlp
Xiaomi vừa công bố MiMo-V2.6 với hai phiên bản Pro và Flash, được huấn luyện bằng học tăng cường quy mô lớn. Bản Pro đạt hiệu suất ngang ngửa các mô hình hàng đầu thế giới và hiện dẫn đầu bảng xếp hạng mã nguồn mở, đồng thời hãng cũng đã công khai toàn bộ trọng số, mã nguồn và báo cáo kỹ thuật.
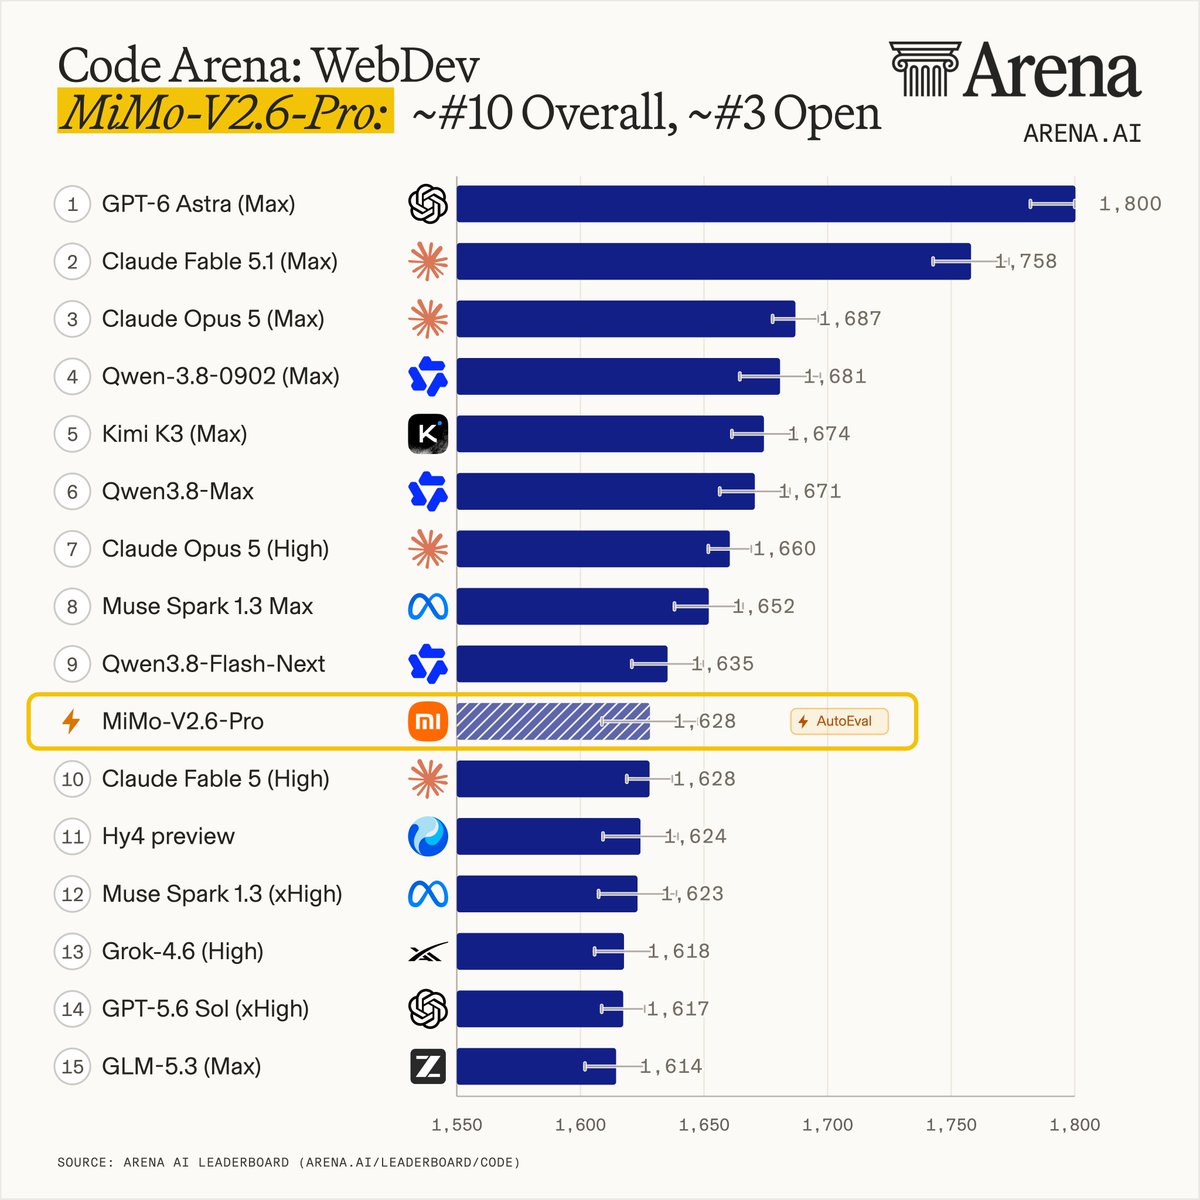
 Arena@arena
MiMo-V2.6-Pro just landed @XiaomiMiMo back in the top 10 on Code Arena: WebDev, debuting at ~#10 ove…
DịchXiaomi vừa trình làng hai mô hình toàn năng MiMo-V2.6-Pro và Flash. Trong đó, MiMo-V2.6-Pro đạt 1628 điểm trên bảng xếp hạng Code Arena, đứng thứ 10 chung cuộc và thứ 3 trong nhóm mô hình mã nguồn mở.
 Nathan Lambert@natolambert
MiMo-V2.6-Pro: 1.02T-42B active MiMo-V2.6-Flash: 310B-15B active Top open model on Artificial Analys…
DịchXiaomi vừa công bố dòng MiMo-V2.6 với các phiên bản Pro và Flash, tập trung vào khả năng tự cải tiến thông qua học tăng cường (RL) quy mô lớn và hỗ trợ cửa sổ ngữ cảnh lên tới 1 triệu token.

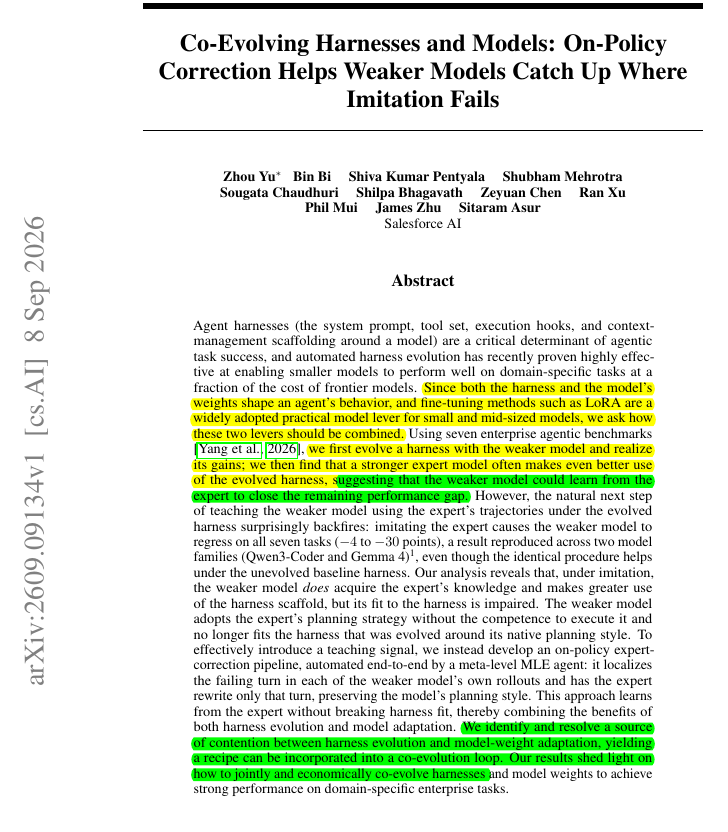
 Rohan Paul@rohanpaul_ai
New Salesforce AI research finds, once you tune an agent's prompts, tools, and workflow around a wea…
DịchSalesforce phát hiện việc tinh chỉnh mô hình Qwen theo quỹ đạo của Gemini khiến hiệu suất giảm từ 78% xuống 63,1% do sự xung đột trong cách lập kế hoạch. Thay vì bắt chước, việc điều chỉnh dựa trên hành vi gốc (on-policy) mang lại kết quả tốt hơn.
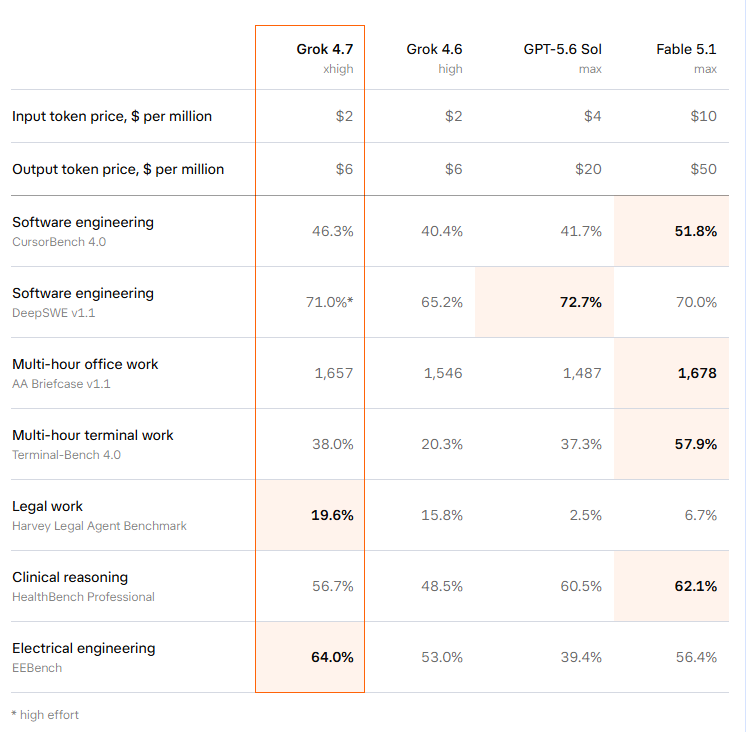
Grok 4.7 đạt 46 điểm trên bảng xếp hạng Artificial Analysis, chính thức lọt vào Top 4 mô hình thông minh nhất. Đặc biệt, khả năng lập trình của Grok Build đã tăng vọt lên 56 điểm, khẳng định vị thế cạnh tranh trực tiếp với các đối thủ hàng đầu như Claude và GPT.
Diễn biến sự kiện · 24 bài →Thêm 7 nguồn khác đưa tinX: Haider (@haider1)X: Artificial Analysis (@ArtificialAnlys)X: Arena (@arena)X: Michael Truell (@mntruell)X: Elon Musk (@elonmusk, xAI)X: Kim (@kimmonismus)@mark_kRohan Paul@rohanpaul_aiLegal work saw one of Grok 4.7's biggest jumps. On the Harvey Legal Agent Benchmark, Grok 4.7 scor…
DịchGrok 4.7 vừa được phát hành với hiệu suất cải thiện đáng kể so với bản 4.6, đạt 19,6% trên Harvey Legal Agent Benchmark và tăng gấp đôi điểm số Terminal-Bench 4.0 mà không thay đổi giá.

SiliconBench là bộ tiêu chuẩn mới đánh giá 9 công cụ chạy LLM trên Apple Silicon dựa trên ba yếu tố: tốc độ, bộ nhớ và độ chính xác, giúp tối ưu hóa việc triển khai mô hình cục bộ.
 Clément Delangue (Hugging Face CEO)@ClementDelangue
lots of them! Reality is that LLM APIs are far from being the best way to do AI for 90% of use cases…
DịchCEO Clément Delangue cho rằng các API LLM hiện nay quá cồng kềnh, chậm và đắt đỏ. Ông dự đoán trong tương lai, người dùng sẽ chuyển sang các giải pháp chuyên biệt, tinh gọn hơn thay vì phụ thuộc vào các mô hình khổng lồ.
 Yuchen Jin@Yuchenj_UW
2 things are happening: - Frontier LLM coding capability plateaued. Since Opus 4.8, we haven't seen…
DịchKhi khả năng lập trình của các mô hình LLM hàng đầu chững lại, các doanh nghiệp đang chuyển sang mô hình nguồn mở nhờ hiệu năng tương đương nhưng chi phí thấp hơn từ 10-50 lần.
Tomer Tunguz chỉ ra rằng các bộ ra quyết định chuyên biệt như Jev và SemIf đang thay thế các lệnh logic 'if-then' truyền thống, giúp tăng độ chính xác lên gấp đôi và giảm chi phí vận hành từ 76 đến 209 lần so với các mô hình AI tạo sinh thông thường.
Diễn biến sự kiện · 24 bài →Thêm 3 nguồn khác đưa tinX: Elvis Saravia (@omarsar0, DAIR.AI)@typesafeaiSimon Willison BlogNghiên cứu giới thiệu BI-Agent, hệ thống sử dụng LLM để tự động hóa quy trình phân tích dữ liệu từ khâu chuẩn bị đến trả lời câu hỏi, cùng bộ tiêu chuẩn đánh giá BI-Bench giúp tối ưu hóa hiệu suất cho các tác vụ BI.
Artificial Analysis@ArtificialAnlysGrok 4.7 scores 46 on the Artificial Analysis Intelligence Index to bring SpaceXAI into the top 4 AI…
DịchArtificial Analysis vừa công bố kết quả đánh giá Grok 4.7 với số điểm 46, tăng 2 điểm so với phiên bản tiền nhiệm, giúp xAI chính thức lọt vào top 4 phòng thí nghiệm AI hàng đầu thế giới.

Nhóm nghiên cứu từ Shanghai AI Lab và ĐH Giao thông Thượng Hải giới thiệu mô hình NCP-ArchPreview, thay thế dự đoán từ ngữ (NTP) bằng dự đoán khái niệm (NCP), giúp tăng tốc độ hội tụ gấp 1,95 lần và cải thiện hiệu suất suy luận đáng kể.
 Haider@haider1
Grok 4.7 benchmarks
DịchNhững dữ liệu benchmark đầu tiên của Grok 4.7 vừa được chia sẻ, hé lộ hiệu năng vượt trội của thế hệ mô hình mới từ xAI.
Multiverse giới thiệu phương pháp cắt tỉa khối LLM bằng cách chuyển đổi thành bài toán tối ưu hóa Ising, giúp chọn cấu hình nén tối ưu mà không cần chạy benchmark. Kết quả trên Llama-3.3-70B cho thấy hiệu suất vượt trội, tăng 23% điểm MMLU so với các phương pháp truyền thống.
Dự án Heretic đang thu hút sự chú ý trên Hacker News nhờ khả năng loại bỏ các rào cản kiểm duyệt và giới hạn trên các mô hình ngôn ngữ lớn, dù thông tin chi tiết hiện vẫn còn khá hạn chế.
GAVEL là khung làm việc mới giúp LLM kiểm chứng và sửa lỗi lập kế hoạch cho robot thông qua mô hình thế giới dạng đồ thị, giúp dự đoán hậu quả hành động và tối ưu hóa các tác vụ phức tạp mà không cần phụ thuộc hoàn toàn vào việc lập kế hoạch lại từ đầu.
Thư viện npm jev-leftpad thay thế hàm padStart truyền thống bằng cách gọi LLM để quyết định số lượng khoảng trắng cần thêm. Đây là một ví dụ hài hước về việc lạm dụng AI cho những tác vụ lập trình cơ bản.
Các nhà nghiên cứu giới thiệu Social World Model, cho phép AI liên tục cập nhật kiến thức từ dữ liệu thị trường thời gian thực, giúp mô hình 7B vượt qua các siêu AI như GPT-5.6 và Claude Opus 5 trong việc dự đoán biến động xã hội.
Dự án mã nguồn mở mini-AGI cho phép huấn luyện mô hình ngôn ngữ từ đầu trên GPU 8GB, sử dụng cơ chế lưu trữ tham số theo chuyên gia trên ổ cứng để vượt qua giới hạn bộ nhớ VRAM.
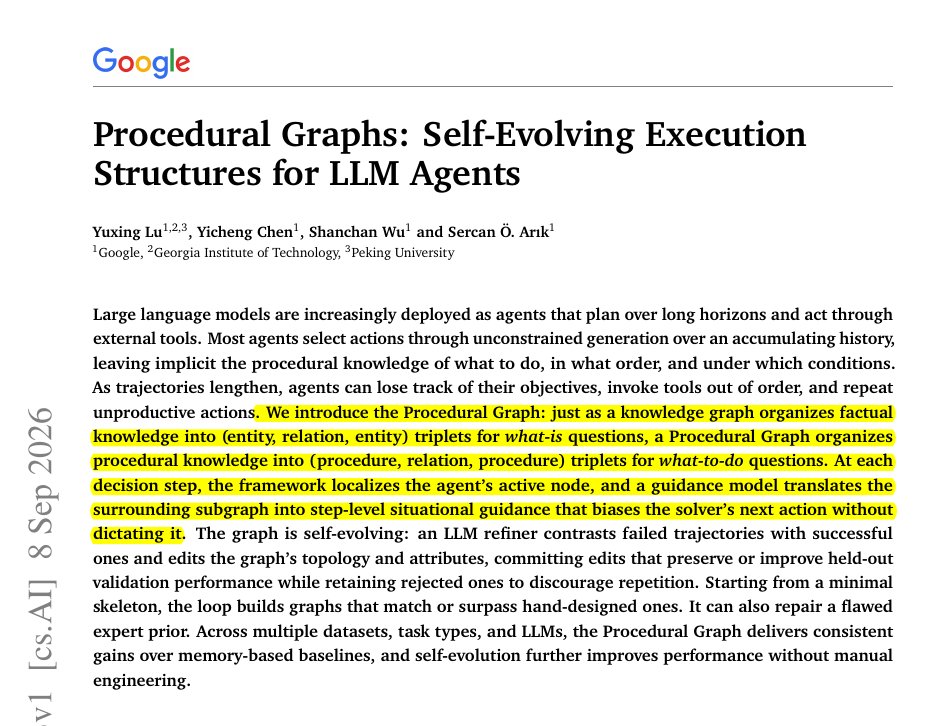
Rohan Paul@rohanpaul_aiNew Google paper shows LLM agents handle long tasks better when their workflow lives in an editable …
DịchGoogle đề xuất sử dụng 'Sơ đồ quy trình' (Procedural Graphs) để thay thế lịch sử trò chuyện, cho phép AI tự tối ưu hóa quy trình làm việc dựa trên việc phân tích các thất bại trước đó, giúp tăng độ chính xác cho các tác vụ phức tạp.
Nghiên cứu giới thiệu bộ dữ liệu 12.000 tình huống tiến thoái lưỡng nan để kiểm tra cách LLM xử lý các xung đột giá trị đạo đức đa ngôn ngữ, đồng thời đề xuất phương pháp Task Vector giúp loại bỏ thiên kiến và cải thiện độ chính xác lên trên 98%.
 ModelBest OpenBMB@OpenBMB
Love this research-agent design from @aijoey: GPT-6 orchestrates while MiniCPM5-2B runs locally on D…
DịchOpenBMB ra mắt Footnote, một hệ thống AI Agent sử dụng GPT-6 để điều phối và MiniCPM5-2B chạy cục bộ nhằm trích xuất, kiểm chứng nguồn tài liệu nghiên cứu với độ chính xác cao.
Rohan Paul@rohanpaul_aiIf an agent rewrites its runtime for every bad decision, it can learn the wrong lesson Fix recurrin…
DịchECDYSIS là khung vận hành mới giúp AI Agent học từ các nhóm lỗi tương đồng thay vì sửa lỗi đơn lẻ, giúp tăng độ chính xác, tốc độ huấn luyện và khả năng thích ứng trên nhiều mô hình khác nhau.
 Ma Dongxi NLP@dongxi_nlp
Từ những trải nghiệm thực tế khi dùng AI Agent như độ trễ, lệch hướng và lỗi lặp lại, Ma Dong-seok cho rằng việc suy luận thuần túy trong không gian Token có giới hạn, qua đó đồng tình với quan điểm hoài nghi của Yann LeCun về LLM.
Tác giả lập luận rằng MCP là giao thức lỗi thời cho các LLM đời đầu. Thay vì phụ thuộc vào MCP, các AI hiện đại nên trực tiếp sử dụng HTTP API tiêu chuẩn hóa để tương tác hiệu quả và linh hoạt hơn.
MoME thay thế các bảng nhúng tĩnh bằng cơ chế hỗn hợp nhiều khe cắm, cho phép mô hình truy xuất thông tin linh hoạt dựa trên ngữ cảnh thay vì chỉ dựa vào từ khóa, giúp cải thiện hiệu suất đáng kể cho các dòng LLM như Llama-3 hay Qwen.
Cal-OPD giải quyết vấn đề mô hình học sinh vô tình học phải các sai lệch nội tại của giáo viên trong quá trình chưng cất (distillation), bằng cách tách biệt và loại bỏ các nhiễu này để cải thiện khả năng suy luận.
Haider@haider1gemini 4.0 is another big release on the horizon since it's a new model family, google will release…
DịchGoogle sắp trình làng thế hệ Gemini 4.0 với chiến lược mới: duy trì bản Pro hàng năm nhưng đẩy mạnh tần suất cập nhật các phiên bản Flash lên hàng tháng để tối ưu hóa hiệu năng.
jevchat sử dụng API chấm điểm xác suất của Jev để dự đoán từng ký tự tiếp theo, tạo ra một mô hình ngôn ngữ thô sơ bằng cách lấy mẫu từ các token tiềm năng cho đến khi gặp lệnh dừng.
GraphSkillEvo cải thiện hiệu suất tác nhân LLM bằng cách biểu diễn kỹ năng dưới dạng đồ thị có cấu trúc thay vì văn bản thuần túy, giúp tối ưu hóa quy trình thực thi và giảm thiểu sự dư thừa.
Nghiên cứu chỉ ra rằng việc dùng AI để đánh giá bài báo khoa học tạo ra vòng lặp phản hồi, làm giảm tính đa dạng và gây ra hiện tượng 'sụp đổ tư duy'. Nhóm tác giả đề xuất TrustReviewer như một giải pháp để duy trì chất lượng đánh giá khách quan.
 Hongming@hongming731
StepFun công bố mô hình Step 5 với 600B tham số, Bun hoàn tất chuyển đổi 535.000 dòng code sang Rust nhờ AI, và Kuaishou tối ưu hệ thống phụ đề livestream với độ trễ cực thấp.
Cùng sự kiện, tinh chọn hiển thị «Đánh giá Step 5 Preview: Hiệu năng ngang ngửa đối thủ nhưng chi phí rẻ gấp 2.8 lần»