22/09

Thứ Ba · 43 tin
Elon Musk@elonmusk
Mô hìnhĐiểm AI 61/100

Cùng sự kiệnElon Musk ra mắt Grok 4.7: Hiệu năng tiệm cận Anthropic với chi phí tối ưu

Elon Musk công bố Grok 4.7, khẳng định mô hình này đạt hiệu suất chỉ đứng sau các dòng của Anthropic theo đánh giá từ Artificial Analysis, trong khi chi phí vận hành chỉ bằng một nửa.

Cùng sự kiện, bài đại diện «Muse Spark chính thức vượt mặt Grok 4.7 trên bảng xếp hạng AI»
Simon Willison Blog
Hướng dẫnĐiểm AI 69/100

Simon Willison đánh giá Jev: Mô hình ra quyết định thế hệ mới từ TypeSafe AI

TypeSafe AI vừa ra mắt Jev, một mô hình 'System One' chuyên biệt trả về điểm số tin cậy thay vì văn bản. Với chi phí cực rẻ chỉ 0,042 USD/triệu token, đây là giải pháp tối ưu cho các tác vụ ra quyết định tự động.

Diễn biến sự kiện · 24 bài →Thêm 3 nguồn khác đưa tin@typesafeaiX: Hongming (@hongming731)X: karminski (@karminski3)
Artificial Analysis@ArtificialAnlys
Mô hìnhĐiểm AI 36/100

Cùng sự kiệnGrok 4.7 bám đuổi sát nút Opus 5 với chi phí chỉ bằng một nửa

Grok 4.7 is behind only Anthropic models on AA-Briefcase, ranking just behind Opus 5 at ~50% of its …

DịchGrok 4.7 đạt bước tiến lớn trên bảng xếp hạng AA-Briefcase, chỉ đứng sau các mô hình của Anthropic với hiệu suất phân tích vượt trội và chi phí vận hành tối ưu hơn 50% so với Opus 5.

Cùng sự kiện, tinh chọn hiển thị «Elon Musk: Grok 4.7 đưa xAI lên vị trí thứ 3 trong lĩnh vực lập trình AI»
Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 45/100

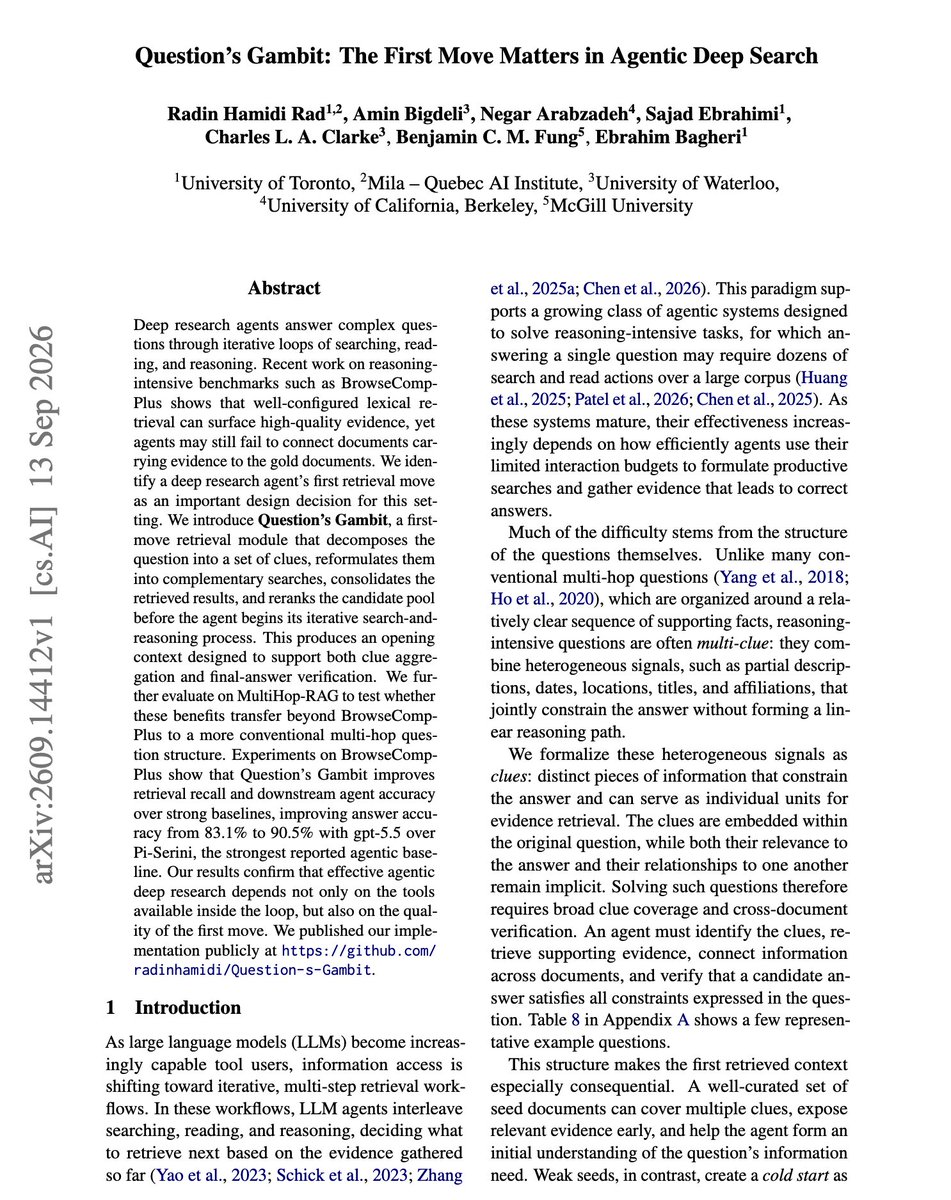
Question's Gambit: Bước đột phá giúp AI nghiên cứu chuyên sâu hiệu quả hơn

Impressive paper showing how much the first retrieval step matters for deep research agents. It hel…

DịchPhương pháp mới giúp AI phân tách câu hỏi thành các manh mối bổ trợ và sắp xếp dữ liệu trước khi tìm kiếm, giúp tối ưu hóa ngữ cảnh đầu vào cho các tác vụ nghiên cứu phức tạp.

Kim@kimmonismus
Mô hìnhĐiểm AI 57/100

Cùng sự kiệnGrok 4.7 ra mắt: Giữ nguyên tốc độ và giá, bổ sung loạt so sánh hiệu năng

Damn. I'm late to the party. Plane just arrived in SF: Grok 4.7 looks super amazing! Not only is i…

DịchPhiên bản Grok 4.7 chính thức trình làng với hiệu suất tương đương bản 4.6 nhưng đi kèm các bài kiểm tra đánh giá chi tiết, giúp người dùng dễ dàng so sánh năng lực mô hình.

Cùng sự kiện, tinh chọn hiển thị «Elon Musk: Grok 4.7 đưa xAI lên vị trí thứ 3 trong lĩnh vực lập trình AI»
Testing Catalog@testingcatalog
Mô hìnhĐiểm AI 72/100

Cùng sự kiệnXiaomi ra mắt bộ đôi mô hình mã nguồn mở MiMo-V2.6: Bản Pro dẫn đầu bảng xếp hạng

XIAOMI 🔥: MiMo-V2.6-Pro and Flash open-source models have been released! MiMo-V2.6-Pro landed on …

DịchXiaomi vừa công bố hai mô hình đa phương thức MiMo-V2.6 Pro và Flash. Trong đó, bản Pro đạt hiệu suất ngang ngửa Claude Opus 5 và GPT-5.6 Sol trên nhiều tiêu chuẩn đánh giá tác nhân AI.

Cùng sự kiện, bài đại diện «Xiaomi MiMo-V2.6-Pro: Bước tiến mới trong tối ưu hóa nghiên cứu vật liệu»
Ma Dongxi NLP@dongxi_nlp
Mô hìnhĐiểm AI 70/100

Xiaomi ra mắt bộ đôi mô hình toàn năng MiMo-V2.6 Pro và Flash, mở mã nguồn hoàn toàn

Xiaomi vừa công bố MiMo-V2.6 với hai phiên bản Pro và Flash, được huấn luyện bằng học tăng cường quy mô lớn. Bản Pro đạt hiệu suất ngang ngửa các mô hình hàng đầu thế giới và hiện dẫn đầu bảng xếp hạng mã nguồn mở, đồng thời hãng cũng đã công khai toàn bộ trọng số, mã nguồn và báo cáo kỹ thuật.

Arena@arena
Mô hìnhĐiểm AI 66/100

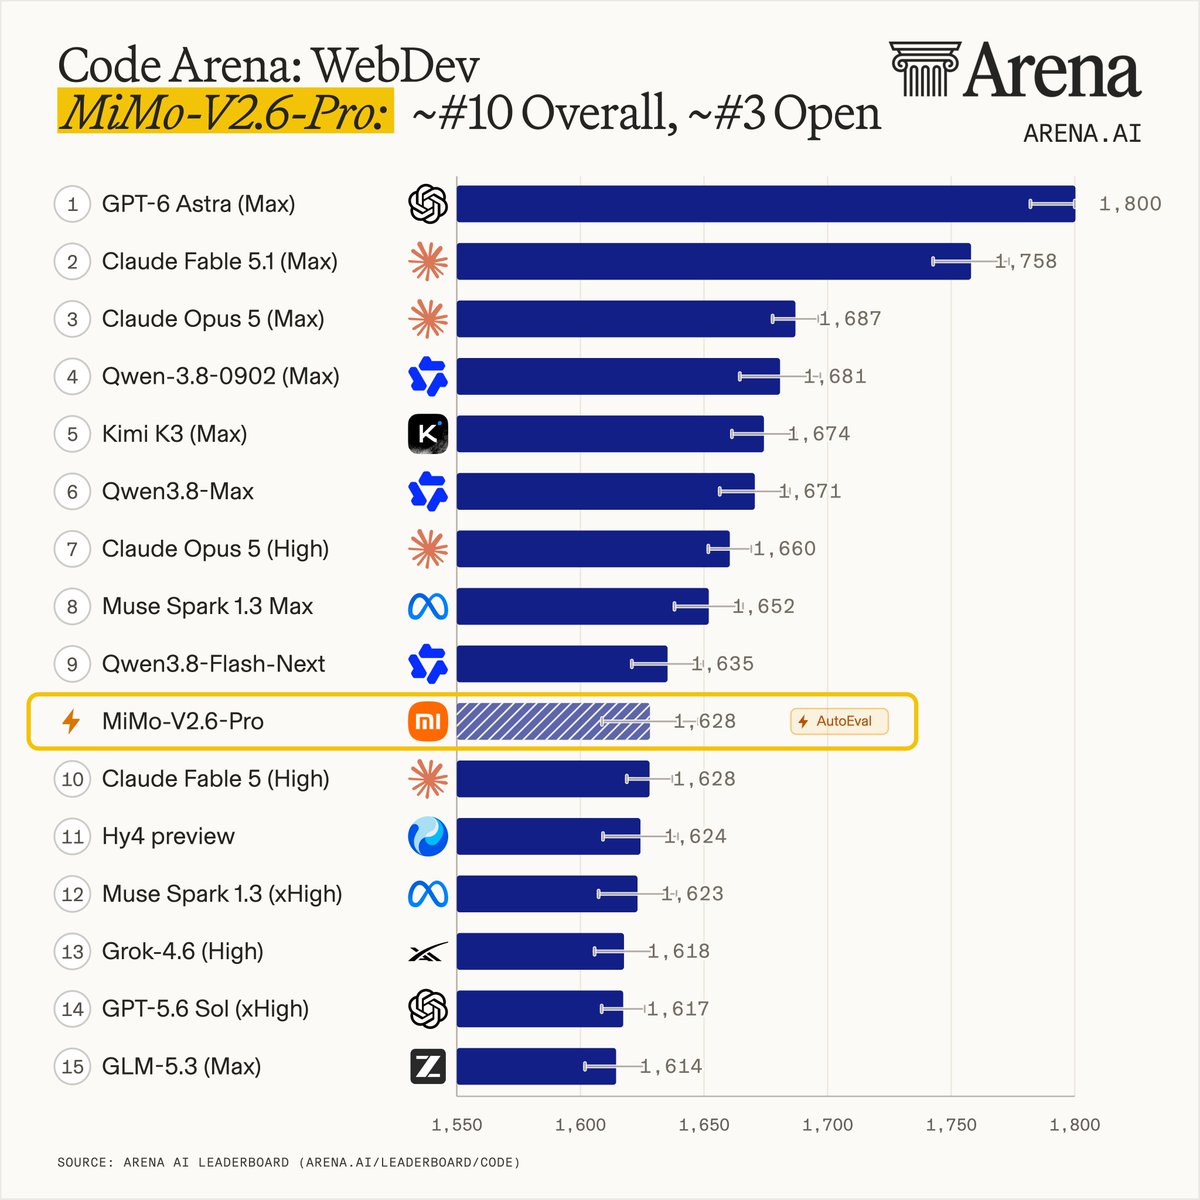
Tinh chọnXiaomi ra mắt MiMo-V2.6-Pro: Lọt Top 10 bảng xếp hạng lập trình WebDev

MiMo-V2.6-Pro just landed @XiaomiMiMo back in the top 10 on Code Arena: WebDev, debuting at ~#10 ove…

DịchXiaomi vừa trình làng hai mô hình toàn năng MiMo-V2.6-Pro và Flash. Trong đó, MiMo-V2.6-Pro đạt 1628 điểm trên bảng xếp hạng Code Arena, đứng thứ 10 chung cuộc và thứ 3 trong nhóm mô hình mã nguồn mở.

Diễn biến sự kiện · 15 bài →Thêm 14 nguồn khác đưa tinX: karminski (@karminski3)X: Elvis Saravia (@omarsar0, DAIR.AI)Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)IT HomeX: Luo Fuli (@_LuoFuli)X: Testing Catalog (@testingcatalog)X: Aravind Srinivas (Perplexity CEO) (@AravSrinivas)Latent SpacePandailyXiaomi MiMo: Phát hành và blog chính thứcX: Xiaomi MiMo (@XiaomiMiMo)X: Ma Dongxi NLP (@dongxi_nlp)X: Artificial Analysis (@ArtificialAnlys)X: Nathan Lambert (@natolambert)

Vì sao đáng đọc: Tin tức quan trọng về bước tiến của Xiaomi trong lĩnh vực mô hình ngôn ngữ lớn, đặc biệt là khả năng lập trình được cộng đồng quốc tế ghi nhận.
Nathan Lambert@natolambert
Mô hìnhĐiểm AI 66/100

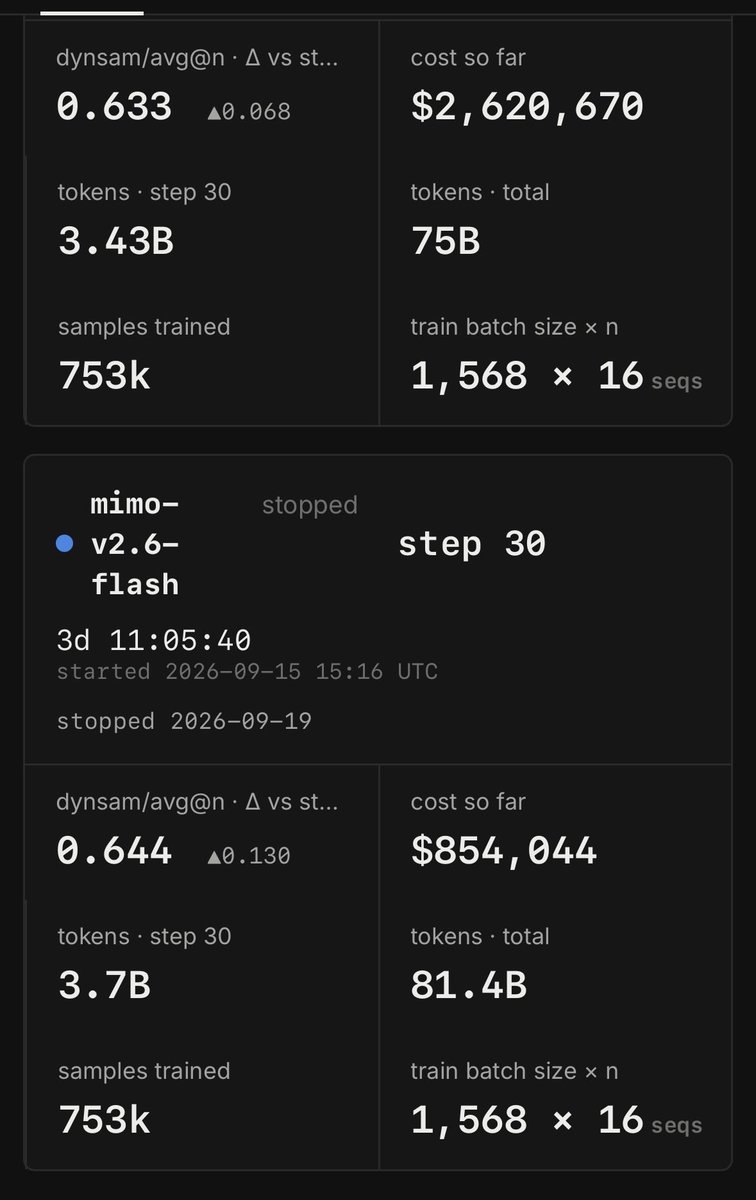
Cùng sự kiệnXiaomi ra mắt dòng MiMo-V2.6: Đột phá với mô hình 1.02T tham số và khả năng tự cải tiến

MiMo-V2.6-Pro: 1.02T-42B active MiMo-V2.6-Flash: 310B-15B active Top open model on Artificial Analys…

DịchXiaomi vừa công bố dòng MiMo-V2.6 với các phiên bản Pro và Flash, tập trung vào khả năng tự cải tiến thông qua học tăng cường (RL) quy mô lớn và hỗ trợ cửa sổ ngữ cảnh lên tới 1 triệu token.

Cùng sự kiện, tinh chọn hiển thị «Xiaomi ra mắt MiMo-V2.6-Pro: Lọt Top 10 bảng xếp hạng lập trình WebDev»
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 55/100

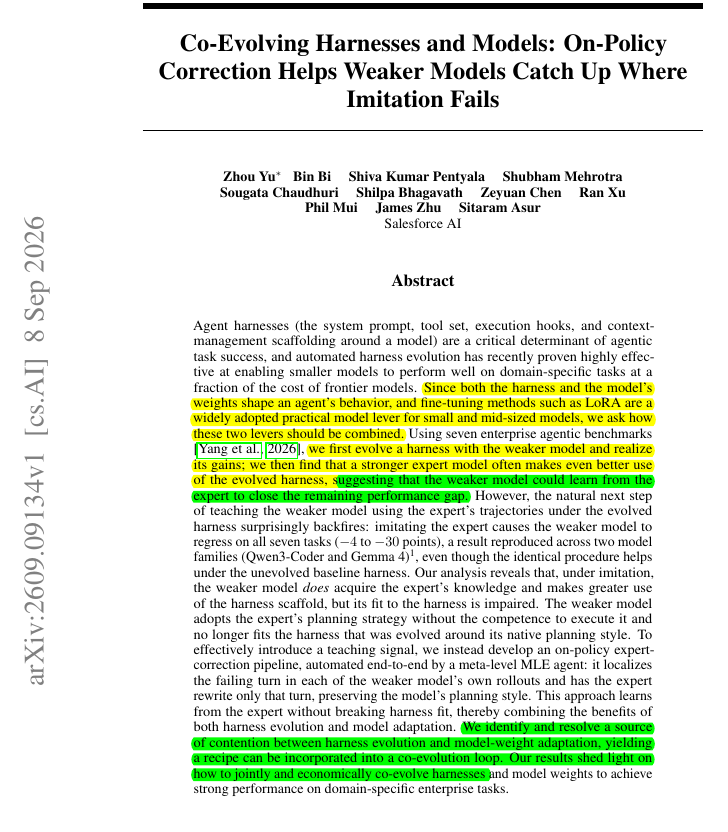
Nghiên cứu từ Salesforce: AI yếu hơn khi bắt chước mô hình mạnh, phương pháp on-policy hiệu quả hơn

New Salesforce AI research finds, once you tune an agent's prompts, tools, and workflow around a wea…

DịchSalesforce phát hiện việc tinh chỉnh mô hình Qwen theo quỹ đạo của Gemini khiến hiệu suất giảm từ 78% xuống 63,1% do sự xung đột trong cách lập kế hoạch. Thay vì bắt chước, việc điều chỉnh dựa trên hành vi gốc (on-policy) mang lại kết quả tốt hơn.

Artificial Analysis bài đầy đủ (Web)
Mô hìnhĐiểm AI 67/100

Tinh chọnĐánh giá Grok 4.7: Lọt Top 4 bảng xếp hạng trí tuệ, năng lực lập trình bứt phá mạnh mẽ

Grok 4.7 đạt 46 điểm trên bảng xếp hạng Artificial Analysis, chính thức lọt vào Top 4 mô hình thông minh nhất. Đặc biệt, khả năng lập trình của Grok Build đã tăng vọt lên 56 điểm, khẳng định vị thế cạnh tranh trực tiếp với các đối thủ hàng đầu như Claude và GPT.

Diễn biến sự kiện · 24 bài →Thêm 7 nguồn khác đưa tinX: Haider (@haider1)X: Artificial Analysis (@ArtificialAnlys)X: Arena (@arena)X: Michael Truell (@mntruell)X: Elon Musk (@elonmusk, xAI)X: Kim (@kimmonismus)@mark_k

Vì sao đáng đọc: Tin tức cập nhật về hiệu năng của một mô hình AI lớn đang được quan tâm, có số liệu so sánh cụ thể giúp người dùng dễ dàng nắm bắt vị thế của Grok trên thị trường.
Rohan Paul@rohanpaul_ai
Mô hìnhĐiểm AI 68/100

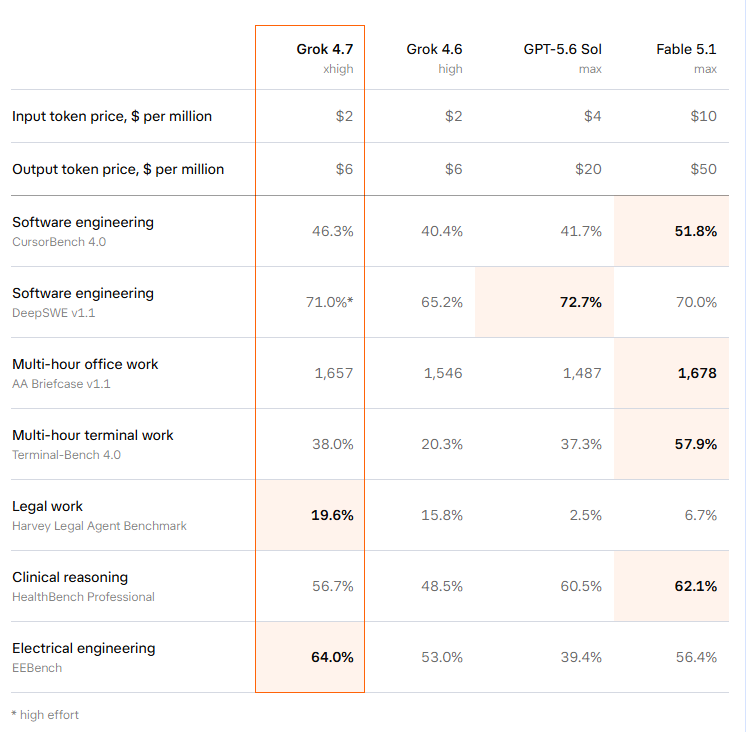
Cùng sự kiệnGrok 4.7 ra mắt: Hiệu suất vượt trội trên Harvey Legal, điểm số Terminal-Bench tăng gấp đôi

Legal work saw one of Grok 4.7's biggest jumps. On the Harvey Legal Agent Benchmark, Grok 4.7 scor…

DịchGrok 4.7 vừa được phát hành với hiệu suất cải thiện đáng kể so với bản 4.6, đạt 19,6% trên Harvey Legal Agent Benchmark và tăng gấp đôi điểm số Terminal-Bench 4.0 mà không thay đổi giá.

Cùng sự kiện, tinh chọn hiển thị «Elon Musk: Grok 4.7 đưa xAI lên vị trí thứ 3 trong lĩnh vực lập trình AI»
Clément Delangue (Hugging Face CEO)@ClementDelangue
Quan điểmĐiểm AI 27/100

CEO Hugging Face: API mô hình ngôn ngữ lớn không phải là giải pháp tối ưu cho 90% nhu cầu thực tế

lots of them! Reality is that LLM APIs are far from being the best way to do AI for 90% of use cases…

DịchCEO Clément Delangue cho rằng các API LLM hiện nay quá cồng kềnh, chậm và đắt đỏ. Ông dự đoán trong tương lai, người dùng sẽ chuyển sang các giải pháp chuyên biệt, tinh gọn hơn thay vì phụ thuộc vào các mô hình khổng lồ.

Yuchen Jin@Yuchenj_UW
Quan điểmĐiểm AI 36/100

Doanh nghiệp ồ ạt chuyển từ mô hình đóng sang mô hình mở

2 things are happening: - Frontier LLM coding capability plateaued. Since Opus 4.8, we haven't seen…

DịchKhi khả năng lập trình của các mô hình LLM hàng đầu chững lại, các doanh nghiệp đang chuyển sang mô hình nguồn mở nhờ hiệu năng tương đương nhưng chi phí thấp hơn từ 10-50 lần.

Tomer Tunguz Blog (phân tích VC)
Quan điểmĐiểm AI 66/100

Tinh chọnTomer Tunguz: AI chuyên biệt thay thế lệnh 'if-then', giảm chi phí vận hành tới 200 lần

Tomer Tunguz chỉ ra rằng các bộ ra quyết định chuyên biệt như Jev và SemIf đang thay thế các lệnh logic 'if-then' truyền thống, giúp tăng độ chính xác lên gấp đôi và giảm chi phí vận hành từ 76 đến 209 lần so với các mô hình AI tạo sinh thông thường.

Diễn biến sự kiện · 24 bài →Thêm 3 nguồn khác đưa tinX: Elvis Saravia (@omarsar0, DAIR.AI)@typesafeaiSimon Willison Blog

Vì sao đáng đọc: Bài viết cung cấp góc nhìn thực tế từ chuyên gia VC về tối ưu hóa chi phí và hiệu suất AI, rất hữu ích cho các kỹ sư và nhà phát triển ứng dụng AI.

21/09

Thứ Hai · 25 tin
Artificial Analysis@ArtificialAnlys
Nghiên cứuĐiểm AI 65/100

Đã có đại diệnArtificial Analysis đánh giá Grok 4.7: Chỉ số thông minh đạt 46, khả năng lập trình vượt trội

Grok 4.7 scores 46 on the Artificial Analysis Intelligence Index to bring SpaceXAI into the top 4 AI…

DịchArtificial Analysis vừa công bố kết quả đánh giá Grok 4.7 với số điểm 46, tăng 2 điểm so với phiên bản tiền nhiệm, giúp xAI chính thức lọt vào top 4 phòng thí nghiệm AI hàng đầu thế giới.

Cùng sự kiện, tinh chọn hiển thị «Đánh giá Grok 4.7: Lọt Top 4 bảng xếp hạng trí tuệ, năng lực lập trình bứt phá mạnh mẽ»
JiQiZhiXin
Nghiên cứuĐiểm AI 95/100

Tinh chọnĐột phá AI: Giảm 50% chi phí huấn luyện với mô hình 'Dự đoán khái niệm' từ Shanghai AI Lab

Nhóm nghiên cứu từ Shanghai AI Lab và ĐH Giao thông Thượng Hải giới thiệu mô hình NCP-ArchPreview, thay thế dự đoán từ ngữ (NTP) bằng dự đoán khái niệm (NCP), giúp tăng tốc độ hội tụ gấp 1,95 lần và cải thiện hiệu suất suy luận đáng kể.


Vì sao đáng đọc: Đây là bước tiến quan trọng thay đổi tư duy huấn luyện LLM truyền thống, có tác động lớn đến hiệu quả chi phí và hiệu năng, được cộng đồng quốc tế đánh giá rất cao.
Haider@haider1
Mô hìnhĐiểm AI 19/100

Cùng sự kiệnLộ diện kết quả benchmark ấn tượng của mô hình Grok 4.7

Grok 4.7 benchmarks

DịchNhững dữ liệu benchmark đầu tiên của Grok 4.7 vừa được chia sẻ, hé lộ hiệu năng vượt trội của thế hệ mô hình mới từ xAI.

Cùng sự kiện, tinh chọn hiển thị «Đánh giá Grok 4.7: Lọt Top 4 bảng xếp hạng trí tuệ, năng lực lập trình bứt phá mạnh mẽ»
Hugging Face: Blog
Nghiên cứuĐiểm AI 47/100

Multiverse: Ứng dụng vật lý lượng tử để tối ưu hóa việc cắt tỉa mô hình LLM

Multiverse giới thiệu phương pháp cắt tỉa khối LLM bằng cách chuyển đổi thành bài toán tối ưu hóa Ising, giúp chọn cấu hình nén tối ưu mà không cần chạy benchmark. Kết quả trên Llama-3.3-70B cho thấy hiệu suất vượt trội, tăng 23% điểm MMLU so với các phương pháp truyền thống.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

GAVEL: Mô hình thế giới dạng đồ thị giúp LLM lập kế hoạch robot dài hạn chính xác và hiệu quả

GAVEL là khung làm việc mới giúp LLM kiểm chứng và sửa lỗi lập kế hoạch cho robot thông qua mô hình thế giới dạng đồ thị, giúp dự đoán hậu quả hành động và tối ưu hóa các tác vụ phức tạp mà không cần phụ thuộc hoàn toàn vào việc lập kế hoạch lại từ đầu.

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Sản phẩmĐiểm AI 33/100

jev-leftpad: Thư viện npm 'dùng dao mổ trâu giết gà' khi gọi LLM để đệm chuỗi

Thư viện npm jev-leftpad thay thế hàm padStart truyền thống bằng cách gọi LLM để quyết định số lượng khoảng trắng cần thêm. Đây là một ví dụ hài hước về việc lạm dụng AI cho những tác vụ lập trình cơ bản.

JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnĐột phá: Mô hình 7B từ UIUC và startup Thanh Hoa đánh bại GPT-5.6 nhờ tự chưng cất trên thị trường dự báo

Các nhà nghiên cứu giới thiệu Social World Model, cho phép AI liên tục cập nhật kiến thức từ dữ liệu thị trường thời gian thực, giúp mô hình 7B vượt qua các siêu AI như GPT-5.6 và Claude Opus 5 trong việc dự đoán biến động xã hội.


Vì sao đáng đọc: Nghiên cứu mang tính đột phá về khả năng tự học liên tục (continual learning) của LLM trong môi trường thực tế, thách thức giới hạn của các mô hình tĩnh hiện nay.
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 48/100

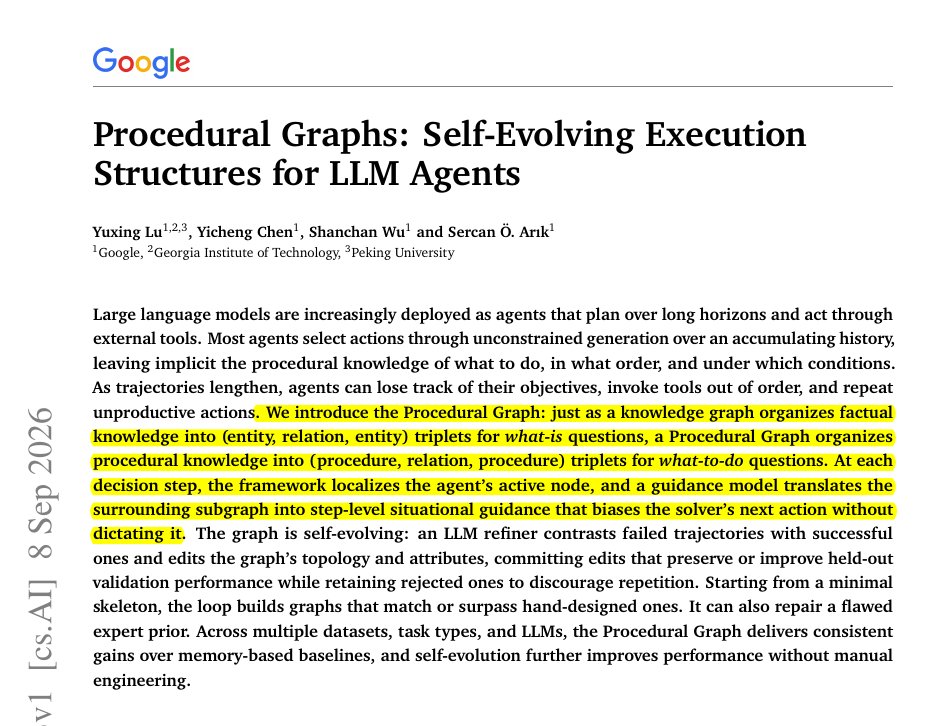
Google giới thiệu Procedural Graphs: Giải pháp giúp AI Agent xử lý tác vụ dài ổn định hơn

New Google paper shows LLM agents handle long tasks better when their workflow lives in an editable …

DịchGoogle đề xuất sử dụng 'Sơ đồ quy trình' (Procedural Graphs) để thay thế lịch sử trò chuyện, cho phép AI tự tối ưu hóa quy trình làm việc dựa trên việc phân tích các thất bại trước đó, giúp tăng độ chính xác cho các tác vụ phức tạp.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Hình học của các giá trị: Sử dụng Task Vector để căn chỉnh đạo đức cho mô hình ngôn ngữ

Nghiên cứu giới thiệu bộ dữ liệu 12.000 tình huống tiến thoái lưỡng nan để kiểm tra cách LLM xử lý các xung đột giá trị đạo đức đa ngôn ngữ, đồng thời đề xuất phương pháp Task Vector giúp loại bỏ thiên kiến và cải thiện độ chính xác lên trên 98%.

ModelBest OpenBMB@OpenBMB
Sản phẩmĐiểm AI 47/100

OpenBMB giới thiệu Footnote: AI Agent kết hợp GPT-6 và MiniCPM5-2B để nghiên cứu chuyên sâu

Love this research-agent design from @aijoey: GPT-6 orchestrates while MiniCPM5-2B runs locally on D…

DịchOpenBMB ra mắt Footnote, một hệ thống AI Agent sử dụng GPT-6 để điều phối và MiniCPM5-2B chạy cục bộ nhằm trích xuất, kiểm chứng nguồn tài liệu nghiên cứu với độ chính xác cao.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 40/100

ECDYSIS: Tối ưu hóa huấn luyện AI Agent thông qua phân tích mô hình lỗi

If an agent rewrites its runtime for every bad decision, it can learn the wrong lesson Fix recurrin…

DịchECDYSIS là khung vận hành mới giúp AI Agent học từ các nhóm lỗi tương đồng thay vì sửa lỗi đơn lẻ, giúp tăng độ chính xác, tốc độ huấn luyện và khả năng thích ứng trên nhiều mô hình khác nhau.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

MoME: Cơ chế nhúng bộ nhớ hỗn hợp giúp LLM hiểu ngữ cảnh tốt hơn

MoME thay thế các bảng nhúng tĩnh bằng cơ chế hỗn hợp nhiều khe cắm, cho phép mô hình truy xuất thông tin linh hoạt dựa trên ngữ cảnh thay vì chỉ dựa vào từ khóa, giúp cải thiện hiệu suất đáng kể cho các dòng LLM như Llama-3 hay Qwen.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Cal-OPD: Tối ưu hóa chưng cất mô hình thông qua hiệu chỉnh sai lệch giữa giáo viên và học sinh

Cal-OPD giải quyết vấn đề mô hình học sinh vô tình học phải các sai lệch nội tại của giáo viên trong quá trình chưng cất (distillation), bằng cách tách biệt và loại bỏ các nhiễu này để cải thiện khả năng suy luận.

Haider@haider1
Mô hìnhĐiểm AI 27/100

Google chuẩn bị ra mắt Gemini 4.0: Chiến lược tập trung vào tốc độ cập nhật

gemini 4.0 is another big release on the horizon since it's a new model family, google will release…

DịchGoogle sắp trình làng thế hệ Gemini 4.0 với chiến lược mới: duy trì bản Pro hàng năm nhưng đẩy mạnh tần suất cập nhật các phiên bản Flash lên hàng tháng để tối ưu hóa hiệu năng.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnKhi AI đánh giá AI: Nguy cơ 'sụp đổ tư duy khoa học' và giải pháp khắc phục

Nghiên cứu chỉ ra rằng việc dùng AI để đánh giá bài báo khoa học tạo ra vòng lặp phản hồi, làm giảm tính đa dạng và gây ra hiện tượng 'sụp đổ tư duy'. Nhóm tác giả đề xuất TrustReviewer như một giải pháp để duy trì chất lượng đánh giá khách quan.


Vì sao đáng đọc: Chủ đề mang tính thời sự cao về rủi ro của AI trong học thuật. Nghiên cứu thực nghiệm rõ ràng, có đề xuất giải pháp cụ thể, rất đáng quan tâm cho giới nghiên cứu.
Hongming@hongming731
Quan điểmĐiểm AI 33/100

Cùng sự kiệnĐiểm tin AI: Step 5 của StepFun ra mắt, Bun chuyển đổi sang Rust và đột phá từ Kuaishou

StepFun công bố mô hình Step 5 với 600B tham số, Bun hoàn tất chuyển đổi 535.000 dòng code sang Rust nhờ AI, và Kuaishou tối ưu hệ thống phụ đề livestream với độ trễ cực thấp.

Cùng sự kiện, tinh chọn hiển thị «Đánh giá Step 5 Preview: Hiệu năng ngang ngửa đối thủ nhưng chi phí rẻ gấp 2.8 lần»
JiQiZhiXin
Nghiên cứuĐiểm AI 88/100

Tinh chọnEMNLP 2026: ToolLoop - Đột phá trong tổng hợp dữ liệu sử dụng công cụ cho LLM thông qua cơ chế tự phản hồi

ToolLoop tối ưu hóa việc tạo dữ liệu huấn luyện cho LLM bằng cách chia nhỏ quy trình thành ba giai đoạn: lấy mẫu hàm, tạo câu hỏi ngược và tạo lệnh gọi công cụ, kết hợp cơ chế tự phản hồi để đảm bảo độ chính xác cao hơn so với phương pháp lọc truyền thống.


Vì sao đáng đọc: Nghiên cứu từ vivo AI Lab được chấp nhận tại EMNLP 2026, giải quyết vấn đề cốt lõi trong việc huấn luyện Agent bằng cách cải thiện chất lượng dữ liệu tổng hợp thông qua quy trình khép kín.
Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (49 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “LLM” — Trang 4 | AIHOT.vn