06/09

Chủ Nhật · 1 tin
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 51/100

DisCo: Phương pháp chưng cất kho lưu trữ GitHub thành kỹ năng, giúp AI đạt 72.89% trên MLE-bench

Very useful insight in this paper. AI agents may be wasting huge amounts of effort rediscovering t…

DịchNghiên cứu DisCo giới thiệu cách chuyển đổi kho lưu trữ GitHub và tài liệu kỹ thuật thành các 'kỹ năng' tinh gọn, giúp AI tự chủ trong việc chọn công cụ và xử lý lỗi, từ đó nâng cao đáng kể hiệu suất giải quyết tác vụ thực tế.

05/09

Thứ Bảy · 1 tin
MiniMax@MiniMax_AI
NgànhĐiểm AI 23/100

MiniMax và Together AI tổ chức sự kiện 'Open by Design' tại London vào ngày 16/9

Open models are changing the cost equation for production AI. On September 16, MiniMax and @togethe…

DịchMiniMax và Together AI sẽ thảo luận về tối ưu hóa chi phí, lựa chọn mô hình và chiến lược triển khai các mô hình mã nguồn mở trong môi trường thực tế tại sự kiện diễn ra ở London.

04/09

Thứ Sáu · 2 tin
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 44/100

Nghiên cứu từ Stanford: Kỹ thuật Prefix Sliding giúp tăng tốc suy luận AI gấp 3 lần mà không cần huấn luyện lại

New Stanford paper Prefix Sliding shows that long reasoning does not need the full chain of thought …

DịchPhương pháp Prefix Sliding cho phép mô hình AI lược bỏ các token suy luận trung gian, chỉ giữ lại tiền tố nhiệm vụ và cửa sổ trượt gần nhất, giúp tối ưu hóa tốc độ suy luận gấp 3 lần mà không làm giảm hiệu suất.

03/09

Thứ Năm · 2 tin
Alibaba Cloud@alibaba_cloud
Mô hìnhĐiểm AI 50/100

Qwen3.8-Flash ra mắt chế độ Standard trên QwenWork: Tăng tốc độ tạo tác vụ gấp 2 lần, giảm 75% tiêu thụ token

🚀 A better AI shouldn't just be faster-it should get more real work done with less budget. Qwen3.8-…

DịchAlibaba Cloud vừa tích hợp Qwen3.8-Flash vào chế độ Standard của QwenWork, giúp tối ưu hóa hiệu suất vượt trội với tốc độ xử lý nhanh gấp đôi và tiết kiệm đáng kể chi phí token cho người dùng.

Kim@kimmonismus
Hướng dẫnĐiểm AI 47/100

Mostik: Giao thức cầu nối không gian ẩn giúp mô hình 4B đạt hiệu suất tiệm cận mô hình 753B

A 753B model reads the problem: A 4B model writes the answer. Mostik reports that its latent bridge…

DịchMostik giới thiệu giao thức cầu nối không gian ẩn cho phép mô hình 4B nhận dữ liệu trực tiếp từ mô hình 753B mà không cần tinh chỉnh. Giải pháp này giúp tăng tốc độ xử lý gấp 20 lần và tiết kiệm 2,5 lần tài nguyên tính toán trong khi vẫn duy trì 80% độ chính xác của mô hình lớn.

02/09

Thứ Tư · 3 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Thích nghi không cần Gradient: Phương pháp CASTER tối ưu hóa mô hình AI mà không cần cập nhật tham số

CASTER là phương pháp thích nghi thời gian thực (TTA) không cần gradient, giúp điều chỉnh phân phối dữ liệu mà không cần cập nhật trọng số mô hình. Giải pháp này đặc biệt hiệu quả cho các thiết bị hạn chế bộ nhớ hoặc các mô hình bị khóa tham số.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 37/100

Tối ưu hóa Prompt cho hệ thống đa tác nhân AI: Phương pháp tách biệt luồng điều khiển và dữ liệu

Nghiên cứu giới thiệu cách tách biệt giao thức điều khiển khỏi nội dung dữ liệu trong hệ thống đa tác nhân, giúp đảm bảo tính ổn định của quy trình làm việc mà vẫn tối ưu hóa hiệu quả thực thi nhiệm vụ.

Google DeepMind: Blog
Sản phẩmĐiểm AI 71/100

Tinh chọnGoogle DeepMind ra mắt tính năng hiểu video thông minh cho Gemini

Google DeepMind cập nhật khả năng xử lý video thông minh cho dòng Gemini Flash, giúp mô hình tự động quét các phân đoạn quan trọng. Công nghệ này giúp giảm 88% lượng token, tiết kiệm 66% chi phí và tăng 7% độ chính xác so với phương pháp xử lý khung hình cố định truyền thống.

Diễn biến sự kiện · 2 bài →Thêm 4 nguồn khác đưa tinX: Google AI for Developers (@googleaidevs)X: Logan Kilpatrick (@OfficialLoganK)X: Google DeepMind (@GoogleDeepMind)The Decoder: AI News

Vì sao đáng đọc: Đây là bước tiến quan trọng trong tối ưu hóa chi phí và hiệu suất cho AI đa phương thức, có tác động trực tiếp đến người dùng doanh nghiệp và lập trình viên.

01/09

Thứ Ba · 5 tin
Elvis Saravia@omarsar0
Hướng dẫnĐiểm AI 40/100

Kỷ nguyên mới của trí tuệ nhân tạo tùy chỉnh: Khi mô hình nhỏ đánh bại gã khổng lồ

CEO Shopify chia sẻ về việc mô hình 0.8B được tinh chỉnh chuyên biệt đã vượt qua các siêu mô hình lớn nhờ cơ chế tự cải tiến liên tục, mở ra xu hướng doanh nghiệp tự xây dựng hệ sinh thái AI riêng để tạo lợi thế cạnh tranh.

Tencent Hunyuan@TencentHunyuan
Mô hìnhĐiểm AI 67/100

Cùng sự kiệnTencent ra mắt Hunyuan Hy4 Preview: Mô hình 770B tham số với khả năng tự tối ưu hóa hiệu suất

One more thing about Hy4 preview that is particularly interesting. In AI research. Hy4 preview found…

DịchTencent giới thiệu Hunyuan Hy4 Preview với 770B tham số và cửa sổ ngữ cảnh 1M. Điểm nhấn là khả năng tự phát hiện nút thắt suy luận, giúp tăng 31,8% lưu lượng xử lý thực tế, hướng tới tối ưu chi phí cho doanh nghiệp.

Cùng sự kiện, bài đại diện «Tencent Hunyuan Hy4 lọt Top 5 bảng xếp hạng lập trình toàn cầu»
Elon Musk@elonmusk
Sản phẩmĐiểm AI 28/100

Elon Musk hé lộ tính năng tối ưu hóa token tự động trên Grok để cắt giảm chi phí

Automatic token optimization to lower your Grok @Bot cost will be added soon

DịchElon Musk thông báo Grok sắp cập nhật tính năng tự động tối ưu hóa token nhằm giảm chi phí vận hành, thông qua việc quản lý ngữ cảnh thông minh và lưu trữ các phản hồi để tái sử dụng cho các tác vụ chuyên biệt.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 48/100

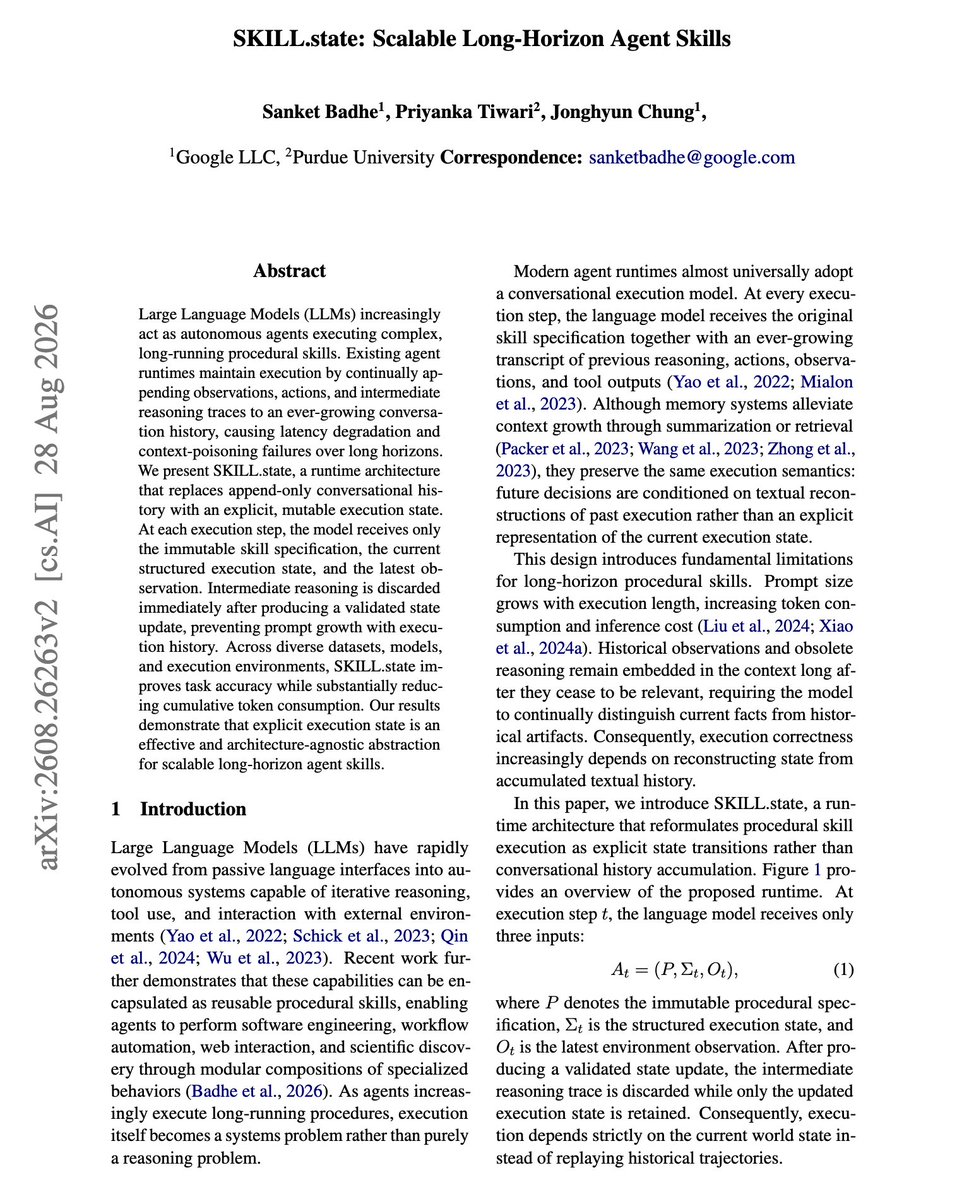
Google giới thiệu SKILL.state: Tối ưu hóa bộ nhớ cho AI tác vụ dài

Great paper from Google and colleagues. It proposes an interesting approach to improve agents on lo…

DịchGoogle đề xuất SKILL.state, thay thế lịch sử hội thoại cồng kềnh bằng trạng thái thực thi rõ ràng, giúp AI xử lý tác vụ dài nhanh hơn, chính xác hơn và tiết kiệm token hơn.

Thêm 2 nguồn khác đưa tinX: Elvis Saravia (@omarsar0, DAIR.AI)X: Rohan Paul (@rohanpaul_ai)

31/08

Thứ Hai · 2 tin
Kim@kimmonismus
Sản phẩmĐiểm AI 50/100

Ra mắt Reflexio: Nền tảng giúp AI tự tối ưu hóa từ phản hồi thực tế

AI agents produce a mountain of logs and still repeat the same mistake next week. Reflexio turns co…

DịchReflexio là nền tảng giúp AI tự cải thiện thông qua việc chuyển đổi phản hồi từ người dùng thành các quy tắc vận hành. Công cụ này giúp giảm 36% tỷ lệ lỗi, cải thiện 47% chất lượng phản hồi và cắt giảm 57% chi phí token cho các tác vụ tương tự.

Microsoft Research@MSFTResearch
Mô hìnhĐiểm AI 29/100

GigaPath-Flash: Đột phá mô hình bệnh lý học với hiệu suất cao, tiết kiệm tài nguyên

What if pathology foundation models could do more with less? GigaPath-Flash and GigaTIME-Flash cut c…

DịchGigaPath-Flash và GigaTIME-Flash tối ưu hóa nhu cầu tính toán cho các mô hình bệnh lý học mà vẫn duy trì hiệu năng vượt trội, mở ra tiềm năng cho các nghiên cứu y khoa quy mô lớn.

30/08

Chủ Nhật · 1 tin
JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnKhi AI tự thiết kế 'bộ khung nhận thức' cho nhau: Không cần huấn luyện, vẫn giúp mô hình nhỏ mạnh gấp bội

Thay vì tốn kém huấn luyện lại mô hình, các nhà nghiên cứu đang thử nghiệm phương pháp 'Strong-to-Weak Scaffolding', nơi AI mạnh thiết kế quy trình làm việc tối ưu để nâng cấp năng lực cho AI yếu hơn, mở ra kỷ nguyên AI4AI đầy tiềm năng.


Vì sao đáng đọc: Bài viết đi sâu vào xu hướng kỹ thuật quan trọng: tối ưu hóa hệ thống thay vì chỉ chạy đua kích thước mô hình. Nội dung có tính chuyên môn cao, tầm nhìn xa và rất thực tế cho giới công nghệ.

28/08

Thứ Sáu · 5 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 66/100

Aphanta: Khung chẩn đoán tự động giúp tối ưu hóa chỉnh sửa ảnh bằng mô hình đa phương thức

Aphanta là khung chẩn đoán tự động giúp đánh giá và cải thiện hiệu quả của các công cụ chỉnh sửa ảnh trong quy trình suy luận đa phương thức, giúp tăng đáng kể độ chính xác của các tác vụ phức tạp.

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Sản phẩmĐiểm AI 66/100

Experiential: Cổng kết nối và bộ định tuyến mã nguồn mở cho quy trình làm việc của AI Agent

Experiential là giải pháp mã nguồn mở giúp quản lý, điều phối và tối ưu hóa các mô hình AI thông qua API tương thích với OpenAI, hỗ trợ kiểm soát chi phí và hiệu suất cho các quy trình làm việc của AI Agent.

MiniMax@MiniMax_AI
Mô hìnhĐiểm AI 42/100

MiniMax hợp tác cùng fal ra mắt mô hình H3 Max tối ưu hóa hiệu suất

A great deep dive from the @fal team on how they built H3 Max, combining post-training with a co-des…

DịchMiniMax chúc mừng đội ngũ fal ra mắt H3 Max, phiên bản được tinh chỉnh từ mô hình H3 nhằm nâng cao khả năng tuân thủ câu lệnh và chất lượng hình ảnh, đồng thời tối ưu hóa tốc độ suy luận mà không làm giảm hiệu suất.

MiniMax@MiniMax_AI
Mô hìnhĐiểm AI 52/100

MiniMax công bố mô hình H3: H3 Max thống trị bảng xếp hạng video AI với tốc độ vượt trội

Congrats to the fal team on MiniMax H3 Max - fantastic work! A quick note on what's actually happen…

DịchMô hình H3 Max (dựa trên nền tảng H3 của MiniMax) vừa đạt vị trí dẫn đầu về chất lượng video và khả năng hiểu prompt. Nhờ tối ưu hóa SGLang và Sol-Attention, mô hình đạt tốc độ tạo video 5 giây chỉ trong dưới 3 giây, nhanh gấp 3,95 lần so với thông thường.

LMSYS: Blog (nhóm Chatbot Arena)
Nghiên cứuĐiểm AI 65/100

Tinh chọnMiniMax-H3 trên 8x H200: Tăng tốc không mất dữ liệu lên tới 1,95 lần

Nhóm SGLang Diffusion thử nghiệm MiniMax-H3 trên 8 GPU NVIDIA H200, đạt tốc độ nhanh gấp 1,95 lần so với Diffusers mà không làm giảm chất lượng hình ảnh.


Vì sao đáng đọc: Đây là bước tiến kỹ thuật quan trọng trong tối ưu hóa suy luận video, cung cấp số liệu thực tế cho các nhà phát triển AI về hiệu năng phần cứng cao cấp.

27/08

Thứ Năm · 4 tin
ModelBest OpenBMB@OpenBMB
NgànhĐiểm AI 27/100

OpenBMB khởi động chương trình MiniCPM Spark: Tìm kiếm giải pháp tối ưu hóa hiệu suất AI

🔥 MiniCPM Spark Program S1: Cost Optimization with MiniCPM Can you make AI more efficient without …

DịchOpenBMB chính thức phát động chương trình MiniCPM Spark S1, kêu gọi các nhà phát triển và nghiên cứu chia sẻ các giải pháp tối ưu hóa mô hình, API, triển khai và phối hợp giữa thiết bị với đám mây.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 45/100

RetrievalRouter: Tối ưu hóa quy trình truy xuất tài liệu bằng định tuyến thông minh

RetrievalRouter là bộ định tuyến nhẹ giúp tự động chọn quy trình truy xuất phù hợp nhất cho từng truy vấn, giúp cân bằng hiệu quả giữa độ chính xác và tốc độ phản hồi trong các lĩnh vực chuyên sâu như tài chính và khoa học.

26/08

Thứ Tư · 2 tin
Elvis Saravia@omarsar0
Sản phẩmĐiểm AI 44/100

Glean ra mắt hơn 50 tính năng mới, tối ưu hóa AI doanh nghiệp bằng dữ liệu nội bộ

With models becoming increasingly interchangeable, it's all about quality and organization of contex…

DịchTại sự kiện Glean:GO, Glean giới thiệu loạt tính năng mới giúp kết nối tri thức doanh nghiệp với AI. Nền tảng này đạt hiệu suất vượt trội khi giảm 81% chi phí token và được người dùng ưu tiên lựa chọn trong 78% các bài kiểm tra so với Claude Cowork.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 46/100

DiffusionOPSD: Khung tự chưng cất chiến lược trực tuyến cho mô hình khuếch tán

DiffusionOPSD tối ưu hóa mô hình khuếch tán bằng cách chuyển đổi phần thưởng hình ảnh thành mục tiêu dự đoán trực tiếp, giúp cải thiện đáng kể hiệu suất và giảm tới 63% thời gian huấn luyện so với các phương pháp hiện có.

25/08

Thứ Ba · 3 tin
Hugging Face Blog
Nghiên cứuĐiểm AI 92/100

Tinh chọnQuantization-Aware Healing: Kỹ thuật nén mô hình 4-bit vượt trội hơn cả bản gốc full-precision

Phương pháp mới giúp tối ưu hóa mô hình AI bằng cách nén xuống 4-bit mà vẫn giữ nguyên hoặc cải thiện hiệu suất so với mô hình gốc, giải quyết bài toán đánh đổi giữa tốc độ và độ chính xác.


Vì sao đáng đọc: Đây là bước tiến quan trọng trong tối ưu hóa mô hình, giúp giảm tài nguyên tính toán đáng kể mà không làm mất đi chất lượng, rất hữu ích cho cộng đồng phát triển AI.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 46/100

Apodex 1.1: Bước tiến mới trong khả năng thực thi tác vụ phức tạp của AI Agent

Apodex 1.1 tối ưu hóa khả năng xử lý tài liệu, lập trình và nghiên cứu thông qua cơ chế phối hợp tác tử thông minh. Với phiên bản 35B có thể chạy cục bộ, mô hình đạt hiệu suất vượt trội so với các hệ thống lớn hơn trong nhiều lĩnh vực chuyên môn.

Thêm 1 nguồn khác đưa tinX: Ma Dongxi NLP (@dongxi_nlp)
MiniMax@MiniMax_AI
Sản phẩmĐiểm AI 38/100

MiniMax H3 đạt tốc độ suy luận nhanh gấp 27,7 lần trên chip NVIDIA GB200

The real breakthrough in the NVIDIA SANA team's Sol Engine work on MiniMax H3! By splitting generat…

DịchNhờ công cụ Sol Engine từ đội ngũ NVIDIA SANA, thời gian tạo video 10 giây (768p) của MiniMax H3 đã giảm từ 414 giây xuống còn 14,93 giây, đánh dấu bước tiến vượt bậc về hiệu suất xử lý.

24/08

Thứ Hai · 3 tin
DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 29/100

Mô hình Harness: Giải pháp chuẩn hóa cho các tác nhân AI trong doanh nghiệp

// Applying Anthropic Primitives at Large Enterprises // Frontier models collapsed the cost of writ…

DịchThay vì tùy chỉnh mã nguồn cho từng dự án, bài báo đề xuất sử dụng 'harness' làm khung xương cố định cho các tác nhân AI. Cách tiếp cận này giúp giảm thiểu chi phí bảo trì và kiểm duyệt, đồng thời tối ưu hóa hiệu suất vượt trội hơn cả việc thay đổi mô hình nền tảng.

Tomer Tunguz Blog (phân tích VC)
Hướng dẫnĐiểm AI 62/100

Tinh chọnAI Agent nên 'sống' bao lâu là tối ưu?

Việc để AI Agent chạy quá lâu dễ gây suy giảm khả năng tập trung và rủi ro bảo mật. Giải pháp là thiết lập vòng đời 24 giờ cho trợ lý cá nhân, sử dụng các sub-agent chuyên biệt cho tác vụ ngắn hạn và chỉ lưu trữ các tùy chỉnh quan trọng vào cuối ngày.


Vì sao đáng đọc: Bài viết đưa ra góc nhìn thực tiễn và giải pháp kỹ thuật cụ thể cho vấn đề quản lý bộ nhớ của AI Agent, rất hữu ích cho người dùng và lập trình viên.
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 36/100

Active Inference: Giải pháp giúp AI tự quyết định khi nào cần nạp thêm dữ liệu

AI agents have an expensive problem: when a request is missing information, they either guess too ea…

DịchNghiên cứu mới đề xuất cơ chế Active Inference giúp AI tự đánh giá chi phí và lợi ích trước khi thực hiện các thao tác như tìm kiếm hay gọi công cụ, giúp tối ưu hóa hiệu suất và độ chính xác thay vì thực hiện tự động.

23/08

Chủ Nhật · 2 tin
Clément Delangue (Hugging Face CEO)@ClementDelangue
Hướng dẫnĐiểm AI 34/100

NVIDIA đạt điểm tuyệt đối trong thử thách ARC-AGI-3 với khung lập trình tự động

NVIDIA built its own coding harness to optimize CUDA GPU kernels and achieved a 100% score on ARC-AG…

DịchNVIDIA vừa ra mắt khung lập trình giúp tối ưu hóa nhân CUDA, đạt tỷ lệ giải quyết 100% các bài toán trong ARC-AGI-3. Bước tiến này hứa hẹn sẽ hạ thấp rào cản kỹ thuật, giúp việc huấn luyện và tối ưu hóa AI trở nên dễ dàng hơn cho mọi người.

22/08

Thứ Bảy · 3 tin
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 36/100

Học tập liên tục cho AI Agent: Thay đổi hành vi mà không cần huấn luyện lại mô hình

An agent can improve without retraining the model. Once agents rewrite their own prompts, memory, a…

DịchNghiên cứu mới giới thiệu khung 'Học tập liên tục theo cấu trúc' (HCL), cho phép AI Agent cập nhật hành vi bằng cách tinh chỉnh prompt, bộ nhớ và định tuyến thay vì huấn luyện lại tham số. Phương pháp này coi các thay đổi cấu trúc như mã nguồn, cần kiểm thử hồi quy trước khi áp dụng.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 37/100

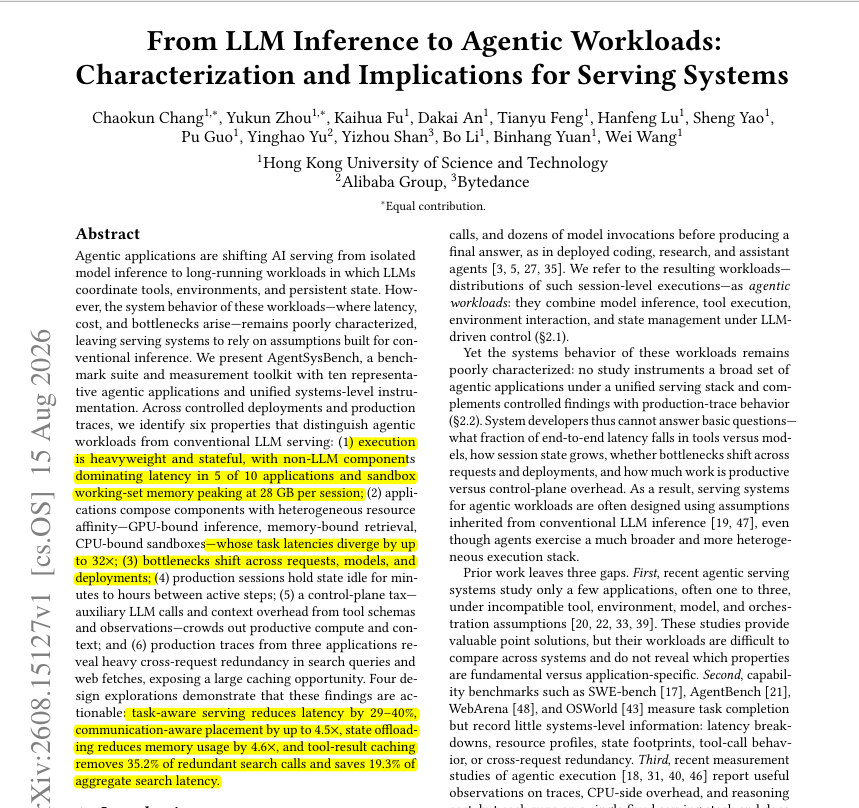
Nghiên cứu mới từ Alibaba và ByteDance: Kiến trúc hệ thống là chìa khóa cho AI Agent

New Alibaba ByteDance paper shows that AI agents can no longer be served like ordinary LLM requests….

DịchAlibaba và ByteDance chỉ ra rằng hiệu năng AI Agent không còn phụ thuộc vào mô hình mà nằm ở sự phối hợp giữa công cụ, bộ nhớ và môi trường. Việc tối ưu hóa kiến trúc hệ thống giúp giảm độ trễ đáng kể và tăng tốc độ xử lý gấp nhiều lần so với chỉ tập trung vào tốc độ suy luận.

LMSYS: Blog (nhóm Chatbot Arena)
Nghiên cứuĐiểm AI 63/100

Tinh chọnLing-3.0-flash: Tối ưu hóa độ trễ giải mã lên 54% trên 4 GPU Blackwell

Đội ngũ Ant Group và RadixArk đã tối ưu hóa mô hình Ling-3.0-flash, giúp tăng tốc độ giải mã đơn yêu cầu từ 288 lên 606 tok/s và giảm độ trễ TPOT xuống còn 1.53 ms nhờ kiến trúc MoE cải tiến.


Vì sao đáng đọc: Đây là một bước tiến kỹ thuật quan trọng trong việc tối ưu hóa suy luận mô hình MoE trên phần cứng Blackwell, mang lại giá trị thực tiễn cao cho cộng đồng kỹ thuật.

21/08

Thứ Sáu · 4 tin
Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (65 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Tối ưu hóa AI” — Trang 3 | AIHOT.vn