07/09

Thứ Hai · 4 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnIris: Đột phá mới trong công nghệ tìm kiếm bằng AI

Giới thiệu Iris-mini và Iris-pro, hai tác nhân tìm kiếm thông minh được huấn luyện qua quy trình xây dựng dữ liệu từ cấu trúc siêu liên kết web, giúp giải quyết các truy vấn phức tạp mà mô hình truyền thống thường thất bại.


Vì sao đáng đọc: Nghiên cứu quan trọng về tối ưu hóa tác nhân tìm kiếm (search agents) bằng RL và SFT, có tiềm năng thay đổi cách AI truy xuất thông tin thực tế.

05/09

Thứ Bảy · 2 tin
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 44/100

Tại sao tư duy coi LLM chỉ là 'máy dự đoán token tiếp theo' đã lỗi thời?

Tác giả lập luận rằng việc coi LLM chỉ là máy dự đoán token là cách hiểu phiến diện. Với sự hỗ trợ của RLHF và RLVR, các mô hình hiện nay đã vượt xa khả năng bắt chước văn bản thuần túy, hoạt động giống như các cỗ máy tìm kiếm giải pháp tối ưu thay vì chỉ sao chép dữ liệu huấn luyện.

04/09

Thứ Sáu · 7 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 41/100

DRACO: Tối ưu hóa phân bổ tín dụng cho tác nhân AI dài hạn bằng tiêu chuẩn đánh giá động

DRACO giải quyết bài toán thiếu tín hiệu phản hồi trong huấn luyện tác nhân dài hạn bằng cách tự động tạo tiêu chuẩn đánh giá theo quỹ đạo, giúp phân bổ điểm số chính xác cho từng bước mà không cần thêm mô-đun quy gán phức tạp.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 45/100

Environment Evolution: Phương pháp tiến hóa môi trường giúp Agent đầu cuối học tập liên tục

Nghiên cứu đề xuất phương pháp tiến hóa môi trường bằng cách tăng dần độ khó theo thế hệ, tạo tín hiệu học tập bền vững cho quá trình huấn luyện các Agent đầu cuối.

AK@_akhaliq
Nghiên cứuĐiểm AI 24/100

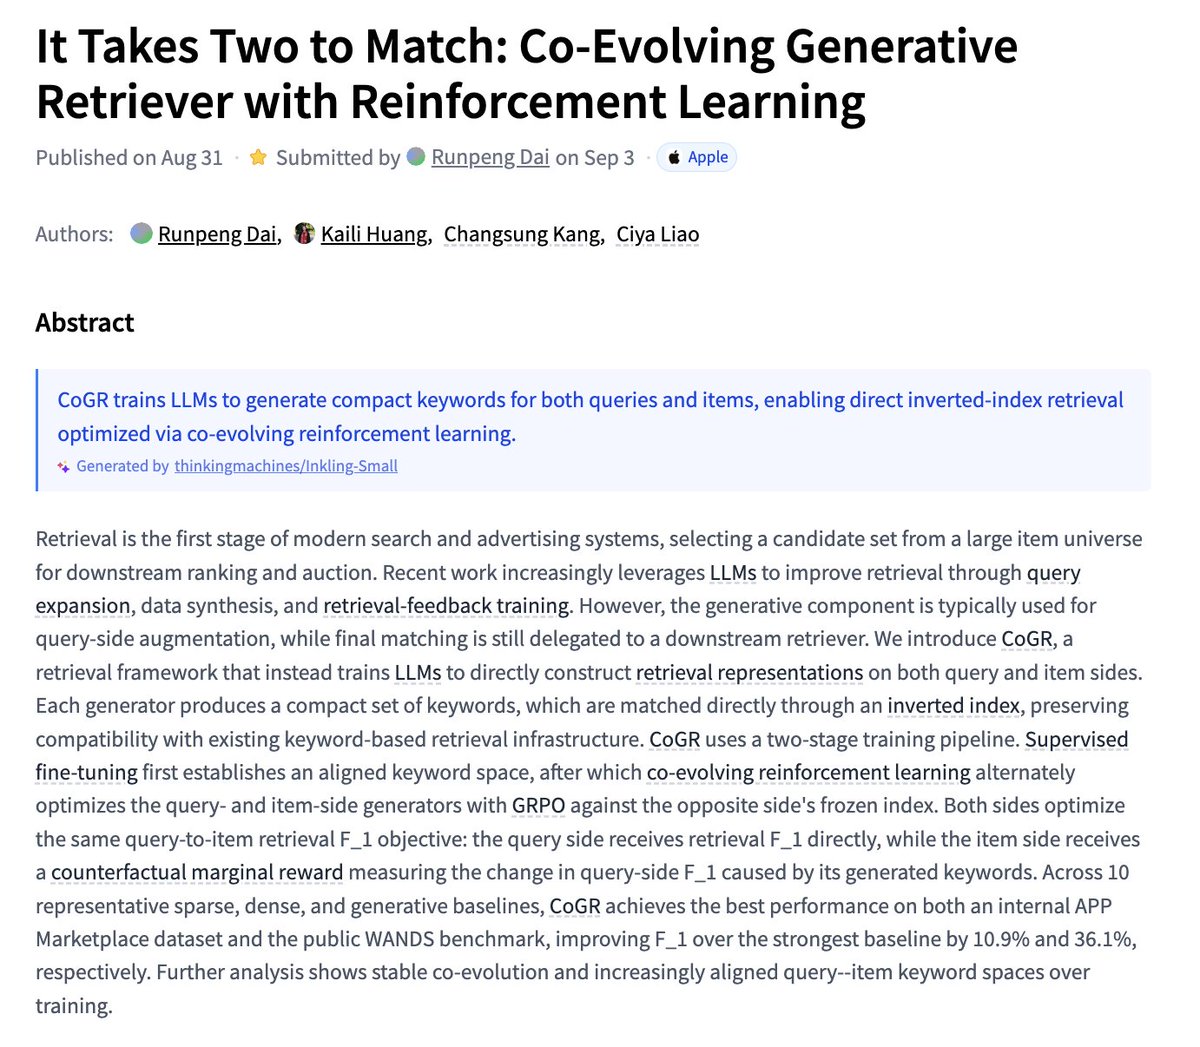
CoGR: Bước tiến mới trong tối ưu hóa truy vấn bằng học tăng cường

It Takes Two to Match Co-Evolving Generative Retriever with Reinforcement Learning paper: https://...

DịchNghiên cứu giới thiệu CoGR, phương pháp huấn luyện LLM đồng bộ hóa từ khóa giữa truy vấn và sản phẩm thông qua học tăng cường (GRPO), giúp cải thiện đáng kể hiệu suất tìm kiếm so với các phương pháp truyền thống.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 42/100

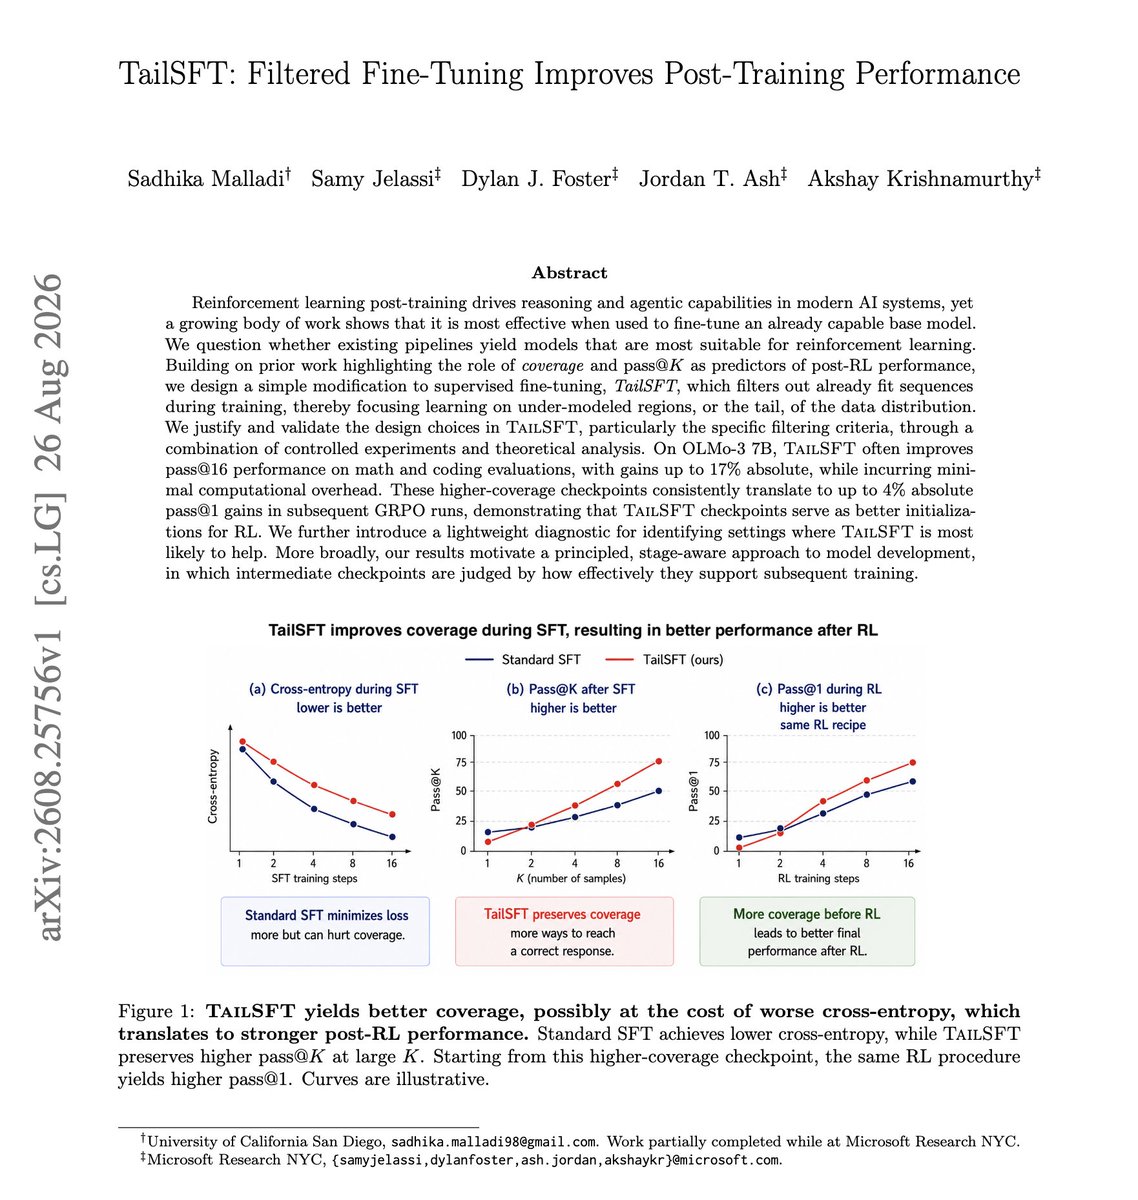
Microsoft và UCSD giới thiệu TailSFT: Loại bỏ dữ liệu quá khớp để tối ưu hóa học tăng cường (RL)

New Microsoft plus Univ of San Diego paper shows a model can look better after SFT but actually be a…

DịchNghiên cứu chỉ ra rằng việc tinh chỉnh (SFT) quá mức có thể xóa bỏ các hành vi hiếm gặp nhưng quan trọng, khiến mô hình trở thành điểm khởi đầu kém hiệu quả cho quá trình học tăng cường (RL).

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Sử dụng mô hình ngôn ngữ nhỏ làm giám khảo cho học tăng cường dựa trên tiêu chí

Nghiên cứu đánh giá khả năng thay thế các mô hình lớn bằng các mô hình ngôn ngữ nhỏ (như Qwen3-1.7B) để làm giám khảo chấm điểm trong học tăng cường, giúp giảm chi phí tính toán mà vẫn đảm bảo độ chính xác.

03/09

Thứ Năm · 7 tin
JiQiZhiXin
Nghiên cứuĐiểm AI 88/100

Tinh chọnEASE: Khi mô hình AI trả lời đúng nhưng 'nhìn nhầm' ảnh - Giải pháp từ Đại học Công nghệ Cáp Nhĩ Tân

Nghiên cứu giới thiệu EASE, phương pháp giúp mô hình đa phương thức không chỉ trả lời đúng mà còn phải 'nhìn' đúng vào vùng dữ liệu bằng chứng trên ảnh, giúp cải thiện đáng kể độ tin cậy của các mô hình VLM.


Vì sao đáng đọc: Giải quyết vấn đề cốt lõi trong suy luận đa phương thức (VLM) là 'đoán mò' thay vì hiểu ảnh. Phương pháp thực tiễn, có số liệu kiểm chứng rõ ràng trên các mô hình Qwen.
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 44/100

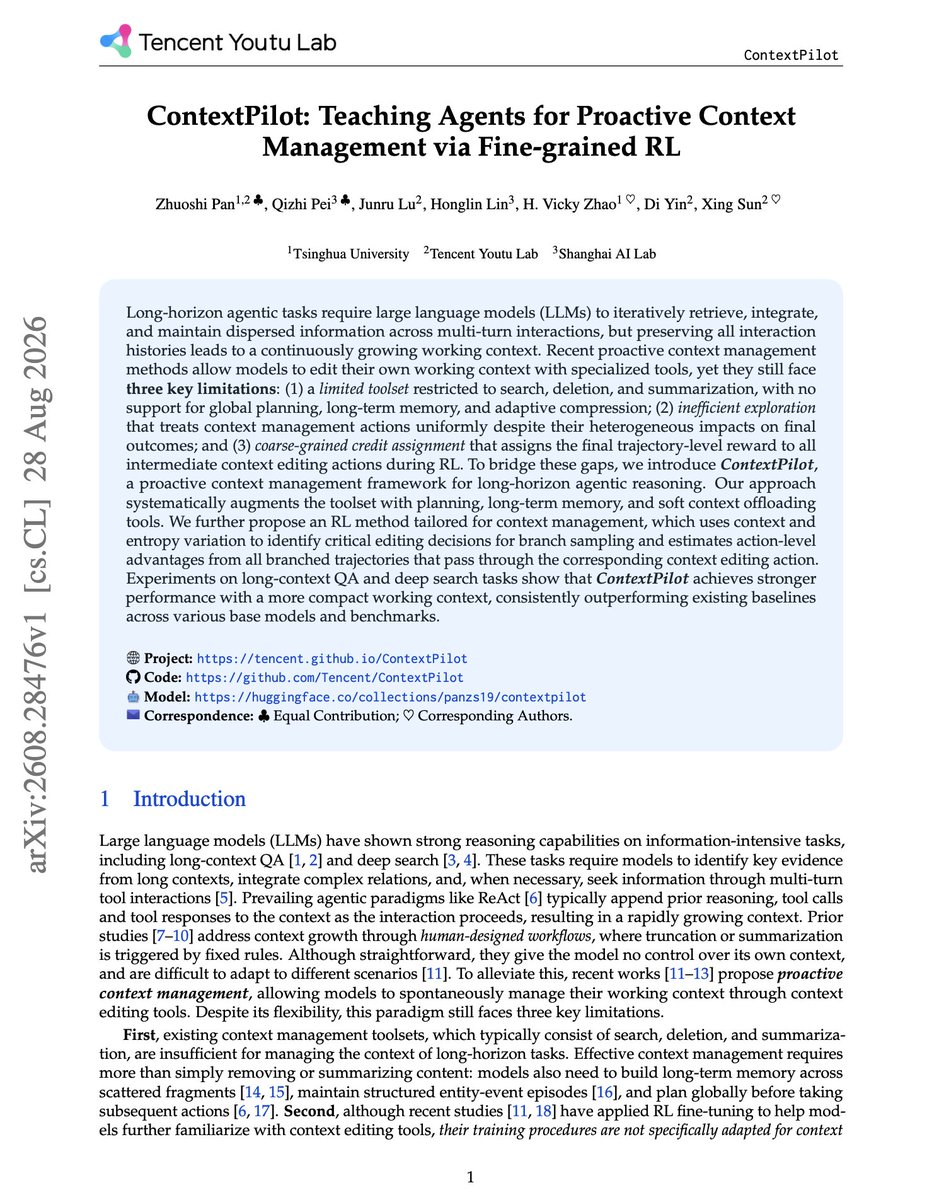
ContextPilot: Tối ưu hóa quản lý ngữ cảnh cho AI bằng học tăng cường (RL)

Long-running agents do not just need a bigger context window. They need to learn what deserves to st…

DịchContextPilot là phương pháp mới giúp AI chủ động quản lý bộ nhớ thông qua việc tự quyết định lưu trữ, nén hoặc xóa dữ liệu cũ, sử dụng học tăng cường để tối ưu hóa hiệu quả xử lý.

Hugging Face: Blog
Hướng dẫnĐiểm AI 62/100

Tinh chọnHugging Face hướng dẫn huấn luyện AI vẽ tranh màu nước bằng code thông qua TRL và OpenEnv

Hugging Face chia sẻ quy trình mã nguồn mở sử dụng TRL, OpenEnv và mô hình Qwen3.5 để huấn luyện AI viết code JavaScript vẽ tranh màu nước, kèm theo toàn bộ dữ liệu và môi trường thực thi.


Vì sao đáng đọc: Bài viết cung cấp quy trình thực hành (hands-on) chi tiết và mã nguồn mở, rất hữu ích cho các kỹ sư muốn tìm hiểu về RL trong lập trình sáng tạo.
Aravind Srinivas (Perplexity CEO)@AravSrinivas
Sản phẩmĐiểm AI 38/100

CEO Perplexity ra mắt dự án mã nguồn mở miles: Dịch vụ RL-as-a-service

open-source RL-as-a-service https://github.com/radixark/miles

DịchAravind Srinivas, CEO của Perplexity, vừa giới thiệu dự án mã nguồn mở 'miles' cung cấp dịch vụ RL-as-a-service trên GitHub. Hiện tại, các thông tin chi tiết về tính năng cụ thể của dự án vẫn chưa được công bố.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 44/100

Cliff: Chiến lược định hình phần thưởng RLVR học từ lỗi sai đầu tiên

Cliff sử dụng LLM làm giáo viên để phát hiện lỗi sai sớm trong quá trình suy luận, từ đó tối ưu hóa mô hình bằng cách phân tách chuỗi phản hồi thành phần đúng và sai. Phương pháp này vượt trội hơn các kỹ thuật truyền thống như GRPO tới 7%, ngay cả khi giáo viên có năng lực hạn chế.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

CoGR: Bước tiến mới trong hệ thống tìm kiếm với mô hình ngôn ngữ lớn đồng tiến hóa

CoGR là khung làm việc đột phá cho phép LLM trực tiếp tạo ra các biểu diễn từ khóa cho cả truy vấn và sản phẩm, giúp tối ưu hóa hệ thống tìm kiếm mà vẫn tương thích với hạ tầng chỉ mục ngược hiện có.

02/09

Thứ Tư · 5 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Học cách suy luận hình học đa phương thức thông qua cơ chế phân bổ tín dụng

Nghiên cứu giới thiệu phương pháp suy luận mới giúp mô hình VLM xác định chính xác các bước logic quan trọng trong bài toán hình học, từ đó tối ưu hóa việc học thông qua mã thực thi và phân bổ tín dụng cục bộ thay vì chỉ dựa vào kết quả cuối cùng.

JiQiZhiXin
Nghiên cứuĐiểm AI 88/100

Tinh chọnUniSteer: Đột phá mới giúp robot học kỹ năng tinh vi thông qua sự hướng dẫn của con người

UniSteer giải quyết bài toán khó trong học tăng cường cho robot bằng cách chuyển đổi hành động của con người thành tín hiệu nhiễu, giúp mô hình VLA học các thao tác chính xác như xếp hạt nhựa chỉ với lượng dữ liệu tối thiểu.


Vì sao đáng đọc: Giải pháp kỹ thuật thông minh cho vấn đề thực tế trong robot học, kết hợp hiệu quả giữa VLA và học tăng cường, có tính ứng dụng cao và đã được kiểm chứng qua thử nghiệm thực tế.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

InternReviewer & InternAdvocate: Hệ thống AI tự động hóa quy trình phản biện và bảo vệ luận văn khoa học

Nghiên cứu giới thiệu bộ đôi tác nhân AI chuyên biệt giúp tự động hóa việc viết phản biện và phản hồi bài báo khoa học, sử dụng học tăng cường (RL) và cơ chế kiểm chứng thực tế để giảm thiểu hiện tượng ảo giác.

Thomas Wolf (Hugging Face đồng sáng lập/CSO)@Thom_Wolf
Hướng dẫnĐiểm AI 38/100

Thomas Wolf chia sẻ video dùng chú vịt đồ chơi giải thích về học tăng cường (RL)

RL explained with ducks

DịchĐồng sáng lập Hugging Face, Thomas Wolf, đã chia sẻ một video thú vị sử dụng chú vịt Microduck để minh họa quá trình học đi bằng phương pháp học tăng cường (Reinforcement Learning), giúp khái niệm kỹ thuật trở nên dễ hiểu và gần gũi hơn.

01/09

Thứ Ba · 7 tin
X.PIN@thexpin
Sản phẩmĐiểm AI 57/100

Robot hai chân Microduck của Hugging Face đạt hơn 10.000 đơn đặt hàng

Hugging Face's US$399 Microduck has attracted more than 10, 000 pre-orders, with the development team…

DịchMẫu robot để bàn mã nguồn mở Microduck giá 399 USD của Hugging Face đang gây sốt với hơn 10.000 đơn đặt trước. Thiết bị này được thiết kế để hỗ trợ các nhà phát triển thử nghiệm học tăng cường trên phần cứng thực tế.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

DIEM: Tối ưu hóa chọn lọc dữ liệu động trong tinh chỉnh mô hình bằng học tăng cường

DIEM là khung làm việc tự động giúp tối ưu hóa việc chọn lọc dữ liệu trong quá trình tinh chỉnh mô hình bằng học tăng cường (RFT), bằng cách đánh giá đóng góp của từng mẫu dữ liệu theo thời gian thực để cải thiện hiệu suất học tập.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 42/100

Đề xuất khung L0-L4: Lộ trình giúp mô hình suy luận AI vượt xa sự giám sát của con người

Nghiên cứu giới thiệu khung 5 cấp độ (L0-L4) giúp các mô hình suy luận lớn (LRM) tự tiến hóa mà không cần sự can thiệp của con người, thông qua việc tự động hóa quá trình xác thực và tạo lộ trình học tập.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 48/100

Nghiên cứu cơ chế chưng cất On-Policy và đề xuất phương pháp không giám sát OPSA

Nghiên cứu chỉ ra rằng hiệu quả của chưng cất On-Policy (OPD) chủ yếu đến từ việc ức chế các token có xác suất thấp thay vì phụ thuộc vào giáo viên. Từ đó, nhóm tác giả đề xuất OPSA, phương pháp không cần giám sát giúp tối ưu hóa mô hình hiệu quả hơn.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 48/100

ContextLeak: Nghiên cứu mới từ Duke về kỹ thuật dùng AI để đánh cắp dữ liệu từ LLM Agent

// ContextLeak in AI Agents // The whole attack surface here is a tool name and a tool description….

DịchCác nhà nghiên cứu tại Đại học Duke đã phát triển ContextLeak, một phương pháp sử dụng học tăng cường để tạo ra các công cụ độc hại nhằm đánh cắp dữ liệu nhạy cảm từ LLM Agent, bao gồm lịch sử hội thoại và các tiến trình thực thi.

Thêm 1 nguồn khác đưa tinX: Rohan Paul (@rohanpaul_ai)
Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 42/100

Cùng sự kiệnTencent ra mắt ContextPilot: Tối ưu hóa quản lý ngữ cảnh cho AI bằng học tăng cường

Interesting paper from Tencent. Tencent trains an agent to manage its own working context, and assi…

DịchTencent cùng các đối tác giới thiệu ContextPilot, một phương pháp giúp AI chủ động quản lý ngữ cảnh làm việc thông qua học tăng cường, cho phép hệ thống tự quyết định lưu trữ hoặc nén thông tin thay vì chỉ loại bỏ, giúp tối ưu hóa bộ nhớ dài hạn và khả năng lập kế hoạch.

Cùng sự kiện, bài đại diện «ContextPilot: Tối ưu hóa quản lý ngữ cảnh cho AI Agent thông qua học tăng cường chi tiết»
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 39/100

CREST: Phương pháp phân bổ tín dụng thông minh cho tác nhân AI đa vòng

This paper shows a better way to train multi-turn agents: score each turn separately, then use a s…

DịchNghiên cứu giới thiệu khung CREST giúp tối ưu hóa việc học cho các tác nhân LLM đa bước bằng cách phân bổ tín dụng phân tầng. Mô hình tự đóng vai trò giáo viên để điều chỉnh trọng số học tập dựa trên độ tin cậy của các quyết định, giúp cải thiện hiệu suất mà không làm thay đổi kết quả kiểm chứng.

31/08

Thứ Hai · 4 tin
Rohan Paul@rohanpaul_ai
Hướng dẫnĐiểm AI 56/100

OpenAI chi mạnh tay mua hàng chục nghìn máy Mac để huấn luyện AI điều khiển máy tính

POV: somewhere inside OpenAI. truckload of Macs are training computer-use-agents.

DịchOpenAI đang đẩy mạnh thu mua Mac mini và Mac Studio với số lượng lớn để phục vụ việc huấn luyện các tác nhân AI có khả năng tự vận hành máy tính thông qua học tăng cường.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

RCCA: Tối ưu hóa học tăng cường cho lập trình web thông qua phân bổ tín hiệu theo tiêu chí

RCCA là khung học tăng cường mới giúp cải thiện khả năng tạo ứng dụng web bằng cách chia nhỏ phản hồi chức năng thành các tín hiệu tối ưu hóa cục bộ, thay vì đánh giá toàn bộ mã nguồn như các phương pháp truyền thống.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

ContextPilot: Tối ưu hóa quản lý ngữ cảnh cho AI Agent thông qua học tăng cường chi tiết

ContextPilot giải quyết vấn đề quá tải ngữ cảnh trong các tác vụ dài hạn bằng cách cho phép AI tự quản lý và tinh chỉnh bộ nhớ hiệu quả hơn thông qua học tăng cường (RL) phân cấp, thay vì chỉ tóm tắt hay xóa dữ liệu thô sơ.

Thêm 2 nguồn khác đưa tinX: Elvis Saravia (@omarsar0, DAIR.AI)X: Rohan Paul (@rohanpaul_ai)
DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 44/100

TailSFT: Phương pháp mới từ Microsoft giúp tối ưu hóa SFT để tăng cường hiệu suất RL

Interesting technical work from Microsoft. Provides a better understanding on SFT and how to levera…

DịchMicrosoft giới thiệu TailSFT, kỹ thuật lọc dữ liệu giúp mô hình tập trung vào các phần chưa tối ưu thay vì lãng phí tài nguyên vào những gì đã học tốt, từ đó cải thiện đáng kể khả năng lập trình và toán học sau khi huấn luyện tăng cường (RL).

30/08

Chủ Nhật · 1 tin
Rohan Paul@rohanpaul_ai
Hướng dẫnĐiểm AI 26/100

Học tăng cường giúp robot chạy hiệu quả hơn nhờ tư thế đổ người về phía trước

Reinforcement learning apparently kept this running posture over human form A person swings the arm…

DịchThay vì giữ dáng đứng thẳng, robot sử dụng học tăng cường để nghiêng người về phía trước, giúp tối ưu hóa trọng tâm, giảm áp lực lên động cơ và chuyển hóa năng lượng thành tốc độ di chuyển hiệu quả hơn.

28/08

Thứ Sáu · 2 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnPhát triển game bằng AI: Đột phá mới trong việc huấn luyện mô hình thế giới thông qua dữ liệu có thể kiểm chứng

Nghiên cứu đề xuất sử dụng công cụ phát triển game làm môi trường huấn luyện mô hình thế giới, cung cấp tín hiệu phản hồi chính xác về vật lý và va chạm thay vì dựa vào các chỉ số mơ hồ như CLIP.


Vì sao đáng đọc: Hướng tiếp cận mới mẻ, giải quyết bài toán thiếu dữ liệu chất lượng cao cho mô hình thế giới bằng cách tận dụng tính thực thi của game engine.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 45/100

TTPO: Tối ưu hóa chiến lược khi kiểm thử, giúp mô hình ngôn ngữ lớn tự học mà không cần nhãn

TTPO giới thiệu phương pháp tự học không cần nhãn bằng cách sử dụng bình chọn đa số làm nhãn giả và học tăng cường nhóm để tinh chỉnh mô hình. Kỹ thuật này giúp cải thiện đáng kể hiệu suất suy luận toán học của các mô hình nhỏ như Qwen3-1.7B, đạt kết quả ngang ngửa với phương pháp có giám sát.

27/08

Thứ Năm · 6 tin
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Sản phẩmĐiểm AI 51/100

Cùng sự kiệnPollen Robotics (Hugging Face) ra mắt robot hai chân mã nguồn mở Microduck giá 399 USD

Microduck là robot hai chân cao 25cm hỗ trợ học tăng cường, được trang bị đầy đủ cảm biến và phần mềm mã nguồn mở, cho phép người dùng huấn luyện trong môi trường mô phỏng MuJoCo trước khi triển khai thực tế.

Cùng sự kiện, bài đại diện «Hugging Face ra mắt robot hình vịt Microduck: Giá 399 USD, biết nhặt đồ và có giọng nói riêng»
Thomas Wolf (Hugging Face đồng sáng lập/CSO)@Thom_Wolf
Sản phẩmĐiểm AI 56/100

Ra mắt Microduck: Robot hai chân mã nguồn mở giá dưới 400 USD

We have a huge news to share today! Today we are unveiling the first truly accessible RL robot - we…

DịchĐồng sáng lập Hugging Face vừa giới thiệu Microduck, robot hai chân nhỏ gọn tích hợp AI, LiDAR và camera, cho phép người dùng tự huấn luyện bằng học tăng cường với chi phí cực rẻ.

Thêm 6 nguồn khác đưa tinX: Clément Delangue (Hugging Face CEO) (@ClementDelangue)MarkTechPostX: AI Notes (@AYi_AInotes)TechCrunch: AIX: Kim (@kimmonismus)Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (77 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Học tăng cường” — Trang 3 | AIHOT.vn