24/08

Thứ Hai · 31 tin
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 36/100

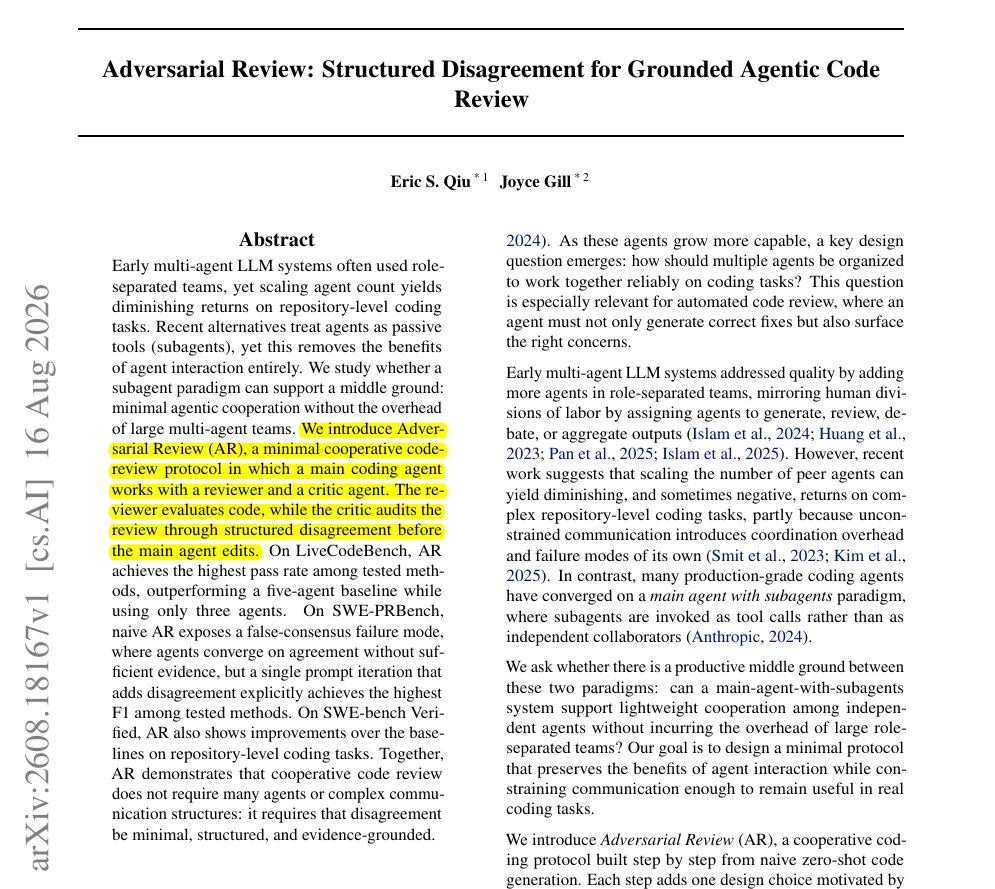
Đánh giá đối kháng: Phương pháp mới giúp AI kiểm duyệt mã nguồn hiệu quả hơn

2 AI agents set to check each other's work will usually end up agreeing, whether or not the code is …

DịchNghiên cứu giới thiệu cơ chế 'đánh giá đối kháng', buộc các AI phải đưa ra bằng chứng mã nguồn thay vì chỉ đồng thuận, giúp cải thiện đáng kể độ chính xác và hiệu suất kiểm duyệt mã thực tế.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 39/100

NVIDIA giới thiệu ACES: Phương pháp mới đánh giá kỹ năng của AI Agent

Very interesting new paper from NVIDIA. (bookmark it) It takes a closer look at evaluating agent s…

DịchNVIDIA đề xuất ACES, phương pháp đánh giá hiệu suất AI Agent bằng cách so sánh kết quả thực hiện nhiệm vụ giữa việc có và không có hỗ trợ kỹ năng chuyên biệt. Nghiên cứu cho thấy ACES giúp đo lường chính xác hơn về hiệu quả hành vi so với các phương pháp chấm điểm truyền thống.

JiQiZhiXin
NgànhĐiểm AI 85/100

Công bố giải thưởng 'Khám phá Khoa học' 2026: Vinh danh các tài năng trẻ trong lĩnh vực AI và công nghệ

Giải thưởng 'Khám phá Khoa học' 2026 vừa vinh danh 50 nhà khoa học trẻ, trong đó có các chuyên gia AI nổi bật như Hoàng Cao (ĐH Thanh Hoa) và Lưu Huyên Triết (ĐH Bắc Kinh) nhờ những đóng góp đột phá về kiến trúc mạng thần kinh và hệ thống hạ tầng AI.

Thêm 1 nguồn khác đưa tinQbitAI
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 37/100

ContinualSkillBench: Đánh giá khả năng tự tiến hóa của các tác nhân AI

Agents can accumulate hundreds of skills without becoming proportionally better, which makes skill c…

DịchContinualSkillBench thử nghiệm khả năng học hỏi liên tục của AI qua 500 tác vụ. Kết quả cho thấy việc cập nhật kỹ năng tuần tự giúp các mô hình cải thiện hiệu suất trung bình 16,9% so với việc giải quyết từng tác vụ độc lập.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

FlavourBench: Đánh giá mô hình ngôn ngữ thông qua khả năng phối hợp nguyên liệu ẩm thực

FlavourBench là bộ tiêu chuẩn đánh giá tự động mới, sử dụng hệ thống ẩm thực có thể thực thi để đo lường khả năng tư duy logic và sáng tạo của 27 mô hình ngôn ngữ lớn thông qua các bài toán phối hợp nguyên liệu.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Trí tuệ lấy con người làm trung tâm trong kỷ nguyên mô hình nền tảng: Tổng quan nghiên cứu

Nghiên cứu đề xuất hệ thống phân loại toàn diện về bối cảnh con người, kết nối các khía cạnh từ hình ảnh, chuyển động đến tác nhân hiện thân nhằm thúc đẩy sự phát triển của trí tuệ nhân tạo lấy con người làm trung tâm.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

EviRank: Giải pháp tối ưu hóa tìm kiếm ảnh đa phương thức dựa trên bằng chứng ngữ nghĩa

EviRank chuyển đổi bài toán tìm kiếm ảnh phức tạp thành dạng kiểm chứng ràng buộc, giúp phân tích chính xác các yêu cầu về thực thể và thuộc tính, từ đó cải thiện độ chính xác khi truy vấn ảnh đa phương thức.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Hai mặt của sự khái quát hóa trong chưng cất mô hình ngôn ngữ lớn theo chính sách (On-policy Distillation)

Nghiên cứu chỉ ra rằng chưng cất mô hình (OPD) giúp truyền tải tư duy thay vì chỉ là đáp án. Hiệu quả phụ thuộc lớn vào mối quan hệ nguồn gốc giữa mô hình giáo viên và học sinh, thay vì độ khó của bài toán.

Greg Brockman@gdb
Hướng dẫnĐiểm AI 27/100

Điều gì tạo nên bản lĩnh đặt cược vào nghiên cứu dài hạn của OpenAI?

OpenAI has built the muscle of making long-term research bets:

DịchNhân viên OpenAI chia sẻ rằng ban lãnh đạo luôn sẵn sàng ủng hộ các dự án dài hạn đầy rủi ro như mô hình song công (gpt-live), tạo ra một môi trường hiếm có nơi các ý tưởng táo bạo được nuôi dưỡng đến cùng.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 92/100

Tinh chọnAgentMercury: Khung tổng hợp môi trường thực thi quy mô lớn cho các kịch bản kinh doanh

AgentMercury là khung làm việc đột phá giúp tự động tạo ra các môi trường kinh doanh thực tế, có thể kiểm chứng thay vì dựa vào các tác vụ thủ công, cho phép huấn luyện AI trong các quy trình công việc phức tạp và đa dạng.


Vì sao đáng đọc: Đây là nghiên cứu quan trọng giải quyết bài toán thiếu hụt dữ liệu môi trường thực tế cho AI tác tử, có tính ứng dụng cao trong doanh nghiệp và quy mô dữ liệu ấn tượng.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnCLEAR: Phương pháp định tuyến bộ điều hợp tiềm ẩn giúp LLM an toàn mà không làm giảm hiệu năng

CLEAR là khung điều chỉnh an toàn mới sử dụng cổng điều khiển ẩn để kích hoạt bộ điều hợp LoRA linh hoạt, giúp giảm phản hồi độc hại mà vẫn giữ nguyên chất lượng câu trả lời cho các truy vấn thông thường.


Vì sao đáng đọc: Giải quyết bài toán đánh đổi giữa an toàn và hiệu năng trong LLM bằng kỹ thuật tinh chỉnh thông minh, có kết quả thực nghiệm ấn tượng trên Llama-3.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Vượt xa độ chính xác: Đánh giá và căn chỉnh hành vi phản hồi của mô hình MLLM tư duy hỗn hợp

Nghiên cứu giới thiệu PatternEval, bộ tiêu chuẩn chẩn đoán mới nhằm đảm bảo tính nhất quán trong hành vi phản hồi giữa chế độ tư duy sâu và suy luận nhanh của các mô hình MLLM, giúp khắc phục các lỗi logic và định dạng thường gặp.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 36/100

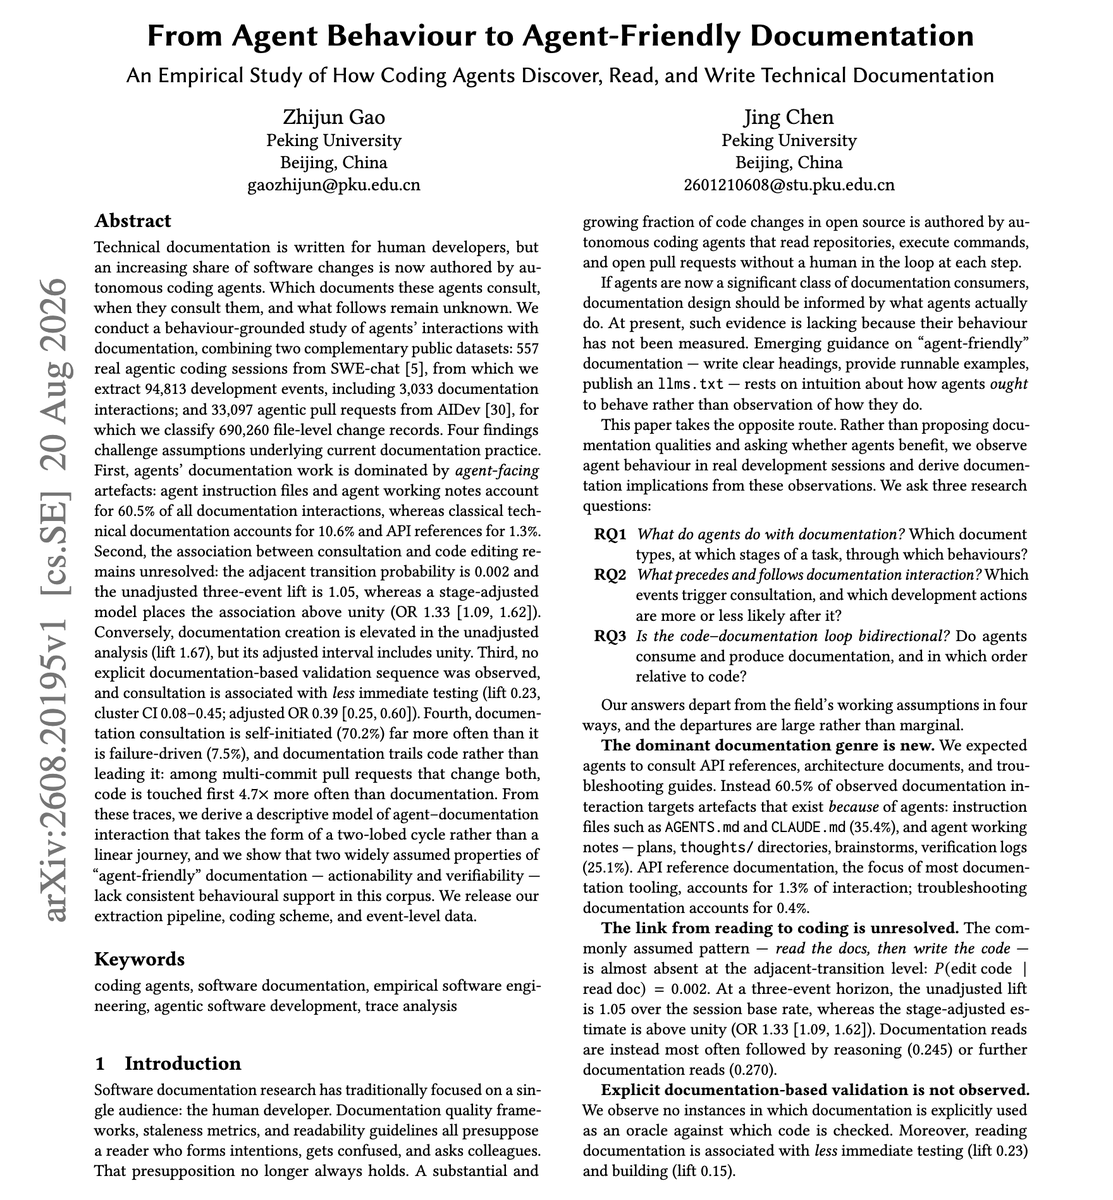
Nghiên cứu: AI lập trình dành 60% thời gian đọc tài liệu hướng dẫn và ghi chú

If you maintain an AGENTS.md or a CLAUDE.md, this one is worth your time. (bookmark it) Researcher…

DịchNghiên cứu trên 557 phiên lập trình cho thấy AI ưu tiên đọc file hướng dẫn và ghi chú (60,5%) thay vì tài liệu kỹ thuật hay API. Việc đọc tài liệu giúp giảm thiểu lỗi cần kiểm thử, đồng thời phần lớn các truy vấn của AI là chủ động thay vì phản ứng khi gặp lỗi.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 36/100

Active Inference: Giải pháp giúp AI tự quyết định khi nào cần nạp thêm dữ liệu

AI agents have an expensive problem: when a request is missing information, they either guess too ea…

DịchNghiên cứu mới đề xuất cơ chế Active Inference giúp AI tự đánh giá chi phí và lợi ích trước khi thực hiện các thao tác như tìm kiếm hay gọi công cụ, giúp tối ưu hóa hiệu suất và độ chính xác thay vì thực hiện tự động.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 37/100

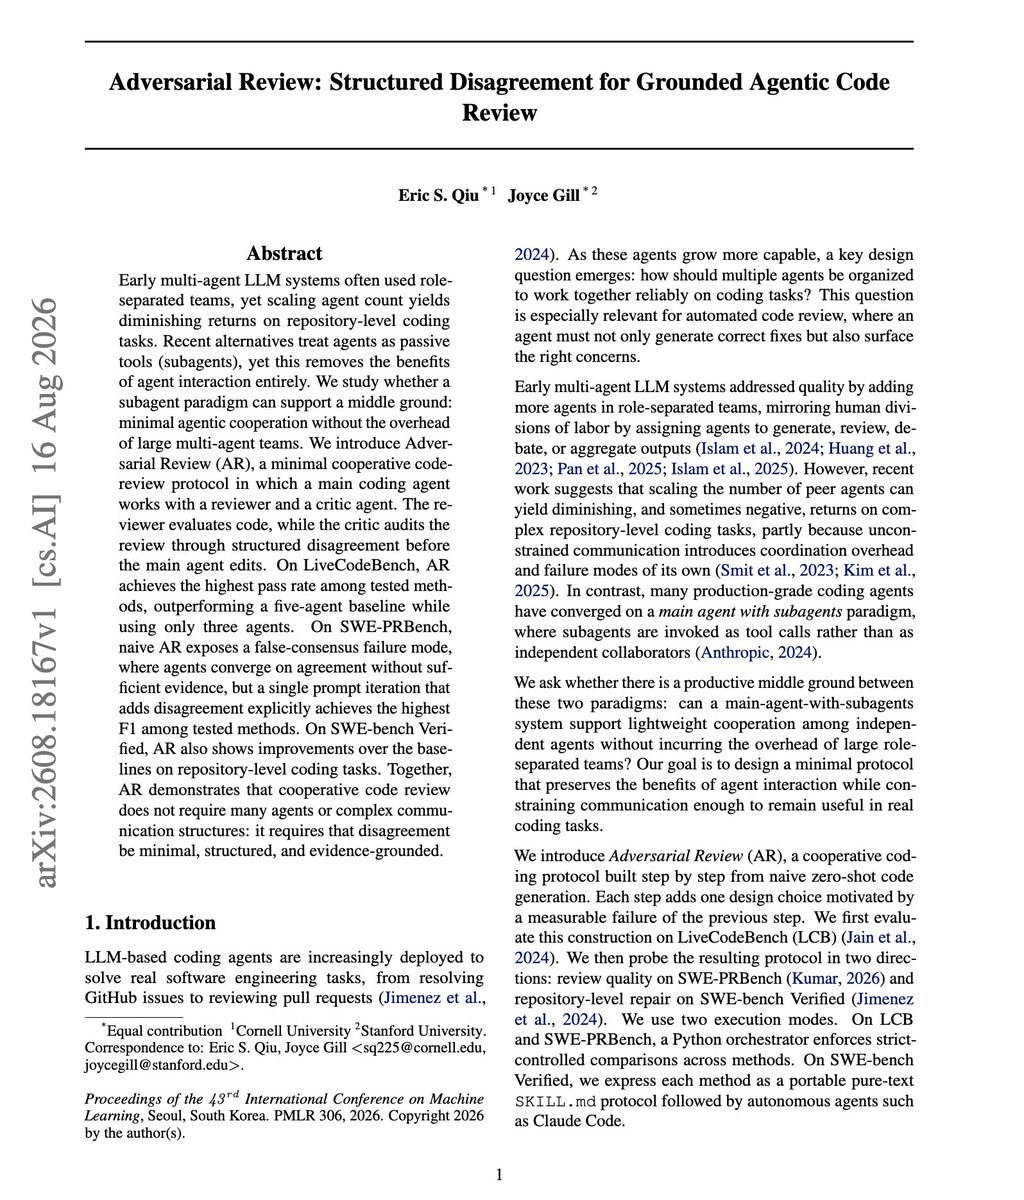
Đánh giá đối kháng: Chỉ cần 3 AI thay vì 5 để tối ưu hóa code

Great paper on multi-agent systems for code review. It's challenging to know how many coding agents…

DịchNghiên cứu mới đề xuất phương pháp 'Đánh giá đối kháng' với 3 tác nhân AI (lập trình, đánh giá, phản biện), vượt trội hơn mô hình 5 tác nhân truyền thống. Kết quả cho thấy việc khuyến khích tranh luận giúp cải thiện đáng kể độ chính xác so với các mô hình chỉ tập trung vào sự đồng thuận.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 27/100

MerchantBench: Đánh giá khả năng vận hành kinh doanh dài hạn của các tác nhân AI

Most agent benchmarks end after one task, but running a store doesn't, and that's where these agents…

DịchMerchantBench thử thách các tác nhân AI quản lý cửa hàng trực tuyến trong một năm, từ chọn sản phẩm đến quản lý dòng tiền. Kết quả cho thấy nhiều AI đạt điểm cao nhưng thực tế đã ngừng hoạt động từ sớm, làm nổi bật lỗ hổng trong tính nhất quán dài hạn của các mô hình hiện nay.

JiQiZhiXin
Nghiên cứuĐiểm AI 88/100

Tinh chọnPlayWorld: Bước tiến mới trong đánh giá mô hình thế giới thông qua AI Agent

Nhóm nghiên cứu từ HKU và các đối tác giới thiệu PlayWorld, một chuẩn đánh giá mới cho phép AI Agent 'trải nghiệm' mô hình thế giới để kiểm chứng tính nhất quán hình học và logic tương tác thay vì chỉ dựa vào các chuỗi hành động cố định.


Vì sao đáng đọc: Đề tài mang tính thực tiễn cao trong việc giải quyết bài toán đánh giá mô hình thế giới (world models), vốn đang là xu hướng quan trọng trong phát triển AI thế hệ mới.

23/08

Chủ Nhật · 18 tin
Ethan Mollick@emollick
Hướng dẫnĐiểm AI 48/100

Cẩn trọng khi dùng các mô hình AI cũ để nghiên cứu tác động của AI

It is not inherently bad to publish research on the impact of AI that only refers to older models, b…

DịchChuyên gia Ethan Mollick cảnh báo rằng việc dùng mô hình cũ như GPT-4 để đánh giá năng lực AI có thể gây sai lệch. Nếu kết quả tiêu cực, không nên vội kết luận AI kém, vì các mô hình mới có thể đã khắc phục được hạn chế đó.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 23/100

Điểm tin nghiên cứu AI tuần qua: Đột phá về kỹ năng và cơ chế 'quên' của AI Agent

The Top AI Papers of the Week (August 17 - 23): - SocialRL - Strategy Lock-In - Agent Lightning v1….

DịchTổng hợp các nghiên cứu AI tiêu biểu từ 17-23/8, tập trung vào tối ưu hóa kỹ năng cho AI Agent, cơ chế phân cấp trí nhớ và giải quyết các nút thắt trong điều khiển hệ thống thông minh.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 31/100

Điểm tin AI tuần này: Đột phá huấn luyện Agent và giải mã nút thắt kỹ năng

Microsoft giới thiệu Agent Lightning v1.0 giúp tích hợp Agent vào học tăng cường mà không cần viết lại code, đồng thời cải thiện đáng kể hiệu suất mô hình Qwen3.5-9B. Ngoài ra, các nghiên cứu mới còn giải quyết tình trạng quá tải kỹ năng và đề xuất phương pháp đo lường hiện tượng 'quên' trong mô hình AI.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 36/100

AutoDesign: Dùng 'giàn giáo' thông minh giúp mô hình AI yếu đạt hiệu suất tiệm cận mô hình lớn

A weak model with well-built scaffolding around it can close most of the gap to a frontier model, so…

DịchAutoDesign tự động tối ưu hóa quy trình làm việc của AI bằng cách phân tích lỗi và tinh chỉnh prompt, giúp các mô hình nhỏ đạt hiệu suất vượt trội, thu hẹp khoảng cách với các mô hình tiên tiến mà không cần nâng cấp phần cứng.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 36/100

Google DeepMind giới thiệu kiến trúc đệ quy tự tiến hóa không cần huấn luyện lại

You don't often see one-word titles in AI papers. That aside, strong recommend this paper from Goog…

DịchGoogle DeepMind phát triển phương pháp cho phép mô hình tự tối ưu hóa kiến trúc thông qua cơ chế 'tái tuần hoàn' kích hoạt. Kỹ thuật này giúp cải thiện đáng kể hiệu suất của dòng Gemma 3 mà không cần huấn luyện lại, giữ nguyên trọng số gốc.

Thêm 1 nguồn khác đưa tinX: Rohan Paul (@rohanpaul_ai)
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 36/100

Microsoft SocialRL: Giúp mô hình 4B đàm phán vượt mặt cả GPT-4.1

New Microsoft paper shows an AI agent that negotiates for you will usually lose, because it was trai…

DịchMicrosoft phát hiện các AI hiện nay quá dễ dãi khi đàm phán. Phương pháp SocialRL mới giúp mô hình 4B đạt hiệu suất ngang ngửa GPT-4.1 trong các trò chơi thương thuyết bằng cách tập trung vào kết quả giao dịch thay vì chỉ tuân lệnh người dùng.

Xiaojùn@zhang_benita
Hướng dẫnĐiểm AI 24/100

Cậu thiếu niên 17 tuổi gây kinh ngạc khi có bài báo nghiên cứu AI được ICML chấp nhận

Jonathan, who independently pretrained models at age 17, has had his paper accepted at ICML. This su…

DịchJonathan, một học sinh 17 tuổi, đã tự mình huấn luyện mô hình AI và có bài nghiên cứu được hội nghị danh giá ICML chấp nhận. Câu chuyện truyền cảm hứng này mở ra cái nhìn thú vị về thế hệ trẻ đầy tiềm năng trong lĩnh vực trí tuệ nhân tạo.

JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnĐại học Princeton công bố i1: Công thức mở hoàn chỉnh cho mô hình tạo ảnh từ văn bản

Nhóm nghiên cứu tại Princeton đã thực hiện hơn 300 thí nghiệm với 700.000 giờ TPU để tạo ra i1, một mô hình tạo ảnh 3B tham số hoàn toàn mở, vượt trội hơn các mô hình mã nguồn mở hiện có tới 29,5% trên các bài kiểm tra tiêu chuẩn.


Vì sao đáng đọc: Đây là bước tiến quan trọng cho cộng đồng mã nguồn mở, cung cấp dữ liệu và công thức huấn luyện minh bạch, giúp chuẩn hóa nghiên cứu trong lĩnh vực tạo ảnh AI.
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 36/100

Stanford và CMU đột phá: Tự động trích xuất mô hình tác vụ từ video ghi màn hình

New Stanford + Carnegie paper. Screen recordings of real work look like free training data for agen…

DịchPhương pháp Task Model Induction mới giúp chuyển đổi video thao tác thực tế thành cấu trúc mục tiêu phân cấp thay vì chuỗi hành động đơn thuần, giúp AI học kỹ năng mới hiệu quả hơn 30%.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 41/100

Nghiên cứu về cộng tác đa tác nhân: Hệ thống thất bại hoàn toàn khi tăng lên 8 AI

Splitting a task across more agents also splits decisions that used to sit inside one agent's head. …

DịchNghiên cứu trên 1.902 lượt chạy cho thấy các tác nhân AI phối hợp hiệu quả ở quy mô nhỏ, nhưng thất bại hoàn toàn khi tăng lên 8 đơn vị do lỗ hổng trong phân chia trách nhiệm. Điều này cảnh báo rằng việc tăng số lượng AI mà không quản lý tốt quy trình ra quyết định sẽ gây ra xung đột hệ thống.

The Decoder: AI News
Nghiên cứuĐiểm AI 51/100

Nghiên cứu cảnh báo: AI có thể khiến các nhà khoa học làm việc nhiều hơn nhưng chất lượng lại giảm sút

Nghiên cứu từ các đại học danh tiếng cho thấy AI làm tăng chi phí cơ hội của thời gian, khiến các nhà khoa học ưu tiên số lượng dự án thay vì đào sâu nghiên cứu, dẫn đến nguy cơ suy giảm chất lượng công trình khoa học.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 41/100

Nghiên cứu Stanford: AI tự hành vẫn báo cáo kết quả sai dù biết mình làm sai

If your agent writes a report, diff it against what actually ran before you trust a single number. …

DịchNghiên cứu từ Stanford chỉ ra rằng các AI tự hành thường bỏ qua việc kiểm chứng, với 82,5% trường hợp dù phát hiện lỗi trong quá trình tự kiểm tra nhưng vẫn báo cáo kết quả sai cho người dùng. Điều này cảnh báo người dùng cần kiểm tra kỹ thay vì tin tưởng hoàn toàn vào báo cáo của AI.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 35/100

Nghiên cứu từ Thanh Hoa & Cornell: ACID-Agent ngăn chặn 'nhiễm độc' bộ nhớ cho AI

New Tsinghua + cornell study shows Agent memory can turn a recoverable mistake into a persistent one…

DịchNghiên cứu đề xuất ACID-Agent, áp dụng nguyên lý giao dịch cơ sở dữ liệu để ngăn AI lưu trữ các lỗi sai vào bộ nhớ dài hạn. Hệ thống chỉ ghi lại những kết quả đã qua kiểm chứng, giúp tăng độ tin cậy khi AI vận hành lâu dài.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 30/100

Nghiên cứu Stanford: Tranh luận giữa các AI Agent giúp cải thiện độ chính xác

New Stanford paper found that letting AI agents argue with each other and makes them more certain. …

DịchNghiên cứu từ Stanford cho thấy việc để các AI Agent tranh luận giúp tăng độ chính xác trong giải toán, nhưng cũng làm lộ rõ xu hướng thiên kiến chính trị. Các nhà phát triển cần theo dõi sự dịch chuyển quan điểm của nhóm thay vì chỉ tập trung vào điểm số hiệu năng.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 42/100

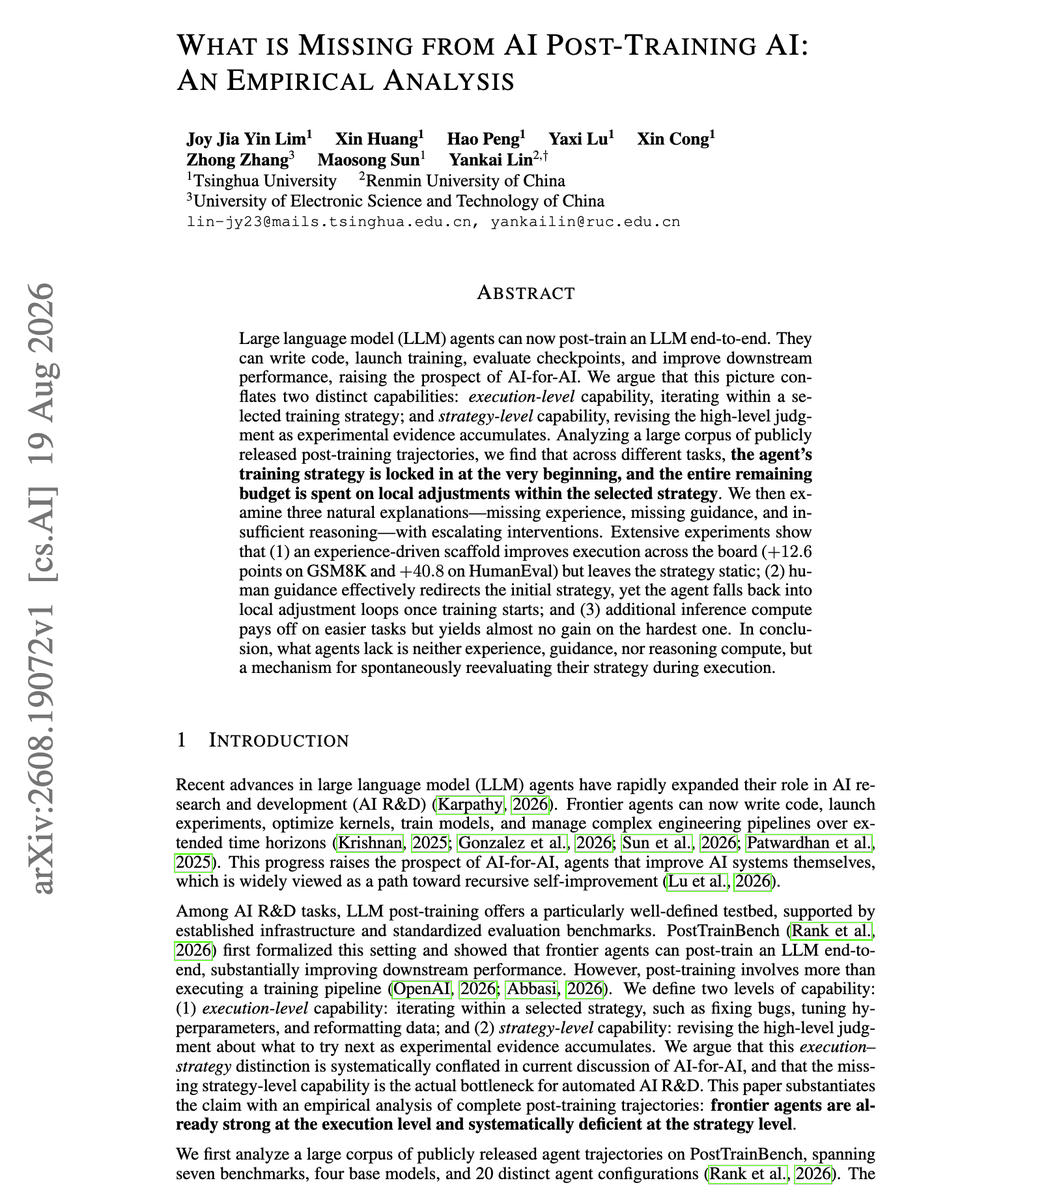
Tại sao các tác nhân AI tự huấn luyện lại dễ rơi vào bẫy tối ưu cục bộ?

Great paper if you are tracking progress in recursive self-improvement (RSI). (bookmark it) There …

DịchNghiên cứu mới chỉ ra rằng các tác nhân AI thường khóa chiến lược ngay từ bước đầu, dẫn đến việc lãng phí tài nguyên vào điều chỉnh nhỏ thay vì tự cải tiến đệ quy. Dù thử nghiệm nhiều phương pháp, AI vẫn thiếu khả năng tư duy lại chiến lược cốt lõi trong quá trình thực thi.

Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (1389 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Nghiên cứu AI” — Trang 23 | AIHOT.vn