25/09

Thứ Sáu · 1 tin

24/09

Thứ Năm · 2 tin
Google Developers Blog
Nghiên cứuĐiểm AI 48/100

Tái hiện quá trình huấn luyện OLMo 3 7B trên Google Cloud TPU bằng MaxText

Đội ngũ Google đã sử dụng MaxText để tái hiện thành công quá trình huấn luyện từ đầu của mô hình OLMo 3 7B trên Google Cloud TPU, bao gồm cả giai đoạn tiền huấn luyện và tinh chỉnh, với kết quả đạt chuẩn trên các bộ chỉ số đánh giá.

23/09

Thứ Tư · 2 tin
QbitAI
Nghiên cứuĐiểm AI 92/100

Tinh chọnDeepSeek công bố nghiên cứu mới về huấn luyện Agent với sự tham gia của Lương Văn Phong

DeepSeek vừa công bố bài báo nghiên cứu mới về huấn luyện Agent, với sự góp mặt của Lương Văn Phong, cho thấy khả năng tạo ra hơn 5.000 môi trường sandbox mỗi giây.

Thêm 1 nguồn khác đưa tinJiqizhixin

Vì sao đáng đọc: Đây là thông tin quan trọng từ DeepSeek về kỹ thuật huấn luyện Agent quy mô lớn, thu hút sự quan tâm lớn từ cộng đồng nghiên cứu AI.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 41/100

ACLArena: Khung huấn luyện hậu kỳ đa giai đoạn cho học liên tục trên tác nhân AI

ACLArena là khung nghiên cứu mới giúp phân tích cơ chế quên và khái quát hóa trong học liên tục cho tác nhân AI, đồng thời đề xuất phương pháp kết hợp phát lại dữ liệu chất lượng cao với mạng định tuyến LoRA chuyên biệt để tối ưu hiệu suất.

22/09

Thứ Ba · 5 tin
JiQiZhiXin
Mô hìnhĐiểm AI 92/100

Tinh chọnKhi sở hữu 10.000 hay 100.000 GPU: Làm thế nào để mở rộng quy mô huấn luyện RL?

Bài viết phân tích chiến lược tối ưu hóa Batch Size trong huấn luyện Reinforcement Learning (RL) quy mô lớn, giúp cân bằng giữa hiệu suất tính toán và thời gian huấn luyện để tiết kiệm chi phí vận hành hàng triệu USD.


Vì sao đáng đọc: Chủ đề cực kỳ thực tế cho các kỹ sư AI và doanh nghiệp đang chạy mô hình lớn, phân tích sâu về bài toán tối ưu hóa chi phí và hiệu suất phần cứng.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 38/100

Chỉ cần 1% Token: Tối ưu hóa chưng cất chính sách trực tuyến (OPD) bằng lý thuyết thông tin

Nghiên cứu chỉ ra rằng có thể đạt hiệu suất tương đương hoặc vượt trội so với chưng cất toàn phần chỉ với 0,1%-1% token. Bằng cách sử dụng chỉ số hiệu quả thông tin (IER), phương pháp này giúp chọn lọc dữ liệu huấn luyện tối ưu, tiết kiệm tài nguyên đáng kể cho các mô hình ngôn ngữ lớn.

Rohan Paul@rohanpaul_ai
NgànhĐiểm AI 45/100

OpenAI đã tự động hóa gần như toàn bộ quy trình huấn luyện các mô hình thử nghiệm mới

JUST IN: "Internally, OpenAI has largely automated the process of training new experimental models" …

DịchTheo báo cáo từ The Information, OpenAI đã đạt được bước tiến lớn khi tự động hóa hầu hết các công đoạn trong quy trình huấn luyện các mô hình AI thử nghiệm nội bộ.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

One to More, More to One: Huấn luyện chuyên gia lặp theo danh mục cho tác nhân kỹ thuật phần mềm

Nghiên cứu giới thiệu khung huấn luyện tác nhân AI dựa trên việc phân loại nhiệm vụ kỹ thuật phần mềm, giúp giải quyết tình trạng hiệu suất không đồng đều giữa các nhóm tác vụ khác nhau thông qua cơ chế củng cố hành vi và chọn lọc tác vụ thích ứng.

Kim@kimmonismus
NgànhĐiểm AI 41/100

Cùng sự kiệnOpenAI đã tự động hóa quy trình huấn luyện các mô hình thử nghiệm mới

"Internally, OpenAI has largely automated the process of training new experimental models, the OpenA…

DịchTheo báo cáo, OpenAI đã tự động hóa thành công quy trình huấn luyện mô hình mới, giúp giải quyết 100 bài toán hóc búa khiến chính các nhà nghiên cứu cũng phải kinh ngạc.

Cùng sự kiện, bài đại diện «OpenAI tự động hóa quy trình huấn luyện mô hình, giải quyết hàng trăm bài toán khó trong thời gian ngắn»

18/09

Thứ Sáu · 4 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 39/100

Giải mã vai trò của thông tin đặc quyền trong tự chưng cất On-Policy: Nghiên cứu thực nghiệm với AMPLE-Math

Nghiên cứu giới thiệu bộ dữ liệu AMPLE-Math với hơn 5.000 bài toán, giúp phân tách và đánh giá chính xác đóng góp của thông tin đặc quyền trong quá trình tự chưng cất (OPSD) cho mô hình ngôn ngữ.

Jason Liu@jxnlco
Sản phẩmĐiểm AI 60/100

Exa ra mắt Snapshot: Kho lưu trữ 400 tỷ trang web, cho phép tìm kiếm dữ liệu theo thời gian

Edited with Astra!?! That's crazy @donaldjewkes

DịchExa vừa giới thiệu Snapshot, công cụ lập chỉ mục 400 tỷ bản lưu trang web lịch sử, hỗ trợ truy vấn thông tin theo trạng thái quá khứ. Dữ liệu này hiện được ứng dụng trong huấn luyện mô hình AI, kiểm thử chiến lược và nghiên cứu sự phát triển của internet.

17/09

Thứ Năm · 4 tin
Thomas Wolf (Hugging Face đồng sáng lập/CSO)@Thom_Wolf
Mô hìnhĐiểm AI 54/100

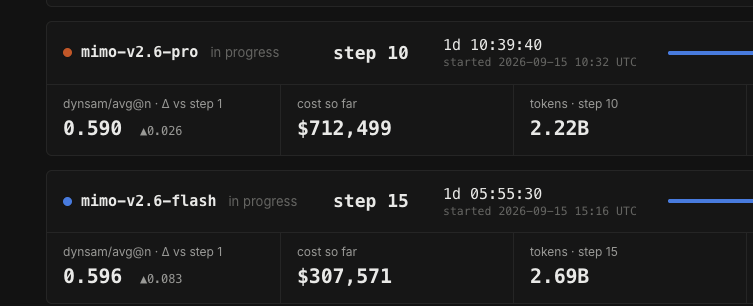
Cùng sự kiệnXiaomi công khai quá trình huấn luyện RL quy mô lớn cho mô hình MiMo-V2.6

Impressive level of openness on such a large run

DịchĐội ngũ Xiaomi đang thực hiện huấn luyện Reinforcement Learning (RL) cho MiMo-V2.6 với quy mô tính toán lên tới 2 tỷ token mỗi bước, nhằm khám phá giới hạn tối đa của mô hình.

Cùng sự kiện, bài đại diện «Xiaomi livestream quá trình huấn luyện mô hình MiMo-V2.6, đầu tư hơn 1,25 triệu USD»

16/09

Thứ Tư · 2 tin
JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnNghiên cứu từ Thanh Hoa: Chỉ cần một bài toán để huấn luyện mô hình ngôn ngữ lớn?

Nhóm nghiên cứu từ ĐH Thanh Hoa phát hiện On-Policy Distillation (OPD) có thể đạt 70% hiệu suất dù chỉ huấn luyện trên một mẫu dữ liệu duy nhất, cho thấy thuật toán hiện tại vẫn chưa khai thác hết tiềm năng của dữ liệu.


Vì sao đáng đọc: Nghiên cứu thách thức tư duy truyền thống về quy mô dữ liệu trong huấn luyện LLM, mang tính đột phá và có giá trị thực tiễn cao cho cộng đồng AI.

14/09

Thứ Hai · 3 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

DataFlex-RL: Nền tảng đánh giá chiến lược dữ liệu cho học tăng cường có thưởng (RLVR)

DataFlex-RL là nền tảng mới giúp so sánh các chiến lược chọn lọc và trọng số dữ liệu trong huấn luyện mô hình RLVR. Kết quả thực nghiệm cho thấy các phương pháp chọn lọc phức tạp hiện nay chưa mang lại ưu thế vượt trội so với cách lấy mẫu đồng nhất truyền thống.

JiQiZhiXin
Sản phẩmĐiểm AI 88/100

Tinh chọnTrao quyền tự chủ cho doanh nghiệp: PyTRIO định nghĩa lại kỷ nguyên huấn luyện mô hình AI qua API

Khi các doanh nghiệp AI dần chuyển sang tự huấn luyện mô hình chuyên biệt để đảm bảo tính tự chủ, nền tảng PyTRIO xuất hiện như một giải pháp đột phá giúp đơn giản hóa quy trình huấn luyện phức tạp thông qua mô hình TaaS (Training-as-a-Service).


Vì sao đáng đọc: Bài viết phân tích sâu sắc xu hướng tự chủ mô hình của các doanh nghiệp AI và giới thiệu giải pháp kỹ thuật kịp thời, có tính ứng dụng cao cho thị trường doanh nghiệp.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnFeyospace-v1: Đột phá trong huấn luyện mô hình AI chuyên biệt về an ninh mạng

Feyospace-v1 giới thiệu khung dữ liệu tập trung giúp tối ưu hóa việc huấn luyện các tác nhân AI an ninh mạng thông qua năm hệ thống chuyên biệt, giải quyết các rào cản về chi phí và môi trường thực thi để tạo ra hơn 164.000 quỹ đạo dữ liệu chất lượng cao.


Vì sao đáng đọc: Nghiên cứu giải quyết vấn đề thực tế trong huấn luyện AI an ninh mạng, cung cấp giải pháp kỹ thuật cụ thể cho các rào cản về dữ liệu và môi trường thực thi.

10/09

Thứ Năm · 6 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

HybridAL: Tối ưu hóa chiến lược huấn luyện trong Active Learning bằng tín hiệu ổn định

Nghiên cứu đề xuất HybridAL, phương pháp tự động chuyển đổi giữa huấn luyện lại từ đầu và tinh chỉnh (fine-tuning) dựa trên tín hiệu ổn định của mô hình, giúp tiết kiệm tài nguyên mà vẫn duy trì hiệu suất tối ưu.

Thomas Wolf (Hugging Face đồng sáng lập/CSO)@Thom_Wolf
NgànhĐiểm AI 45/100

Hugging Face ra mắt TRL v1.13: Hỗ trợ huấn luyện mô hình với ngữ cảnh siêu dài

TRL v1.13 is out! our open-source RL training library to to post-train foundation models this new r…

DịchThư viện TRL v1.13 vừa được phát hành với trọng tâm là huấn luyện hậu kỳ cho các mô hình có ngữ cảnh trên 1 triệu token, đi kèm với các tối ưu hóa quan trọng về tốc độ và bộ nhớ.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 50/100

Salesforce đề xuất phương pháp hiệu chỉnh chính sách giúp mô hình AI học tập hiệu quả hơn

Nice paper from Salesforce on co-evolving harnesses and models. Harness engineering is a hot topic …

DịchNghiên cứu mới từ Salesforce giải quyết vấn đề mô hình AI bị 'sao chép thất bại' khi cùng tiến hóa với các hệ thống hỗ trợ (harnesses), thông qua kỹ thuật hiệu chỉnh chính sách (on-policy correction).

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 57/100

Đột phá từ Đại học Thanh Hoa và Qwen: Tái cấu trúc quỹ đạo AI thành môi trường huấn luyện lập trình

New Tsinghua + Qwen Team's paper flips the usual agent-data recipe: Reconstructing and re-solving o…

DịchNhóm nghiên cứu từ Thanh Hoa và Qwen giới thiệu Terminal-Universe, phương pháp khôi phục không gian làm việc từ quỹ đạo AI để tạo dữ liệu huấn luyện chất lượng cao, giúp cải thiện đáng kể hiệu suất của mô hình Qwen3.5-27B trong các tác vụ lập trình thực tế.

Thomas Wolf (Hugging Face đồng sáng lập/CSO)@Thom_Wolf
Sản phẩmĐiểm AI 62/100

Hugging Face ra mắt ML Intern trên HuggingChat: Huấn luyện mô hình AI chỉ bằng cách trò chuyện

in 2026 training a model for a task should be as easy as vibe-coding an app the pieces were already…

DịchHugging Face vừa giới thiệu ML Intern, công cụ giúp việc huấn luyện mô hình trở nên đơn giản như lập trình ứng dụng, hướng tới mục tiêu phổ cập hóa quy trình tạo AI vào năm 2026.

09/09

Thứ Tư · 4 tin
JiQiZhiXin
Nghiên cứuĐiểm AI 88/100

Tinh chọnNeoHorse-1: Bước tiến mới của TokenRhythm trong việc hiện thực hóa khả năng tự cải tiến (RSI) cho AI Agent

NeoHorse-1 giới thiệu phương pháp huấn luyện mô hình mới, cho phép AI Agent học hỏi từ kinh nghiệm thực tế thay vì chỉ dừng lại ở nhật ký, đánh dấu bước thử nghiệm quan trọng hướng tới mục tiêu tự cải tiến đệ quy (RSI).


Vì sao đáng đọc: Bài viết đề cập đến xu hướng RSI đầy tiềm năng trong tương lai, giải quyết bài toán thực tế về việc AI lặp lại lỗi sai, có giá trị chuyên môn cao cho cộng đồng nghiên cứu.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 37/100

Đột phá mới trong huấn luyện AI: Phương pháp OPRD giúp mô hình học sinh vượt mặt thầy giáo yếu

Phương pháp On-Policy Reverse Distillation (OPRD) cho phép mô hình AI học từ giáo viên yếu nhưng vẫn đạt hiệu suất vượt trội, nhờ cơ chế lọc và khuếch đại các cập nhật tối ưu từ trình xác thực.

Kim@kimmonismus
NgànhĐiểm AI 34/100

Mô hình mới của OpenAI vượt mặt GPT-6-Astra-xhigh chỉ sau một tuần huấn luyện

To reiterate: training on OpenAI's new model began on August 28th. It took just one week, seven day…

DịchOpenAI đang thử nghiệm một mô hình nội bộ mới, chỉ mất một tuần để vượt qua hiệu suất của GPT-6-Astra-xhigh trong các bài kiểm tra toán học và vẫn đang tiếp tục cải thiện mạnh mẽ.

08/09

Thứ Ba · 3 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Một triệu chứng, ba đòn bẩy: Đánh giá chuyên sâu về kỹ thuật tự chưng cất On-Policy

Nghiên cứu phân tích kỹ thuật tự chưng cất (OPSD) giúp mô hình tự học từ dữ liệu có sẵn mà không cần mô hình giáo viên lớn, đồng thời cảnh báo về rủi ro suy giảm khả năng suy luận do thiên kiến trong quá trình huấn luyện.

07/09

Thứ Hai · 3 tin
WeChat: Xiaohongshu Tech (dots.llm)
NgànhĐiểm AI 45/100

Giải quyết bất đồng tốc độ hội tụ trong huấn luyện đa giáo viên: Tiểu Hồng Thư giới thiệu D3-MOPD

Tiểu Hồng Thư (AllSpark) đề xuất phương pháp D3-MOPD nhằm khắc phục sự chênh lệch tốc độ hội tụ khi sử dụng nhiều mô hình giáo viên trong huấn luyện, giúp tối ưu hóa hiệu suất học tập cho mô hình.

04/09

Thứ Sáu · 3 tin
Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (72 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “huấn luyện mô hình” | AIHOT.vn