14/08

Thứ Sáu · 68 tin
ModelBest OpenBMB@OpenBMB
Nghiên cứuĐiểm AI 56/100

OpenBMB ra mắt SciDC: Giải pháp dùng quy tắc chuyên gia để loại bỏ ảo giác cho mô hình AI

LLMs know a lot and sound convincing-yet in clinical diagnosis, chemical synthesis, or industrial fo…

DịchOpenBMB cùng các đối tác giới thiệu SciDC, phương pháp ép buộc mô hình AI tuân thủ các quy tắc khoa học khi suy luận mà không cần tinh chỉnh. Công nghệ này giúp tăng độ chính xác đáng kể trong các lĩnh vực đòi hỏi độ tin cậy cao như y tế và công nghiệp.

Qwen@Alibaba_Qwen
Mô hìnhĐiểm AI 41/100

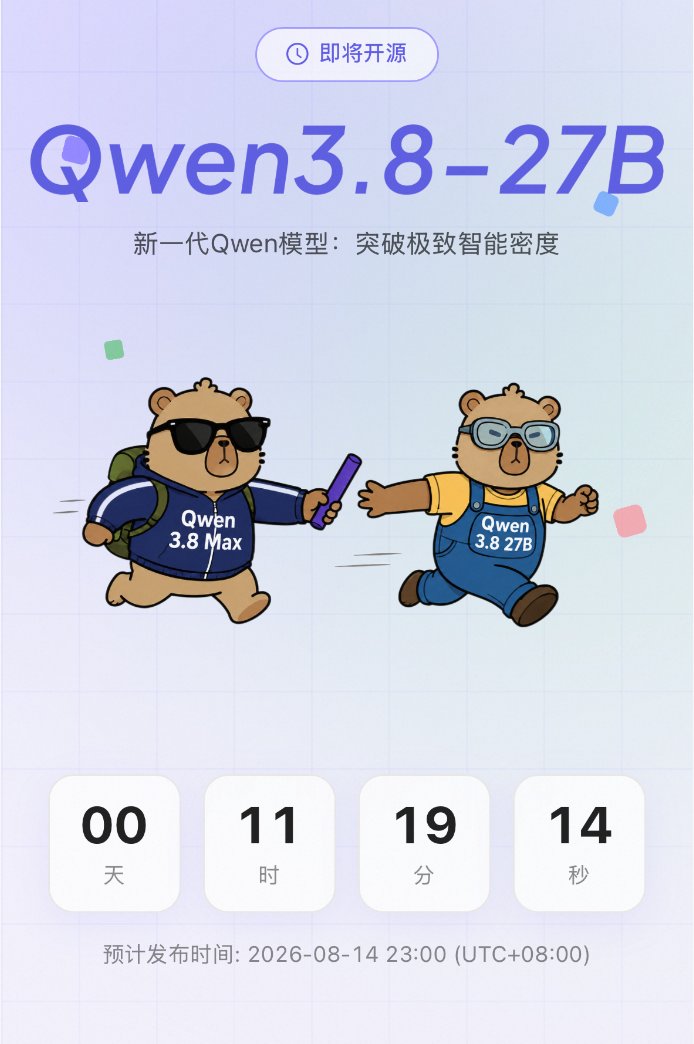
Qwen3.8-27B sắp ra mắt: Đếm ngược đến thế hệ mô hình mới từ Alibaba

Less than 2 hours to say hi👋. It's almost time! See you soon: 👀 https://huggingface.co/Qwen/Qwen3....

DịchAlibaba chuẩn bị trình làng mô hình ngôn ngữ Qwen3.8-27B. Chỉ còn chưa đầy 2 giờ nữa, cộng đồng AI sẽ chính thức được tiếp cận phiên bản mới này trên Hugging Face.

Thêm 3 nguồn khác đưa tinThe Decoder: AI NewsX: Alibaba Cloud (@alibaba_cloud)Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Francois Chollet@fchollet
Hướng dẫnĐiểm AI 37/100

ARC-AGI-3: Các giải pháp hàng đầu đều sử dụng mô hình thế giới biểu tượng dẫn dắt bởi LLM

Jeremy's excellent work here is a great illustration of a very powerful type of approach: LLM-guided…

DịchFrançois Chollet nhận định rằng các phương pháp dẫn đầu trong thử thách ARC-AGI-3 đều dựa trên việc dùng LLM để tổng hợp các mô hình thế giới biểu tượng, thông qua việc viết mã thực thi nhằm giải mã cơ chế nhân quả của thế giới.

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 47/100

Tại sao trải nghiệm sử dụng Opus 5 lại gây thất vọng?

Dù đạt điểm benchmark cao, Opus 5 lại gây khó chịu vì xu hướng tự ý suy diễn thay vì đặt câu hỏi làm rõ, khiến người dùng phải giám sát thủ công nhiều hơn. Tác giả cho rằng áp lực điểm số đã vô tình ưu tiên các mô hình 'liều lĩnh' thay vì sự cẩn trọng cần thiết trong lập trình.

Rohan Paul@rohanpaul_ai
Mô hìnhĐiểm AI 52/100

Cùng sự kiệnZhipu GLM-5.3 vượt mặt Anthropic Mythos 5 trong kiểm thử bảo mật mạng

China's Z.ai; s new model GLM-5.3 beats Anthropic's Mythos 5 in cyber-defence tests, i.e. at vulnera…

DịchZhipu vừa ra mắt GLM-5.3 với 743 tỷ tham số, cho thấy khả năng vượt trội trong phát hiện lỗ hổng bảo mật so với Mythos 5, dù vẫn còn hạn chế ở một số bài kiểm tra khai thác chuyên sâu.

Cùng sự kiện, tinh chọn hiển thị «GLM-5.3 ra mắt: Bước tiến đột phá trong năng lực an ninh mạng và phòng thủ tự động»
X.PIN@thexpin
NgànhĐiểm AI 55/100

Cùng sự kiệnApple tự phát triển mô hình AI riêng cho thị trường Trung Quốc với sự hỗ trợ từ Alibaba

Apple is not simply plugging an existing Chinese model into Apple Intelligence. According to Reuters…

DịchThay vì dựa vào bên thứ ba, Apple đã hợp tác cùng Alibaba để huấn luyện mô hình ngôn ngữ lớn độc quyền cho thị trường Trung Quốc, giúp tối ưu hóa trải nghiệm Apple Intelligence và tuân thủ các quy định sở tại.

Cùng sự kiện, bài đại diện «Apple tự phát triển mô hình AI riêng cho thị trường Trung Quốc»
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 40/100

Tác động của tinh chỉnh chỉ dẫn đến độ tin cậy và sự đa dạng từ vựng của mô hình ngôn ngữ

Nghiên cứu thực nghiệm cho thấy tinh chỉnh chỉ dẫn (instruction tuning) làm thay đổi độ tin cậy của mô hình nhưng không cải thiện đáng kể độ chính xác, đồng thời gây ra những tác động không đồng nhất lên sự đa dạng từ vựng và khả năng suy luận.

JiQiZhiXin
Mô hìnhĐiểm AI 92/100

Tinh chọnTiểu Hồng Thư chính thức mã nguồn mở dots3-note: Phiên bản kế thừa từ mô hình đạt điểm tuyệt đối IMO

Tiểu Hồng Thư vừa ra mắt phiên bản mã nguồn mở dots3-note preview, sở hữu 280B tham số và khả năng xử lý đa phương thức, tập trung tối ưu cho các tác vụ dài hạn phức tạp như lập kế hoạch thực tế.


Vì sao đáng đọc: Đây là bước tiến quan trọng của một mô hình đạt kỷ lục IMO, thu hút sự quan tâm lớn từ cộng đồng AI nhờ khả năng xử lý tác vụ dài hạn và tính ứng dụng thực tế cao.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 92/100

Tinh chọnBiết khi nào nên dừng: Huấn luyện LLM từ chối các suy luận vô nghĩa

Nghiên cứu giới thiệu phương pháp CaRL giúp LLM nhận diện giới hạn năng lực của chính mình, từ đó từ chối trả lời thay vì đưa ra các suy luận sai lệch nhưng nghe có vẻ thuyết phục.


Vì sao đáng đọc: Giải quyết vấn đề 'ảo tưởng' (hallucination) và suy luận sai của LLM bằng cách huấn luyện mô hình biết thừa nhận giới hạn, một bước tiến quan trọng cho độ tin cậy của AI.
opencode@opencode
Sản phẩmĐiểm AI 40/100

Cùng sự kiệnGLM-5.3 chính thức hỗ trợ Go: Cửa sổ ngữ cảnh 1 triệu token với mức giá cũ

GLM-5.3 now available in Go text · 1M context · same pricing as 5.2

DịchMô hình GLM-5.3 đã có mặt trên nền tảng Go, hỗ trợ cửa sổ ngữ cảnh lên tới 1 triệu token mà không thay đổi giá so với phiên bản 5.2.

Cùng sự kiện, bài đại diện «Codex hỗ trợ cửa sổ ngữ cảnh lên tới 1 triệu token cho GPT-5.6 Sol»
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 52/100

LycheeMemory V2: Bước đột phá trong khung bộ nhớ dài hạn cho tác nhân AI

Nhóm nghiên cứu từ HIT (Thâm Quyến) giới thiệu LycheeMemory V2, sử dụng phương pháp tích hợp theo phân đoạn ngữ nghĩa thay vì từng vòng, giúp giảm đáng kể chi phí token mà vẫn duy trì độ chính xác cao cho các tác nhân LLM.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnDarwinX: Tiến hóa hệ thống tác nhân AI thông qua chọn lọc tự nhiên

DarwinX tối ưu hóa khả năng của tác nhân AI bằng cách áp dụng cơ chế chọn lọc tự nhiên lên các thành phần như prompt và công cụ, giúp cải thiện hiệu suất mà không cần thay đổi trọng số mô hình.


Vì sao đáng đọc: Phương pháp tiếp cận mới lạ, giải quyết vấn đề thoái hóa hiệu năng khi tự cải tiến, có kết quả thực nghiệm ấn tượng trên các benchmark khó.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 92/100

Tinh chọnFull-bandwidth Transformer: Đột phá mới trong kiến trúc mô hình ngôn ngữ

Full-bandwidth Transformer cải thiện khả năng suy luận bằng cách truyền trạng thái ẩn từ lớp trên cùng trở lại đầu vào, giúp mô hình tận dụng được các tính toán chuyên sâu thay vì chỉ dựa vào token đã tạo.


Vì sao đáng đọc: Đây là một cải tiến kiến trúc quan trọng, giải quyết điểm nghẽn về luồng thông tin trong các mô hình Transformer hiện nay mà vẫn giữ được tính tương thích với hạ tầng cũ.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnKhi AI làm giám khảo: Nghệ thuật dùng từ có thể 'đánh lừa' đánh giá của AI như thế nào?

Nghiên cứu chỉ ra rằng các mô hình ngôn ngữ lớn dễ bị thao túng bởi phong cách viết thay vì chỉ dựa vào nội dung khoa học. Việc điều chỉnh cách trình bày bằng chứng và nhấn mạnh tính mới có thể làm thay đổi đáng kể điểm số đánh giá của AI.


Vì sao đáng đọc: Chủ đề cực kỳ thời sự về tính minh bạch và độ tin cậy của AI trong nghiên cứu khoa học, có tác động trực tiếp đến cộng đồng học thuật và phát triển mô hình đánh giá.
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 45/100

Cơ chế nén ngữ cảnh thông minh trên Pi: Cách tối ưu hóa bộ nhớ hội thoại

Pi tự động nén các đoạn hội thoại cũ thành tóm tắt cấu trúc khi đạt giới hạn token, giúp duy trì ngữ cảnh dài mà vẫn tiết kiệm tài nguyên. Người dùng có thể kích hoạt thủ công qua lệnh /compact để quản lý bộ nhớ hiệu quả hơn.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 51/100

Từ bằng chứng nguyên tử đến logic tổ hợp: Phương pháp suy luận cấu trúc cho các lựa chọn phức hợp

Khung làm việc mới giúp LLM giải quyết các câu hỏi logic phức tạp bằng cách phân tách lựa chọn thành các thành phần nguyên tử, sau đó sử dụng lập trình tuyến tính để tổng hợp kết quả. Phương pháp này cải thiện đáng kể độ chính xác trên các bộ dữ liệu logic khó.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

ReRound: Phương pháp lượng tử hóa LLM không cần hiệu chỉnh bằng cách giải quyết sai số làm tròn

ReRound sử dụng mô hình khuếch tán để tái tạo trọng số, giúp xác định chính xác hướng làm tròn cho các giá trị nằm gần điểm giữa của khoảng lượng tử hóa, từ đó tối ưu hóa hiệu suất LLM ở mức bit thấp.

Ma Dongxi NLP@dongxi_nlp
Hướng dẫnĐiểm AI 30/100

SSI có thể đang phát triển mô hình với 'không gian làm việc' tự tối ưu hóa

I began to like the word "Workspace". It is the internal area where a model holds, evaluates, and …

DịchChuyên gia Ma Dongxi cho rằng SSI đang xây dựng mô hình có khả năng tự đánh giá và tinh chỉnh suy nghĩ trong một 'không gian làm việc' nội bộ trước khi đưa ra câu trả lời, tương tự như cơ chế tối ưu hóa không gian ẩn dựa trên giá trị.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 35/100

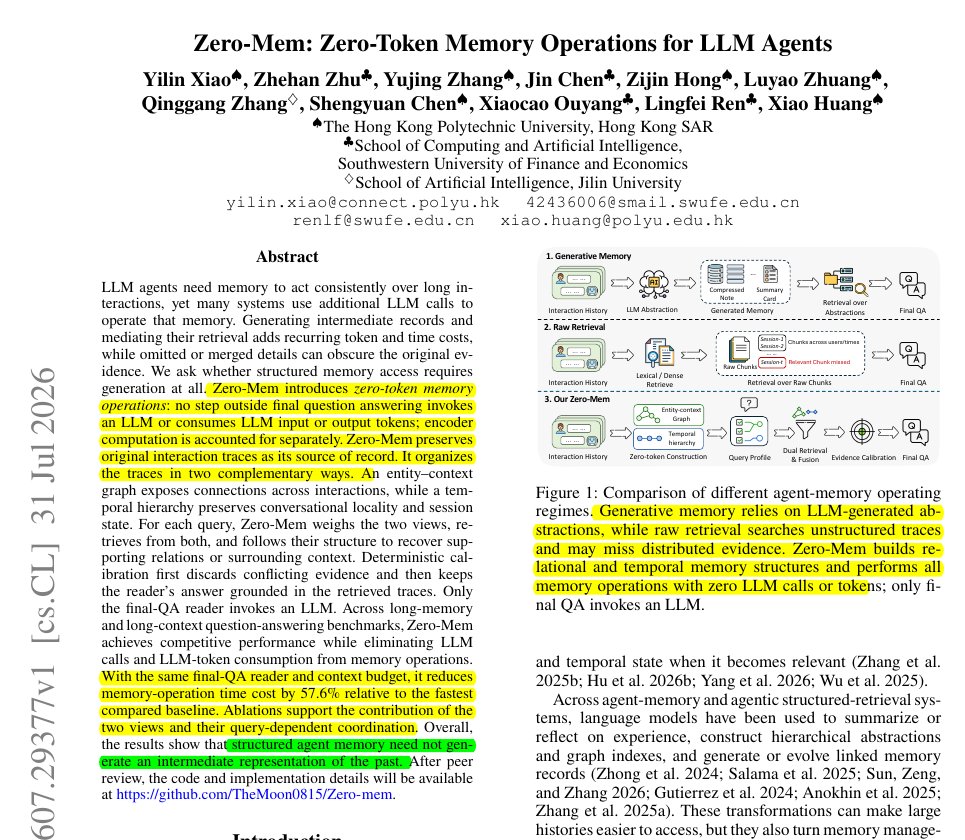
Zero-Mem: Giải pháp tối ưu hóa bộ nhớ cho AI Agent mà không tốn token

What if an AI agent could manage long-term memory without spending a single LLM token on the memory …

DịchZero-Mem là phương pháp quản lý bộ nhớ đột phá giúp AI Agent truy xuất dữ liệu mà không cần gọi LLM, giúp giảm độ trễ tới 57,6% so với các giải pháp hiện có bằng cách sử dụng đồ thị thực thể và phân cấp thời gian.

cb_doge@cb_doge
Hướng dẫnĐiểm AI 26/100

Cùng sự kiệnGrok 4.6 soán ngôi đầu bảng xếp hạng Realm Tax

Grok 4.6 wins again. 🏆 Grok 4.6 is #1 on micro1's Realm Tax benchmark with a 57.9% Best@3 score, b…

DịchGrok 4.6 vừa thiết lập cột mốc mới khi dẫn đầu bài kiểm tra Realm Tax (micro1) với điểm số Best@3 đạt 57.9%, vượt qua hàng loạt đối thủ sừng sỏ như Claude, GPT và Gemini.

Cùng sự kiện, bài đại diện «Grok 4.6 chính thức dẫn đầu bảng xếp hạng GDPVal-AA»
Databricks: Blog
Sản phẩmĐiểm AI 42/100

Unity AI Gateway ra mắt tính năng định tuyến thông minh: Giảm 30% chi phí vận hành AI mà vẫn giữ nguyên chất lượng

Databricks giới thiệu tính năng định tuyến thông minh trên Unity AI Gateway, giúp tự động tối ưu hóa việc lựa chọn mô hình cho các tác vụ lập trình, từ đó cắt giảm hơn 30% chi phí suy luận mà không làm giảm hiệu suất.

Artificial Analysis@ArtificialAnlys
Mô hìnhĐiểm AI 72/100

Cùng sự kiệnGoogle ra mắt Gemini 3.7 Flash: Đỉnh cao mới về tốc độ và hiệu năng

Google has released Gemini 3.7 Flash, improving 4 points over Gemini 3.6 Flash and reaching the Inte…

DịchGoogle vừa trình làng Gemini 3.7 Flash, đạt 56 điểm trên bảng xếp hạng Artificial Analysis. Phiên bản này thiết lập chuẩn mực mới khi cân bằng hoàn hảo giữa sức mạnh trí tuệ và tốc độ phản hồi siêu nhanh.

Cùng sự kiện, tinh chọn hiển thị «Google DeepMind ra mắt Gemini 3.7 Flash: Bước tiến đột phá cho lập trình và tác vụ AI Agent»
Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 37/100

Harness-IF: Phương pháp định lượng mức độ tuân thủ quy tắc của AI Agent

If you write rules in an AGENTS.md, this one is worth your time. When a coding agent follows your r…

DịchHarness-IF đánh giá khả năng tuân thủ các quy tắc trong AGENTS.md của AI Agent bằng cách loại bỏ các yếu tố ngẫu nhiên. Kết quả cho thấy độ chính xác thực tế thấp hơn dự đoán, đồng thời khẳng định hệ thống và chỉ dẫn người dùng luôn được ưu tiên hơn mô tả công cụ.

Sherwin Wu@sherwinwu
Sản phẩmĐiểm AI 43/100

Cerebras ra mắt GPT-5.6 Sol Ultrafast: Tốc độ siêu khủng 750 tokens/giây

GPT-5.6 Sol Ultrafast is here!! 750 tokens per second honestly feels instantaneous for most worklo…

DịchCerebras giới thiệu chế độ Sol Ultrafast với tốc độ 750 tokens/giây, nhanh gấp 14 lần thông thường. Mô hình này hoàn thành bài kiểm tra 'Humanity's Last Exam' chỉ trong hơn 11 giờ, vượt xa hiệu suất của Claude Fable 5 với độ chính xác tương đương.

Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (61 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “LLM” — Trang 30 | AIHOT.vn