21/09

Thứ Hai · 6 tin

20/09

Chủ Nhật · 2 tin
Rohan Paul@rohanpaul_ai
Sản phẩmĐiểm AI 35/100

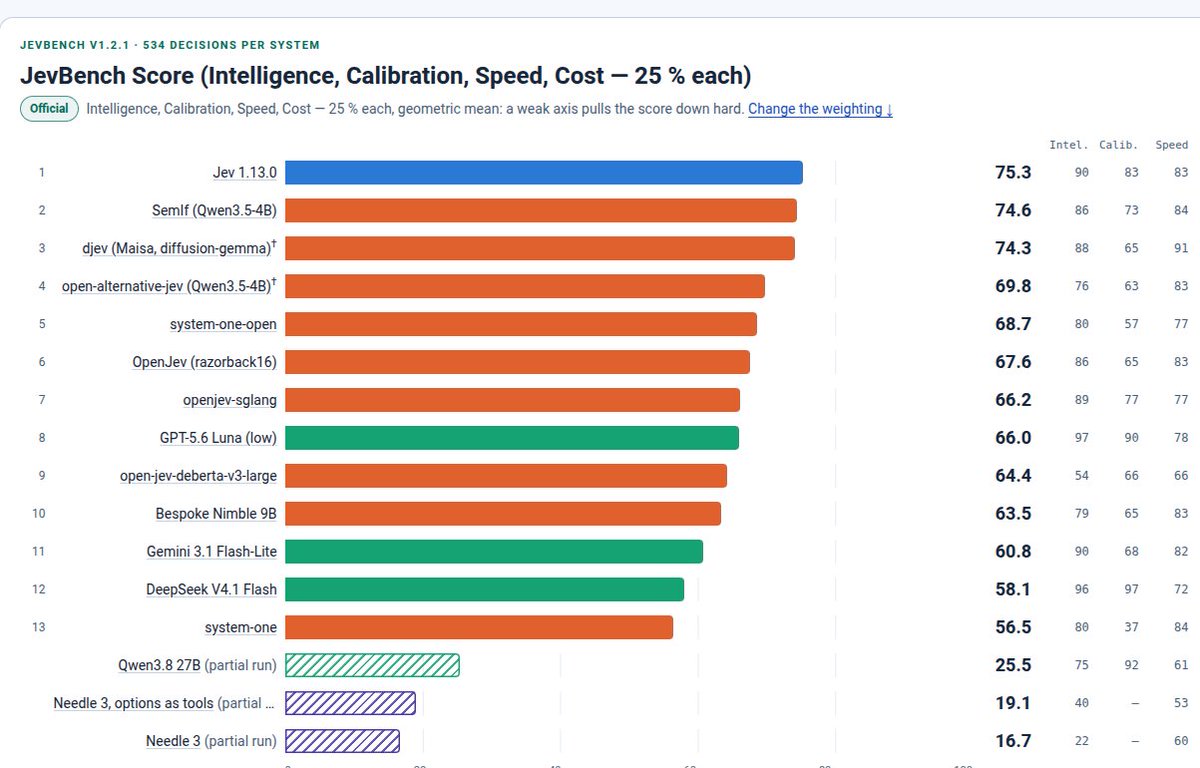
Ra mắt JevBench: Chuẩn đánh giá mới cho các mô hình ra quyết định có cấu trúc

A new benchmark called JevBench just dropped. for models whose output is a bounded software decisio…

DịchJevBench là bộ tiêu chuẩn mới đánh giá khả năng đưa ra quyết định phần mềm có giới hạn thay vì văn bản tự do. Điểm số được tính dựa trên sự cân bằng giữa độ chính xác, tốc độ và chi phí, giúp tối ưu hóa hiệu suất thực tế cho các ứng dụng AI chuyên biệt.

SemiAnalysis@SemiAnalysis_
NgànhĐiểm AI 24/100

SemiAnalysis chuẩn bị ra mắt bộ tiêu chuẩn đánh giá AgentX cho Google TPU

Many Google TPU customers are already asking Google for SemiAnalysis AgentX performance results, as …

DịchTrước nhu cầu lớn từ các khách hàng sử dụng Google TPU, SemiAnalysis xác nhận sẽ sớm công bố bộ tiêu chuẩn đánh giá AgentX, hứa hẹn trở thành thước đo chuẩn mực cho hiệu năng suy luận của các tác nhân AI (AI agents).

18/09

Thứ Sáu · 4 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

RiskChainBench: Bộ tiêu chuẩn đánh giá khả năng giải mã thông điệp độc hại và điều tra web tự động

RiskChainBench là bộ dữ liệu mới giúp AI giải mã các thông điệp lừa đảo tinh vi (dùng emoji, từ đồng âm) và tự động điều tra, thu thập bằng chứng từ các trang web độc hại một cách chính xác.

Karina Nguyen@karinanguyen
Sản phẩmĐiểm AI 50/100

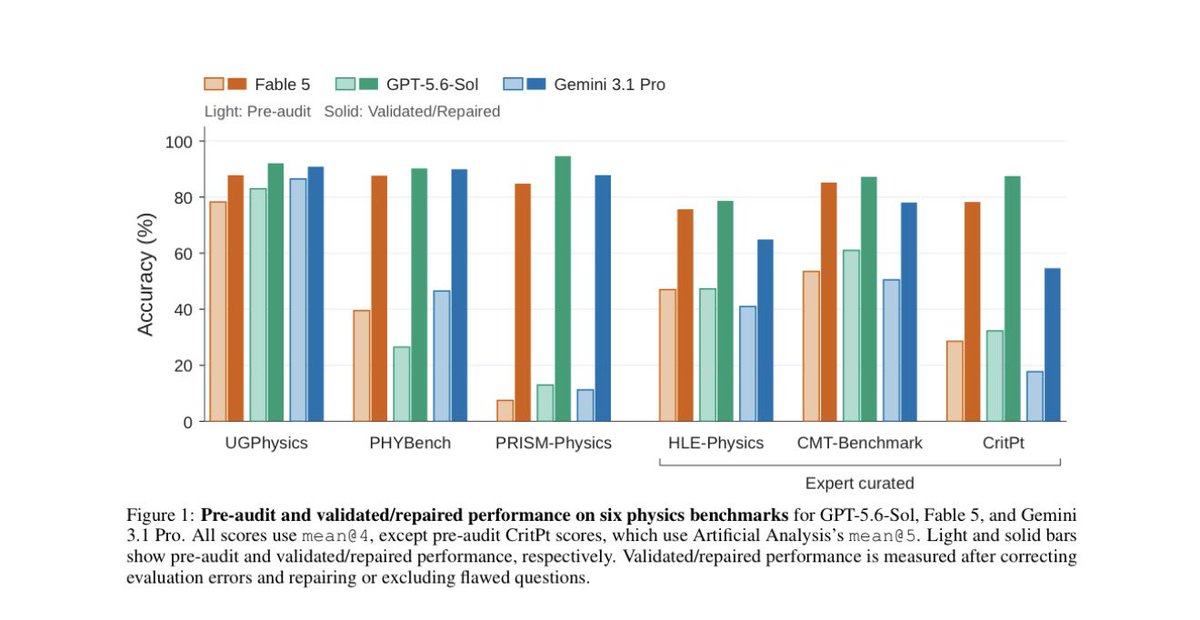
Epoch AI ra mắt chương trình Benchmark Reviews: Kiểm định chất lượng 15 bộ tiêu chuẩn AI

Great initiative to eval the evals. It incentivizes the industry to build genuinely high-quality ben…

DịchEpoch AI vừa công bố sáng kiến Benchmark Reviews nhằm đánh giá độ tin cậy của các bộ tiêu chuẩn AI, với kết quả ban đầu cho thấy 4 bộ đạt chuẩn, 9 bộ bị lỗi và 2 bộ chưa đủ dữ liệu. Động thái này được kỳ vọng sẽ thúc đẩy ngành công nghiệp xây dựng các tiêu chuẩn đánh giá AI chất lượng hơn.

Ethan Mollick@emollick
NgànhĐiểm AI 48/100

Epoch AI ra mắt chương trình đánh giá chất lượng các bộ tiêu chuẩn AI

Epoch continues to do some of the best public benchmarking work on AI. This is helpful (and tells us…

DịchEpoch AI vừa khởi động dự án Benchmark Reviews nhằm kiểm định độ tin cậy của các bộ tiêu chuẩn AI hiện nay. Kết quả ban đầu cho thấy trong 15 bộ tiêu chuẩn được kiểm tra, chỉ có 4 bộ đạt yêu cầu, trong khi 9 bộ khác bị đánh giá là có khiếm khuyết.

Thêm 1 nguồn khác đưa tinX: Karina Nguyen (@karinanguyen)
Epoch AI@EpochAIResearch
Nghiên cứuĐiểm AI 48/100

Epoch AI khởi động dự án đánh giá tính minh bạch của các bộ tiêu chuẩn AI

Introducing Benchmark Reviews: our new initiative to audit AI benchmarks. We are launching with 15 b…

DịchEpoch AI vừa ra mắt chương trình 'Benchmark Reviews' nhằm kiểm định chất lượng các bộ tiêu chuẩn đo lường AI. Trong đợt đầu, họ đã đánh giá 15 bộ tiêu chuẩn, kết quả cho thấy 4 cái đạt chuẩn, 9 cái có khiếm khuyết và 2 cái chưa đủ dữ liệu.

17/09

Thứ Năm · 3 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 44/100

ProgramDistill: Bộ tiêu chuẩn đánh giá AI lập trình dựa trên ứng dụng Web thực tế

ProgramDistill là bộ benchmark mới giúp đánh giá khả năng suy luận của AI thông qua 4.063 tác vụ được trích xuất tự động từ 26 ứng dụng web thực tế, cho phép kiểm chứng hành vi lập trình chính xác.

Haider@haider1
Mô hìnhĐiểm AI 38/100

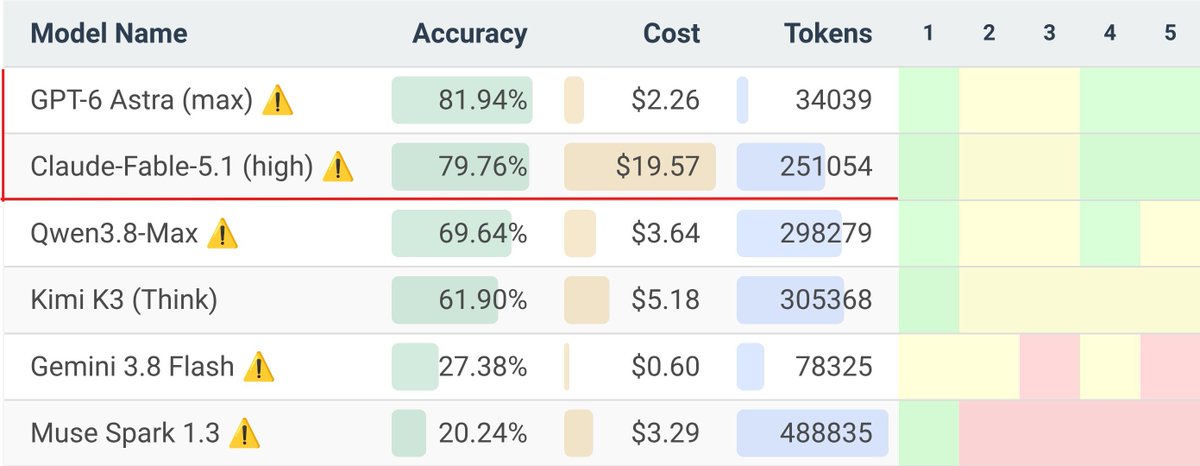
GPT-6 Astra vượt mặt Fable 5.1 trong bài kiểm tra toán học với chi phí chỉ bằng 1/3

GPT-6 Astra brutally mogged Fable 5.1 on a benchmark testing research-level math problems from recen…

DịchGPT-6 Astra đạt 88,6% trên các bộ tiêu chuẩn toán học, đánh bại Fable 5.1 (87,7%) với chi phí mỗi câu hỏi chỉ 3,63 USD, thấp hơn đáng kể so với mức 12,77 USD của đối thủ.

16/09

Thứ Tư · 2 tin
Ethan Mollick@emollick
Quan điểmĐiểm AI 48/100

Khủng hoảng niềm tin: Các bài kiểm tra đánh giá AI hiện nay đang dần mất đi giá trị

The state of public AI benchmarking is dire and is undermining our ability to understand how good AI…

DịchCác bộ tiêu chuẩn đánh giá AI công khai đang trở nên lỗi thời và thiếu chính xác, khiến việc đo lường năng lực thực tế của các mô hình AI trở nên khó khăn và dễ gây hiểu lầm.

15/09

Thứ Ba · 3 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 40/100

BVB: Dùng Blender tái tạo video để kiểm chứng khả năng hiểu hình ảnh của AI

BVB (Blender-VideoBench) là bộ tiêu chuẩn mới yêu cầu AI tái tạo video thực thành hoạt cảnh Blender. Kết quả cho thấy dù mô hình có thể mô phỏng hình ảnh tốt, chúng vẫn gặp khó khăn lớn trong việc duy trì tính chính xác của các sự kiện theo thời gian.

karminski@karminski3
NgànhĐiểm AI 41/100

Tranh cãi việc các hãng AI dùng bản 'Max' để chạy điểm benchmark nhưng khuyên người dùng dùng bản 'High'

Người dùng chỉ trích các hãng AI vì dùng cấu hình 'Max' để đạt điểm cao trên bảng xếp hạng, nhưng lại khuyến nghị người dùng phổ thông sử dụng cấu hình 'High' vì hiệu năng thực tế tốt hơn, cho thấy sự thiếu hụt trong quá trình hậu huấn luyện.

14/09

Thứ Hai · 2 tin
Artificial Analysis@ArtificialAnlys
NgànhĐiểm AI 44/100

Artificial Analysis ra mắt chỉ số năng lực AI v1.1: Đánh giá chuyên sâu theo từng ngành nghề

Announcing Artificial Analysis Capability Indices v1.1, updated with stronger domain tuning, combini…

DịchArtificial Analysis cập nhật chỉ số năng lực v1.1, kết hợp dữ liệu O*NET để đo lường hiệu suất AI trong 6 lĩnh vực chuyên môn như tài chính, luật và y tế dựa trên Intelligence Index v4.3.

11/09

Thứ Sáu · 2 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

IdeaAMBIG: Đánh giá lỗ hổng trong việc hiện thực hóa các ý tưởng nghiên cứu AI

Nghiên cứu giới thiệu IdeaAMBIG, bộ dữ liệu gồm 660 trường hợp nhằm kiểm tra khả năng chuyển đổi từ ý tưởng nghiên cứu sang mã nguồn thực tế, giúp xác định các thiếu sót trong tài liệu kỹ thuật mà các nhà phát triển thường gặp phải.

Lee Robinson@leerob
NgànhĐiểm AI 29/100

CursorBench 4.0 chính thức ra mắt: Thử thách mới cho khả năng lập trình của AI

We just rolled out CursorBench 4.0! It includes new tasks for how well models follow instructions, …

DịchCursorBench 4.0 vừa được phát hành với các bài kiểm tra khắt khe hơn về khả năng tuân thủ chỉ dẫn và xử lý các dự án phức tạp dài hạn, khiến điểm số của mọi mô hình AI đều giảm đáng kể.

10/09

Thứ Năm · 5 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

WearableQA: Bộ tiêu chuẩn đánh giá khả năng suy luận sức khỏe từ dữ liệu thiết bị đeo thực tế

WearableQA là bộ benchmark mới gồm 4.084 câu hỏi trắc nghiệm, giúp đánh giá khả năng của AI trong việc phân tích dữ liệu sinh lý và hành vi dài hạn từ người dùng thực tế, vượt qua các hạn chế của dữ liệu giả lập.

Perplexity@perplexity_ai
NgànhĐiểm AI 35/100

Perplexity ra mắt Q2D-Web: Chuẩn đánh giá mới cho hệ thống RAG và tìm kiếm web

We're introducing Q2D-Web (Query2Doc-Web), a benchmark and public leaderboard for evaluating retriev…

DịchPerplexity giới thiệu Q2D-Web, bộ tiêu chuẩn và bảng xếp hạng công khai nhằm đánh giá hiệu suất của các mô hình nhúng (embedding) khi thực hiện tìm kiếm web dựa trên truy vấn được tái cấu trúc bởi AI.

Artificial Analysis@ArtificialAnlys
NgànhĐiểm AI 38/100

GPT-6 Astra hiện đã hỗ trợ chạy các bài kiểm tra đánh giá tùy chỉnh trên Optima

You can test GPT-6 Astra on your own custom benchmarks in Optima Head to https://artificialanalysis...

DịchNgười dùng hiện có thể thiết lập và thực thi các bộ tiêu chuẩn đánh giá (benchmark) riêng cho mô hình GPT-6 Astra thông qua nền tảng Optima tại artificialanalysis.ai/optima.

09/09

Thứ Tư · 4 tin
Rohan Paul@rohanpaul_ai
NgànhĐiểm AI 40/100

Voice Arena công bố: Gradium dẫn đầu tốc độ phản hồi TTS với độ trễ chỉ 231ms

I usually scroll past benchmark posts because they're self-reported. This one isn't: Voice Arena mea…

DịchVoice Arena vừa thực hiện kiểm thử thực tế trên 10 mô hình TTS, trong đó Gradium đạt tốc độ phản hồi nhanh nhất với độ trễ p50 là 231ms. Kết quả này được đánh giá cao nhờ tính minh bạch và dữ liệu thực tế thay vì chỉ dựa trên thông số công bố từ nhà phát triển.

08/09

Thứ Ba · 1 tin
SemiAnalysis@SemiAnalysis_
NgànhĐiểm AI 45/100

Nghi vấn gian lận điểm chuẩn trên Gemini 3.8 Flash và Muse Spark 1.3

Gemini 3.8 Flash and Muse Spark 1.3 are two of the most clearly benchmaxxed models we've seen yet. D…

DịchGemini 3.8 Flash và Muse Spark 1.3 đang gây tranh cãi khi cho thấy dấu hiệu tối ưu hóa quá mức trên các bài kiểm tra chuẩn, dẫn đến sự sụt giảm hiệu suất đáng kể khi chuyển từ Terminal Bench 2.1 sang 4.0.

07/09

Thứ Hai · 1 tin

06/09

Chủ Nhật · 2 tin
IT Home
Hướng dẫnĐiểm AI 77/100

Tinh chọnFortune: OpenAI nhiều lần chỉnh sửa dữ liệu benchmark của GPT-6 Astra

Theo Fortune, OpenAI đã liên tục thay đổi số liệu đánh giá GPT-6 Astra kể từ khi công bố, bao gồm việc điều chỉnh tỷ lệ ảo tưởng từ 4,2% xuống 2% rồi lại thay đổi ngược lại, làm dấy lên nghi vấn về tính minh bạch.


Vì sao đáng đọc: Tin tức quan trọng về tính minh bạch của OpenAI, ảnh hưởng trực tiếp đến uy tín của các mô hình AI đầu bảng, thu hút sự quan tâm lớn từ cộng đồng công nghệ.

05/09

Thứ Bảy · 3 tin
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Sản phẩmĐiểm AI 49/100

Artificial Analysis cập nhật Intelligence Index v4.2: Bổ sung bộ tiêu chuẩn đánh giá AI mới

Artificial Analysis ra mắt bản cập nhật v4.2, bổ sung AA-Briefcase cho tác vụ trí tuệ nhân tạo và GDP.pdf để kiểm tra khả năng suy luận trên tài liệu dài, đồng thời loại bỏ các bài kiểm tra đã bão hòa.

Alexandr Wang (Scale AI nhà sáng lập/Meta Giám đốc AI)@alexandr_wang
Hướng dẫnĐiểm AI 49/100

Artificial Analysis cập nhật Intelligence Index v4.2: Claude 3.5 Sonnet vươn lên dẫn đầu

updated artificial analysis index-muse spark 1.3 max still performs quite well! the efficient front…

DịchBản cập nhật v4.2 bổ sung các bài kiểm tra chuyên sâu về tác vụ trí tuệ và khả năng suy luận tài liệu dài, đồng thời tăng trọng số bộ dữ liệu kiểm thử kín để ngăn chặn tình trạng tối ưu hóa điểm số ảo.

Artificial Analysis@ArtificialAnlys
Sản phẩmĐiểm AI 53/100

Artificial Analysis cập nhật Intelligence Index v4.2: Tăng trọng số kiểm thử riêng

Announcing Artificial Analysis Intelligence Index v4.2. We are accelerating elements of our upcoming…

DịchArtificial Analysis ra mắt bản cập nhật v4.2 với trọng số kiểm thử riêng tăng gấp đôi, bổ sung các bài đánh giá mới như AA-Briefcase và GDP.pdf, đồng thời loại bỏ bộ dữ liệu GPQA Diamond đã bão hòa.

04/09

Thứ Sáu · 6 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 39/100

Ra mắt Last Translation Benchmark: Bộ tiêu chuẩn đánh giá giới hạn của AI dịch thuật đa phương thức

Last Translation Benchmark sử dụng các mẫu dữ liệu đa phương thức (văn bản, hình ảnh, âm thanh, video) được con người kiểm duyệt khắt khe để thử thách và tìm ra điểm yếu của các mô hình dịch thuật AI hiện nay.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 32/100

Cùng sự kiệnApodex ra mắt TRACES: Bộ tiêu chuẩn đánh giá khả năng khám phá khoa học của AI với các câu hỏi chưa có lời giải

Very important paper accelerating research around AI discovery. https://x.com/omarsar0/status/20958...

DịchTRACES là bộ benchmark mới giúp đo lường năng lực suy luận và khám phá khoa học của các mô hình AI khi đối mặt với những vấn đề chưa được xác thực trong thực tế.

Cùng sự kiện, bài đại diện «Apodex ra mắt TRACES: Bộ tiêu chuẩn đánh giá khả năng giải quyết các bài toán khoa học chưa có lời giải»
Kim@kimmonismus
Mô hìnhĐiểm AI 24/100

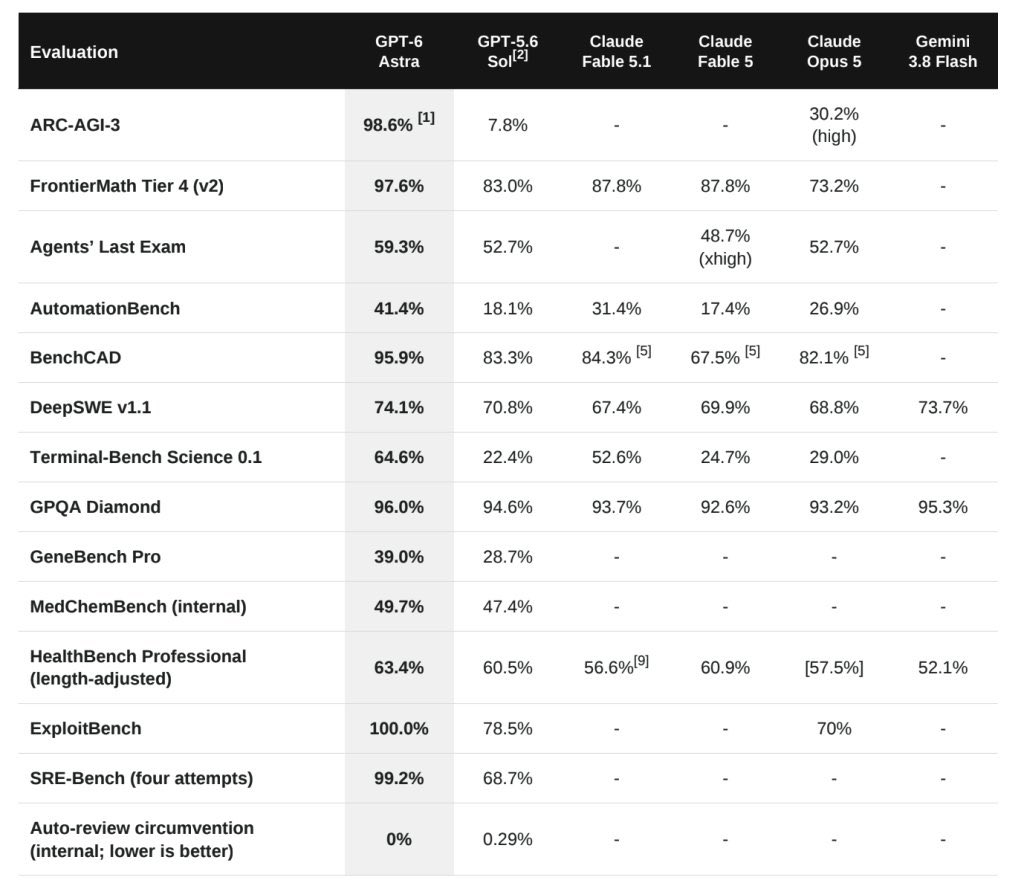
Cùng sự kiệnGPT-6 Astra thiết lập kỷ lục mới: Đạt 98,6% điểm ARC-AGI-3, vượt xa Claude Fable 5.1

You can quote me on this: OpenAI crushed Anthropic's IPO. They put the newly released, state-of-the…

DịchGPT-6 Astra vừa ra mắt đã gây sốc với hiệu suất vượt trội trong các bài kiểm tra năng lực tư duy phức tạp, đạt điểm tuyệt đối ở ExploitBench và bỏ xa đối thủ Claude Fable 5.1 trong nhiều tiêu chuẩn đánh giá quan trọng.

Cùng sự kiện, tinh chọn hiển thị «OpenAI ra mắt GPT-6 Astra: Đạt cấp độ 'Critical' về an ninh mạng»
Testing Catalog@testingcatalog
Hướng dẫnĐiểm AI 35/100

Cùng sự kiệnLộ điểm benchmark GPT-6 Astra: Đạt 98,6% trong bài kiểm tra ARC-AGI-3

OPENAI 🔥: GPT-6 Astra scored 98.6% on ARC-AGI-3 and topped most of the other benchmarks. > 74.%…

DịchCác dữ liệu rò rỉ cho thấy mô hình GPT-6 Astra đã đạt kết quả ấn tượng 98,6% trong bài kiểm tra ARC-AGI-3, đánh dấu bước tiến lớn về khả năng suy luận của AI.

Cùng sự kiện, bài đại diện «Lộ diện kết quả benchmark GPT-6 Astra: Đạt 98.6% trong bài kiểm tra ARC-AGI-3»
Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (69 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “benchmark” — Trang 2 | AIHOT.vn