24/09

Thứ Năm · 24 tin
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 51/100

Đánh giá Mercury 2.5: Tốc độ suy luận đạt 780.8 token/giây, vượt xa chuẩn thị trường

Artificial Analysis vừa cập nhật dữ liệu cho Mercury 2.5, mẫu mô hình suy luận chuyên biệt ra mắt ngày 8/9/2026 với tốc độ ấn tượng 780.8 token/giây, bỏ xa mức trung bình 110.3 token/giây của các đối thủ cùng phân khúc.

WeChat: Xiaomi MiMo
Mô hìnhĐiểm AI 48/100

Xiaomi hé lộ kiến trúc HySparse2 trên MiMo-V3: Tối ưu cho Agent đa vòng hội thoại dài

Xiaomi giới thiệu kiến trúc HySparse2 cho mô hình MiMo-V3, sử dụng cơ chế chia sẻ KV hai cấp và chọn lọc token thưa để giảm thiểu chi phí tính toán Prefill và bộ nhớ KV Cache cho các tác vụ Agent phức tạp.

Diễn biến sự kiện · 3 bài →Thêm 4 nguồn khác đưa tinIT HomeX: Luo Fuli (@_LuoFuli)TechNodePandaily
WeChat: Baidu AI Cloud (ERNIE)
Hướng dẫnĐiểm AI 38/100

Tái hiện nguyên mẫu Jev với chi phí 1.395 đồng: Thực hành tối ưu trên Baidu Qianfan Token Plan

Sử dụng Baidu Qianfan Token Plan với chi phí chỉ 1.395 đồng, bài viết hướng dẫn cách tùy biến mô hình DeepSeek-V4-Flash để tái hiện cơ chế Jev của TypeSafe AI, biến LLM tự hồi quy thành công cụ ra quyết định có cấu trúc chỉ với 400 dòng C++.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

MemoryAthena: Tối ưu hóa bộ nhớ AI thông qua định tuyến thích ứng giữa dữ liệu truy xuất và tạo mới

MemoryAthena giới thiệu phương pháp kết hợp truy xuất bộ nhớ truyền thống với khả năng tự tạo nội dung, sử dụng bộ định tuyến thông minh để quyết định khi nào nên dùng dữ liệu gốc và khi nào cần bổ sung thông tin mới, giúp tăng độ chính xác cho mô hình.

TechNode
Mô hìnhĐiểm AI 85/100

Cùng sự kiệnXiaomi MiMo-V3 chuyển sang kiến trúc mới với công nghệ HySparse2 giúp tối ưu chi phí xử lý ngữ cảnh dài

Xiaomi xác nhận MiMo-V3 sẽ sử dụng kiến trúc HySparse2, giúp giảm đáng kể chi phí suy luận và bộ nhớ KV cache khi xử lý ngữ cảnh lên tới 1 triệu token, tối ưu hóa hiệu suất cho các tác vụ AI agent.

Cùng sự kiện, bài đại diện «Xiaomi hé lộ kiến trúc HySparse2 trên MiMo-V3: Tối ưu cho Agent đa vòng hội thoại dài»
Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 45/100

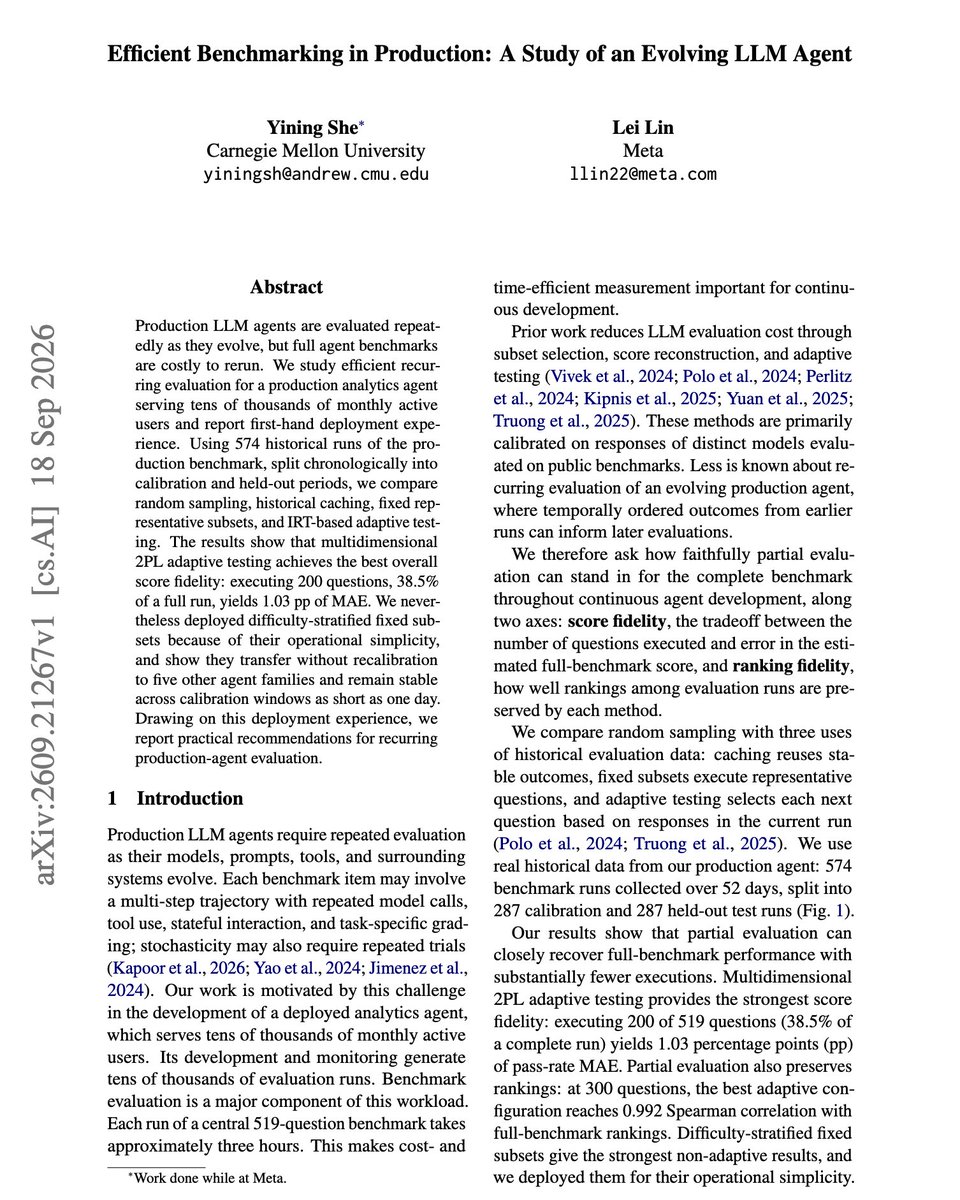
Phương pháp đánh giá lại AI Agent trong môi trường thực tế với chi phí tối ưu

Nice paper showing how to re-evaluate a production agent at a fraction of the cost. 200 questions, …

DịchNghiên cứu đề xuất cách đánh giá lại AI Agent sản xuất chỉ với 200 câu hỏi (38.5% bộ đề gốc) nhưng vẫn giữ sai số cực thấp, giúp tiết kiệm chi phí vận hành đáng kể.

Yuchen Jin@Yuchenj_UW
Quan điểmĐiểm AI 38/100

Chi phí cho kỹ sư 500.000 USD/năm: Tại sao đầu tư vào LLM là bài toán ROI dễ nhất?

A $500k engineer costs $2, 000 per working day. If $200/day of LLM tokens makes them 20% more produc…

DịchVới mức lương 2.000 USD/ngày, việc chi 200 USD cho LLM để tăng 20% năng suất kỹ sư là khoản đầu tư cực kỳ hiệu quả. Thứ đắt đỏ không phải là token, mà là sự lãng phí tiềm năng của nhân sự trình độ cao.

Tencent Hunyuan@TencentHunyuan
Nghiên cứuĐiểm AI 40/100

Cùng sự kiệnTencent Hunyuan: Nghiên cứu tối ưu hóa kích thước batch trong học tăng cường cho LLM

⚡️ As LLM reinforcement learning scales to larger GPU clusters and more training data, training effi…

DịchNghiên cứu từ Tencent Hunyuan cho thấy việc điều chỉnh learning rate giúp tăng hiệu suất huấn luyện GRPO và PPO, giúp tăng tốc độ xử lý lên 2,29 lần và tiết kiệm 29% thời gian huấn luyện.

Cùng sự kiện, bài đại diện «Tencent Hunyuan: Nghiên cứu mở rộng kích thước batch trong học tăng cường LLM»
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

SpeakerMem-R1: Hệ thống bộ nhớ kênh đôi tập trung vào người nói cho hội thoại đa bên

SpeakerMem-R1 giải quyết các hạn chế của LLM trong việc ghi nhớ hội thoại đa bên bằng cách sử dụng cấu trúc bộ nhớ kênh đôi, giúp phân tách thông tin theo từng cá nhân và nhóm để tái tạo trạng thái hội thoại chính xác hơn.

Tencent Hunyuan@TencentHunyuan
Nghiên cứuĐiểm AI 39/100

Tencent Hunyuan: Nghiên cứu mở rộng kích thước batch trong học tăng cường LLM

⚡️ As LLM reinforcement learning scales to larger GPU clusters and more training data, training effi…

DịchNhóm nghiên cứu Tencent Hunyuan tối ưu hóa học tăng cường cho LLM bằng cách mở rộng kích thước batch, giúp tăng tốc độ xử lý của PPO lên 2,29 lần và rút ngắn 29% thời gian huấn luyện GRPO mà vẫn đảm bảo hiệu suất.

@typesafeai@typesafeai
Mô hìnhĐiểm AI 27/100

JEV: Đột phá mới giúp LLM phản hồi suy luận tức thì

Stepping away while LLMs churn is the new "sorry, code's compiling". Jev makes instant feedback ju…

DịchJEV giới thiệu mô hình suy luận ngữ nghĩa mới, cho phép LLM đưa ra quyết định có cấu trúc ngay lập tức với mọi ngữ cảnh. Hiệu suất của JEV trong các tác vụ truy vấn phức tạp đã đạt ngưỡng tương đương với các mô hình Claude hàng đầu hiện nay.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 92/100

Tinh chọnKho mã nguồn Schrödinger: Liệu LLM thực sự hiểu lập trình hay chỉ đang học vẹt SWE-bench?

Nghiên cứu giới thiệu SchrodingerRepo, một khung đánh giá mới giúp loại bỏ tình trạng 'học vẹt' bằng cách thay đổi cấu trúc mã nguồn động, buộc các tác nhân AI phải thực sự tư duy thay vì dựa vào dữ liệu đã ghi nhớ từ trước.


Vì sao đáng đọc: Đề tài rất quan trọng trong bối cảnh các benchmark lập trình hiện nay đang bị bão hòa do dữ liệu rò rỉ, ảnh hưởng trực tiếp đến độ tin cậy của các mô hình coding AI.
OpenRouter@OpenRouter
Mô hìnhĐiểm AI 36/100

Mô hình Qwen3.8 Max Prime chính thức có mặt trên OpenRouter

Qwen3.8 Max Prime from @Alibaba_Qwen is live on OpenRouter. A higher-throughput variant of Qwen3.8 …

DịchQwen3.8 Max Prime, phiên bản tối ưu hóa băng thông cao của Qwen3.8 Max, đã chính thức ra mắt trên OpenRouter. Mô hình giữ nguyên sức mạnh 2.4T tham số, hỗ trợ đa phương thức (văn bản, ảnh, video), cửa sổ ngữ cảnh 1M và khả năng suy luận mạnh mẽ.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 48/100

Nghiên cứu mới từ Google: Tải mô hình là 'nút thắt' chính gây độ trễ khi khởi động LLM lượng tử hóa

New Google paper shows for small quantized LLMs on serverless CPUs, 55-70% of cold-start latency is …

DịchNghiên cứu của Google chỉ ra rằng 55-70% độ trễ khởi động của các LLM lượng tử hóa trên CPU serverless đến từ việc tải trọng số mô hình. Việc tăng dung lượng RAM cấp phát có thể giúp tối ưu hóa đáng kể tốc độ suy luận.

23/09

Thứ Tư · 35 tin
IT Home
Quan điểmĐiểm AI 63/100

Cùng sự kiệnKỹ sư Anthropic lý giải vì sao văn phong Claude ngày càng 'máy móc': Do được huấn luyện để giao tiếp với AI

Kỹ sư Jackson Kernion từ Anthropic cho biết việc tối ưu hóa Claude cho toán học và code, cùng lượng lớn dữ liệu huấn luyện dành cho AI, đã tạo ra 'giọng văn Claude' xa rời ngôn ngữ tự nhiên của con người.

Cùng sự kiện, bài đại diện «Kỹ sư Anthropic lý giải vì sao Claude ngày càng thông minh nhưng văn phong lại tệ đi»
Aravind Srinivas (Perplexity CEO)@AravSrinivas
Mô hìnhĐiểm AI 68/100

Tinh chọnXiaomi ra mắt MiMo-V2.6 Pro và Flash: Mô hình toàn năng thách thức Claude Opus 5 và GPT-5.6 Sol

Never bet against open weight models

DịchXiaomi vừa trình làng bộ đôi mô hình mã nguồn mở MiMo-V2.6 Pro và Flash. Phiên bản Pro đạt điểm số kỷ lục 46 trên Artificial Analysis, khẳng định năng lực vượt trội ngang hàng với Claude Opus 5 và GPT-5.6 Sol trong các tác vụ Agent.


Vì sao đáng đọc: Tác giả đánh giá mô hình mới của Xiaomi từ góc độ quyền hạn mã nguồn mở, các so sánh chuẩn mực được trích dẫn giúp xác định sự thay đổi khoảng cách giữa mô hình mã nguồn mở và mô hình tiên phong đóng trên Claude Opus 5 và GPT-5.6 Sol.
IT Home
Mô hìnhĐiểm AI 50/100

Cùng sự kiệnXiaomi công bố kiến trúc MiMo-V3 với lõi HySparse 2 đột phá

Xiaomi chính thức ra mắt lõi HySparse 2 cho mô hình MiMo-V3, giúp giảm 5 lần khối lượng tính toán và 4,5 lần bộ nhớ KV cache ở độ dài 1M token, đồng thời cải thiện đáng kể hiệu suất xử lý ngữ cảnh dài.

Cùng sự kiện, bài đại diện «Xiaomi hé lộ kiến trúc HySparse2 trên MiMo-V3: Tối ưu cho Agent đa vòng hội thoại dài»
Luo Fuli@_LuoFuli
Mô hìnhĐiểm AI 43/100

Cùng sự kiệnMiMo-V3 ra mắt kiến trúc lõi HySparse2: Tối ưu hóa vượt trội cho xử lý văn bản dài

MiMo-V3 is getting a new architecture. The core of it, HySparse2, is out today. Less prefill, a sma…

DịchKiến trúc HySparse2 mới của MiMo-V3 giúp giảm 5,02 lần FLOPs prefill và thu nhỏ 4,5 lần KV cache so với bản tiền nhiệm, đồng thời cải thiện đáng kể hiệu suất trên các bài kiểm tra độ dài ngữ cảnh lớn.

Cùng sự kiện, bài đại diện «Xiaomi hé lộ kiến trúc HySparse2 trên MiMo-V3: Tối ưu cho Agent đa vòng hội thoại dài»
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 44/100

JEV-as-a-Judge: Chiến lược đánh giá AI tiết kiệm chi phí bằng cách phân tầng độ tin cậy

JEV-as-a-Judge sử dụng mô hình đánh giá chi phí thấp để sàng lọc sơ bộ, kết hợp cơ chế leo thang khi độ tin cậy thấp, giúp duy trì 99% độ chính xác của các mô hình SOTA với chi phí chỉ bằng 0,36%.

Thêm 1 nguồn khác đưa tinX: Elvis Saravia (@omarsar0, DAIR.AI)
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

LatentPort: Chuyển giao bộ nhớ đệ quy giữa các mô hình ngôn ngữ lai mà không cần đọc lại ngữ cảnh

Nghiên cứu giới thiệu kỹ thuật LatentPort cho phép chuyển giao trạng thái bộ nhớ trực tiếp giữa Qwen3.5 4B và 9B mà không cần nạp lại tiền tố, giúp tối ưu hóa hiệu suất suy luận thông qua việc tái sử dụng trạng thái Gated DeltaNet.

Pandaily
Mô hìnhĐiểm AI 92/100

Tinh chọnAlibaba bắt đầu huấn luyện dòng Qwen4; lộ trình hướng tới Qwen4.5 và Qwen5 với quy mô 5-10 nghìn tỷ tham số

Tại hội nghị Apsara 2026, Alibaba xác nhận đang huấn luyện Qwen4 và công bố lộ trình phát triển Qwen4.5/Qwen5 với quy mô lên tới 10 nghìn tỷ tham số, đồng thời ghi nhận hiệu suất tự cải thiện ấn tượng từ Qwen3.8-Max.


Vì sao đáng đọc: Tin tức quan trọng về lộ trình phát triển của một trong những mô hình AI hàng đầu thế giới, đặc biệt là thông tin về quy mô tham số khổng lồ và khả năng tự cải thiện.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 45/100

Taste-Bench: Đo lường và nâng cao 'gu' thẩm mỹ trong tư duy của AI Agent

Nghiên cứu giới thiệu Taste-Bench, bộ tiêu chuẩn đánh giá khả năng đưa ra quyết định tối ưu của AI Agent trong các tác vụ dài hạn. Kết quả cho thấy ngay cả các mô hình mạnh nhất cũng gặp khó khăn khi đối mặt với các tình huống đòi hỏi sự tinh tế trong lựa chọn.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Bellman Policy Optimization: Phương pháp tối ưu hóa mới giúp LLM suy luận toán học chính xác hơn

Bellman Policy Optimization (BPO) là phương pháp huấn luyện mô hình ngôn ngữ không cần critic, giúp tối ưu hóa khả năng suy luận thông qua các phần thưởng cuối cùng mà không cần ước tính giá trị trạng thái trung gian.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Từ nhận diện mẫu đến người bạn đồng hành: Tổng quan về LLM trong lĩnh vực sức khỏe tâm thần

Bài nghiên cứu phân tích sự tiến hóa của các mô hình ngôn ngữ lớn (LLM) trong việc hỗ trợ sức khỏe tâm thần, từ công cụ nhận diện cơ bản đến những người bạn đồng hành cá nhân hóa, nhằm giải quyết các rào cản trong chăm sóc y tế truyền thống.

Elvis Saravia@omarsar0
Quan điểmĐiểm AI 27/100

Cùng sự kiệnOpus 5.5 mang lại trải nghiệm viết lách giống Opus 4.5 hơn

Opus 5.5 feels more like Opus 4.5. Is it just me, or did it get a lot better at writing? Claudes…

DịchNgười dùng nhận định Opus 5.5 có phong cách viết cải thiện đáng kể, loại bỏ được cảm giác máy móc đặc trưng của Claude và mang lại trải nghiệm đọc tự nhiên, dễ chịu hơn.

Cùng sự kiện, tinh chọn hiển thị «Claude Code cập nhật v2.1.280: Ra mắt Claude Opus 5.5 làm mô hình mặc định»
Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 38/100

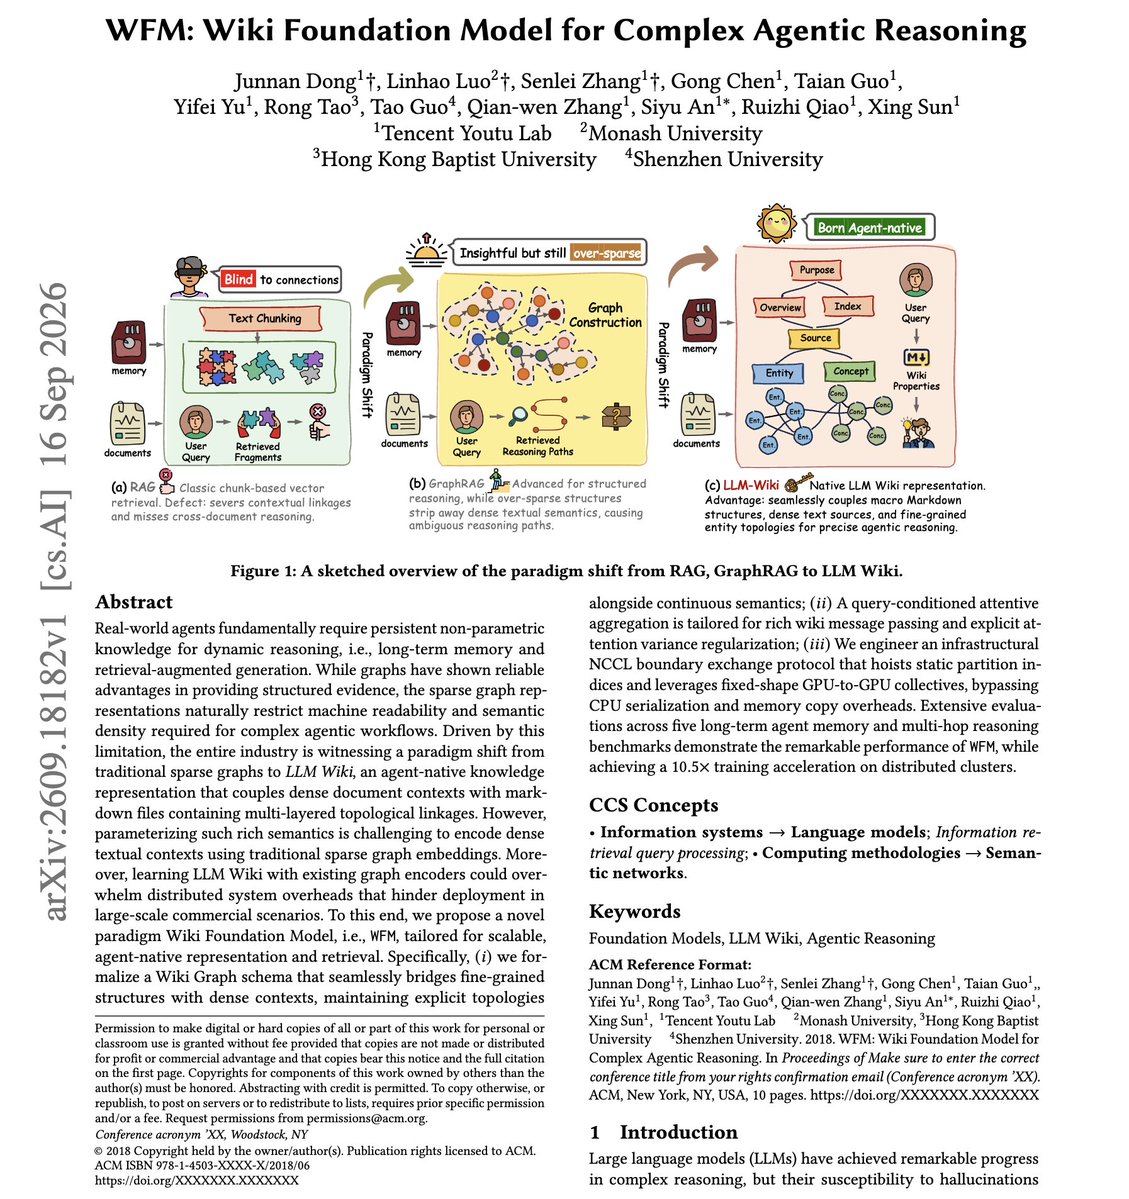
WFM: Biến bộ nhớ của AI thành Wiki Markdown liên kết

Interesting paper on agent memory stored as a linked markdown wiki. Lots of great ideas and insight…

DịchWFM là mô hình nền tảng Wiki giúp chuyển đổi dữ liệu LLM thành cấu trúc đồ thị, cho phép truy xuất thông tin dựa trên mối liên kết giữa các trang. Công nghệ này tối ưu hóa khả năng suy luận đa bước và tăng tốc độ huấn luyện lên 10,5 lần, lý tưởng cho các AI sử dụng bộ nhớ dạng Markdown.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 47/100

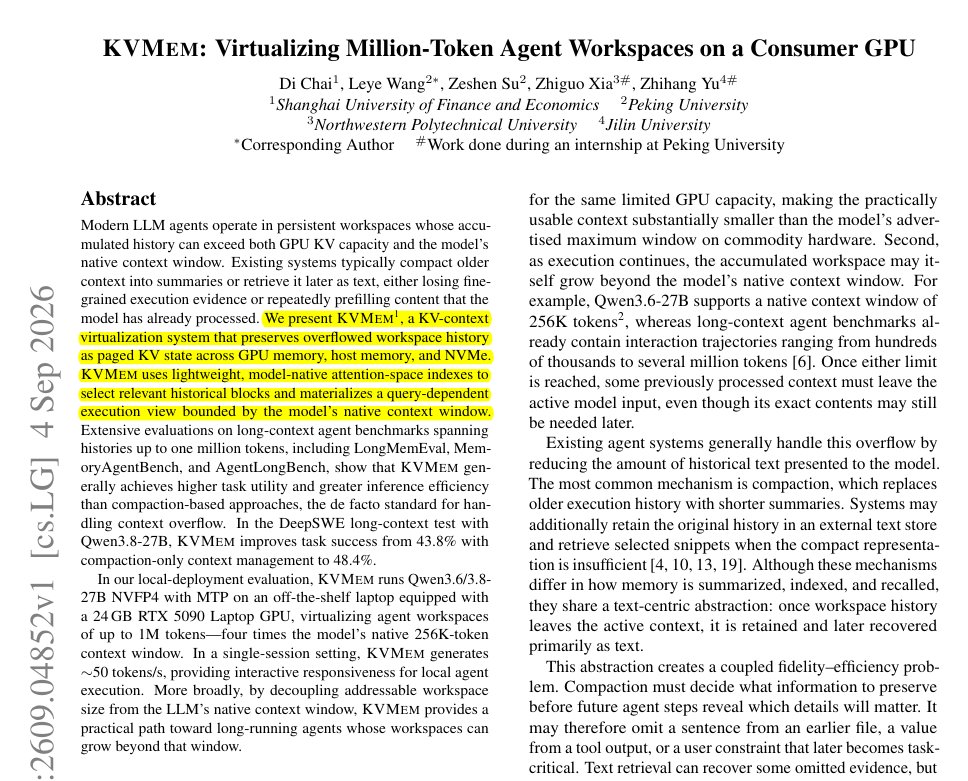
KVMEM: Giải pháp tối ưu hóa bộ nhớ cho AI Agent với khả năng xử lý hàng triệu token

A model's context window does not have to be an agent's workspace limit. KVMEM makes million-token …

DịchKVMEM áp dụng kỹ thuật phân trang trạng thái KV cũ giúp AI Agent xử lý hàng triệu token hiệu quả hơn. Công nghệ này cải thiện đáng kể độ chính xác trên DeepSWE và tăng tốc độ truy xuất dữ liệu gấp nhiều lần so với các phương pháp nén truyền thống.

OpenRouter: Announcements
Hướng dẫnĐiểm AI 66/100

Tinh chọnOpenRouter công bố hướng dẫn chọn mô hình Embedding tốt nhất năm 2026

OpenRouter đã kiểm chứng 37 mô hình embedding thông qua 28 bài kiểm tra hiệu năng thực tế, cung cấp cái nhìn toàn diện giúp người dùng lựa chọn mô hình phù hợp nhất cho dự án.


Vì sao đáng đọc: Tác giả đã thử nghiệm thực tế 19 mô hình qua API và đưa ra các ứng viên, giá cả cùng các tiêu chí theo trường hợp sử dụng, giúp độc giả đối chiếu lựa chọn trực tiếp dựa trên loại đầu vào và giới hạn lưu trữ.
Hongming@hongming731
Quan điểmĐiểm AI 57/100

Cùng sự kiệnĐiểm tin AI 23/09: Claude Opus 5.5 ra mắt, đột phá MiMo-V2 và ứng dụng LLM tại Meituan

Anthropic trình làng Claude Opus 5.5 với chi phí vận hành giảm 40% và tốc độ xử lý nhanh hơn 30%. Bản tin còn cập nhật về mô hình MiMo-V2 trong học tăng cường và cách Meituan tối ưu hóa hệ thống gợi ý bằng LLM.

Cùng sự kiện, tinh chọn hiển thị «Anthropic giải mã lý do Claude Opus 5.5 là lựa chọn tối ưu cho lập trình với ngữ cảnh dài»
Simon Willison Blog
Hướng dẫnĐiểm AI 34/100

Cùng sự kiệnCông cụ llm-anthropic 0.29 ra mắt: Hỗ trợ chính thức Claude Opus 5.5

Phiên bản llm-anthropic 0.29 vừa được phát hành, cho phép người dùng gọi trực tiếp mô hình Claude Opus 5.5 thông qua dòng lệnh với cú pháp đơn giản.

Cùng sự kiện, tinh chọn hiển thị «Claude Code cập nhật v2.1.280: Ra mắt Claude Opus 5.5 làm mô hình mặc định»
Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (50 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “LLM” — Trang 2 | AIHOT.vn