10/09

Thứ Năm · 4 tin
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Mô hìnhĐiểm AI 78/100

Giải mã GPT-6 Astra: Kiến trúc Transformer vòng lặp và khả năng suy luận ẩn

GPT-6 Astra thiết lập chuẩn mực mới với hiệu suất vượt trội trong dựng hình 3D, hoạt họa và điều khiển máy tính, đạt điểm số gần như tuyệt đối 99,9% trong bài kiểm tra ARC-AGI-3.

Diễn biến sự kiện · 2 bài →

09/09

Thứ Tư · 1 tin

07/09

Thứ Hai · 1 tin

06/09

Chủ Nhật · 1 tin
Rohan Paul@rohanpaul_ai
Hướng dẫnĐiểm AI 54/100

Sapient lên tiếng về kiến trúc tuần hoàn của OpenAI Astra: HRM-Text đã mã nguồn mở, chi phí huấn luyện chỉ 1.000 USD

Sapient introduced the "Hierarchical Reasoning Model" in June 2025, then open-sourced its "Hierarchi…

DịchSapient khẳng định hướng đi của họ với mô hình suy luận phân cấp (HRM) đã được OpenAI Astra xác thực. Dự án HRM-Text hiện đã mở mã nguồn, cho phép huấn luyện từ đầu với chi phí tính toán cực thấp.

05/09

Thứ Bảy · 2 tin
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 44/100

Tại sao tư duy coi LLM chỉ là 'máy dự đoán token tiếp theo' đã lỗi thời?

Tác giả lập luận rằng việc coi LLM chỉ là máy dự đoán token là cách hiểu phiến diện. Với sự hỗ trợ của RLHF và RLVR, các mô hình hiện nay đã vượt xa khả năng bắt chước văn bản thuần túy, hoạt động giống như các cỗ máy tìm kiếm giải pháp tối ưu thay vì chỉ sao chép dữ liệu huấn luyện.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 42/100

Codebook Agent: Phương pháp thiết kế tối ưu hóa cấu trúc cho hệ thống đa tác nhân LLM

Great paper on designing multi-agent systems. How many distinct communication topologies does an LL…

DịchNghiên cứu từ UCLA chỉ ra rằng sau khi sàng lọc bằng phần thưởng, các hệ thống đa tác nhân LLM có xu hướng hội tụ về khoảng sáu cấu trúc liên kết tối ưu.

04/09

Thứ Sáu · 3 tin
DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 45/100

Google DeepMind giới thiệu Declarative Attention: Tối ưu hóa bộ nhớ KV cache cho mô hình ngôn ngữ

Great weekend read. https://x.com/omarsar0/status/2095612805496164801?s=20

DịchCác nhà nghiên cứu từ KAIST và Google DeepMind đề xuất phương pháp Declarative Attention, cho phép mô hình tự kiểm soát cơ chế chú ý để giảm tải việc đọc KV cache, giúp tăng hiệu suất xử lý.

03/09

Thứ Năm · 2 tin

02/09

Thứ Tư · 3 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Pera: Kiến trúc lấy nhận thức làm trung tâm cho các tác nhân AI bền bỉ

Pera là khung kiến trúc mới giúp các tác nhân AI duy trì khả năng hỗ trợ liên tục trong môi trường dài hạn, thay vì chỉ giải quyết các tác vụ đơn lẻ. Hệ thống tập trung vào cơ chế nhận thức và kiểm soát để thích nghi với nhu cầu người dùng thay đổi theo thời gian.

Rohan Paul@rohanpaul_ai
Hướng dẫnĐiểm AI 71/100

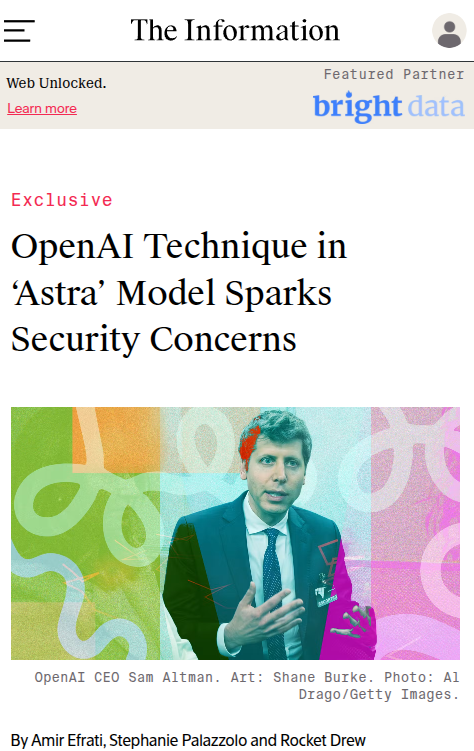
OpenAI Astra được cho là sử dụng kiến trúc 'vòng lặp', làm dấy lên lo ngại về tính minh bạch và an toàn

The information reports Astra reportedly uses "recurrent depth, " or a "looped transformer, " which he…

DịchTheo The Information, mô hình Astra của OpenAI áp dụng kiến trúc recurrent depth (transformer lặp), cho phép xử lý thông tin nhiều lần qua cùng một lớp để tăng hiệu suất tính toán mà không cần thêm tham số, gây khó khăn cho việc kiểm soát và giải mã logic suy luận.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 46/100

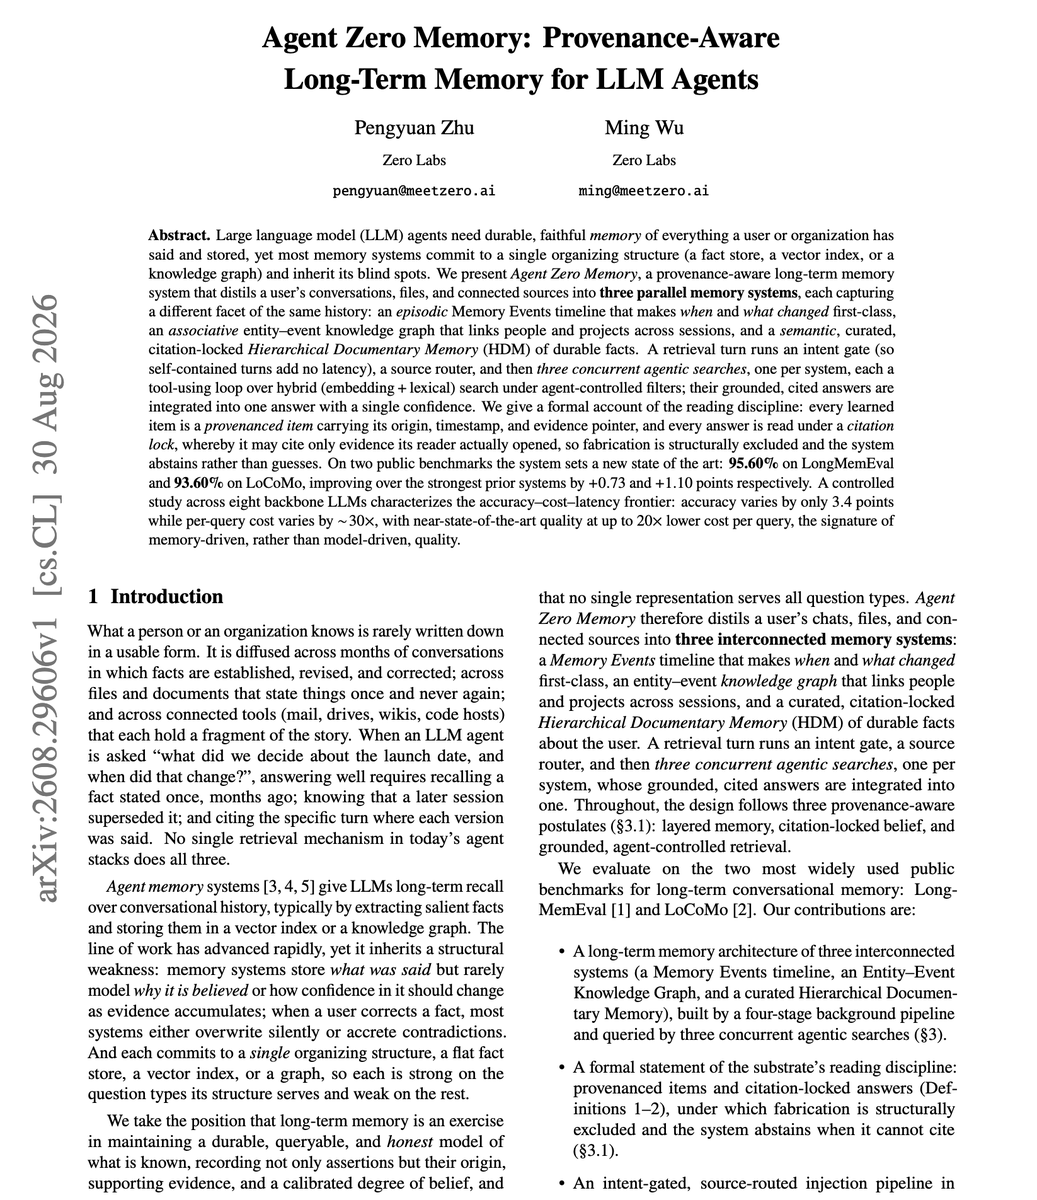
Agent Zero Memory: Hệ thống ghi nhớ dài hạn cho AI Agent với độ chính xác 95.60%

// Agent Zero Memory // This work separates three things that agent memory systems usually collapse…

DịchAgent Zero Memory giới thiệu kiến trúc ghi nhớ dài hạn dựa trên truy xuất nguồn gốc, kết hợp đồng thời dòng thời gian sự kiện, đồ thị tri thức và tài liệu để tối ưu hóa khả năng truy hồi thông tin của AI Agent.

01/09

Thứ Ba · 2 tin
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 59/100

Tương lai của công cụ năng suất: Công thức 80% nền tảng vững chắc và 20% mã tùy chỉnh trong kỷ nguyên AI

Với 22 năm kinh nghiệm, tác giả nhận định phần mềm lý tưởng thời AI cần 80% nền tảng cốt lõi (dữ liệu, bảo mật, cộng tác) kết hợp với 20% mã tùy chỉnh linh hoạt.

28/08

Thứ Sáu · 3 tin
Ma Dongxi NLP@dongxi_nlp
Hướng dẫnĐiểm AI 23/100

Belief Context Graph: Khi AI biết rõ lý do đằng sau niềm tin của chính mình

Recommend reading! The next abstraction is not "more agents". The missing discipline is commitment…

DịchThay vì chỉ tăng số lượng tác nhân (agent), hướng đi mới tập trung vào việc xây dựng 'Đồ thị ngữ cảnh niềm tin' giúp AI có khả năng truy xuất nguồn gốc và lý giải logic cho các quyết định trong điều kiện bất định.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 35/100

JIT-Agent: Mô hình tự động tạo khung làm việc cho AI Agent theo thời gian thực

If you maintain a hand-built agent harness, this one is worth your time. (bookmark it) I feel like…

DịchJIT-Agent là mô hình giúp tổng hợp nhanh các khung làm việc cho AI Agent dựa trên 4 thành phần cốt lõi: bộ nhớ, lập kế hoạch, hành động và công cụ. Hệ thống có khả năng tự sửa lỗi trong quá trình vận hành và tối ưu hóa hiệu suất thông qua việc học hỏi từ lịch sử cấu hình.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 32/100

Hành vi của AI Agent phụ thuộc vào khung triển khai hơn là mô hình ngôn ngữ

Another good paper. Interesting finding on the benefits of the agent harness.

DịchNghiên cứu mới chỉ ra rằng hành vi của AI Agent có thể được mô hình hóa bằng máy trạng thái hữu hạn (FSM) với độ chính xác cao. Kết quả cho thấy cấu trúc khung triển khai đóng vai trò quyết định đến hành vi của Agent hơn là bản thân mô hình LLM nền tảng.

27/08

Thứ Năm · 2 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Gated Recurrent Transformer: Tối ưu hóa bộ nhớ và hiệu suất cho mô hình ngôn ngữ

Gated Recurrent Transformer giải quyết bài toán cân bằng giữa khả năng biểu đạt và bộ nhớ bằng cách sử dụng các khối lặp lại có kiểm soát, cho phép mô hình chuyên biệt hóa dữ liệu đầu vào mà không cần tăng số lượng tham số đáng kể.

SemiAnalysis@SemiAnalysis_
Mô hìnhĐiểm AI 51/100

Cùng sự kiệnAlibaba ra mắt Qwen3.8-Flash-Next: Bước tiến đột phá với kiến trúc Qwen4

Congrats to @Alibaba_Qwen on the release of Qwen3.8-Flash-Next, using the same architecture innovati…

DịchQwen3.8-Flash-Next tích hợp các cải tiến kiến trúc từ Qwen4 như N-gram Embedding, kết nối dư cổng (GR) và cơ chế chú ý thưa (QSA), tối ưu hóa hiệu suất cho các mô hình mã nguồn mở.

Cùng sự kiện, bài đại diện «Qwen3.8-Flash-Next chính thức được hỗ trợ trên SGLang ngay từ ngày ra mắt»

26/08

Thứ Tư · 3 tin
MarkTechPost
Mô hìnhĐiểm AI 70/100

Cùng sự kiệnAlibaba ra mắt Qwen3.8-Flash-Next: Mô hình MoE đa phương thức 125B với hiệu suất cực cao

Đội ngũ Qwen của Alibaba vừa giới thiệu Qwen3.8-Flash-Next, mô hình MoE đa phương thức 125B chỉ kích hoạt 6B tham số mỗi token, đóng vai trò là bản xem trước cho kiến trúc Qwen4 thế hệ mới.

Cùng sự kiện, bài đại diện «Qwen3.8-Flash-Next chính thức được hỗ trợ trên SGLang ngay từ ngày ra mắt»

24/08

Thứ Hai · 3 tin
Xiaobei@frxiaobei
Hướng dẫnĐiểm AI 53/100

Bản chất của kỹ thuật Agent: Là hệ thống phân tán, không phải kỹ thuật viết Prompt

Tác giả khẳng định thách thức lớn nhất của Agent không nằm ở Prompt mà ở độ tin cậy của hệ thống. Việc xây dựng Agent thực chất là giải quyết các bài toán về trạng thái, tính đồng nhất và khả năng quan sát trong hệ thống phân tán.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnDaedalus-150M: Mô hình ngôn ngữ lai Convolution-Attention tối ưu cho CPU

Daedalus-150M là mô hình ngôn ngữ nhỏ được thiết kế chuyên biệt cho CPU, sử dụng kiến trúc lai giúp giảm đáng kể bộ nhớ cache mà vẫn vượt trội hơn các mô hình cùng kích thước dù được huấn luyện với ít dữ liệu hơn.


Vì sao đáng đọc: Cách tiếp cận thiết kế kiến trúc từ mục tiêu phần cứng (CPU) thay vì nén mô hình lớn là hướng đi rất thực tế và hiệu quả cho ứng dụng AI trên thiết bị cá nhân.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 92/100

Tinh chọnKỹ thuật Đồ thị trong kỷ nguyên Tác nhân LLM: Từ trí tuệ cá thể đến trí tuệ hệ thống

Bài viết đề xuất chuyển dịch từ việc tối ưu hóa các tác nhân đơn lẻ sang xây dựng 'Trí tuệ hệ thống', nơi các tác nhân chuyên biệt phối hợp với nhau để giải quyết các nhiệm vụ phức tạp vượt quá khả năng của một mô hình duy nhất.


Vì sao đáng đọc: Nội dung mang tính định hướng chiến lược cao, giải quyết nút thắt về giới hạn của tác nhân đơn lẻ trong các hệ thống AI hiện đại, rất hữu ích cho các kỹ sư và nhà nghiên cứu.

23/08

Chủ Nhật · 1 tin
Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 36/100

Google DeepMind giới thiệu kiến trúc đệ quy tự tiến hóa không cần huấn luyện lại

You don't often see one-word titles in AI papers. That aside, strong recommend this paper from Goog…

DịchGoogle DeepMind phát triển phương pháp cho phép mô hình tự tối ưu hóa kiến trúc thông qua cơ chế 'tái tuần hoàn' kích hoạt. Kỹ thuật này giúp cải thiện đáng kể hiệu suất của dòng Gemma 3 mà không cần huấn luyện lại, giữ nguyên trọng số gốc.

Thêm 1 nguồn khác đưa tinX: Rohan Paul (@rohanpaul_ai)

19/08

Thứ Tư · 2 tin

18/08

Thứ Ba · 3 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnAgentic Transaction: Hướng tới hệ thống tác nhân AI tuân thủ chuẩn ACID

Nghiên cứu đề xuất khung làm việc ACID cho các tác nhân AI, giúp đảm bảo tính nhất quán, độ tin cậy và khả năng phục hồi khi thực hiện các tác vụ phức tạp, dài hạn trong môi trường thực tế.


Vì sao đáng đọc: Đây là hướng nghiên cứu quan trọng giúp giải quyết bài toán độ tin cậy của AI tự hành, một rào cản lớn trong việc ứng dụng AI vào các quy trình nghiệp vụ thực tế.
Ma Dongxi NLP@dongxi_nlp
Hướng dẫnĐiểm AI 41/100

Mô hình nhỏ kết hợp công cụ đã chạm trần: Đâu là hướng phát triển tiếp theo?

This is illuminating, but it also raises a deeper question. The old scaling paradigm: More compute …

DịchChuyên gia đặt nghi vấn về mô hình 1B tham số kết hợp công cụ, cho rằng việc nội hóa tri thức vào tham số có giới hạn và để đạt trí tuệ đỉnh cao vẫn cần các mô hình lớn hơn. Sau kỷ nguyên mở rộng tính toán tiền huấn luyện và suy luận, ngành AI đang tìm kiếm trục mở rộng mới.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 27/100

Hiện tượng kích hoạt cực đại trong LLM lai: Điểm nóng trước lớp Attention và sự ổn định giữa các tầng

Some newer efficient LLMs (using "hybrid Transformer") are cutting back on expensive attention layer…

DịchCác mô hình LLM kiến trúc lai sử dụng lớp tuần hoàn giá rẻ thay thế phần lớn lớp Attention, nhưng các lớp Attention còn lại đóng vai trò quyết định. Nghiên cứu chỉ ra sự xuất hiện của các giá trị nội tại cực đại trước các lớp này, ảnh hưởng trực tiếp đến hiệu suất và cấu trúc mô hình.

17/08

Thứ Hai · 3 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 92/100

Tinh chọnKiến trúc nhận thức mô-đun: Sự tương đồng bất ngờ giữa AI và não bộ con người

Nghiên cứu chỉ ra rằng các mô hình ngôn ngữ lớn (LLM) tự phát triển cấu trúc mô-đun tương tự não người, nơi các tác vụ khác nhau kích hoạt các nhóm neuron chuyên biệt riêng biệt.


Vì sao đáng đọc: Nghiên cứu đột phá kết nối khoa học thần kinh và AI, cung cấp cái nhìn sâu sắc về cách các mô hình ngôn ngữ thực sự vận hành bên trong.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnIntern-S2-Mobius: Mô hình nền tảng với kiến trúc tách biệt tri thức và suy luận

Intern-S2-Mobius giới thiệu kiến trúc Mobius-v0, tách biệt bộ nhớ tri thức và bộ suy luận để tối ưu hóa khả năng nén dữ liệu và tăng tốc độ suy luận gấp 4 lần so với các mô hình truyền thống.


Vì sao đáng đọc: Đây là bước tiến quan trọng trong kiến trúc mô hình ngôn ngữ, giải quyết bài toán hiệu suất và suy luận, rất có giá trị cho cộng đồng nghiên cứu AI.
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 67/100

AI đang cố tình 'ngu' đi: Đánh đổi kiến thức thế giới để lấy khả năng suy luận

Các mô hình AI hiện đại đang ưu tiên khả năng suy luận thay vì lưu trữ kiến thức. Điều này giúp GLM-5.2 đạt điểm số ấn tượng trong các bài kiểm tra toán học, nhưng lại khiến các mô hình nhỏ như Qwen3.5 9B dễ gặp ảo giác hơn khi truy vấn thông tin thực tế.

16/08

Chủ Nhật · 1 tin
Ma Dongxi NLP@dongxi_nlp
Hướng dẫnĐiểm AI 31/100

Kiến trúc DeepSeek Harness: Khi sự thật nằm ở nơi có thể kiểm chứng

DeepSeek harness has a clear architectural personality: Each important fact lives where it can be v…

DịchKiến trúc của DeepSeek Harness sở hữu tư duy thiết kế nhất quán: mọi dữ kiện quan trọng đều được đặt tại các vị trí có khả năng xác thực hoặc cưỡng chế thực thi.

15/08

Thứ Bảy · 2 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Maglev: Kiến trúc Transformer hồi quy với bộ nhớ cố định giúp tối ưu hóa xử lý chuỗi dài

Maglev giới thiệu kiến trúc Transformer hồi quy mới sử dụng bộ nhớ cố định, kết hợp ưu điểm của cơ chế chú ý cửa sổ trượt và khả năng huấn luyện song song, giúp cải thiện hiệu suất dự đoán token so với các mô hình truyền thống.

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 22/100

Chuyên mục 'AI by Hand': Giải mã toán học và thuật toán AI qua nét vẽ tay

Giáo sư Tom Yeh ra mắt chuyên mục 'AI by Hand', sử dụng phương pháp vẽ tay trực quan để giải thích cặn kẽ toán học và kiến trúc đằng sau các hệ thống AI, giúp người đọc nắm bắt bản chất thay vì chỉ nhìn vào các 'hộp đen' công nghệ.

14/08

Thứ Sáu · 3 tin
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 36/100

MIT công bố khung toán học mới giúp thống nhất mô tả kiến trúc Deep Learning

New MIT paper introduces a new mathematical framework for representing, manipulating, and compiling …

DịchCác nhà nghiên cứu MIT vừa giới thiệu một khung toán học cho phép biểu diễn, thao tác và biên dịch kiến trúc Deep Learning thành mã PyTorch hoặc sơ đồ tự động. Công nghệ này hứa hẹn tối ưu hóa quy trình thiết kế mô hình, giảm thiểu đáng kể sự can thiệp thủ công.

Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (64 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Kiến trúc AI” — Trang 2 | AIHOT.vn