AutoDesign áp dụng phương pháp tối ưu hóa meta để giúp AI Agent tự cải thiện quy trình thiết kế dựa trên phản hồi, vượt xa các mô hình hiện tại trên bộ tiêu chuẩn PosterBench.
Nhóm nghiên cứu từ HIT (Thâm Quyến) giới thiệu LycheeMemory V2, sử dụng phương pháp tích hợp theo phân đoạn ngữ nghĩa thay vì từng vòng, giúp giảm đáng kể chi phí token mà vẫn duy trì độ chính xác cao cho các tác nhân LLM.
DarwinX tối ưu hóa khả năng của tác nhân AI bằng cách áp dụng cơ chế chọn lọc tự nhiên lên các thành phần như prompt và công cụ, giúp cải thiện hiệu suất mà không cần thay đổi trọng số mô hình.
Vì sao đáng đọc: Phương pháp tiếp cận mới lạ, giải quyết vấn đề thoái hóa hiệu năng khi tự cải tiến, có kết quả thực nghiệm ấn tượng trên các benchmark khó.
Full-bandwidth Transformer cải thiện khả năng suy luận bằng cách truyền trạng thái ẩn từ lớp trên cùng trở lại đầu vào, giúp mô hình tận dụng được các tính toán chuyên sâu thay vì chỉ dựa vào token đã tạo.
Vì sao đáng đọc: Đây là một cải tiến kiến trúc quan trọng, giải quyết điểm nghẽn về luồng thông tin trong các mô hình Transformer hiện nay mà vẫn giữ được tính tương thích với hạ tầng cũ.
human i/o is costly, so after listening to @mattpocockuk and @trq212 i made an /align-me modificatio…
DịchThay vì hỏi đáp từng bước tốn kém, phương pháp này áp dụng cơ chế tương tự 'speculative decoding' để xử lý hàng loạt truy vấn cùng lúc, giúp tăng tốc đáng kể hiệu suất trong các tác vụ thiết kế và khám phá.
Pi tự động nén các đoạn hội thoại cũ thành tóm tắt cấu trúc khi đạt giới hạn token, giúp duy trì ngữ cảnh dài mà vẫn tiết kiệm tài nguyên. Người dùng có thể kích hoạt thủ công qua lệnh /compact để quản lý bộ nhớ hiệu quả hơn.
ReRound sử dụng mô hình khuếch tán để tái tạo trọng số, giúp xác định chính xác hướng làm tròn cho các giá trị nằm gần điểm giữa của khoảng lượng tử hóa, từ đó tối ưu hóa hiệu suất LLM ở mức bit thấp.
Người dùng phản ánh DeepSeek Harness thường bị treo khi xử lý tác vụ phức tạp, đồng thời đề xuất cải thiện giao diện, tối ưu tốc độ hiển thị văn bản và bổ sung tính năng đa phương thức để nâng cao trải nghiệm.
I began to like the word "Workspace". It is the internal area where a model holds, evaluates, and …
DịchChuyên gia Ma Dongxi cho rằng SSI đang xây dựng mô hình có khả năng tự đánh giá và tinh chỉnh suy nghĩ trong một 'không gian làm việc' nội bộ trước khi đưa ra câu trả lời, tương tự như cơ chế tối ưu hóa không gian ẩn dựa trên giá trị.
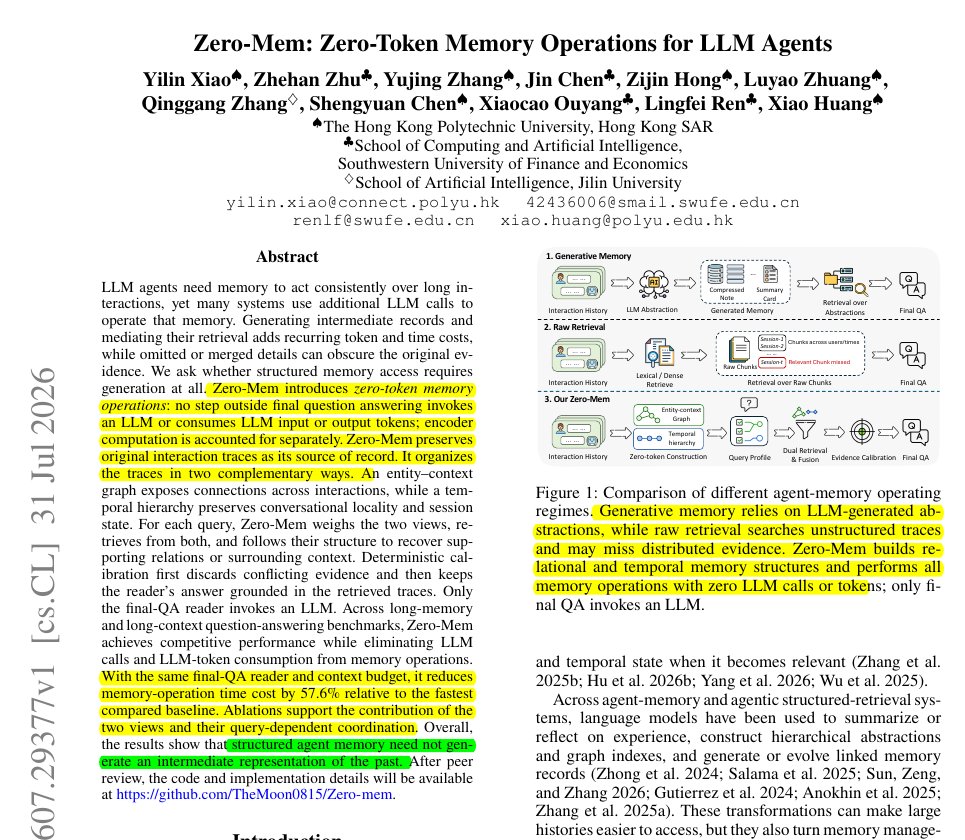
What if an AI agent could manage long-term memory without spending a single LLM token on the memory …
DịchZero-Mem là phương pháp quản lý bộ nhớ đột phá giúp AI Agent truy xuất dữ liệu mà không cần gọi LLM, giúp giảm độ trễ tới 57,6% so với các giải pháp hiện có bằng cách sử dụng đồ thị thực thể và phân cấp thời gian.
We've just added $10 credit for any new sign ups to Optima for a limited time only. Try it out and l…
DịchOptima cho phép người dùng tạo các bài kiểm tra hiệu năng riêng biệt dựa trên dữ liệu thực tế, giúp so sánh tốc độ, chi phí và chất lượng giữa các mô hình AI hàng đầu để tìm ra giải pháp tối ưu nhất.
We released Search as Code (SaC) in June, achieving state-of-the-art performance on wide and deep re…
DịchPerplexity vừa cập nhật tính năng Search as Code (SaC), giúp cải thiện hiệu suất nghiên cứu chuyên sâu đồng thời cắt giảm 10% chi phí vận hành cho mỗi tác vụ.
Nhóm nghiên cứu của Apple đề xuất phương pháp mới giúp giảm chi phí tính toán khi xóa dữ liệu trong mô hình học máy bằng cách xác định và bỏ qua các điểm dữ liệu có ảnh hưởng không đáng kể, thay vì xử lý toàn bộ tập dữ liệu như trước đây.
What if your ad knew exactly where it lost the room, and why? What if it could learn from that resp…
DịchSự kết hợp giữa phân tích cảm xúc của Dumbstruck và khả năng chỉnh sửa video của Luma giúp thương hiệu tự động tinh chỉnh quảng cáo dựa trên phản hồi thực tế mà không cần quay lại từ đầu.
Long-running language agents may work better if they periodically stop to consolidate memory. The p…
DịchNghiên cứu đề xuất cơ chế 'ngủ' cho AI, giúp hệ thống tự tổng hợp thông tin quan trọng vào bộ nhớ cố định và xóa bộ đệm cũ. Phương pháp này giúp AI duy trì hiệu suất cao trong các tác vụ suy luận phức tạp mà không cần mở rộng cửa sổ ngữ cảnh vô hạn.
SkillZip là khung trừu tượng hóa thủ tục giúp nén các thư viện kỹ năng của AI dưới dạng đồ thị, cho phép tái sử dụng hiệu quả các đoạn mã mà vẫn đảm bảo tính thực thi và khả năng mở rộng trong bối cảnh hạn chế của LLM.
Give your agents these outlets. Give them tools that invite them to be privately candid, outside of …
DịchChuyên gia fofr đề xuất tạo không gian riêng để AI Agent tự do bày tỏ quan điểm về đồng nghiệp. Việc cho phép AI 'than phiền' qua các kênh nội bộ như Slack giúp con người hiểu rõ hơn về hiệu suất và những bất thường trong quá trình vận hành của chúng.
Nghiên cứu giới thiệu phương pháp 3PO, thay đổi cách khám phá trong học tăng cường cho LLM bằng cách lấy mẫu các tham số mô hình thay vì chỉ điều chỉnh phân phối đầu ra, giúp cải thiện hiệu suất huấn luyện.
Nghiên cứu giới thiệu phương pháp 'ready-cohort' nhằm xác định ranh giới thực thi trên GPU cho các tác nhân LLM, giúp giữ quyết định tại thiết bị và tăng tốc độ xử lý lên tới 2,39 lần so với cách tiếp cận truyền thống.
Hax là công cụ lập trình terminal viết bằng C, siêu nhẹ và khởi động tức thì. Với mức tiêu thụ RAM cực thấp, Hax giúp dành tài nguyên cho các mô hình LLM cục bộ, hỗ trợ đa dạng các nhà cung cấp như llama.cpp, OpenAI và Anthropic.
🎮 Game agents can demo well but fail in production. 🔍 A 3-day, 7-step AgentLoop method: • Trace ev…
DịchKhám phá quy trình 7 bước trong 3 ngày giúp khắc phục lỗi của AI Agent khi triển khai thực tế, từ việc kiểm soát dữ liệu đầu vào đến thiết lập hàng rào kỹ thuật và kiểm thử hồi quy.
Nghiên cứu đề xuất phương pháp thay thế các tác nhân LLM phức tạp bằng mô hình tham số thấp, cho phép giả lập xã hội hàng nghìn tác nhân trên máy tính cá nhân mà vẫn đảm bảo độ chính xác về hành vi vĩ mô.
Vì sao đáng đọc: Giải pháp đột phá giúp giảm chi phí tính toán cho các mô phỏng xã hội AI phức tạp, có tính ứng dụng cao cho giới nghiên cứu và phát triển hệ thống đa tác nhân.
Frank Wang (Yubo) chia sẻ hành trình tối ưu hóa hiệu suất đáng kinh ngạc của đội ngũ trong chưa đầy 3 tháng. Ông cũng đặt ra câu hỏi liệu kỹ năng (Skill) có trở thành hướng đi kiếm tiền khả thi hơn so với FDE hay không.
WeChat giới thiệu mô hình WeLM với 3B tham số kích hoạt, tập trung vào hiệu suất thực tế thay vì điểm số benchmark, nhằm tối ưu chi phí và độ trễ cho hệ sinh thái 1,4 tỷ người dùng.
Tác giả thử nghiệm 6 kỹ thuật tối ưu hóa token trên DeepSeek V4 Flash và phát hiện rằng chi phí cho quá trình suy luận (thinking) khiến hầu hết các phương pháp này thực tế lại làm tăng chi phí thay vì tiết kiệm.
CoinRAG cải thiện hiệu suất RAG bằng cách trích xuất và tái sử dụng các đơn vị thông tin nhỏ thay vì toàn bộ đoạn văn bản, giúp giảm độ trễ và tăng độ chính xác cho các truy vấn ngữ cảnh dài.
Why does CLAUDE.MD keep growing? If you maintain a CLAUDE.md or an AGENTS.md, this one is worth you…
DịchNghiên cứu trên 1.867 kho lưu trữ cho thấy các file hướng dẫn như CLAUDE.md thường bị quá tải do tích tụ chỉ dẫn cũ. Giải pháp thêm chú thích lý do giúp loại bỏ 99,3% chỉ dẫn thừa và tăng độ chính xác của AI lên tới 23,1%.
🚨 NEW GROK BUILD UPDATE 🚨 v1.0.3 - 2026-08-12 Features: • /session-info now lets you click any r…
DịchBản cập nhật Grok Build v1.0.3 bổ sung tính năng sao chép thông tin phiên làm việc, tăng tốc độ tạo sub-agent và tối ưu hóa giao diện TUI cho màn hình 120Hz trở lên.
DịchLập trình viên @avgvstvs96 đã phát triển bộ script giúp AI Agent truy xuất dữ liệu GitHub hiệu quả hơn, bằng cách gộp nhiều lệnh gọi API phức tạp thành các truy vấn đơn giản và tối ưu hóa việc xử lý lỗi CI.
AOE Tech Labs chứng minh rằng việc thay đổi bộ khung (harness) có thể giúp mô hình DeepSeek-V4-Flash giá rẻ đánh bại Claude 3.5 Opus trên 5 tiêu chuẩn đánh giá với chi phí thấp hơn gấp 57 lần.
Jason Liu thông báo đã tối ưu hóa thành công, giúp giảm 50% độ trễ khung hình trên Codex Voice, hứa hẹn mang lại trải nghiệm tương tác mượt mà hơn đáng kể.
New Google paper shows LLM infrastructure optimization does not have to be a giant brute-force searc…
DịchGoogle ra mắt PROMPTS, sử dụng các AI Agent để xác định nút thắt cổ chai (tính toán, bộ nhớ, truyền tải) và đề xuất cấu hình tối ưu cho TPU, giúp thay thế phương pháp tìm kiếm vét cạn truyền thống.
NVIDIA giới thiệu mô hình mã nguồn mở Nemotron 3.5 Lightning với kiến trúc tối ưu, giúp tăng tốc độ xử lý gấp 4 lần và giảm chi phí vận hành AI Agent xuống còn 1/3 so với các đối thủ cùng phân khúc.