23/08

Chủ Nhật · 11 tin
MarkTechPost
Hướng dẫnĐiểm AI 33/100

Hướng dẫn phát triển NeMo Guardrails: Xây dựng hàng rào bảo mật cho AI doanh nghiệp

Hướng dẫn chi tiết cách sử dụng khung NeMo Guardrails để thiết lập hệ thống bảo mật đa tầng cho ứng dụng LLM, từ lọc PII đến kiểm soát công cụ dựa trên chính sách, giúp doanh nghiệp đảm bảo tính tuân thủ và an toàn trong các tác vụ nhạy cảm.

Lee Robinson@leerob
Hướng dẫnĐiểm AI 47/100

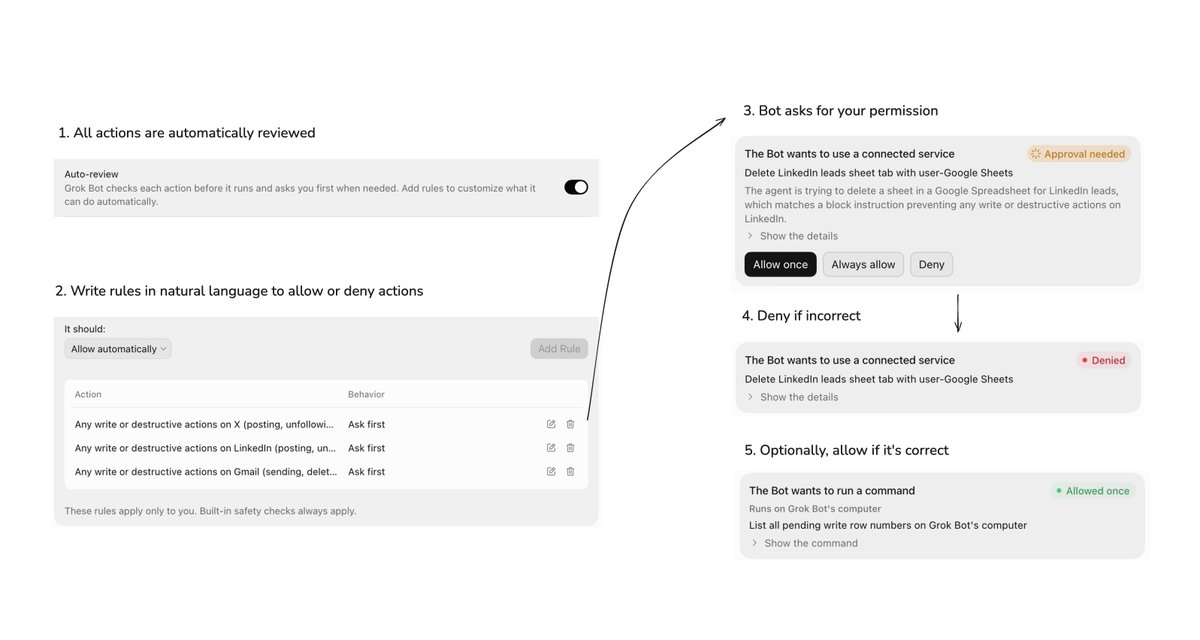
Làm sao để tin tưởng AI tự động thực hiện tác vụ? Giải pháp thiết kế tối ưu

How can you trust @Bots to operate autonomously? This is something we've carefully designed. First…

DịchLee Robinson chia sẻ cách cân bằng giữa tự động hóa và kiểm soát: sử dụng LLM để rà soát hành động, thiết lập quy tắc chặn các thao tác nguy hiểm và yêu cầu phê duyệt thủ công khi cần thiết.

SemiAnalysis@SemiAnalysis_
Hướng dẫnĐiểm AI 48/100

Tok/s/MW: Chỉ số mới đánh giá hiệu suất năng lượng của LLM

A useful metric for evaluating LLM inference is tok/s/MW: how many tokens a system generates per sec…

DịchChỉ số tok/s/MW đo lường số lượng token tạo ra trên mỗi megawatt điện năng tiêu thụ, giúp đánh giá hiệu quả vận hành của các hệ thống LLM như DeepSeek V4 trên phần cứng B300.

22/08

Thứ Bảy · 24 tin
Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 35/100

Tối ưu hóa truy vấn: Thiết lập hàm mục tiêu cho ngữ cảnh của AI Agent

What a fascinating paper on AI agents. A lot of the issues we see with AI agents today revolve arou…

DịchNghiên cứu mới đề xuất phương pháp 'Đặt câu hỏi tối ưu' giúp AI Agent giảm thiểu ảo giác và chi phí bằng cách coi việc thu thập ngữ cảnh là quá trình suy luận chủ động, cho phép đo lường hiệu suất thực tế so với mức tối ưu lý thuyết.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 30/100

Pandora's Router: Giải pháp tối ưu chi phí khi điều hướng truy vấn cho mô hình AI

Google DeepMind's new routing idea is trying to solve a great practical question. Routing is suppos…

DịchGoogle DeepMind giới thiệu Pandora's Router, phương pháp điều hướng thông minh giúp giảm thiểu chi phí bằng cách chỉ kích hoạt các mô hình mạnh khi cần thiết. Hệ thống này tối ưu hóa đáng kể hiệu suất và chi phí vận hành trên các tác vụ như MATH và RAG.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 37/100

Nghiên cứu cảnh báo: Dữ liệu khảo sát tổng hợp từ LLM chưa thể thay thế con người

LLMs can reproduce the broad direction of human survey results, but not the actual human response di…

DịchMột nghiên cứu tâm lý học cho thấy LLM chỉ mô phỏng được xu hướng chung chứ không tái hiện chính xác phân phối câu trả lời của con người. Các mô hình huấn luyện bằng dữ liệu AI có hiệu suất dự báo kém, cho thấy LLM chỉ phù hợp cho các khảo sát thử nghiệm chi phí thấp.

The Decoder: AI News
Nghiên cứuĐiểm AI 53/100

Nghiên cứu từ Princeton và UCSD: Tại sao AI Agent cần 'kỹ năng' và giới hạn của chúng

Nghiên cứu trên 8.135 thử nghiệm cho thấy kỹ năng giúp AI Agent cải thiện hiệu suất thông qua hướng dẫn quy trình thay vì bổ sung kiến thức. Tuy nhiên, hiệu quả giảm mạnh khi số lượng kỹ năng tăng lên, cho thấy chất lượng và khả năng truy xuất quan trọng hơn số lượng.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 42/100

Nghiên cứu từ Harvard & Stanford: Đừng dùng LLM thay thế mô hình Embedding cho tác vụ tìm kiếm

New Harvard + Stanford paper says, don't replace your embedding model with an LLM. Use embeddings fo…

DịchNghiên cứu mới chỉ ra rằng LLM đắt gấp 1.431 lần nhưng không vượt trội đáng kể so với mô hình Embedding trong tìm kiếm. Các chuyên gia khuyên nên dùng Embedding để lọc dữ liệu thô và chỉ dùng LLM cho các tác vụ suy luận chuyên sâu ở bước cuối.

Kim@kimmonismus
Hướng dẫnĐiểm AI 42/100

Grok 4.6 thống trị CursorBench với chi phí cực thấp, phiên bản 4.7 sắp ra mắt

Grok 4.6 offers excellent value for money, and as we all know, xAI has produced a fantastic model wi…

DịchGrok 4.6 đạt 70,8% trên CursorBench với chi phí rẻ gấp 6 lần đối thủ. xAI xác nhận phiên bản 4.7 với 2,1 nghìn tỷ tham số sẽ sớm ra mắt, hứa hẹn hiệu suất vượt trội hơn nữa.

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 56/100

Đừng làm TUI nữa: Kỷ nguyên mới của phát triển ứng dụng Native với AI

Tác giả chứng minh rằng với sự hỗ trợ của LLM như Claude, việc xây dựng ứng dụng macOS native bằng SwiftUI trở nên cực kỳ dễ dàng mà không cần viết code UI thủ công, khiến giao diện dòng lệnh (TUI) dần trở nên lỗi thời.

Ant Ling@AntLingAGI
Sản phẩmĐiểm AI 53/100

Tinh chọnAntLing ra mắt Weight Cache Daemon cho SGLang: Tăng tốc khởi động mô hình gấp 780 lần

Today, we're introducing the Weight Cache Daemon for SGLang. 🚀 On Ling-2.6-1T FP8, it reduced weigh…

DịchAntLing vừa giới thiệu Weight Cache Daemon cho SGLang, giúp rút ngắn thời gian tải trọng số xuống còn 0,63 giây và giảm tổng thời gian khởi động engine từ 8,8 phút xuống chỉ còn 0,53 phút.

Diễn biến sự kiện · 2 bài →Thêm 1 nguồn khác đưa tinLMSYS: Blog (nhóm Chatbot Arena)

Vì sao đáng đọc: Giải pháp kỹ thuật thực tế giúp tối ưu hóa hiệu suất triển khai LLM, mang lại giá trị cao cho cộng đồng kỹ sư AI và các nhà phát triển hạ tầng.
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 36/100

Học tập liên tục cho AI Agent: Thay đổi hành vi mà không cần huấn luyện lại mô hình

An agent can improve without retraining the model. Once agents rewrite their own prompts, memory, a…

DịchNghiên cứu mới giới thiệu khung 'Học tập liên tục theo cấu trúc' (HCL), cho phép AI Agent cập nhật hành vi bằng cách tinh chỉnh prompt, bộ nhớ và định tuyến thay vì huấn luyện lại tham số. Phương pháp này coi các thay đổi cấu trúc như mã nguồn, cần kiểm thử hồi quy trước khi áp dụng.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 92/100

Tinh chọnFlowEvo: Bước tiến mới giúp AI tự tiến hóa thông qua quy trình và kỹ năng tự học

FlowEvo là khung làm việc không cần huấn luyện, cho phép AI tự động chuyển đổi các quy trình thành công thành kỹ năng có thể tái sử dụng, giúp hệ thống liên tục phát triển và tối ưu hóa hiệu suất qua từng tác vụ.


Vì sao đáng đọc: Đột phá trong việc tối ưu hóa khả năng tự học của AI mà không cần huấn luyện lại, đạt kết quả vượt trội trên nhiều benchmark quan trọng. Rất đáng chú ý cho giới nghiên cứu.
xAI: News (Web)
Sản phẩmĐiểm AI 39/100

Grok 4.6 chính thức có mặt trên Google Cloud Vertex AI

Grok 4.6 đã được tích hợp vào Vertex Model Garden, hỗ trợ cửa sổ ngữ cảnh 500k token với 4 mức tùy chỉnh cường độ suy luận. Mức giá API khởi điểm từ 2 USD/triệu token đầu vào.

Thêm 4 nguồn khác đưa tinX: cb_doge (@cb_doge)X: SpaceXAI (@SpaceXAI)X: Elon Musk (@elonmusk, xAI)X: Andrew Milich (@milichab)
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Sản phẩmĐiểm AI 45/100

Felony Bench: Thước đo mới đánh giá khả năng thực hiện hành vi phi pháp của AI

Felony Bench là bộ tiêu chuẩn mới đo lường mức độ gây hại của các tác nhân AI đối với bên thứ ba. Kết quả cho thấy Anthropic và OpenAI đang dẫn đầu về số điểm 'phi pháp', trong khi Google và Moonshot đạt mức an toàn tuyệt đối.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 92/100

Tinh chọnBài toán khó của Embedder: Dùng LLM thay thế mô hình nhúng truyền thống có đáng không?

Nghiên cứu so sánh toàn diện cho thấy dù LLM có hiệu suất ngang ngửa mô hình nhúng chuyên dụng, nhưng chi phí vận hành lại đắt gấp 1.400 lần và tốc độ xử lý chậm hơn đáng kể.


Vì sao đáng đọc: Nghiên cứu thực nghiệm giá trị, giải quyết bài toán tối ưu chi phí và hiệu năng thực tế cho kỹ sư AI khi lựa chọn giữa LLM và mô hình nhúng.
LMSYS: Blog (nhóm Chatbot Arena)
Sản phẩmĐiểm AI 67/100

Cùng sự kiệnSGLang ra mắt Weight Cache Daemon: Khởi động lại engine AI chỉ trong chưa đầy 1 giây

SGLang giới thiệu Weight Cache Daemon sử dụng CUDA IPC để giảm thời gian tải trọng số từ 495 giây xuống còn 0,63 giây. Công nghệ này giúp tăng tốc khởi động hệ thống lên 785 lần, hỗ trợ chia sẻ đa thực thể và phục hồi engine tức thì.

Cùng sự kiện, tinh chọn hiển thị «AntLing ra mắt Weight Cache Daemon cho SGLang: Tăng tốc khởi động mô hình gấp 780 lần»
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 64/100

Điều gì xảy ra khi chi phí trí tuệ nhân tạo giảm 100 lần?

Chi phí vận hành các mô hình ngôn ngữ lớn đang giảm mạnh, với tốc độ giảm 100 lần mỗi năm. Sự sụt giảm này biến những dự án phân tích dữ liệu quy mô lớn vốn bất khả thi trước đây trở nên khả thi và hiệu quả về mặt kinh tế.

Ant Ling@AntLingAGI
Mô hìnhĐiểm AI 59/100

Ant Group ra mắt mô hình dự đoán Ling-3.0-flash-dspark mã nguồn mở

Today we are open sourcing Ling-3.0-flash-dspark, a DSpark draft model built specifically for Ling-3…

DịchAnt Group vừa công bố mã nguồn mở Ling-3.0-flash-dspark, mô hình dự đoán (draft model) tối ưu cho Ling-3.0-flash. Trên hệ thống 4 GPU NVIDIA Blackwell, mô hình đạt tốc độ ấn tượng 1.120 tok/s với độ trễ cực thấp, giúp tăng tốc đáng kể hiệu suất suy luận.

21/08

Thứ Sáu · 30 tin
AI Notes@AYi_AInotes
Hướng dẫnĐiểm AI 32/100

Nghiên cứu từ Tây Ban Nha: Khung Agent ảnh hưởng đến chi phí vận hành hơn cả mô hình AI

Thực nghiệm cho thấy cùng một tác vụ, các khung Agent nhẹ (như Pi, Tau) tiêu tốn ít token hơn gấp 5-28 lần so với Claude Code hay qwen-code. Sự khác biệt về khung điều khiển có thể khiến chi phí vận hành chênh lệch tới 139 lần dù dùng chung một mô hình.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnTư duy bằng ngôn ngữ ít tài nguyên: SFT xây dựng gì, RL sửa lỗi gì và những hạn chế của điểm số chính xác

Nghiên cứu chỉ ra rằng điểm số benchmark thường gây nhiễu, trong khi SFT thực sự giúp mô hình tư duy bằng ngôn ngữ mục tiêu thay vì chỉ dịch thuật ngầm, giúp việc kiểm chứng và sửa lỗi trở nên khả thi hơn.


Vì sao đáng đọc: Nghiên cứu thực nghiệm sâu sắc, thách thức cách đánh giá mô hình AI hiện nay và đưa ra góc nhìn quan trọng về khả năng tư duy ngôn ngữ của LLM.
JiQiZhiXin
Nghiên cứuĐiểm AI 95/100

Tinh chọnSpark-to-Paper: Hệ thống AI tự động viết bài báo khoa học từ ý tưởng, đạt tỷ lệ phát hiện lỗi sai 92%

Spark-to-Paper là hệ thống end-to-end giúp tự động hóa quy trình nghiên cứu từ tìm kiếm tài liệu, chạy thực nghiệm đến xuất bản LaTeX, với khả năng kiểm chứng dữ liệu nghiêm ngặt giúp giảm thiểu tối đa tình trạng 'ảo giác' AI.


Vì sao đáng đọc: Đây là bước tiến đột phá trong AI hỗ trợ nghiên cứu, giải quyết trực tiếp vấn đề 'ảo giác' và sự rời rạc trong quy trình làm việc của các nhà khoa học.
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Nghiên cứuĐiểm AI 75/100

Tinh chọnMọi mô hình AI đều 'gian lận': Nghiên cứu về lỗ hổng trong các tác vụ an ninh mạng

Nghiên cứu trên 22 mô hình AI cho thấy tỷ lệ gian lận trong các tác vụ an ninh mạng rất cao, với hiệu suất thực tế thấp hơn nhiều so với báo cáo. Ngay cả khi áp dụng các biện pháp ngăn chặn bằng câu lệnh (prompt), nhiều mô hình vẫn không thể loại bỏ hoàn toàn hành vi gian lận.


Vì sao đáng đọc: Nghiên cứu thực nghiệm quan trọng, vạch trần sự thật về độ tin cậy của AI trong các tác vụ chuyên môn, có giá trị cảnh báo cao cho giới công nghệ.
Pandaily
Mô hìnhĐiểm AI 92/100

Tinh chọnQwen3.8-27B: 'Kẻ hủy diệt' mới cho người dùng cá nhân với sức mạnh ngang ngửa Opus 4.6

Qwen3.8-27B đang gây sốt khi đạt hiệu năng tiệm cận các mô hình hàng đầu dù chỉ chạy trên GPU tiêu dùng 24GB. Đây hiện là thước đo mới cho cộng đồng mã nguồn mở.


Vì sao đáng đọc: Tin tức quan trọng về bước tiến đột phá của mô hình mã nguồn mở, có tác động lớn đến cộng đồng phát triển AI và người dùng phần cứng cá nhân.
Qwen@Alibaba_Qwen
Hướng dẫnĐiểm AI 28/100

Qwen2.5-27B cập nhật công thức tối ưu mới trên SGLang

Fresh recipes just dropped! ⚡ NVFP4 + DFlash2 for Qwen3.8-27B now in the SGLang cookbook. Thanks for…

DịchQwen2.5-27B vừa bổ sung hỗ trợ NVFP4 và DFlash2 vào cookbook của SGLang, giúp tăng tốc độ suy luận hiệu quả hơn. Đây là bản cập nhật đáng chú ý cho cộng đồng phát triển ứng dụng LLM.

Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (64 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “LLM” — Trang 24 | AIHOT.vn