Ugreen ra mắt nền tảng nhà thông minh HomeAgent tại IFA: Tích hợp AI cục bộ với trợ lý Uliya
Ugreen giới thiệu HomeAgent, nền tảng nhà thông minh tích hợp NAS và NVR, sử dụng trợ lý AI Uliya xử lý dữ liệu hoàn toàn cục bộ mà không cần phí thuê bao.
Nvidia giới thiệu công cụ mã nguồn mở PAIR giúp điều phối các tác vụ AI cục bộ giữa các thiết bị trong nhà, tối ưu hóa hiệu suất cho Ollama và LM Studio mà không cần thay đổi cấu hình ứng dụng.
NVIDIA vừa giới thiệu Personal AI Router (PAIR) dưới dạng mã nguồn mở, cho phép tự động phân phối các tác vụ AI cục bộ từ Ollama hoặc LM Studio sang các thiết bị rảnh rỗi trong mạng nội bộ.
Aravind Srinivas (Perplexity CEO)@AravSrinivasPortable Computer (fully local runtime of Perplexity Computer) is now compatible with RTX (Linux). W…
DịchCEO Aravind Srinivas thông báo Portable Computer của Perplexity đã hỗ trợ chạy cục bộ trên Linux với GPU NVIDIA RTX (yêu cầu VRAM từ 24GB trở lên), phiên bản Windows sẽ sớm ra mắt.
Tại IFA 2026, NVIDIA hợp tác cùng Microsoft giới thiệu dòng PC RTX Spark nhỏ gọn, tối ưu hóa khả năng chạy các tác nhân AI cục bộ cho nhà phát triển và người sáng tạo.
Nvidia giới thiệu công cụ mã nguồn mở PAIR, cho phép kết nối các máy tính trong mạng nội bộ để tạo thành hệ thống xử lý AI cục bộ, hỗ trợ tốt cho Ollama và LM Studio.
Thêm 1 nguồn khác đưa tinThe Decoder: AI News
ModelBest OpenBMB@OpenBMBWhat if your AI agents could be lightning-fast, privacy-first, and smart enough to handle complex mu…
DịchMiniCPM Agent Gateway là hệ thống định tuyến Agent tập trung vào chất lượng và tính cục bộ, được xây dựng trên nền tảng NVIDIA-NeMo/Switchyard. Giải pháp này tối ưu hóa tốc độ và bảo mật cho các tác vụ đa phương thức phức tạp.
Perplexity vừa mã nguồn mở Lily, công cụ suy luận hiệu năng cao viết bằng Rust và Metal, được thiết kế chuyên biệt để chạy mô hình Qwen3.6-35B-A3B trên chip Apple Silicon mà không cần phụ thuộc vào PyTorch hay MLX.
WebLLM là dự án mã nguồn mở cho phép chạy các mô hình ngôn ngữ lớn ngay trên trình duyệt web mà không cần server, tận dụng tối đa sức mạnh phần cứng của người dùng.
Nhóm Lâm Diệc đã phát triển và mã nguồn mở Jarvis, một trợ lý AI toàn năng chạy cục bộ trên máy tính, tận dụng khả năng phản hồi độ trễ thấp của mô hình MiniCPM-o 4.5.
Aravind Srinivas (Perplexity CEO)@AravSrinivasWe're open-sourcing Lily, Perplexity's local inference engine for serving models locally on Apple Si…
DịchPerplexity vừa mã nguồn mở Lily, công cụ suy luận được tối ưu hóa cho chip Apple Silicon để chạy mô hình Qwen3.6-35B-A3B, giúp tăng tốc các tác vụ tính toán hỗn hợp trên Mac mà không phụ thuộc vào điện toán đám mây.

Aravind Srinivas (Perplexity CEO)@AravSrinivasLive demo of Perplexity Computer running fully local on DGX Spark
DịchCEO Aravind Srinivas vừa chia sẻ video trực tiếp cho thấy Perplexity Computer vận hành trơn tru trên phần cứng DGX Spark của NVIDIA mà không cần kết nối đám mây, khẳng định bước tiến mới trong việc triển khai AI cục bộ.
Nubia NaviX Ultra vừa đạt chứng nhận mạng, dự kiến lên kệ vào tháng 9 với trợ lý AI Doubao tích hợp sâu. Thiết bị tập trung vào khả năng xử lý cục bộ, cho phép AI điều khiển ứng dụng thông qua giao thức MCP thay vì mô phỏng thao tác chạm truyền thống.
Cùng sự kiện, bài đại diện «Nubia NaviX Ultra chính thức lộ diện: Chip Snapdragon, màn hình BOE và tích hợp trợ lý AI Doubao»
Aravind Srinivas (Perplexity CEO)@AravSrinivasLive demo of Portable Computer (aka a fully local runtime of Perplexity Computer) on DGX Spark
DịchCEO Aravind Srinivas sẽ livestream demo 'Perplexity Computer' chạy hoàn toàn cục bộ trên hệ thống NVIDIA DGX Spark vào ngày 2/9. Buổi trình diễn hứa hẹn giới thiệu các tính năng phân tích tài liệu bảo mật và kết nối công cụ chuyên sâu.
Aravind Srinivas (Perplexity CEO)@AravSrinivasWe're introducing hybrid compute for all users of the Perplexity Mac app. This will allow Computer…
DịchPerplexity vừa cập nhật tính năng hybrid compute cho ứng dụng Mac, cho phép chạy các mô hình AI cục bộ để xử lý dữ liệu nhạy cảm như báo cáo y tế hay tài liệu thuế, giúp đảm bảo quyền riêng tư tối đa cho người dùng.
Tận dụng micro từ camera an ninh sẵn có để chạy BirdNet-Go, giúp nhận diện hơn 14.000 loài chim, dơi và ếch cục bộ 24/7 mà không tốn phí thuê bao. Hệ thống hỗ trợ tích hợp Home Assistant và gửi thông báo qua Discord.
OpenShot 4.0 mang đến bước tiến lớn với tính năng ghi hình trực tiếp, bộ công cụ chỉnh màu chuyên sâu và AI Masking chạy hoàn toàn ngoại tuyến, không cần đăng ký dịch vụ đám mây.
Perplexity giới thiệu Portable Computer, khung làm việc cho phép chạy các mô hình như Qwen 2.8-27B ngay trên thiết bị cá nhân, giúp bảo mật dữ liệu và loại bỏ chi phí API cho các tác vụ AI thông thường.
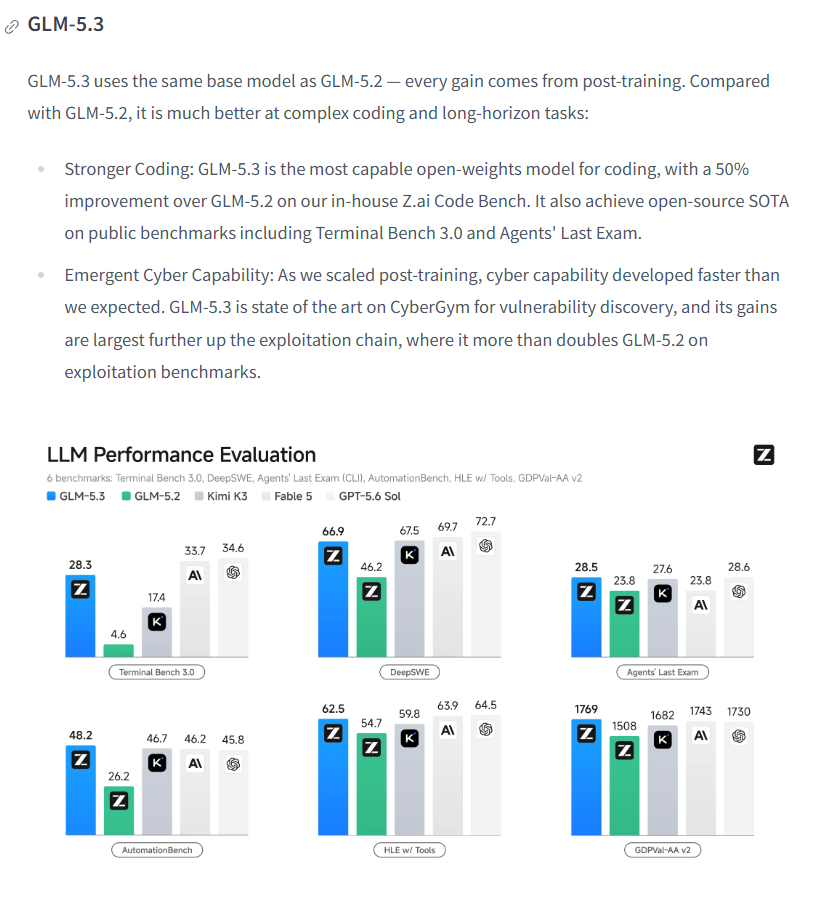
Kim@kimmonismusGLM-5.3 is officially live on Hugging Face. What should run it locally: - FP8: 10-12× H100 or 8× H…
DịchGLM-5.3 đã có mặt trên Hugging Face với các phiên bản lượng tử hóa GGUF và NVFP4, cho phép người dùng dễ dàng triển khai và chạy trực tiếp trên máy tính cá nhân.

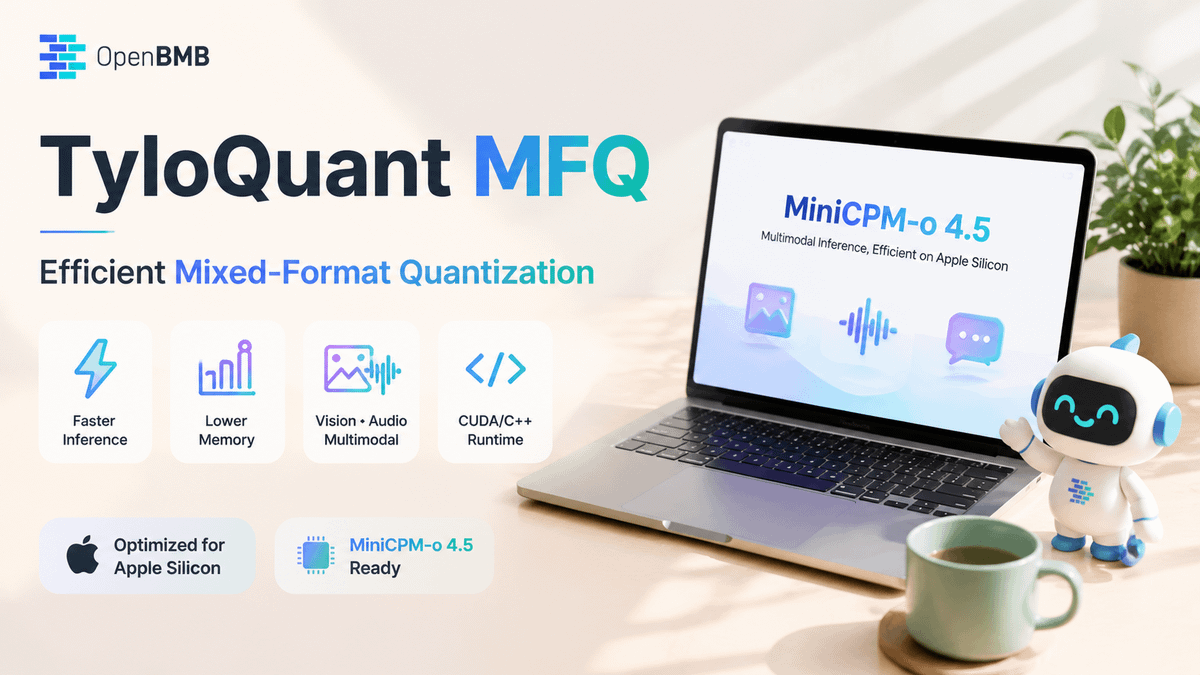
ModelBest OpenBMB@OpenBMBMiniCPM-o 4.5 now runs efficiently on Apple Silicon with TyloQuant MFQ! 🥰 The team at @Tylogi_ai h…
DịchMô hình MiniCPM-o 4.5 hiện đã có thể chạy cục bộ trên chip Apple Silicon thông qua kỹ thuật lượng tử hóa TyloQuant MFQ, giúp tối ưu bộ nhớ mà vẫn giữ nguyên khả năng xử lý đa phương thức và tương tác thời gian thực.

Kim@kimmonismusyou just need 10-12× H100 for FP8, or $400.000-$650.000 to run GLM-5.3 locally.
DịchĐể vận hành mô hình GLM-5.3 ở định dạng FP8 ngay tại máy chủ nội bộ, người dùng cần đầu tư hệ thống gồm 10-12 GPU H100 với chi phí ước tính từ 400.000 đến 650.000 USD.
Perplexity AI vừa giới thiệu Portable Computer, phiên bản chạy cục bộ của hệ thống tác nhân AI đa mô hình, giúp người dùng xử lý công việc riêng tư ngay trên thiết bị và chỉ kết nối đám mây khi thực sự cần thiết.
Aravind Srinivas (Perplexity CEO)@AravSrinivasHardware like DGX Spark, with a local agentic computer, will become the gateway for consuming fronti…
DịchCEO Perplexity dự báo thiết bị tích hợp AI cục bộ sẽ xử lý 90% tác vụ, giúp giảm 10 lần chi phí bằng cách tối ưu hóa token trước khi gửi lên mô hình đám mây.

Qwen@Alibaba_QwenA high-performance 125B model now running locally on just 75GB RAM! Thank you @UnslothAI for the day…
DịchNhờ sự hỗ trợ từ UnslothAI, mô hình mạnh mẽ 125B của Alibaba giờ đây đã có thể vận hành cục bộ chỉ với 75GB RAM, mở ra khả năng tiếp cận AI hiệu năng cao cho người dùng cá nhân.
AI Notes@AYi_AInotesThay vì dựa vào điểm hiệu năng CPU, người dùng nên ưu tiên dung lượng RAM thống nhất khi chọn Mac để chạy AI cục bộ. Tùy vào nhu cầu từ nhẹ đến chuyên sâu, hãy cân nhắc các cấu hình từ 16GB đến 64GB RAM để tối ưu hóa khả năng xử lý mô hình.

Perplexity giới thiệu giải pháp Portable Computer tích hợp trên NVIDIA DGX Spark, cho phép vận hành các tác nhân AI cục bộ hoàn toàn mà không phát sinh chi phí theo token.
Perplexity@perplexity_aiNew research: Portable Computer is a local-first agent for private and cost-effective work. With an…
DịchPerplexity giới thiệu Portable Computer, một tác nhân AI chạy cục bộ với mô hình 27B, giúp tối ưu hóa công việc tri thức với độ bảo mật cao và chi phí thấp, vượt qua các khung làm việc mã nguồn mở hiện nay.

Perplexity@perplexity_aiToday we're launching Portable Computer on @NVIDIA DGX Spark. Portable Computer is a fully local ve…
DịchPerplexity vừa giới thiệu phiên bản Portable Computer chạy hoàn toàn cục bộ trên phần cứng NVIDIA DGX Spark, cho phép vận hành toàn bộ quy trình LLM và tác nhân AI mà không cần dựa vào đám mây.
Testing Catalog@testingcatalogPERPLEXITY 🔥: Perplexity Pro and Max subscribers can now use a new Portable Computer on DGX Spark f…
DịchNgười dùng Perplexity Pro và Max hiện có thể chạy các mô hình AI cục bộ mạnh mẽ như PPLX 27B và Qwen 3.8 27B trực tiếp trên thiết bị NVIDIA DGX Spark, mang lại trải nghiệm xử lý dữ liệu riêng tư và tốc độ cao.
Apple vừa trình làng Mac mini và Mac Studio mới với chip M6 (2nm) và M5 Ultra, tập trung mạnh mẽ vào khả năng xử lý AI cục bộ nhờ kiến trúc bộ nhớ thống nhất và hiệu suất GPU vượt trội.
Cùng sự kiện, bài đại diện «Apple ra mắt chip M6 và M5 Ultra: Bước nhảy vọt về hiệu năng và sức mạnh AI»
Kim@kimmonismusHuge upgrade for local AI: Apple introduces M6 and M5 Ultra for a "big leap in performance and AI co…
DịchApple chính thức trình làng dòng chip M6 và M5 Ultra với trọng tâm là khả năng xử lý AI cục bộ. Trong đó, M6 đạt tốc độ xử lý LLM nhanh gấp 4,8 lần so với M4, băng thông bộ nhớ 170GB/s và tích hợp hệ thống Neural Engine kép mạnh mẽ.

Kim@kimmonismusNice: Apple may launch an M5 or M6 Mac mini before its iPhone keynote, "as soon as the coming days" …
DịchApple dự kiến trình làng Mac mini thế hệ mới trong vài ngày tới sau gần 2 năm chờ đợi. Thiết bị được kỳ vọng sẽ đáp ứng nhu cầu chạy các ứng dụng AI cục bộ đang tăng cao, vốn đang gây ra tình trạng khan hiếm nguồn cung cho các phiên bản hiện tại.

Chủ tịch Xiaomi Lu Weibing vừa giới thiệu Xuanjie O100, thiết bị AI chuyên dụng loại bỏ camera sau để tập trung vào hệ thống chip kép và tản nhiệt chủ động, đạt tốc độ xử lý MiMo ấn tượng 295 token/giây.
Cohere@cohereSupertranscribe = S-tier. Cohere is now the default local model for @superwhisper onboarding. Dicta…
DịchSuperwhisper đã tích hợp Cohere làm mô hình mặc định cho trải nghiệm chuyển đổi giọng nói thành văn bản cục bộ, cho phép người dùng ghi chú ý tưởng ngay trên thiết bị mà không cần kết nối internet.
Artificial Analysis@ArtificialAnlysYou can now benchmark Qwen3.8 27B with Optima. See how a model that can run on your laptop compares …
DịchBạn có thể sử dụng Optima để đánh giá hiệu suất, chi phí và tốc độ của mô hình Qwen2.5 27B trên các tác vụ thực tế ngay trên máy tính cá nhân. Artificial Analysis cũng cung cấp hỗ trợ tư vấn và tín dụng miễn phí cho các doanh nghiệp muốn xây dựng bộ kiểm thử riêng.
Xiaomi giới thiệu nguyên mẫu thiết bị gập O100 trang bị hệ thống chip AI Xuanjie và tản nhiệt chủ động 10W, cùng máy tính mini AI Cube hỗ trợ chạy mô hình ngôn ngữ lớn cục bộ.
Thêm 1 nguồn khác đưa tinPandaily
Yuchen Jin@Yuchenj_UW2024: A gaming PC with a RTX 4090 ran Llama 3 70B at ~2 tok/s in 4-bit. 2026: A gaming PC with a RT…
DịchTừ mức 2 tok/s trên RTX 4090 năm 2024, tốc độ chạy mô hình AI cục bộ dự kiến đạt 24 tok/s trên RTX 5090 vào năm 2026, mở ra khả năng chạy các mô hình thông minh cấp độ cao ngay tại nhà.
Người dùng thường đánh giá thấp khả năng của LLM do sử dụng các phiên bản đã được nén (quantized) làm giảm độ chính xác. Hiệu suất kém thực chất nằm ở cách triển khai thay vì lỗi của chính mô hình.
Nghiên cứu mới cho thấy AI chạy cục bộ hiện đạt chất lượng tương đương 89% so với các mô hình đám mây hàng đầu, giúp giảm tới 80% năng lượng và 74% chi phí vận hành.
Yuchen Jin@Yuchenj_UWUC Berkeley open-sourced FreeToken. Wild results: A single RTX PRO 6000 runs the 753B GLM-5.2 at 14…
DịchFreeToken từ UC Berkeley cho phép chạy các mô hình lớn như GLM-5.2 hay Qwen3.6 trên GPU phổ thông với tốc độ nhanh gấp 2-4 lần so với Ollama mà không cần nén mô hình quá mức.