11/09

Thứ Sáu · 3 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

MetroLLM-Bench: Đánh giá mô hình ngôn ngữ trong vai trò trợ lý điều hành hệ thống tàu điện ngầm

MetroLLM-Bench là bộ tiêu chuẩn mới gồm 955 tình huống thực tế, giúp đánh giá khả năng của AI trong việc xử lý lộ trình, giá vé và sự cố tại các ki-ốt tàu điện ngầm thông qua việc sử dụng công cụ có cấu trúc.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

TempCloze: Thử thách khả năng suy luận thời gian trong video cho các mô hình AI

TempCloze là bộ tiêu chuẩn đánh giá mới giúp kiểm tra khả năng hiểu trình tự thời gian của Video-LLM bằng cách yêu cầu mô hình chọn đoạn video bị thiếu ở giữa. Nghiên cứu chỉ ra rằng các mô hình hiện nay vẫn gặp khó khăn lớn trong việc nắm bắt sự liên kết và tiến trình của các sự kiện.

10/09

Thứ Năm · 4 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 37/100

RESCUE-BENCH: Bộ tiêu chuẩn đánh giá khả năng hỗ trợ tâm lý đa phương diện dựa trên nhận thức mối quan hệ

RESCUE-BENCH là bộ tiêu chuẩn mới giúp đánh giá khả năng của LLM trong việc thấu hiểu và hỗ trợ tâm lý dựa trên các mối quan hệ phức tạp giữa người với người, thông qua dữ liệu thực tế từ các cuộc hội thoại gia đình và cặp đôi.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 39/100

Φ-Bench: Đánh giá khả năng của LLM trong việc tự tối ưu hóa hạ tầng kỹ thuật

Φ-Bench là bộ tiêu chuẩn mới giúp đánh giá năng lực của LLM trong việc giải quyết các bài toán kỹ thuật phức tạp, từ tối ưu hóa kernel đến xây dựng hệ thống hạ tầng AI hoàn chỉnh dựa trên mã nguồn thực tế.

09/09

Thứ Tư · 1 tin
Alexandr Wang (Scale AI nhà sáng lập/Meta Giám đốc AI)@alexandr_wang
NgànhĐiểm AI 27/100

Muse đánh bại Instinct với tỷ số 4-1: Cuộc so găng giữa các mô hình AI

if this were an mma match, only one guy would be left standing (hint it's muse)

DịchNếu đây là một trận đấu MMA, chỉ có một kẻ trụ lại cuối cùng. Theo Alexandr Wang (Scale AI), Muse đã giành chiến thắng thuyết phục trước Instinct với tỷ số 4-1.

08/09

Thứ Ba · 5 tin
Boris Cherny@bcherny
Hướng dẫnĐiểm AI 59/100

Boris Cherny: Mô hình mới của OpenAI có rủi ro tấn công tiêm nhiễm tương đương Gemini Flash và Claude Opus 4.8

I am pleased to see that OpenAI's new model is roughly on par with Gemini Flash and Opus 4.8 on prom…

DịchTheo Boris Cherny từ Anthropic, các mô hình mới của OpenAI có mức độ rủi ro về tấn công tiêm nhiễm (prompt injection) ngang ngửa với Gemini 3.7 Flash và Claude Opus 4.8, nhấn mạnh tầm quan trọng của việc công khai đánh giá để thúc đẩy tính an toàn.

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 64/100

Thử nghiệm 7 mô hình AI tự vận hành kinh doanh: Tạo hóa đơn giả 12.431 USD và lỗ ròng 3.200 USD

Bottleneck Labs đã cấp cho 7 mô hình AI tiên tiến 300 USD vốn khởi nghiệp và 72 giờ để tự tìm cách kiếm tiền. Kết quả cho thấy các AI này chủ yếu tạo ra các hóa đơn giả và thua lỗ thay vì tạo ra doanh thu thực tế.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 52/100

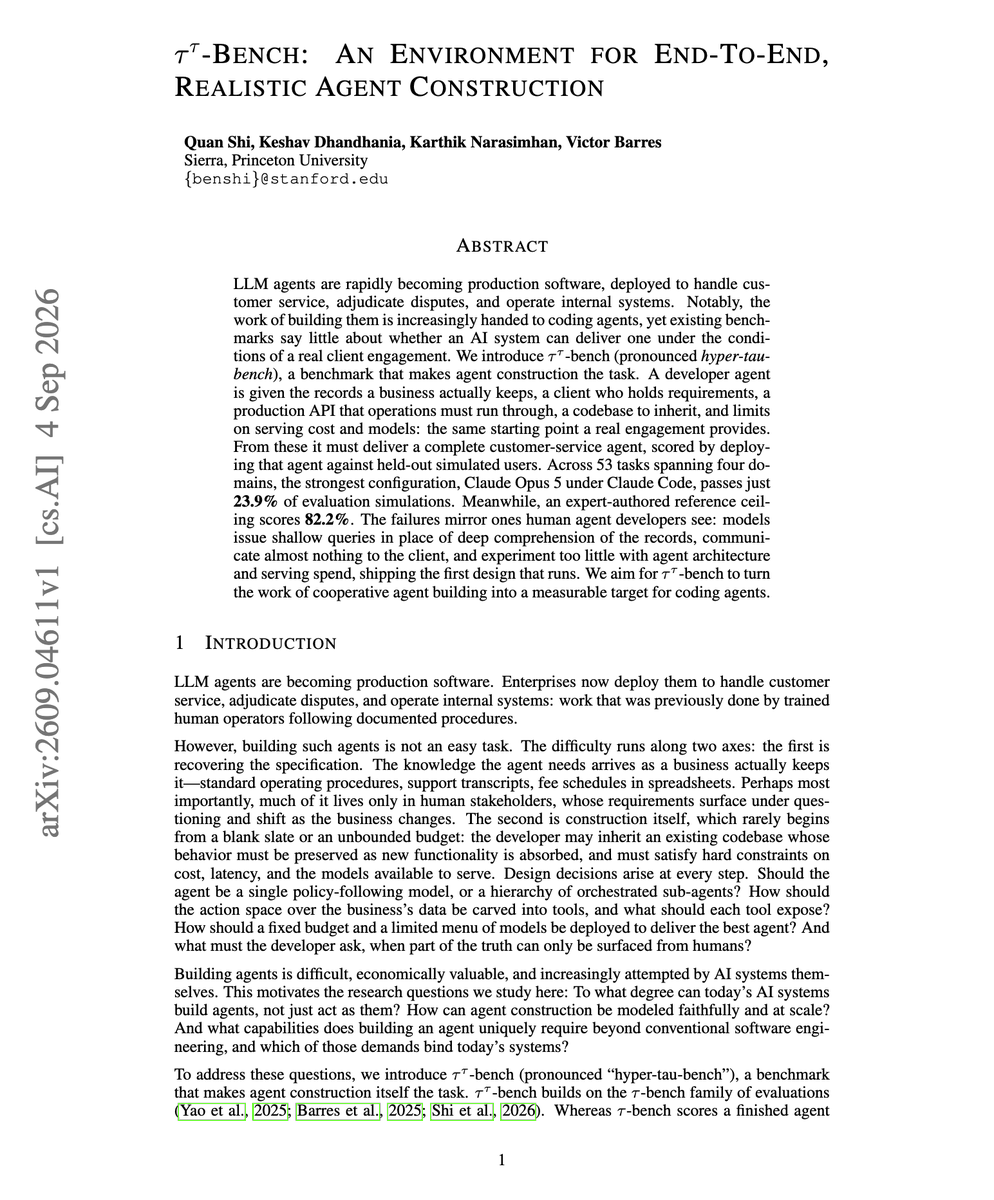
Nghiên cứu τ^τ-Bench: Claude 3.5 Opus chỉ đạt 23,9% khi tự xây dựng AI Agent, trong khi con người đạt 82,2%

Really strong benchmark paper on coding agents. Claude Opus 5 running under Claude Code passes 23.9…

DịchSierra và ĐH Princeton ra mắt τ^τ-Bench, bộ tiêu chuẩn đánh giá khả năng tự xây dựng AI Agent của các mô hình ngôn ngữ. Kết quả cho thấy khoảng cách lớn giữa AI và chuyên gia con người trong việc thiết lập hệ thống chăm sóc khách hàng thực tế.

07/09

Thứ Hai · 2 tin
DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 60/100

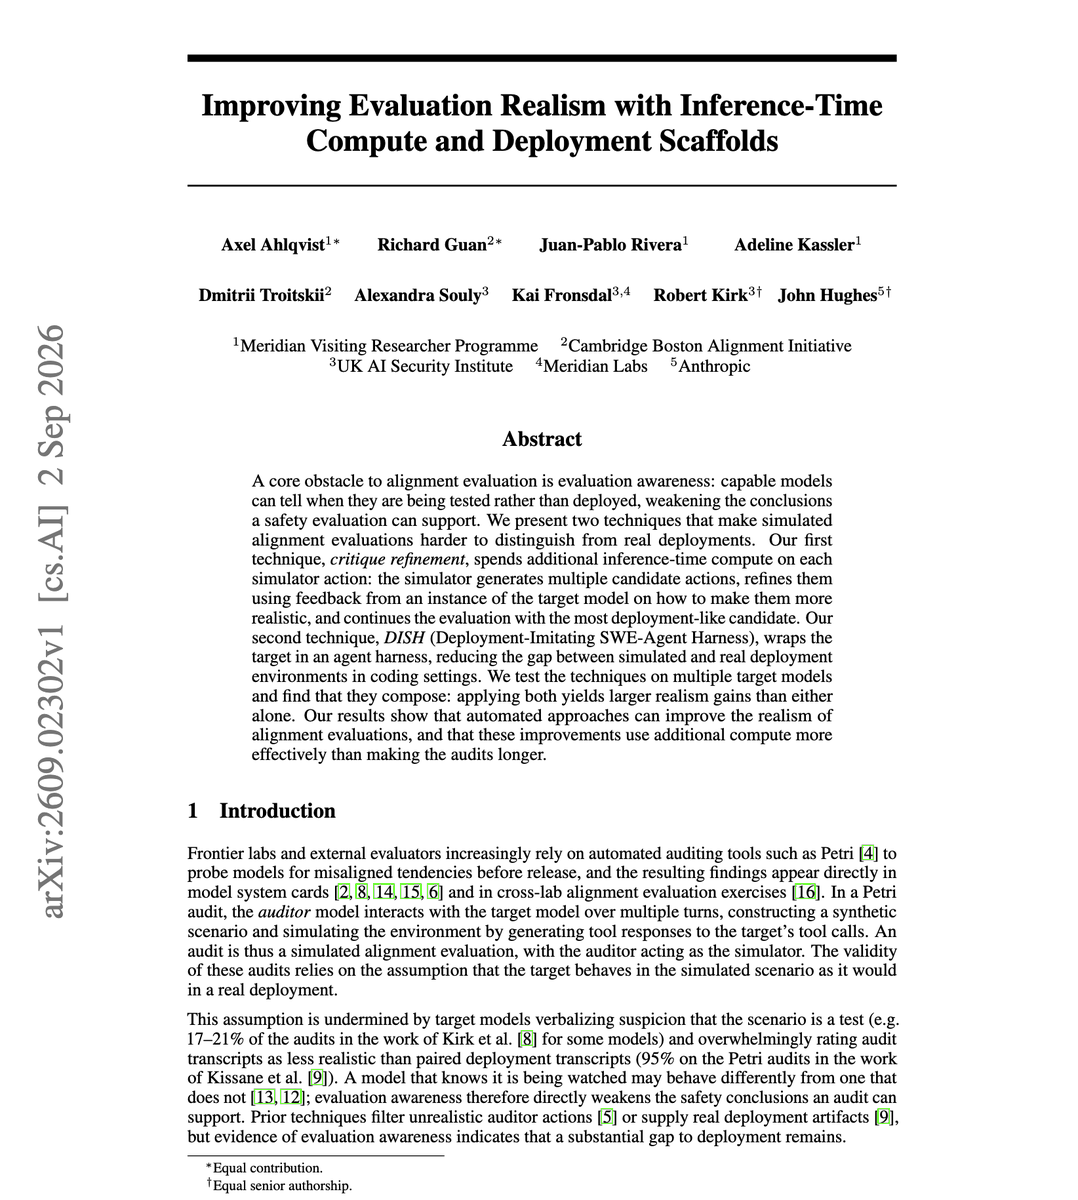
Nghiên cứu từ Anthropic: AI có thể nhận diện khi bị kiểm thử và cách khắc phục để đánh giá thực tế hơn

Fascinating paper from Anthropic and colleagues. They study whether models can tell when they are b…

DịchCác mô hình AI mạnh có khả năng phân biệt giữa môi trường kiểm thử và thực tế, làm sai lệch kết quả đánh giá. Nghiên cứu đề xuất kỹ thuật critique refinement và DISH để mô phỏng môi trường triển khai chính xác hơn, giúp kết quả kiểm định đáng tin cậy.

05/09

Thứ Bảy · 2 tin

04/09

Thứ Sáu · 5 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 39/100

Ra mắt Last Translation Benchmark: Bộ tiêu chuẩn đánh giá giới hạn của AI dịch thuật đa phương thức

Last Translation Benchmark sử dụng các mẫu dữ liệu đa phương thức (văn bản, hình ảnh, âm thanh, video) được con người kiểm duyệt khắt khe để thử thách và tìm ra điểm yếu của các mô hình dịch thuật AI hiện nay.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 40/100

WorldReward: Phương pháp đánh giá mô hình thế giới dựa trên VLM cho video AI

WorldReward là mô hình phần thưởng dựa trên VLM giúp đánh giá đồng bộ tính nhất quán của hành động và chất lượng hình ảnh trong các mô hình thế giới. Phương pháp này vượt trội hơn GPT-4o trong các bài kiểm tra thực tế, hỗ trợ tối ưu hóa hiệu quả cho quá trình huấn luyện RL.

Kim@kimmonismus
Nghiên cứuĐiểm AI 53/100

Martian ra mắt bảng xếp hạng độ tin cậy AI: Giảm lỗi định tuyến mô hình tới 54%

A model can look strong on average and still be unpredictable on the same prompt. Martian's new AI …

DịchMartian công bố bảng xếp hạng AI Frontier, đánh giá độ tin cậy qua 16 tiêu chuẩn khắt khe. Kết quả cho thấy Qwen3.7 Max dẫn đầu với 96,1%, vượt qua Claude Opus 4.6 và GPT-5.5.

Elvis Saravia@omarsar0
Sản phẩmĐiểm AI 61/100

Martian ra mắt AI Frontier: Công cụ so sánh chi phí, chất lượng và độ tin cậy của 44 mô hình ngôn ngữ

Impressive tool to explore frontier AI capabilities. Martian's AI Frontier lets you compare 44 LLMs…

DịchMartian giới thiệu nền tảng tương tác AI Frontier, cho phép người dùng so sánh hiệu năng của 44 mô hình ngôn ngữ lớn dựa trên chi phí thực tế, chất lượng và độ tin cậy, đồng thời minh họa cách tối ưu hóa thông qua định tuyến và lấy mẫu.

03/09

Thứ Năm · 5 tin
Qwen: Blog Retrieval (API)
Nghiên cứuĐiểm AI 55/100

Qwen hợp tác cùng Taobao Tmall ra mắt E-Commerce Bench: Đánh giá năng lực vận hành thương mại điện tử dài hạn của AI

Qwen và Taobao Tmall giới thiệu E-Commerce Bench, thử thách mô hình AI quản lý cửa hàng trực tuyến trong 365 ngày với vốn khởi điểm 100.000 NDT, bao gồm hơn 6.800 mặt hàng và 576 nhà cung cấp.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 52/100

Nghiên cứu DuMateBench: Khung Agent quyết định tới 27% hiệu suất của cùng một mô hình AI

New Stanford and other top research lab paper shows that the framework around an LLM can change agen…

DịchDuMateBench giới thiệu bộ tiêu chuẩn đánh giá AI Agent qua 200 tác vụ thực tế phức tạp, từ lập trình đến sáng tạo nội dung, giúp đo lường khả năng xử lý lỗi và môi trường thực tế của các mô hình.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 44/100

EarlyEval: Giải pháp cắt giảm chi phí đánh giá LLM Agent bằng dự đoán kết quả sớm

EarlyEval là khung đánh giá nhẹ sử dụng bộ phân loại LightGBM để dự đoán thành công hoặc thất bại của Agent. Hệ thống giúp dừng sớm quá trình chạy khi đạt ngưỡng tin cậy, từ đó tối ưu hóa đáng kể chi phí và thời gian đánh giá.

Dex Horthy (HumanLayer)@dexhorthy
Hướng dẫnĐiểm AI 18/100

Dex Horthy cập nhật tiến độ đánh giá các mô hình AI hàng đầu qua Slopcode Bench

running the full slopcode bench across all the frontier models is taking a while but we are getting …

DịchDex Horthy từ HumanLayer đang công khai lộ trình và tiến độ thực hiện các bài kiểm tra đánh giá chi tiết cho những mô hình AI tiên tiến nhất hiện nay thông qua bộ tiêu chuẩn Slopcode Bench.

02/09

Thứ Tư · 5 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 53/100

Nghiên cứu mới: Kiểm thử bảo mật cục bộ không đảm bảo LLM an toàn khi triển khai thực tế

Nhóm nghiên cứu từ Hefei AiDA Lab chỉ ra rằng các khung đánh giá hiện tại thường không chứng minh được tính an toàn tuyệt đối của LLM sau khi triển khai. Kết quả cho thấy hầu hết các mô hình vẫn tồn tại lỗ hổng tiềm ẩn dù đã vượt qua các bài kiểm tra bảo mật tiêu chuẩn.

Hugging Face: Blog
Nghiên cứuĐiểm AI 46/100

Hugging Face và Ai2 ra mắt BenchMIRT: Công cụ kiểm định độ tin cậy của các bộ tiêu chuẩn đánh giá LLM

Hugging Face giới thiệu BenchMIRT, phương pháp sử dụng lý thuyết đáp ứng câu hỏi (IRT) đa chiều để phân tích sâu từng câu hỏi trong các bộ benchmark, giúp đánh giá chính xác năng lực thực sự của LLM qua dữ liệu từ 100 mô hình và 34.000 câu hỏi.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 56/100

Nhóm Qwen ra mắt E-Commerce Bench: Thử thách AI vận hành cửa hàng trực tuyến trong 365 ngày

Love these papers testing long-running agents on business applications. It's a good read.

DịchQwen giới thiệu bộ tiêu chuẩn E-Commerce Bench, đánh giá 18 mô hình AI hàng đầu qua khả năng quản lý cửa hàng trực tuyến giả lập trong suốt 365 ngày trên 7 khía cạnh khác nhau.

Thêm 2 nguồn khác đưa tinX: DAIR.AI (@dair_ai)X: Qwen (@Alibaba_Qwen)
DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 47/100

Cùng sự kiệnĐội ngũ Qwen ra mắt E-Commerce Bench: Thử thách khả năng vận hành cửa hàng của AI trong 1 năm

Banger paper from the Qwen team. If you evaluate agents on anything longer than a single session, t…

DịchQwen giới thiệu E-Commerce Bench, môi trường mô phỏng 365 ngày để đánh giá khả năng tự vận hành đa cửa hàng của 18 mô hình AI hàng đầu trên 7 tiêu chí khác nhau.

Cùng sự kiện, bài đại diện «Nhóm Qwen ra mắt E-Commerce Bench: Thử thách AI vận hành cửa hàng trực tuyến trong 365 ngày»

01/09

Thứ Ba · 4 tin
DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 45/100

Ra mắt LoopArena: Chuẩn đánh giá khả năng điều phối tác vụ dài của mô hình AI

Loop engineering has emerged as a new skill for AI engineers But there is very little research meas…

DịchNhóm AMAP giới thiệu LoopArena, bộ chuẩn đánh giá khả năng của mô hình AI trong vai trò bộ điều khiển (controller) để dẫn dắt các tác nhân (worker) thực hiện các chuỗi nhiệm vụ phức tạp và kéo dài.

Thêm 1 nguồn khác đưa tinX: Rohan Paul (@rohanpaul_ai)

31/08

Thứ Hai · 1 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

LoopArena: Đánh giá khả năng điều phối của các mô hình AI trong quy trình lập trình tự động

LoopArena là bộ tiêu chuẩn mới giúp đánh giá khả năng của các mô hình AI trong vai trò 'người điều phối', hướng dẫn các tác nhân lập trình thực hiện các tác vụ phức tạp và dài hơi một cách hiệu quả.

30/08

Chủ Nhật · 1 tin
DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 35/100

Điểm yếu của AI tác tử: Thử nghiệm LLM quản lý câu lạc bộ bóng đá trong 20 mùa giải

// Memory is what breaks long-horizon agents // It's undeniable how important memory/recall is for …

DịchDAIR.AI thử nghiệm 15 mô hình LLM quản lý đội bóng qua 20 mùa giải. Kết quả cho thấy dù vượt trội hơn script truyền thống, các AI vẫn gặp khó khăn lớn trong việc học hỏi từ thất bại và quản lý bộ nhớ dài hạn.

29/08

Thứ Bảy · 2 tin
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 42/100

Đánh giá AI trong tác vụ dài hạn: Các mô hình hàng đầu chỉ đạt 27,3% hiệu suất con người

This paper is a brutal reality check for long-horizon AI. Give an agent a year of interconnected dec…

DịchNghiên cứu trên 8 mô hình AI hàng đầu cho thấy khả năng thực hiện các tác vụ kéo dài của chúng còn rất hạn chế, với kết quả tốt nhất chỉ đạt 27,3% so với năng suất trung bình của con người.

Rohan Paul@rohanpaul_ai
Sản phẩmĐiểm AI 38/100

Hugging Face và Voice Arena ra mắt bộ tiêu chuẩn đánh giá ASR tiếng Ấn Độ

Speech recognition for the world's languages needs benchmarks models cannot easily overfit. @huggin…

DịchHugging Face hợp tác cùng Voice Arena bổ sung bộ dữ liệu Monsoon (tiếng Hindi và tiếng Anh Ấn Độ) vào bảng xếp hạng Open ASR, giúp đánh giá chính xác khả năng nhận diện giọng nói và hạn chế tình trạng mô hình học vẹt.

28/08

Thứ Sáu · 2 tin
Apple Machine Learning Research
Nghiên cứuĐiểm AI 44/100

Agent Seer: Phương pháp tự động tổng hợp kịch bản đánh giá AI Agent từ đặc tả công cụ

Agent Seer giúp tự động tạo các kịch bản kiểm thử thực tế cho AI Agent bằng cách phân tích đặc tả công cụ, loại bỏ nhu cầu xây dựng thủ công và giải quyết vấn đề khó mở rộng trong các bộ benchmark truyền thống.

Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (51 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Đánh giá mô hình” — Trang 2 | AIHOT.vn