iFLYTEK mở mã nguồn mô hình AI chạy trên thiết bị với cửa sổ ngữ cảnh lên tới 1 triệu token
iFLYTEK vừa ra mắt và mở mã nguồn Spark X2.5-4B và X2.5-1.7B, những mô hình AI chạy tại chỗ đầu tiên hỗ trợ cửa sổ ngữ cảnh lên đến 1 triệu token.
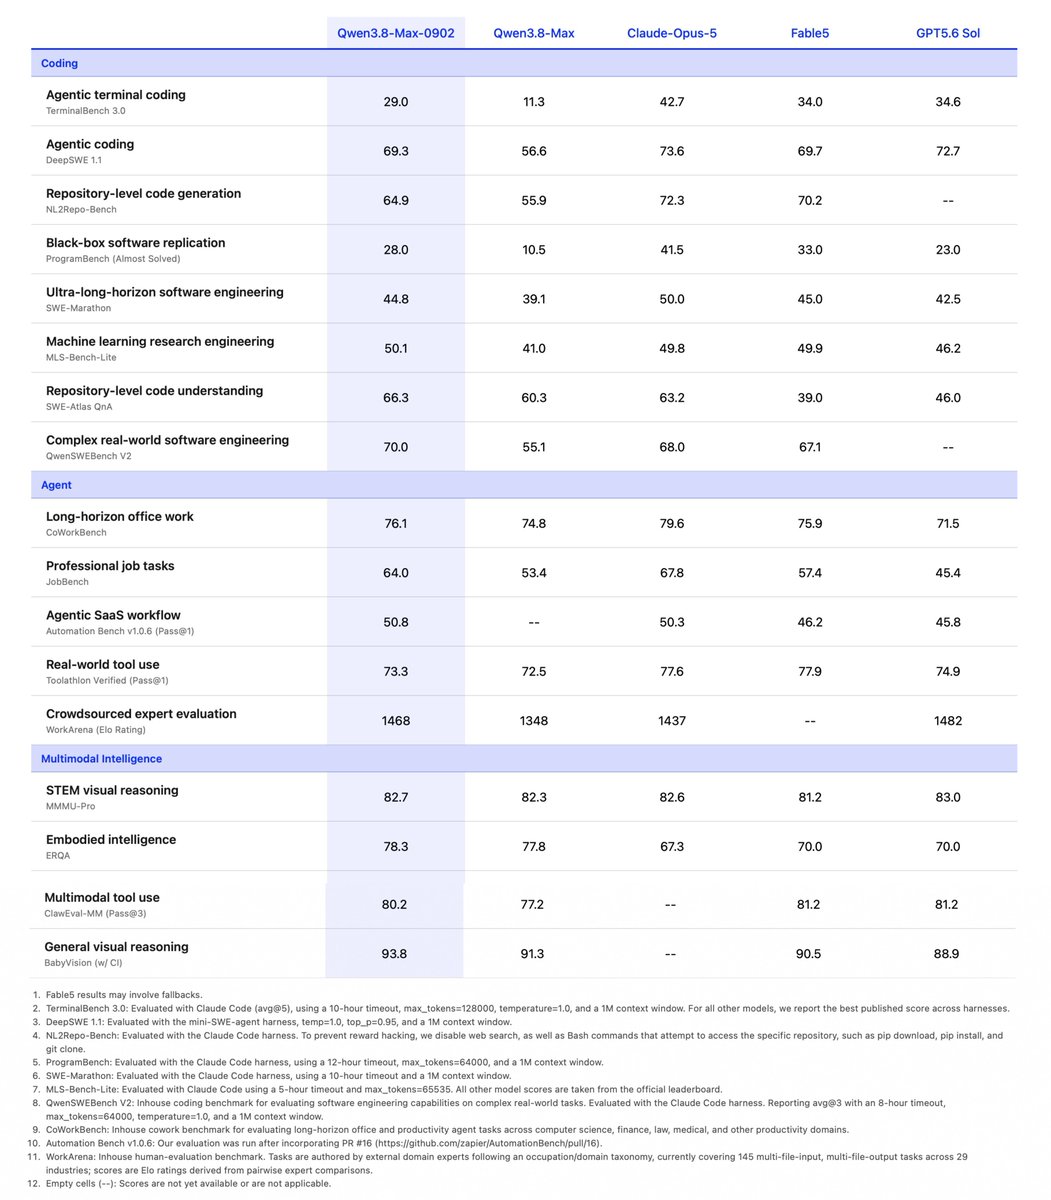
Kim@kimmonismuswtf Qwen 3.8 has been updated to version 0902 and is now almost at the same level as Fable 5 in benc…
DịchAlibaba vừa nâng cấp Qwen3.8-Max với phiên bản 0902, sở hữu 2.4 nghìn tỷ tham số và hỗ trợ 1 triệu token ngữ cảnh. Mô hình được tối ưu hóa cho lập trình và làm việc nhóm, hiện đã có mặt trên QwenCloud với mức giá cạnh tranh.

Bài viết phân tích khung 'Biên hiệu quả' của LLM, chia các kỹ thuật tối ưu thành hai nhóm: cân bằng giữa độ trễ và thông lượng, hoặc đẩy xa giới hạn hiệu suất để đạt hiệu quả tổng thể cao hơn.
Bảng xếp hạng Arena tuần 35 ghi nhận sự bứt phá của GLM-5.3-Flash trong lĩnh vực lập trình và Qwen3.8-Max-0902 vượt mặt Claude-Opus-5-Max để dẫn đầu bảng xếp hạng phát triển Frontend.
Alibaba vừa ra mắt phiên bản Qwen3.8-Max-0902, tập trung tối ưu hóa khả năng lập trình và làm việc nhóm. Mô hình này đã vươn lên dẫn đầu bảng xếp hạng CodeArena với số điểm ấn tượng 1.691.
Cùng sự kiện, tinh chọn hiển thị «Qwen3.8-Max-0902 soán ngôi đầu Code Arena với mức giá cạnh tranh 5 USD/triệu token»Elon Musk thông báo Grok 4.7 sẽ ra mắt vào ngày 12/9 với 2,1 nghìn tỷ tham số. Dù tốc độ phản hồi có thể chậm hơn đôi chút, mô hình này được kỳ vọng sẽ thiết lập tiêu chuẩn mới về hiệu suất và khả năng xử lý token.
Thêm 2 nguồn khác đưa tinX: Elon Musk (@elonmusk, xAI)X: Kim (@kimmonismus)Simon Willison vừa phát hành phiên bản ổn định đầu tiên của datasette-mcp. Bản cập nhật này chuyển đổi định dạng trả về của execute_sql sang mảng đối tượng, giúp các mô hình AI hạn chế sai sót khi ánh xạ cột dữ liệu.
Hướng dẫn chi tiết cách chạy các mô hình LLM cục bộ trên Mac mini M4 Pro 48GB RAM, kết hợp dịch vụ oMLX và Tailscale để đồng bộ hóa trải nghiệm AI trên nhiều thiết bị Apple.
Yuchen Jin@Yuchenj_UWGLM-5.3 at 310 tok/s! Databricks inference is #1 in both speed and latency, again. On our internal…
DịchTheo đánh giá từ Yuchen Jin, GLM-5.3 trên nền tảng Databricks đạt tốc độ 310 tok/s với độ trễ cực thấp, vượt trội so với các đối thủ. Mô hình này cũng được đánh giá là mã nguồn mở mạnh nhất về khả năng lập trình, cạnh tranh trực tiếp với Fable 5 và Opus 4.8.

Alibaba vừa cập nhật phiên bản Qwen3.8-Max-0902 với khả năng lập trình và xử lý văn phòng vượt trội, xuất sắc giành vị trí quán quân trên bảng xếp hạng CodeArena với 1691 điểm.
Cùng sự kiện, tinh chọn hiển thị «Qwen3.8-Max-0902 soán ngôi đầu Code Arena với mức giá cạnh tranh 5 USD/triệu token»Harness-of-Harness (HoH) là khung làm việc mới cho phép các AI lập trình tự động hóa quy trình phát triển phần mềm dài hạn mà không cần con người can thiệp, thông qua cơ chế lặp lại chu trình lập kế hoạch, viết mã và kiểm thử.
Thêm 2 nguồn khác đưa tinX: DAIR.AI (@dair_ai)X: Elvis Saravia (@omarsar0, DAIR.AI)DiagEvo giúp mô hình AI tự học bằng cách lưu trữ các lỗi sai vào bộ nhớ phân tầng, từ đó tự tạo ra các bài tập thực hành phù hợp để khắc phục điểm yếu mà không cần dữ liệu bên ngoài.
Alibaba Cloud@alibaba_cloud🚀Qwen3.8-Max just got upgraded. Meet Qwen3.8-Max-0902! 2.4T parameters. 1M context tokens. Built f…
DịchPhiên bản Qwen3.8-Max-0902 được tối ưu hóa mạnh mẽ cho lập trình và cộng tác, hỗ trợ cửa sổ ngữ cảnh 1 triệu token, giúp xử lý hiệu quả các tác vụ doanh nghiệp phức tạp và quy trình làm việc dài hạn.

E-Commerce Bench là bộ tiêu chuẩn đầu tiên đánh giá khả năng của AI trong việc quản lý cửa hàng trực tuyến suốt một năm, từ đàm phán, quản lý kho đến tối ưu hóa lợi nhuận trong môi trường biến động.
Nghiên cứu giới thiệu cách tách biệt giao thức điều khiển khỏi nội dung dữ liệu trong hệ thống đa tác nhân, giúp đảm bảo tính ổn định của quy trình làm việc mà vẫn tối ưu hóa hiệu quả thực thi nhiệm vụ.
StudentSim sử dụng kỹ thuật huấn luyện gộp và chuyên biệt hóa để tạo ra các mô hình mô phỏng học sinh có khả năng phản hồi và học tập dưới sự hướng dẫn. Hệ thống đi kèm bộ tiêu chuẩn đánh giá StudentSimEval trên 60 học sinh ở các lĩnh vực toán học, ngoại ngữ và cờ vua.
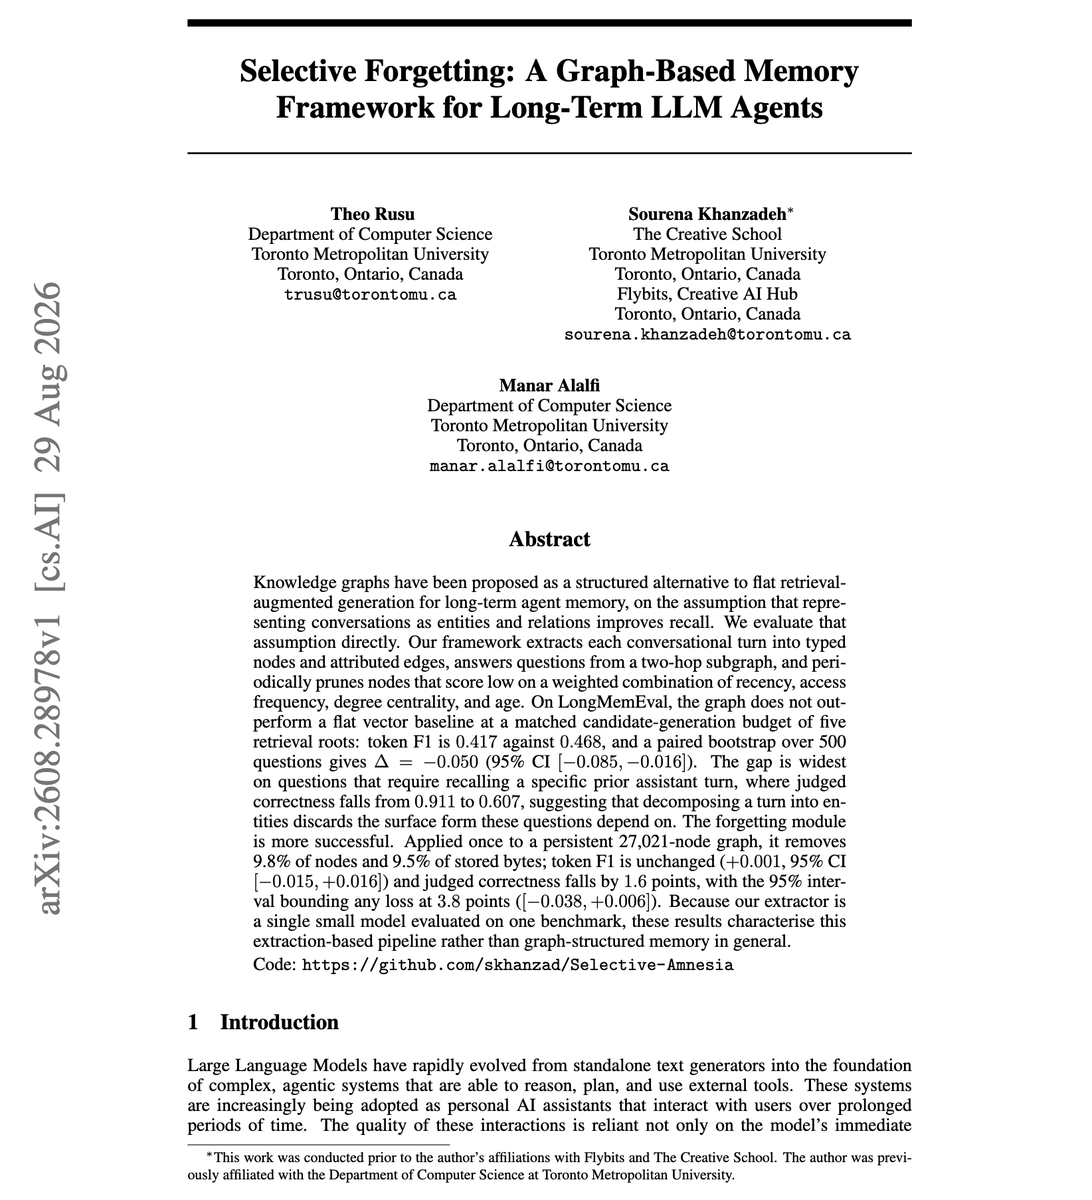
Elvis Saravia@omarsar0Finally, a good paper testing if graph memory actually beats flat retrieval for long-term agents. (…
DịchNghiên cứu mới đề xuất phương pháp chuyển đổi hội thoại thành đồ thị với các nút và cạnh thuộc tính, giúp tác nhân AI truy xuất thông tin chính xác hơn thông qua các truy vấn đồ thị hai bước.

Qwen@Alibaba_Qwen🚀Qwen3.8-Max just got upgraded. Meet Qwen3.8-Max-0902! 2.4T parameters. 1M context tokens. Built f…
DịchAlibaba nâng cấp Qwen3.8-Max lên phiên bản 0902, tối ưu hóa khả năng lập trình và cộng tác cho các tác vụ doanh nghiệp phức tạp, nghiên cứu khoa học và quy trình làm việc dài hạn.

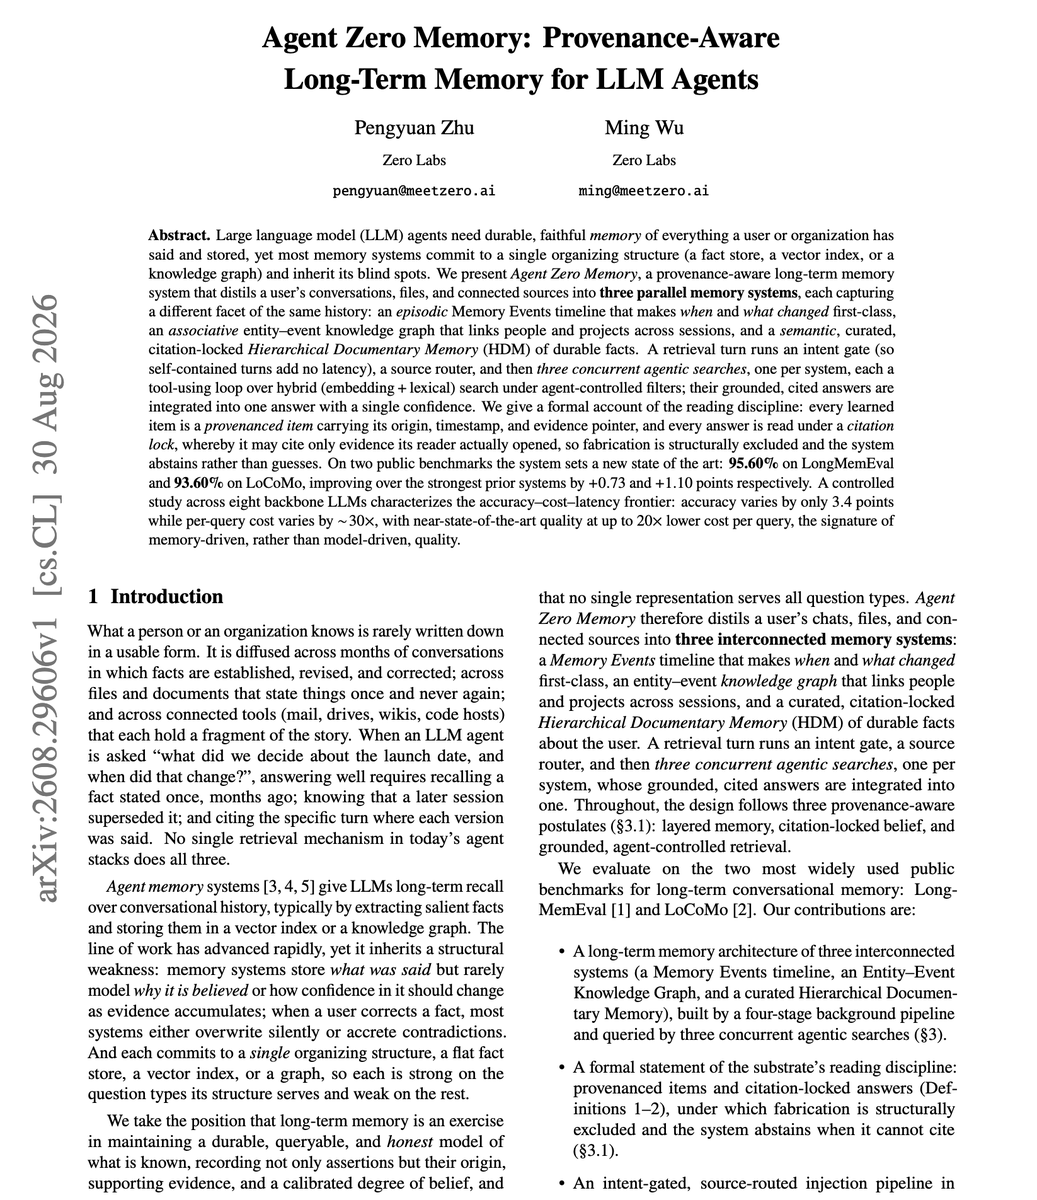
DAIR.AI@dair_ai// Agent Zero Memory // This work separates three things that agent memory systems usually collapse…
DịchAgent Zero Memory giới thiệu kiến trúc ghi nhớ dài hạn dựa trên truy xuất nguồn gốc, kết hợp đồng thời dòng thời gian sự kiện, đồ thị tri thức và tài liệu để tối ưu hóa khả năng truy hồi thông tin của AI Agent.

Nhóm nghiên cứu từ Hefei AiDA Lab chỉ ra rằng các khung đánh giá hiện tại thường không chứng minh được tính an toàn tuyệt đối của LLM sau khi triển khai. Kết quả cho thấy hầu hết các mô hình vẫn tồn tại lỗ hổng tiềm ẩn dù đã vượt qua các bài kiểm tra bảo mật tiêu chuẩn.
Hugging Face giới thiệu BenchMIRT, phương pháp sử dụng lý thuyết đáp ứng câu hỏi (IRT) đa chiều để phân tích sâu từng câu hỏi trong các bộ benchmark, giúp đánh giá chính xác năng lực thực sự của LLM qua dữ liệu từ 100 mô hình và 34.000 câu hỏi.
Anthropic giới thiệu bộ đôi Claude 5.1 với hiệu năng vượt trội và chi phí tối ưu. Trong đó, Fable 5.1 được phát hành rộng rãi, còn Mythos 5.1 giới hạn cho các tổ chức được kiểm duyệt tại Mỹ thuộc dự án Project Glasswing.
Cùng sự kiện, tinh chọn hiển thị «Anthropic ra mắt bộ đôi Claude Fable 5.1 và Claude Mythos 5.1»
Elvis Saravia@omarsar0Love these papers testing long-running agents on business applications. It's a good read.
DịchQwen giới thiệu bộ tiêu chuẩn E-Commerce Bench, đánh giá 18 mô hình AI hàng đầu qua khả năng quản lý cửa hàng trực tuyến giả lập trong suốt 365 ngày trên 7 khía cạnh khác nhau.
Thêm 2 nguồn khác đưa tinX: DAIR.AI (@dair_ai)X: Qwen (@Alibaba_Qwen)
DAIR.AI@dair_aiBanger paper from the Qwen team. If you evaluate agents on anything longer than a single session, t…
DịchQwen giới thiệu E-Commerce Bench, môi trường mô phỏng 365 ngày để đánh giá khả năng tự vận hành đa cửa hàng của 18 mô hình AI hàng đầu trên 7 tiêu chí khác nhau.

Bài viết từ Every đánh giá phiên bản Fable 5.1 mới nhất của Anthropic, đặt ra câu hỏi liệu đây có phải là bước ngoặt đưa Anthropic trở lại vị thế dẫn đầu hay không.
Rohan Paul@rohanpaul_aiCache reads with Fable 5.1 cost 75% less than Fable 5's So the savings get larger as the workload b…
DịchRohan Paul phân tích việc Anthropic ra mắt Claude Fable 5.1 và Mythos 5.1, nhấn mạnh rằng mức giảm 75% chi phí đọc bộ nhớ đệm của Fable 5.1 là chìa khóa giúp cắt giảm đáng kể tổng chi phí cho các tác vụ AI Agent.

OpenRouter@OpenRouterOpenRouter now runs inside @render Workflows. Stop putting LLM batches in your web service. Each pr…
DịchOpenRouter hiện đã hỗ trợ Render Workflows, cho phép tách biệt các tác vụ LLM thành những tiến trình riêng biệt. Điều này giúp hệ thống tự động quản lý hàng đợi, thử lại và phân phối tác vụ hiệu quả hơn thay vì xử lý trực tiếp trên Web Service.
CoVA-SFT là bộ dữ liệu gồm 51,9 nghìn mẫu, giúp mô hình AI xây dựng không gian làm việc hình ảnh nội tại để giải quyết các bài toán suy luận phức tạp thay vì chỉ dựa vào văn bản thuần túy.
Rohan Paul@rohanpaul_aiNot Diamond just released the methodology behind their model routing which gets Opus xhigh quality w…
DịchNot Diamond giới thiệu phương pháp định tuyến mô hình mới, giúp đạt hiệu suất vượt trội so với Claude 3 Opus nhưng tiết kiệm từ 20-80% chi phí vận hành trên các tiêu chuẩn đánh giá chính.

Bài viết giải quyết bài toán nan giải khi chạy các mô hình 70B tham số trên phần cứng tiêu dùng, hướng dẫn kỹ thuật tối ưu hóa dung lượng mà vẫn giữ vững hiệu năng xử lý.
OpenRouter@OpenRouter1/ The fastest reasoning LLM is now live exclusively on OpenRouter. Mercury 2.5 Preview from @_ince…
DịchMercury 2.5 Preview vừa cập bến OpenRouter với khả năng tạo token song song, đạt tốc độ kỷ lục 1.107 token/giây, tối ưu hóa cho các tác vụ yêu cầu độ trễ cực thấp và xử lý JSON chính xác.
Luo Yonghao cho rằng các hãng xe điện đang cố chấp tự phát triển mô hình AI kém chất lượng thay vì tích hợp các LLM hàng đầu như Kimi hay Doubao, gây ảnh hưởng đến trải nghiệm người dùng.
Xiaobei@frxiaobeiTác giả cho rằng các bản hướng dẫn (AGENTS.md) nên có tính di động giữa các mô hình AI khác nhau. Việc phải duy trì nhiều bộ quy tắc riêng biệt cho từng model là lãng phí, thay vào đó cần chuẩn hóa hạ tầng để tối ưu hóa hiệu suất làm việc của Agent.
Ant Group vừa phát hành SingProbe trên Hugging Face, một mô hình giám sát an toàn chỉ với 3,22 triệu tham số. Công cụ này giúp phát hiện rủi ro về ý định, nội dung độc hại và ảo tưởng của AI theo thời gian thực với chi phí vận hành cực thấp.
Cùng sự kiện, bài đại diện «Ant Group ra mắt Ling-3.0-flash-singprobe: Công cụ giám sát an toàn AI siêu nhẹ»Ant Group vừa phát hành Ling-3.0-flash-singprobe, một bộ lọc an toàn dạng luồng giúp phát hiện ý định xấu, nội dung độc hại và ảo tưởng của AI với chi phí vận hành cực thấp (dưới 0,5%).
Nghiên cứu từ StartLux và các đại học danh tiếng đã khám phá cách các lớp Full Attention ảnh hưởng đến mô hình lai, xác định hai trạng thái kích hoạt đặc trưng là 'đỉnh trước chú ý' và 'nền giữa các đỉnh', giúp tối ưu hóa hiệu năng cho các kiến trúc LLM thế hệ mới.
Nghiên cứu giới thiệu FACE-Eval để kiểm tra khả năng suy luận trung thực của 15 mô hình AI. Kết quả cho thấy các mô hình dễ bị ảnh hưởng bởi dữ liệu từ công cụ hơn là tin nhắn người dùng, dù chúng không luôn thừa nhận điều đó trong chuỗi suy luận.
EvoGenUI-Bench là bộ tiêu chuẩn mới giúp đánh giá khả năng duy trì và cập nhật giao diện web tương tác của LLM qua nhiều lượt hội thoại, tập trung vào tính thực thi và độ ổn định của mã nguồn.
Tencent Hunyuan@TencentHunyuanOne more thing about Hy4 preview that is particularly interesting. In AI research. Hy4 preview found…
DịchTencent giới thiệu Hunyuan Hy4 Preview với 770B tham số và cửa sổ ngữ cảnh 1M. Điểm nhấn là khả năng tự phát hiện nút thắt suy luận, giúp tăng 31,8% lưu lượng xử lý thực tế, hướng tới tối ưu chi phí cho doanh nghiệp.

Chat-Edit-3D++ giới thiệu mạng Hash-Atlas giúp tách biệt quy trình chỉnh sửa 2D và tái tạo 3D, cho phép người dùng chỉnh sửa cảnh 3D và 4D linh hoạt thông qua hội thoại tự nhiên.