Emad Mostaque@EMostaqueTranh cãi về '10.000 con vẹt ngẫu nhiên' trong AI
10, 000 stochastic parrots eh
DịchEmad Mostaque đặt câu hỏi hoài nghi về khái niệm 'vẹt ngẫu nhiên' (stochastic parrots) trong bối cảnh phát triển AI hiện nay.

Emad Mostaque@EMostaque10, 000 stochastic parrots eh
DịchEmad Mostaque đặt câu hỏi hoài nghi về khái niệm 'vẹt ngẫu nhiên' (stochastic parrots) trong bối cảnh phát triển AI hiện nay.

Cohere@cohereIntroducing the next evolution in LLM text generation: the first fully-fledged serving system built …
DịchCohere vừa giới thiệu hệ thống phục vụ tạo văn bản LLM dựa trên kiến trúc decode megakernel, mang lại hiệu suất vượt trội so với vLLM và được phát hành hoàn toàn dưới dạng mã nguồn mở.
OpenRouter@OpenRouterMercury 2.5 from @_inception_ai is now generally available on OpenRouter. It's the fastest model on…
DịchMercury 2.5, mô hình ngôn ngữ sử dụng cơ chế khuếch tán để giải mã token song song, hiện đã khả dụng trên OpenRouter. Đây là mô hình nhanh nhất trên nền tảng này mà không yêu cầu phần cứng chuyên dụng, đặc biệt tối ưu cho các tác vụ lập trình.
Bài viết thử nghiệm hiệu năng của các phiên bản nén GGUF (Unsloth) trên mô hình Qwen3.8 27B qua các bộ benchmark GPQA Diamond, IFBench và Terminal-Bench 2.1.
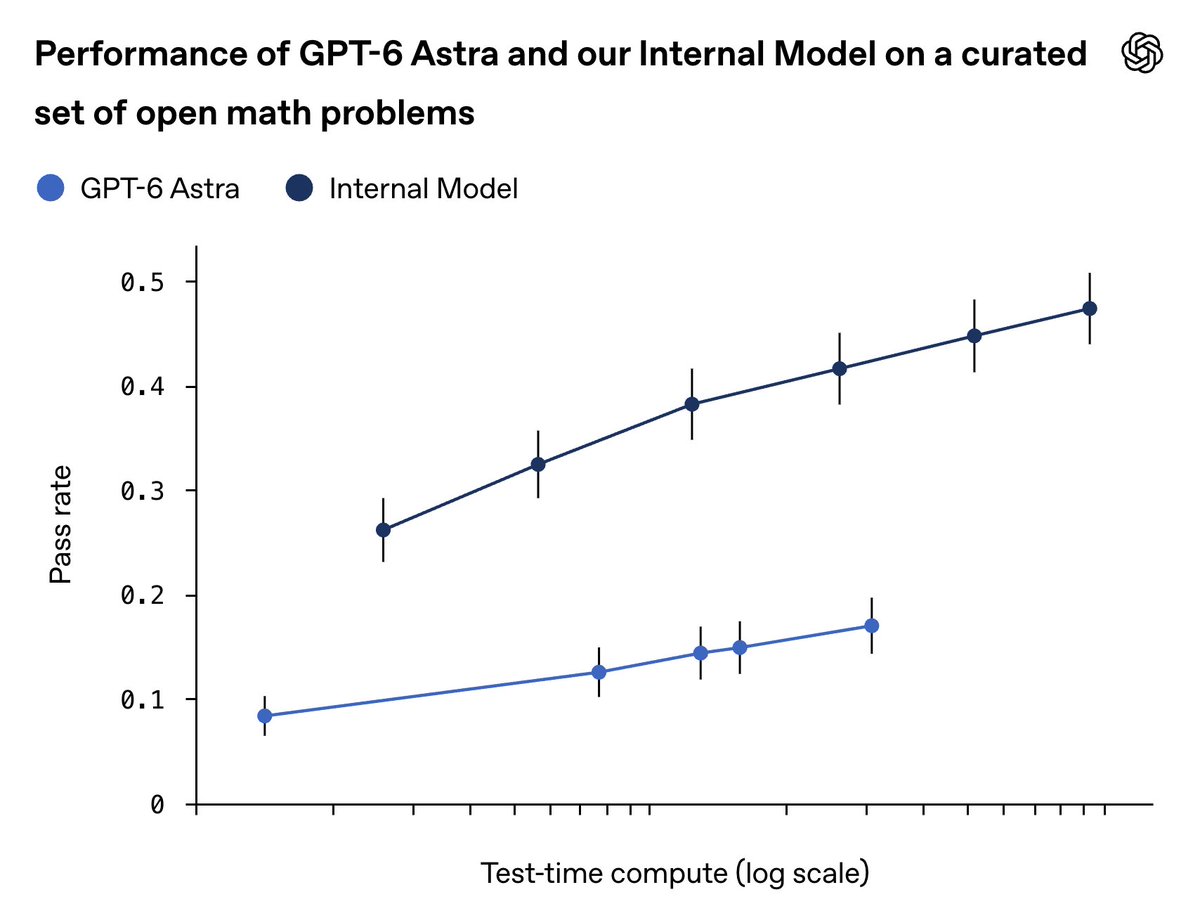
Noam Brown@polynoamialI understand how, looking at today's LLMs, people might think the only way we'd achieve NS is by usi…
DịchNoam Brown khẳng định kết quả Navier-Stokes không phụ thuộc vào gợi ý từ bên ngoài và chia sẻ dữ liệu cho thấy các mô hình nội bộ của OpenAI có tỷ lệ giải toán vượt trội so với các LLM công khai hiện nay.

DeepSeek vừa bất ngờ tung ra phiên bản thử nghiệm V4.1 Flash với cấu trúc mô hình mới, hứa hẹn hiệu suất vượt trội và tốc độ phản hồi cực nhanh, đạt tới 400 token/giây.
Thêm 3 nguồn khác đưa tinTechNodePandailyX: Kim (@kimmonismus)
Rohan Paul@rohanpaul_aiUno shows a simple way to speed up existing LLMs without changing their output distribution: keep th…
DịchUno tối ưu hóa suy luận LLM bằng cách sử dụng mô hình khuếch tán để dự đoán song song nhiều token mà không làm thay đổi chất lượng đầu ra. Phương pháp này giúp tăng thông lượng lên tới 2,5 lần và đẩy nhanh quá trình huấn luyện RL tới 40% trên mô hình Qwen3-8B.

DAIR.AI@dair_aiFinally a good paper testing whether an LLM's mathematical knowledge has coherent structure or just …
DịchNghiên cứu sử dụng lý thuyết không gian tri thức cho thấy các mô hình LLM thường vi phạm sự phụ thuộc logic trong toán học, dù vẫn đạt độ chính xác cao. Các mô hình khác nhau có sự chồng chéo tri thức thấp, cho thấy lỗ hổng trong cách đánh giá năng lực AI hiện nay.

Nghiên cứu giới thiệu khung Conformal Relevance giúp tối ưu hóa độ chính xác và sự cô đọng của văn bản thông qua việc kết hợp các ví dụ học trong ngữ cảnh, giảm thiểu đáng kể công sức thiết kế prompt thủ công.
TradingAgents mô phỏng quy trình làm việc của các công ty tài chính chuyên nghiệp thông qua hệ thống đa tác nhân LLM. Bản cập nhật v0.4.0 đã khắc phục lỗi dữ liệu tương lai, đồng thời bổ sung hỗ trợ cho các mô hình GPT-5.6 và GLM-5.3.
DAIR.AI@dair_ai// Beneath the Surface of Chains-of-Thought // Impressive paper on whether reasoning steps have int…
DịchNghiên cứu mới chỉ ra rằng các bước suy luận của AI không chỉ là văn bản mà có cấu trúc hình học riêng biệt trong không gian ẩn. Các thao tác như phân tích mục tiêu hay suy diễn được sắp xếp có hệ thống, cho thấy AI xây dựng logic dựa trên ngữ cảnh thay vì chỉ dự đoán từ ngữ.

Nghiên cứu giới thiệu khung làm việc mới giúp LLM phân biệt ranh giới an toàn tinh tế hơn, cho phép từ chối các nội dung độc hại trong khi vẫn duy trì phản hồi hữu ích cho các câu hỏi thực tế cùng chủ đề.
Tmall vừa khai trương 'Trạm không gian AI', cho phép người dùng mua các gói đăng ký token và lập trình từ những nhà cung cấp LLM hàng đầu Trung Quốc dễ dàng như mua sắm trực tuyến thông thường.
Nghiên cứu giới thiệu phương pháp kết hợp mô hình khuếch tán vào LLM để tạo nhiều token song song, giúp tăng tốc độ suy luận mà không làm giảm độ chính xác so với cách dự đoán tuần tự truyền thống.
Nghiên cứu phân tích kỹ thuật tự chưng cất (OPSD) giúp mô hình tự học từ dữ liệu có sẵn mà không cần mô hình giáo viên lớn, đồng thời cảnh báo về rủi ro suy giảm khả năng suy luận do thiên kiến trong quá trình huấn luyện.
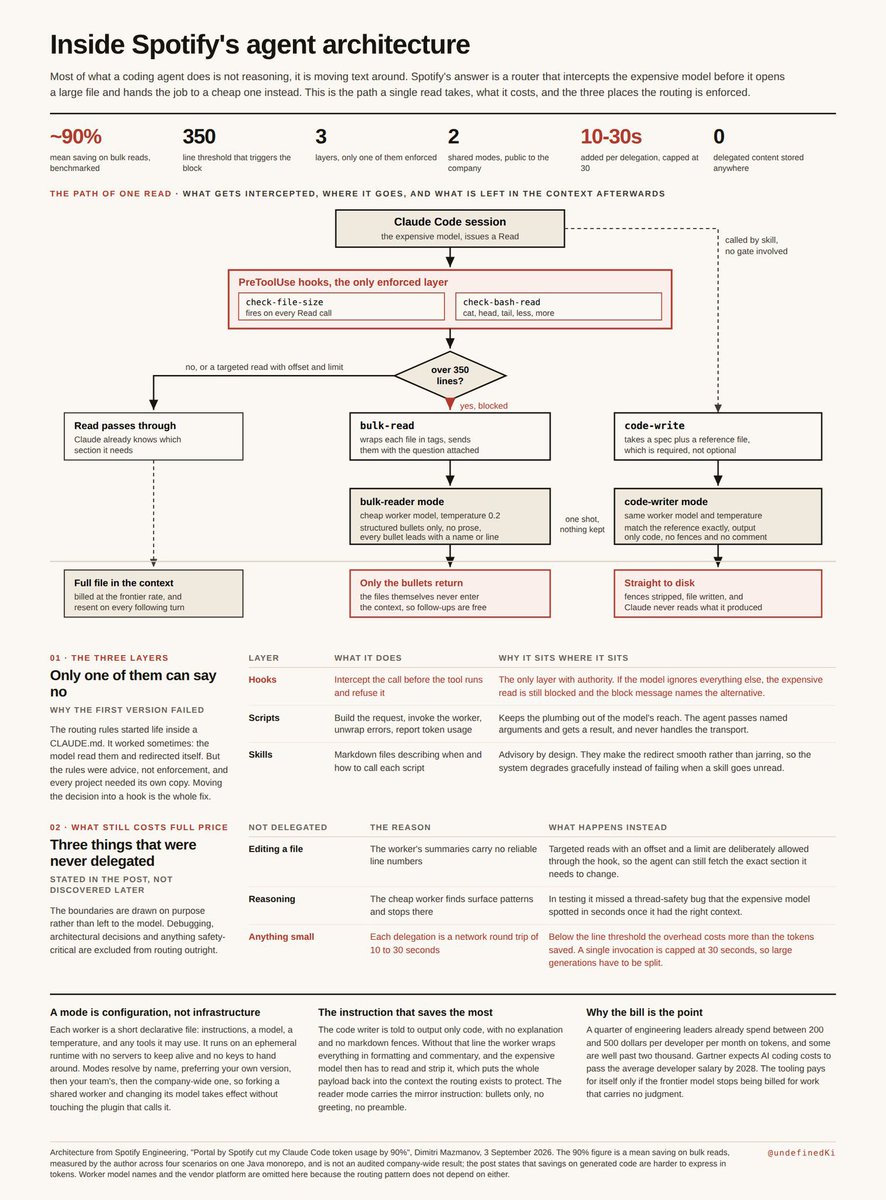
AI Notes@AYi_AInotesSpotify chia sẻ cách họ sử dụng Hook để chặn các tệp tin lớn trên 350 dòng và chuyển hướng xử lý sang các mô hình AI giá rẻ, giúp cắt giảm đáng kể chi phí token khi sử dụng Claude Code.

Rohan Paul@rohanpaul_aiFor hard long-context tasks, the paper suggests a simple fix: run the model again with its previous …
DịchPhương pháp mới sử dụng dấu vết suy luận làm trạng thái điều kiện, giúp mô hình tập trung vào các điểm trọng yếu trong ngữ cảnh dài, giải quyết triệt để tình trạng bỏ lỡ thông tin quan trọng. Kết quả thử nghiệm cho thấy hiệu suất vượt trội trong 26/27 bài kiểm tra.

Nghiên cứu này giải quyết thách thức khi LLM phải tự động cập nhật các phần phụ thuộc trong tài liệu khi người dùng yêu cầu chỉnh sửa cục bộ. Nhóm tác giả đề xuất bộ tiêu chuẩn đánh giá mới và các phương pháp tính toán tiết kiệm chi phí để cải thiện độ chính xác khi lan truyền thay đổi.
Rohan Paul@rohanpaul_aiA skill-enabled agent can look better overall while performing worse on the exact tasks where it ret…
DịchCác nhà nghiên cứu từ Đại học Soongsil chỉ ra rằng cách đánh giá AI Agent hiện nay thường bị sai lệch. Họ đề xuất phương pháp RAE để đo lường thực chất hiệu quả của việc truy xuất kỹ năng, giúp khắc phục các hạn chế trong các bài kiểm tra truyền thống.

Phương pháp TGOPD cải thiện quá trình chưng cất mô hình bằng cách kiểm tra độ tin cậy của giáo viên ở cấp độ prompt trước khi áp dụng giám sát, giúp tránh việc học theo các phản hồi sai lệch.
Phiên bản llm 0.35 vừa được phát hành, bổ sung khả năng kết nối trực tiếp với mô hình GPT-6 Astra mới nhất của OpenAI thông qua giao diện dòng lệnh.
Nghiên cứu từ Epoch AI cho thấy GPT-5.6 có độ trễ TTFT tăng theo đường cong bậc hai khi ngữ cảnh dài, trong khi dòng Claude 5 duy trì hiệu suất gần như tuyến tính.
Elvis Saravia@omarsar0A few days ago, Anthropic shared this brilliant prompt. I was surprised by how it significantly im…
DịchMột bộ prompt mới từ Anthropic đã cho thấy hiệu quả bất ngờ khi cải thiện đáng kể khả năng viết lách của cả Fable 5.1 và GPT-5.6, trở thành công thức tối ưu cho mọi tác vụ biên tập AI.

karminski@karminski3Sự giao thoa giữa mô hình ngôn ngữ và video đang thay đổi từ mô phỏng hình học (3D/logic) sang tạo sinh thống kê pixel, đánh dấu bước ngoặt trong cách AI mô phỏng thế giới thực.

DAIR.AI@dair_ai// From Language Models to World-Acting Systems // A critical review of agentic AI, and a framework…
DịchDAIR.AI đề xuất khung đánh giá mới cho AI Agent, chỉ ra rằng khả năng kết nối hành động đang phát triển mạnh hơn so với độ tin cậy và tính tự chủ. Báo cáo cũng cảnh báo về rủi ro chi phí và lỗi phối hợp trong các hệ thống đa tác tử.

Bài viết giới thiệu cách vLLM triển khai kỹ thuật giải mã suy đoán trên kiến trúc GPU AMD, giúp tăng tốc độ suy luận cho các mô hình ngôn ngữ lớn mà vẫn đảm bảo độ chính xác.
ModelBest OpenBMB@OpenBMBBig thanks to @sgl_project for the day-0 support! MiniCPM5-2B is ready to deploy with SGLang today.
DịchOpenBMB vừa giới thiệu MiniCPM5-2B với khả năng triển khai ngay lập tức qua SGLang. Trên card RTX 5090, mô hình đạt tốc độ giải mã ấn tượng hơn 250 tok/s, tối ưu hóa hiệu suất cho các tác vụ lập trình.
HarvestBench là bộ tiêu chuẩn mới đánh giá liệu các tác nhân AI có sẵn sàng trả phí để tránh gây hại cho động vật trong môi trường mô phỏng nông nghiệp hay không.
Nghiên cứu chỉ ra rằng việc tách biệt câu từ chối và phần giải thích giúp AI phân biệt chính xác hơn giữa các truy vấn độc hại và các câu hỏi lành tính có từ ngữ nhạy cảm, từ đó giảm thiểu đáng kể tình trạng từ chối nhầm.
Bài viết phân tích cách xử lý các lỗi kỹ thuật (timeout, giới hạn tốc độ) và lỗi ngữ nghĩa (ảo tưởng, định dạng sai) trong ứng dụng LLM, đồng thời đề xuất chiến lược phân loại lỗi để xây dựng hệ thống ổn định hơn.
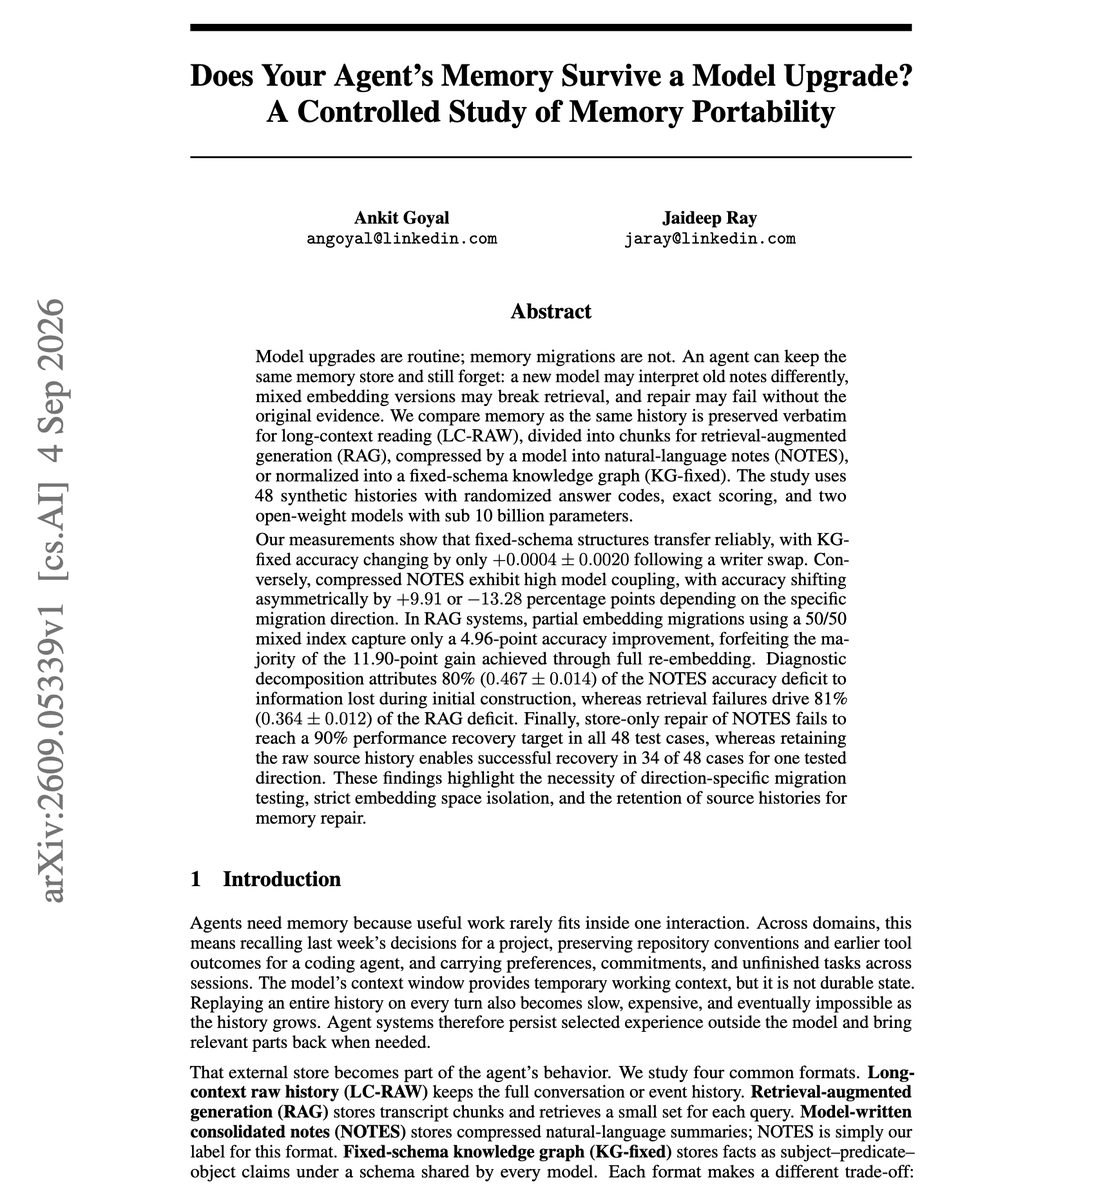
DAIR.AI@dair_aiBrilliant paper from LinkedIn. (bookmark it) I have been saying that memory is one of the most cha…
DịchNghiên cứu của LinkedIn phân tích khả năng duy trì bộ nhớ của các AI Agent khi thay đổi mô hình đọc/ghi, thông qua thử nghiệm trên 48 kịch bản lịch sử tổng hợp để đánh giá tính tương thích.

ModelBest OpenBMB@OpenBMB🚀 Meet MiniCPM5-2B, a 2B-parameter language model bringing high intelligence density to the edge, n…
DịchOpenBMB vừa ra mắt MiniCPM5-2B, mô hình ngôn ngữ nhỏ gọn nhưng dẫn đầu bảng xếp hạng Artificial Analysis cho các model dưới 4B tham số, đồng thời đạt điểm số ấn tượng 20 trong chỉ số Agentic Index.

Nghiên cứu này khám phá cách các mô hình ngôn ngữ lớn tổ chức các thao tác suy luận như phân tích mục tiêu và suy diễn trong không gian biểu diễn ẩn, chứng minh rằng các thao tác này có cấu trúc hình học riêng biệt và không phụ thuộc vào từ vựng.
Nghiên cứu mô hình hóa sự tương tác giữa điều phối viên và tác nhân LLM như một trò chơi phối hợp hai cấp, đồng thời phân tích cơ chế phản hồi thông qua lý thuyết xác suất để tối ưu hóa hiệu suất hệ thống.
Alibaba Cloud@alibaba_cloudAlibaba Cloud giới thiệu Qwen3.8-Flash, mô hình AI tập trung vào hiệu suất cao với yêu cầu hạ tầng tối giản, mang lại kết quả ấn tượng chỉ trên một node duy nhất.
DAIR.AI@dair_aiNghiên cứu thú vị khám phá liệu các mô hình AI có thể tự trả lời câu hỏi về chính khả năng và giới hạn của bản thân hay không, từ đó cải thiện độ chính xác trong tự đánh giá.

τ^τ-Bench là bộ tiêu chuẩn mới đánh giá khả năng của AI trong việc tự xây dựng các Agent thực tế, dựa trên các điều kiện khắt khe như dữ liệu doanh nghiệp, API sản xuất và giới hạn chi phí, thay vì chỉ giải quyết các bài toán lý thuyết.
Enoki là khung trích xuất thông tin mở giúp phát hiện ảo tưởng ở cả cấp độ khẳng định và cấp độ đoạn văn bản, tối ưu hóa quy trình xác thực mà không cần các bước căn chỉnh phức tạp.
Nghiên cứu giới thiệu OR-Clarify, bộ tiêu chuẩn đánh giá khả năng đặt câu hỏi làm rõ của AI trước khi xây dựng mô hình tối ưu hóa, giúp khắc phục tình trạng thiếu hụt thông tin trong các yêu cầu thực tế.
Motion-Omni là khung làm việc end-to-end cho phép mô hình đối thoại tạo ra lời nói cùng cử chỉ cơ thể (mặt, tay, dáng đi) trực tiếp từ trạng thái ẩn, thay vì phải xử lý tách biệt như các phương pháp truyền thống.