CEO Stripe Patrick Collison cho biết một kỹ sư đã thực hiện hơn 600 commit hoàn toàn bằng AI với tỷ lệ lỗi cực thấp, đồng thời duy trì độ ổn định hệ thống ở mức 5.5 số 9. Ngoài ra, OpenRouter sau khi về tay Stripe đã đạt quy mô xử lý 10 nghìn tỷ token mỗi ngày.
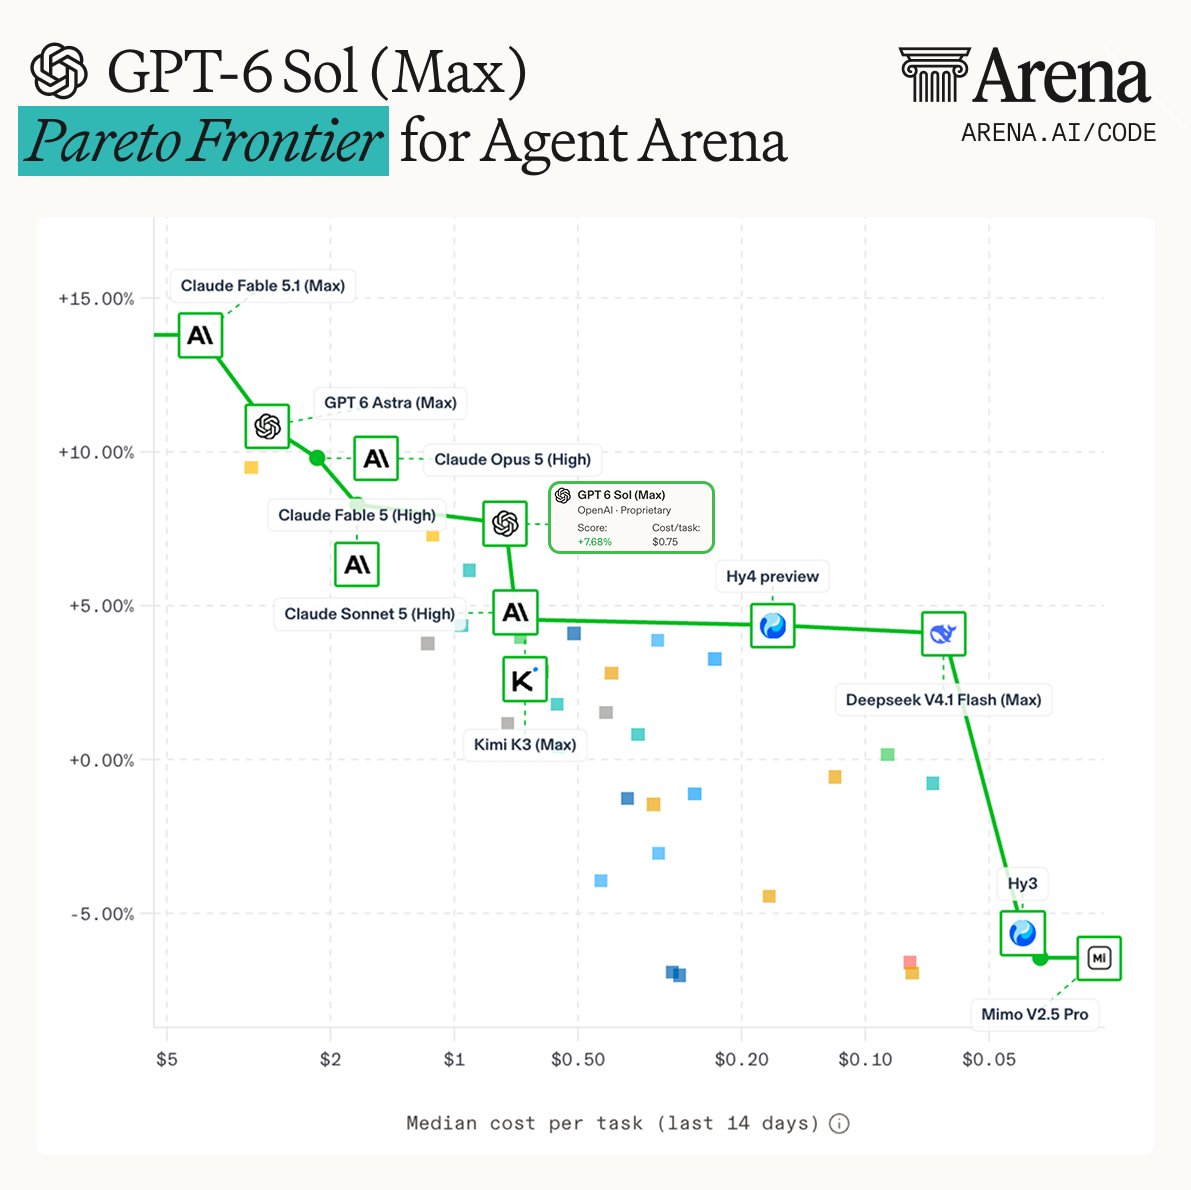
GPT-6 Sol (Max) by @OpenAI has reshaped the Agent Arena Pareto frontier with a +7.7% net improvement…
DịchOpenAI vừa đưa GPT-6 Sol (Max) vào bảng xếp hạng Agent Arena. Mô hình này đạt mức cải thiện ròng 7,7% dựa trên hơn 4.000 phiên hội thoại thực tế, xếp hạng 6 với chi phí trung bình 0,75 USD mỗi tác vụ.
Nghiên cứu từ Epoch AI cho thấy chi phí để đạt cùng một mức hiệu năng AI giảm trung bình 47% mỗi quý. Đặc biệt, các mô hình như GPT-5.6 dự kiến sẽ đạt hiệu suất vượt trội với chi phí thấp hơn gấp nhiều lần so với các thế hệ tiền nhiệm.
Claude Opus 5.5 is the new #1 in the Artificial Analysis Coding Agent Index, with gains across all t…
DịchTheo đánh giá từ Artificial Analysis, Claude Opus 5.5 đã vươn lên vị trí số 1 trên Coding Agent Index với 66 điểm, nhờ hiệu suất vượt trội trong các bài kiểm tra lập trình chuyên sâu, dù đi kèm với mức chi phí vận hành cao hơn đáng kể.
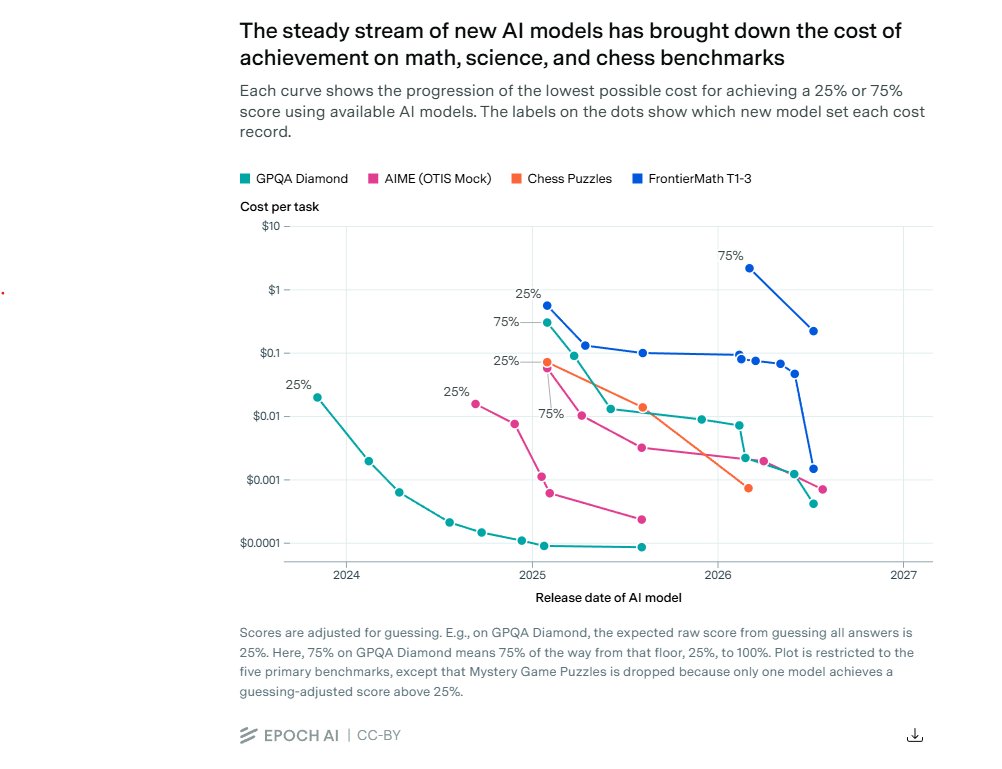
This is a really important graph showing the cost of achieving 25% or 75% scores in various hard mat…
DịchBiểu đồ mới cho thấy chi phí để AI đạt điểm số cao trong các bài kiểm tra toán học và khoa học khó đang giảm chóng mặt, trong khi năng lực lại tăng lên. Điều này cho thấy việc tối ưu hóa chi phí cho một giải pháp cụ thể hiện nay có thể là tầm nhìn ngắn hạn.
Whenever I see a model top this chart, it's normally a bit of a red flag. Would love to be proven wr…
DịchViệc Opus chiếm lĩnh vị trí dẫn đầu gây ra nhiều hoài nghi khi mô hình này tiêu tốn lượng token khổng lồ cho mỗi tác vụ. Nhiều chuyên gia cho rằng chính sự kém hiệu quả này là lý do khiến nhà phát triển phải giảm giá dịch vụ.
NeoCognition ra mắt ApprenticeBench, bài kiểm tra mô phỏng môi trường làm việc thực tế cho AI Agent. Kết quả cho thấy Fable 5.1 và Astra vượt qua con người về hiệu suất xử lý công việc, đặt ra bài toán về chi phí và khả năng tự thích nghi của AI trong doanh nghiệp.
Vì sao đáng đọc: Bài viết cung cấp góc nhìn thực tế về hiệu suất AI trong môi trường doanh nghiệp thay vì chỉ dựa vào các bảng xếp hạng lý thuyết, rất hữu ích cho người làm công nghệ.
Nghiên cứu chỉ ra rằng việc tăng số lượng phản hồi (N) giúp cải thiện khả năng suy luận của LLM, nhưng cách thức thực thi (batching) mới là yếu tố quyết định đến chi phí năng lượng và hiệu suất hệ thống.
This is an excellent demo of an AI model designed to rapidly classify information according to decis…
DịchMột bản demo ấn tượng về mô hình AI chuyên biệt giúp phân loại thông tin dựa trên quy tắc quyết định. Dù không tạo văn bản như LLM, mô hình này vượt trội về tốc độ và chi phí, hứa hẹn là công cụ tối ưu cho các hệ thống xử lý dữ liệu quy mô lớn.
I am extremely bullish on the Pareto frontier of collective intelligence. While everyone works on …
DịchSakana AI giới thiệu Fugu Max và Fugu Ultra v2, hai giải pháp tối ưu hóa giúp đạt hiệu suất đỉnh cao trong các tác vụ phức tạp với chi phí token cực thấp mà không cần phụ thuộc vào các mô hình ngoại lai.
Chỉ trong 2 tháng, Microsoft AI đã trình làng 8 mô hình đột phá, trong đó có 5 mô hình chiếm lĩnh vị trí số 1 trên các bảng xếp hạng uy tín về tốc độ, độ chính xác và chi phí tối ưu.
Better models don't automatically mean smaller AI bills. Sometimes they mean you finally have a rea…
DịchGPT-6 Astra giúp hiện thực hóa các quy trình phức tạp chỉ với một lần phản hồi. Thay vì chỉ nhìn vào chi phí token, doanh nghiệp nên tập trung vào việc tối đa hóa kết quả thực tế đạt được trong cùng một ngân sách.
New Microsoft paper. Long agent runs expose failures that short benchmarks miss. Agents can look rel…
DịchNghiên cứu mới từ Microsoft chỉ ra rằng các LLM Agent mất khả năng xử lý khi số bước thực hiện tăng lên, với tỷ lệ thành công giảm từ gần 100% xuống còn 0-33% ở bước thứ 16. Vấn đề nằm ở số lượng bước thay vì độ dài ngữ cảnh, đòi hỏi các giải pháp kiểm soát lỗi theo từng giai đoạn.
Zho đã thực hiện bài kiểm tra khắc nghiệt kéo dài 12 giờ trên GPT-6 Astra với dữ liệu đầu vào là ảnh kiến trúc. Kết quả đạt 60/100 điểm sau khi tiêu tốn tới 210 triệu token.
GPT-6 Astra just raised Epoch AI's capability record from 163 to 169. A substantial jump that still …
DịchGPT-6 Astra đạt 169 điểm trên thang đo ECI của Epoch AI, vượt qua kỷ lục cũ là 163. Sự tiến bộ này tương đương với khoảng 5 tháng phát triển theo xu hướng hiện tại và vẫn nằm trong phạm vi dự báo của các mô hình tăng trưởng AI.
New Stanford and other top research lab paper shows that the framework around an LLM can change agen…
DịchDuMateBench giới thiệu bộ tiêu chuẩn đánh giá AI Agent qua 200 tác vụ thực tế phức tạp, từ lập trình đến sáng tạo nội dung, giúp đo lường khả năng xử lý lỗi và môi trường thực tế của các mô hình.
Microsoft nhấn mạnh rằng sự tiến bộ của AI không nên chỉ đo bằng số lượng chip hay token, mà bằng khả năng tạo ra trí tuệ hữu ích với chi phí hợp lý cho người dùng.
Another example that the harness, more than the model itself, decides how far intelligence actually …
DịchAtomic Agent là lớp tác tử độc lập giúp GLM 5.3 cải thiện kết quả đáng kể chỉ với 0,77 USD chi phí phát sinh, chứng minh tầm quan trọng của kiến trúc tác tử so với việc chỉ dựa vào sức mạnh mô hình thuần túy.
This paper is a brutal reality check for long-horizon AI. Give an agent a year of interconnected dec…
DịchNghiên cứu trên 8 mô hình AI hàng đầu cho thấy khả năng thực hiện các tác vụ kéo dài của chúng còn rất hạn chế, với kết quả tốt nhất chỉ đạt 27,3% so với năng suất trung bình của con người.
perplexity is the best at search at any level of compute, agnostic of how much compute the competito…
DịchCEO Aravind Srinivas khẳng định Perplexity dẫn đầu bảng xếp hạng Artificial Analysis nhờ hiệu suất vượt trội và chi phí suy luận thấp nhất thị trường, chỉ từ 0,028 USD mỗi tác vụ.
Ox Alpha, the stealth frontier model that went live five days ago on OpenRouter, has attracted much …
DịchMô hình Ox Alpha vừa tạo nên cơn sốt trên OpenRouter khi đạt lưu lượng xử lý 8 nghìn tỷ token/ngày chỉ sau 5 ngày. Cộng đồng đang thảo luận sôi nổi với hơn 16,6 nghìn tỷ token được phân tích qua hàng ngàn tin nhắn.
DịchOx Alpha vừa thiết lập cột mốc ấn tượng khi xử lý khối lượng dữ liệu khổng lồ lên tới 26 nghìn tỷ token chỉ trong vòng 4 ngày, cho thấy bước tiến lớn về hiệu suất tính toán.
2026 is the year companies start seriously caring about model efficiency and reliability as it becom…
DịchKhi AI trở thành hạ tầng cốt lõi vào năm 2026, các doanh nghiệp sẽ chuyển trọng tâm sang việc nâng cao hiệu suất vận hành và đảm bảo độ tin cậy cho các mô hình AI.
Nghiên cứu mới cho thấy AI chạy cục bộ hiện đạt chất lượng tương đương 89% so với các mô hình đám mây hàng đầu, giúp giảm tới 80% năng lượng và 74% chi phí vận hành.
Grok 4.6 on extra high thinking mode now achieves #1 score on CursorBench!
DịchGrok 4.6 đạt 70,8% trên CursorBench 3.2, vượt qua các đối thủ mạnh như Fable 5 Max và Opus 5 Max với chi phí chỉ 2,81 USD mỗi tác vụ, khẳng định hiệu suất vượt trội trong lập trình AI.
This 3D coding test by @thehypedotnews found DeepSeek-V4-Pro-0813 used 48X more tokens than Muse Spa…
DịchTrong thử nghiệm xây dựng 3D, DeepSeek-V4-Pro-0813 tiêu tốn hơn 20 triệu token, gấp 48 lần so với Muse Spark 1.2, với chi phí 4,57 USD và thời gian xử lý hơn 91 phút.
And variance! The AI labs need to be thinking more about variance when considering creative tasks. T…
DịchViệc khó tạo ra các biến thể sáng tạo đa dạng đang hạn chế đáng kể giá trị thực tiễn của AI trong giải quyết vấn đề và các công việc đòi hỏi tư duy sáng tạo.
What are startups learning from building cost-effective agents with GPT-5.6? We worked with teams a…
DịchKhám phá cách các startup tận dụng GPT-5.6 để xây dựng AI Agent thông minh hơn, giúp xử lý các tác vụ phức tạp với chi phí vận hành tối ưu thông qua việc cải thiện suy luận và gọi công cụ.
Nền tảng Optima cho phép người dùng xây dựng các bài kiểm tra AI dựa trên dữ liệu và kịch bản thực tế, giúp so sánh chính xác chất lượng, chi phí và tốc độ của các mô hình ngôn ngữ.
Grok 4.6 beat GPT-5.6 Sol on agentic loop efficiency, spending $13.11 versus $20.18 across the same …
DịchGrok 4.6 hoàn thành các tác vụ lập trình với chi phí 13,11 USD, thấp hơn đáng kể so với 20,18 USD của GPT-5.6 Sol, đồng thời tối ưu hóa tốt hơn về thời gian và số lượng token nhờ tận dụng bộ nhớ đệm.
I think this will turn out to be wrong, and not just because I suspect there are greater returns to …
DịchEthan Mollick cho rằng giá trị kinh tế của AI không nằm ở chatbot mà ở các tác nhân tự hành (agents). Khi độ chính xác tăng lên, khả năng xử lý các tác vụ phức tạp sẽ tăng theo cấp số nhân, tạo ra giá trị vượt xa dự đoán của nhiều chuyên gia.
 Hongming@hongming731