12/09

Thứ Bảy · 7 tin
Ethan Mollick@emollick
NgànhĐiểm AI 36/100

Khi các bài kiểm tra AI đạt ngưỡng bão hòa: Chúng ta nên đo lường tiến bộ bằng gì?

Now that METR long horizons is effectively saturated (Epoch found pre-Fable agents could do 18 weeks…

DịchKhi các chuẩn đo lường như METR, Frontier Math và ARC-AGI dần trở nên quá dễ dàng với AI, giới chuyên gia đang đặt câu hỏi về các chỉ số mới để đánh giá tốc độ phát triển thực sự của trí tuệ nhân tạo.
Thariq@trq212
Sản phẩmĐiểm AI 54/100

Claude Code ra mắt tính năng 'plugin eval': Công cụ đánh giá hiệu quả cho plugin và kỹ năng AI

we heard feedback that it's hard to know if your skills are still working with new model releases p…

DịchClaude Code vừa bổ sung tính năng 'claude plugin eval', cho phép người dùng thiết lập các bài kiểm tra để so sánh hiệu suất giữa việc có và không có plugin, từ đó đánh giá chính xác giá trị thực tế và độ ổn định của các kỹ năng AI trên các phiên bản mô hình mới.

Artificial Analysis@ArtificialAnlys
Hướng dẫnĐiểm AI 64/100

Đánh giá độc lập Devin Fusion: Cấu hình Fable đạt 62 điểm, Astra tối ưu tốc độ và chi phí

We independently benchmarked Devin Fusion for its release today - this is the first time a multi-mod…

DịchArtificial Analysis vừa công bố kết quả kiểm thử độc lập cho Devin Fusion, trở thành tác nhân lập trình đa mô hình đầu tiên góp mặt trong bảng xếp hạng Coding Agent Index của họ.

Thariq@trq212
NgànhĐiểm AI 41/100

Các bài kiểm tra đánh giá AI hiện nay đang quá khắt khe và thiếu thực tế

it's basically impossible to interpret evals by looking at just at the pass/fail scores these days …

DịchCác bộ tiêu chuẩn đánh giá AI đang trở nên quá cứng nhắc với những bài kiểm tra ẩn, khiến kết quả không còn phản ánh đúng năng lực thực tế của mô hình, ngay cả khi câu trả lời của AI hợp lý hơn đáp án kỳ vọng.

11/09

Thứ Sáu · 4 tin
Artificial Analysis@ArtificialAnlys
Hướng dẫnĐiểm AI 53/100

Octen Search vươn lên vị trí thứ 3 trên bảng xếp hạng Artificial Analysis với tốc độ phản hồi nhanh nhất

Octen Search debuts third on the Artificial Analysis Search Index with a score of 77, achieving the …

DịchOcten Search đạt 77 điểm trên bảng xếp hạng Artificial Analysis, chỉ đứng sau Perplexity Search, đồng thời xác lập kỷ lục là công cụ tìm kiếm AI có tốc độ phản hồi nhanh nhất hiện nay.

Lee Robinson@leerob
NgànhĐiểm AI 29/100

CursorBench 4.0 chính thức ra mắt: Thử thách mới cho khả năng lập trình của AI

We just rolled out CursorBench 4.0! It includes new tasks for how well models follow instructions, …

DịchCursorBench 4.0 vừa được phát hành với các bài kiểm tra khắt khe hơn về khả năng tuân thủ chỉ dẫn và xử lý các dự án phức tạp dài hạn, khiến điểm số của mọi mô hình AI đều giảm đáng kể.

10/09

Thứ Năm · 10 tin
Ethan Mollick@emollick
NgànhĐiểm AI 37/100

AI hiện tại đã đủ để tạo ra cuộc cách mạng trong thập kỷ tới

Independent of policy about existential risk, it is worth noting that even if AI development stopped…

DịchNgay cả khi dừng phát triển AI từ hôm nay, các mô hình hiện có vẫn đủ sức thay đổi sâu sắc giáo dục, công việc và xã hội trong ít nhất 10 năm tới nhờ vào việc tối ưu hóa ứng dụng và triển khai thực tế.

Epoch AI: Nghiên cứu, dữ liệu và đánh giá
Nghiên cứuĐiểm AI 60/100

Tinh chọnĐánh giá HealthBench Professional: Epoch AI chỉ ra 50% tác vụ kiểm thử bị lỗi

Epoch AI đã thực hiện kiểm định độc lập trên bộ tiêu chuẩn HealthBench Professional của OpenAI và phát hiện một nửa trong số 50 tác vụ được lấy mẫu ngẫu nhiên gặp vấn đề nghiêm trọng về chất lượng.


Vì sao đáng đọc: Đây là báo cáo quan trọng về tính minh bạch và độ tin cậy của các bộ tiêu chuẩn đánh giá AI trong lĩnh vực y tế, thu hút sự quan tâm lớn từ giới nghiên cứu.
Elvis Saravia@omarsar0
NgànhĐiểm AI 43/100

AutoResearchExam: Bộ tiêu chuẩn mới đánh giá năng lực nghiên cứu của AI Agent

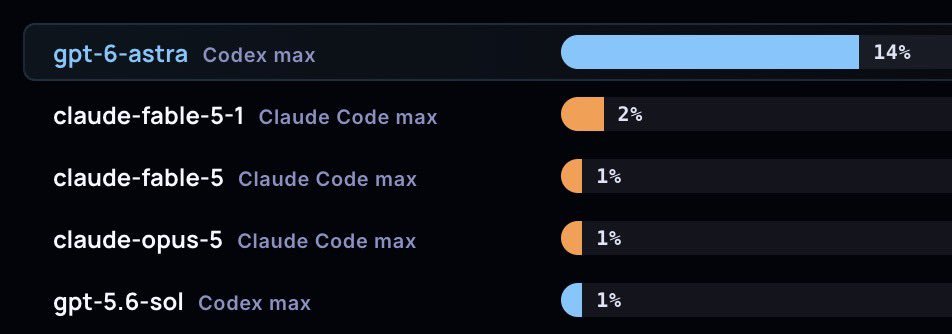
This is a really neat benchmark. It's super interesting that Astra starts strong and holds the lead …

DịchAutoResearchExam đánh giá khả năng tự nghiên cứu của AI trong 24 giờ qua 7 lĩnh vực chuyên sâu. Kết quả cho thấy Fable 5.1 đang dẫn đầu, trong khi Qwen, Gemini và Grok chiếm ưu thế về hiệu suất chi phí.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

VDiff-Bench: Bộ tiêu chuẩn đánh giá khả năng nhận diện thay đổi chi tiết giữa hai hình ảnh

VDiff-Bench là bộ tiêu chuẩn mới gồm 1.756 câu hỏi trắc nghiệm, giúp kiểm tra khả năng phát hiện các thay đổi tinh vi giữa hai hình ảnh của các mô hình ngôn ngữ đa phương thức (MLLM) vốn thường gặp khó khăn trong tác vụ này.

Artificial Analysis@ArtificialAnlys
NgànhĐiểm AI 38/100

GPT-6 Astra hiện đã hỗ trợ chạy các bài kiểm tra đánh giá tùy chỉnh trên Optima

You can test GPT-6 Astra on your own custom benchmarks in Optima Head to https://artificialanalysis...

DịchNgười dùng hiện có thể thiết lập và thực thi các bộ tiêu chuẩn đánh giá (benchmark) riêng cho mô hình GPT-6 Astra thông qua nền tảng Optima tại artificialanalysis.ai/optima.

09/09

Thứ Tư · 6 tin
ZHO@ZHO_ZHO_ZHO
NgànhĐiểm AI 39/100

Đánh giá thực tế GPT Images 2.5: Bước tiến vượt bậc về chất liệu và độ chi tiết

ZHO đánh giá cao khả năng tái tạo chất liệu và giữ vững đặc điểm hình ảnh của GPT Images 2.5. Phiên bản mới không chỉ xử lý xuất sắc các chi tiết phức tạp như lông hay sợi thừng mà còn loại bỏ hoàn toàn hiện tượng nhiễu hạt so với thế hệ trước.

ZHO@ZHO_ZHO_ZHO
NgànhĐiểm AI 36/100

Cùng sự kiệnGPT Image 2.5: Chuyển đổi ảnh anime sang người thật vẫn còn đậm chất AI

GPT Image 2.5 cải thiện đáng kể khả năng chỉnh sửa và độ chính xác khi chuyển đổi ảnh anime sang người thật. Tuy nhiên, kết quả vẫn bị đánh giá là thiếu tự nhiên, bóng bẩy quá mức và thua xa đối thủ Nano Banana Pro về độ chân thực.

Cùng sự kiện, tinh chọn hiển thị «OpenAI ra mắt ChatGPT Images 2.5: Tạo ảnh nhanh hơn, sắc nét và thông minh hơn»
ZHO@ZHO_ZHO_ZHO
NgànhĐiểm AI 37/100

Cùng sự kiệnTrải nghiệm GPT Images 2.5: Khả năng chuyển đổi phong cách đỉnh cao dù vẫn gặp lỗi sau 10 lượt tạo ảnh

GPT Images 2.5 gây ấn tượng mạnh với khả năng chuyển đổi phong cách và tư duy thiết kế xuất sắc, tuy nhiên mô hình vẫn gặp tình trạng mất ngữ cảnh hoặc quên nhiệm vụ sau 10 lượt tạo ảnh liên tiếp.

Cùng sự kiện, tinh chọn hiển thị «OpenAI ra mắt ChatGPT Images 2.5: Tạo ảnh nhanh hơn, sắc nét và thông minh hơn»
ZHO@ZHO_ZHO_ZHO
NgànhĐiểm AI 28/100

Trải nghiệm thực tế GPT Images 2.5: Khả năng giữ đặc điểm nhân vật cải thiện nhưng vẫn đậm chất AI

GPT Images 2.5 đã cải thiện đáng kể việc giữ đặc điểm nhân vật và phong cách, đồng thời giảm bớt nhiễu và độ bóng giả tạo. Tuy nhiên, kết quả đầu ra vẫn chưa thoát khỏi cảm giác 'AI' đặc trưng, ảnh hưởng đến độ chân thực.

08/09

Thứ Ba · 11 tin
DAIR.AI@dair_ai
NgànhĐiểm AI 47/100

Nghiên cứu mới: Kiến thức toán học trong LLM thiếu cấu trúc logic nhất quán

Finally a good paper testing whether an LLM's mathematical knowledge has coherent structure or just …

DịchNghiên cứu sử dụng lý thuyết không gian tri thức cho thấy các mô hình LLM thường vi phạm sự phụ thuộc logic trong toán học, dù vẫn đạt độ chính xác cao. Các mô hình khác nhau có sự chồng chéo tri thức thấp, cho thấy lỗ hổng trong cách đánh giá năng lực AI hiện nay.

Ethan Mollick@emollick
NgànhĐiểm AI 43/100

Liệu các chỉ số đánh giá dài hạn của METR đã chạm ngưỡng bão hòa?

Is the @METR_Evals long horizons measure effectively saturated? No updates to the most famous graph…

DịchCác chỉ số đánh giá dài hạn của METR dường như đã chững lại từ tháng 5, trong khi các nghiên cứu mới cho thấy AI hiện nay đã có khả năng xử lý khối lượng công việc kéo dài hơn 18 tuần trong môi trường kiểm soát.

Ethan Mollick@emollick
NgànhĐiểm AI 39/100

Tranh cãi về độ tin cậy của bộ tiêu chuẩn đánh giá AI GDPval-AA

Broken record here, but GDPval-AA is a very bad benchmark. 1) AIs give answers to the public questio…

DịchChuyên gia Ethan Mollick chỉ trích GDPval-AA là bộ tiêu chuẩn kém chất lượng vì dùng AI chấm điểm AI thay vì con người. Việc các phòng thí nghiệm vẫn sử dụng nó, dù kết quả gây tranh cãi như việc GPT-6 bị Kimi K3 vượt mặt, đang đặt ra dấu hỏi lớn về tính khách quan.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 53/100

Nghiên cứu mới: Phương pháp RAE đánh giá chính xác khả năng truy xuất kỹ năng của AI Agent

A skill-enabled agent can look better overall while performing worse on the exact tasks where it ret…

DịchCác nhà nghiên cứu từ Đại học Soongsil chỉ ra rằng cách đánh giá AI Agent hiện nay thường bị sai lệch. Họ đề xuất phương pháp RAE để đo lường thực chất hiệu quả của việc truy xuất kỹ năng, giúp khắc phục các hạn chế trong các bài kiểm tra truyền thống.

SemiAnalysis@SemiAnalysis_
NgànhĐiểm AI 45/100

Nghi vấn gian lận điểm chuẩn trên Gemini 3.8 Flash và Muse Spark 1.3

Gemini 3.8 Flash and Muse Spark 1.3 are two of the most clearly benchmaxxed models we've seen yet. D…

DịchGemini 3.8 Flash và Muse Spark 1.3 đang gây tranh cãi khi cho thấy dấu hiệu tối ưu hóa quá mức trên các bài kiểm tra chuẩn, dẫn đến sự sụt giảm hiệu suất đáng kể khi chuyển từ Terminal Bench 2.1 sang 4.0.

Ethan Mollick@emollick
NgànhĐiểm AI 41/100

GPT-6 thể hiện ra sao trong các trận chiến D&D?

A couple years later, with GPT-6. https://underdark-duel.netlify.app Apparently the mindflayer has …

DịchEthan Mollick đã thử nghiệm GPT-6 với luật chơi D&D 5E 2014 thông qua kịch bản đối đầu với Mind Flayer và không ghi nhận lỗi nghiêm trọng nào. Đây là một phần trong phương pháp 'kiểm thử chiến đấu' mà ông đề xuất để đánh giá khả năng suy luận của AI.

Artificial Analysis@ArtificialAnlys
NgànhĐiểm AI 44/100

Artificial Analysis ra mắt chỉ số thông minh v4.3: Claude và GPT-6 dẫn đầu bảng xếp hạng

Announcing Artificial Analysis Intelligence Index v4.3, upgrading Terminal-Bench to 4.0 and adding A…

DịchArtificial Analysis cập nhật chỉ số thông minh v4.3 với chuẩn đo lường AutomationBench-AA mới. Claude Fable 5.1 và GPT-6 Astra hiện đang dẫn đầu, trong khi GLM-5.3 và Kimi K3 thống trị nhóm mô hình mã nguồn mở.

07/09

Thứ Hai · 6 tin
Kim@kimmonismus
NgànhĐiểm AI 19/100

MazeBench công bố: GPT-Astra vượt mặt mọi đối thủ về khả năng suy luận

Another exciting reasoning benchmark, MazeBench, where GPT-Astra outperforms any other model, especi…

DịchMazeBench, bộ tiêu chuẩn đánh giá khả năng suy luận mới, đã xác nhận GPT-Astra dẫn đầu thị trường, vượt xa các đối thủ như Fable 5.1. Thành tích này củng cố vị thế của Astra trước thềm OpenAI ra mắt mô hình thế hệ tiếp theo.

Artificial Analysis@ArtificialAnlys
Hướng dẫnĐiểm AI 55/100

MiniCPM5-2B dẫn đầu bảng xếp hạng trí tuệ cho các mô hình AI dưới 4 tỷ tham số

OpenBMB's MiniCPM5-2B scores 15 on the Artificial Analysis Intelligence Index v4.2, the highest of a…

DịchArtificial Analysis đánh giá MiniCPM5-2B đạt 15 điểm trên Intelligence Index v4.2, trở thành mô hình mã nguồn mở dưới 4B tham số thông minh nhất hiện nay, chỉ xếp sau Ling 3.0 Tiny.

Thêm 3 nguồn khác đưa tinX: ModelBest OpenBMB (@OpenBMB)IT HomeWeChat: ModelBest (MiniCPM)
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnτ^τ-Bench: Thước đo thực tế cho khả năng xây dựng AI Agent từ đầu đến cuối

τ^τ-Bench là bộ tiêu chuẩn mới đánh giá khả năng của AI trong việc tự xây dựng các Agent thực tế, dựa trên các điều kiện khắt khe như dữ liệu doanh nghiệp, API sản xuất và giới hạn chi phí, thay vì chỉ giải quyết các bài toán lý thuyết.


Vì sao đáng đọc: Đây là nghiên cứu quan trọng vì nó chuyển dịch trọng tâm từ việc đánh giá AI giải đố sang đánh giá khả năng thực thi dự án thực tế, rất hữu ích cho các kỹ sư AI.
Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (45 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Đánh giá AI” — Trang 4 | AIHOT.vn