15/09

Thứ Ba · 5 tin
Pragmatic Engineer
Hướng dẫnĐiểm AI 79/100

Tinh chọnGergely Orosz thăm OpenAI: Cách Codex vận hành 'nhà máy' phần mềm tự động

Gergely Orosz đã đến thăm trụ sở OpenAI và phỏng vấn các kỹ sư, tiết lộ rằng Codex và ChatGPT Work hiện là nền tảng cốt lõi trong mọi quy trình phát triển phần mềm tại công ty.


Vì sao đáng đọc: Cái nhìn thực tế từ bên trong OpenAI về cách họ ứng dụng AI để tự động hóa quy trình kỹ thuật là thông tin cực kỳ giá trị cho giới lập trình và quản lý công nghệ.
Xiaobei@frxiaobei
Hướng dẫnĐiểm AI 64/100

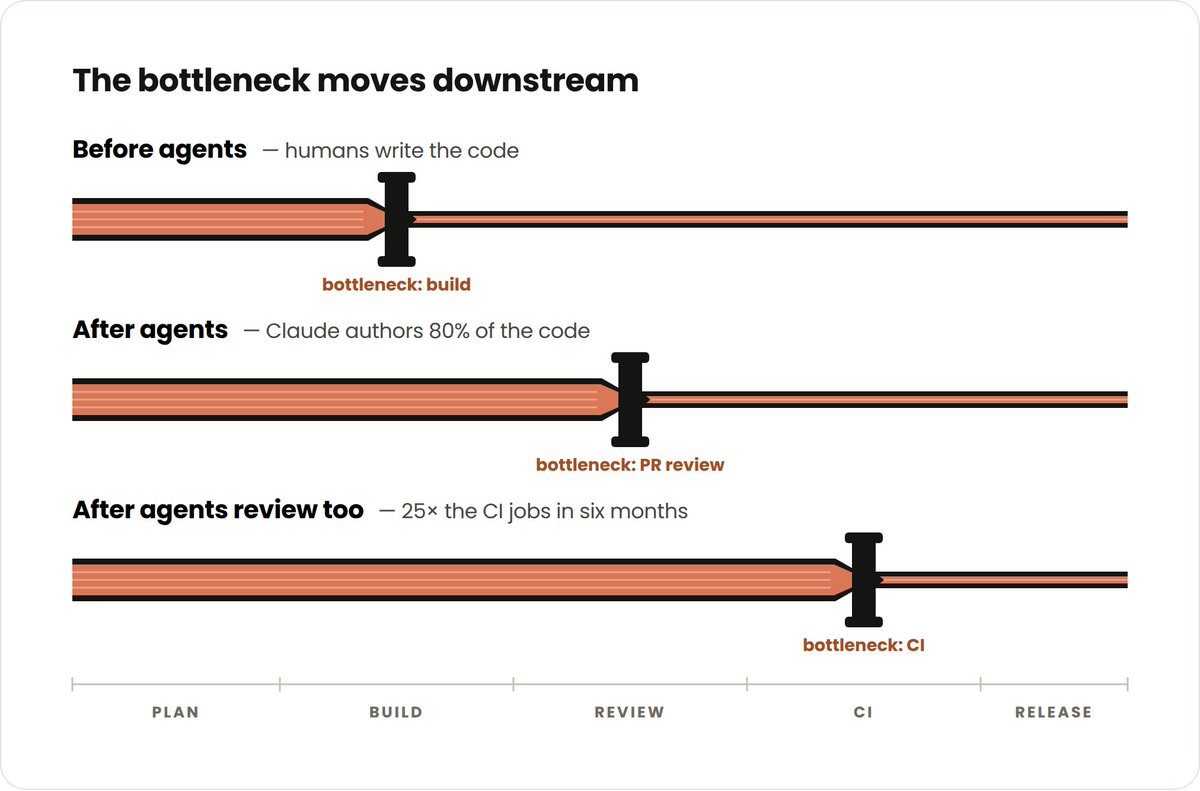
Anthropic chia sẻ bài học xương máu: Khi Coding Agent làm tăng gấp 8 lần lượng code, hệ thống CI 'gục ngã'

Anthropic tiết lộ thách thức khi áp dụng Coding Agent: khối lượng code tăng gấp 8 lần (80% do Claude viết) khiến số lượng kiểm thử tăng vọt, buộc hệ thống CI phải cải tổ toàn diện sau khi tải trọng tăng 25 lần chỉ trong nửa năm.

Claude: Blog (Web)
Hướng dẫnĐiểm AI 66/100

Tinh chọnKỹ sư Anthropic chia sẻ cách mở rộng hệ thống kiểm thử khi lập trình bằng AI

Khi Claude viết 80% mã nguồn khiến khối lượng CI tăng vọt 25 lần, đội ngũ Anthropic đã phải từ bỏ các giải pháp tạm thời để thiết kế lại kiến trúc hệ thống kiểm thử theo hướng phi trạng thái và có khả năng mở rộng linh hoạt.


Vì sao đáng đọc: Bài học thực tế, giá trị cao cho các kỹ sư đang đối mặt với thách thức hạ tầng khi tích hợp AI vào quy trình phát triển phần mềm (AI Coding).

14/09

Thứ Hai · 1 tin

13/09

Chủ Nhật · 3 tin
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
NgànhĐiểm AI 47/100

Cảnh báo từ kỹ sư phần mềm: Rủi ro tiềm ẩn khi AI tự đánh giá và lập trình

Các kỹ sư cảnh báo rằng việc phụ thuộc vào AI để tự đánh giá và lập trình tạo ra nhiều rủi ro 'ẩn'. Do dữ liệu huấn luyện chứa đầy các thói quen xấu từ người dùng không chuyên, AI dễ tạo ra mã nguồn dư thừa và thiếu tối ưu, gây ảnh hưởng đến toàn bộ hệ thống đánh giá tự động.

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 60/100

Real-SWE: Bộ tiêu chuẩn đánh giá AI lập trình dựa trên mã nguồn thực tế của doanh nghiệp

Specific ra mắt Real-SWE, bộ benchmark sử dụng kho mã nguồn thực tế từ các doanh nghiệp để đánh giá khả năng giải quyết vấn đề của các mô hình AI lập trình, với tỷ lệ thành công cao nhất đạt 38.8%.

Thêm 1 nguồn khác đưa tinHuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Dex Horthy (HumanLayer)@dexhorthy
NgànhĐiểm AI 42/100

Dex Horthy phản biện mô hình 'Nhà máy phần mềm': Cần giữ vai trò con người trong vòng lặp

dark factories = fail eventually* Lights on factories = very good idea plz automate everything that…

DịchDex Horthy tranh luận rằng dù tự động hóa là mục tiêu, AI vẫn cần sự giám sát của con người để đảm bảo chất lượng, phản bác quan điểm cho rằng AI có thể tự xây dựng tính năng từ đầu đến cuối mà không cần kiểm soát.

12/09

Thứ Bảy · 6 tin
AI Notes@AYi_AInotes
Hướng dẫnĐiểm AI 51/100

Giám đốc AI tại Meta: Một nhóm AI Agent có thể vượt xa năng suất của 100 kỹ sư cao cấp

Alexandr Wang, nhà sáng lập Scale AI, khẳng định rằng với quy trình vận hành và hệ thống đánh giá tự tối ưu hóa phù hợp, các AI Agent có thể hoàn thành khối lượng công việc lớn hơn cả một đội ngũ 100 kỹ sư phần mềm dày dạn kinh nghiệm.

Rohan Paul@rohanpaul_ai
NgànhĐiểm AI 45/100

Lãnh đạo Meta: Đội ngũ AI Agent có thể làm việc hiệu quả hơn 100 kỹ sư

Meta's chief ai officer @alexandr_wang: "Internally at Meta, we have seen cases where, if you deve…

DịchGiám đốc AI của Meta khẳng định rằng với quy trình và hệ thống đánh giá phù hợp, các nhóm AI Agent có thể hoàn thành khối lượng công việc vượt xa một đội ngũ 100 kỹ sư một cách dễ dàng.

IT Home
Hướng dẫnĐiểm AI 61/100

Cùng sự kiệnOpenAI chuyển đổi nền tảng lưu trữ Habitat từ Python sang Rust, tăng hiệu suất CPU gấp 6 lần

OpenAI đã tối ưu hóa nền tảng lưu trữ Habitat bằng cách chuyển sang Rust, giúp xử lý hơn 70 triệu yêu cầu mỗi giây trên quy mô dữ liệu 500PB với hiệu suất CPU vượt trội.

Cùng sự kiện, tinh chọn hiển thị «OpenAI hé lộ cách nền tảng Habitat vận hành hệ thống lưu trữ cho hơn 1 tỷ người dùng ChatGPT (Phần 1)»
AI Notes@AYi_AInotes
Hướng dẫnĐiểm AI 66/100

Giám đốc Claude Code: Tiêu chuẩn mã nguồn AI phải khắt khe hơn thay vì dễ dãi

Boris Cherny khẳng định khi AI tham gia lập trình, các tiêu chuẩn cho mã nguồn đưa vào môi trường sản xuất cần phải cao hơn so với khi con người tự viết để đảm bảo tính ổn định và bảo mật.

Thêm 1 nguồn khác đưa tinSimon Willison Blog

11/09

Thứ Sáu · 4 tin
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 54/100

Đo lường độ 'ẩu' trong code do LLM tạo ra: Chỉ số Verbosity và Erosion

Kỹ sư tại Earendil đề xuất sử dụng các chỉ số như thay đổi LOC, độ dài (verbosity) và mức độ bào mòn (erosion) để đánh giá chất lượng code từ LLM, thay vì dựa vào phương pháp AI-as-a-judge kém hiệu quả.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

IdeaAMBIG: Đánh giá lỗ hổng trong việc hiện thực hóa các ý tưởng nghiên cứu AI

Nghiên cứu giới thiệu IdeaAMBIG, bộ dữ liệu gồm 660 trường hợp nhằm kiểm tra khả năng chuyển đổi từ ý tưởng nghiên cứu sang mã nguồn thực tế, giúp xác định các thiếu sót trong tài liệu kỹ thuật mà các nhà phát triển thường gặp phải.

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 57/100

AI đang phá vỡ niềm tin nơi công sở: Góc nhìn từ việc đánh giá mã nguồn

Việc lạm dụng AI để tạo mã nguồn mà không thực sự hiểu rõ đang làm xói mòn niềm tin giữa các kỹ sư. Bài viết cảnh báo về sự suy giảm chất lượng trong quy trình đánh giá mã và đề xuất các giải pháp để khôi phục trách nhiệm cá nhân trong công việc.

Peter Steinberger@steipete
NgànhĐiểm AI 30/100

Sao chép logic không còn là nỗi đau, nhưng trừu tượng hóa vẫn là bài toán khó

This makes a lot of sense. Duplicating logic is no longer painful. Abstractions still are.

DịchViệc sao chép logic lập trình đã trở nên dễ dàng hơn, nhưng việc xây dựng các lớp trừu tượng hiệu quả vẫn là thách thức lớn đối với các kỹ sư phần mềm.

10/09

Thứ Năm · 6 tin
Augment Code Blog (Web)
NgànhĐiểm AI 68/100

Tinh chọnAugment chia sẻ kinh nghiệm xây dựng 'nhà máy phần mềm': Tăng năng suất gấp 4,5 lần nhờ AI

Augment Code tổng kết quá trình 9 tháng tối ưu hóa quy trình phát triển phần mềm thông qua nền tảng Cosmos, tích hợp AI vào mọi khâu từ yêu cầu đến triển khai để đạt hiệu suất vượt trội.


Vì sao đáng đọc: Bài viết cung cấp case study thực tế về việc ứng dụng AI Agent vào quy trình kỹ thuật, mang lại giá trị tham khảo cao cho các doanh nghiệp công nghệ.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
NgànhĐiểm AI 39/100

Φ-Bench: Đánh giá khả năng của LLM trong việc tự tối ưu hóa hạ tầng kỹ thuật

Φ-Bench là bộ tiêu chuẩn mới giúp đánh giá năng lực của LLM trong việc giải quyết các bài toán kỹ thuật phức tạp, từ tối ưu hóa kernel đến xây dựng hệ thống hạ tầng AI hoàn chỉnh dựa trên mã nguồn thực tế.

Rohan Paul@rohanpaul_ai
Hướng dẫnĐiểm AI 64/100

OpenAI công bố Defense Factory: Dùng AI tự động vá lỗi cho hàng trăm hệ thống nội bộ

Codex agents wrote every patch in OpenAI's company-wide security sprint across hundreds of systems. …

DịchOpenAI giới thiệu Defense Factory, sử dụng mô hình Codex và AI bảo mật để tự động phát hiện và vá hàng trăm lỗ hổng trong đợt rà soát an ninh quy mô lớn, giúp tối ưu hóa hiệu suất cho hơn 250 kỹ sư.

Mistral AI: News (Web)
Hướng dẫnĐiểm AI 61/100

Tinh chọnMistral chia sẻ kinh nghiệm dùng AI Agent chuyển đổi 40.000 dòng mã Fortran 77 sang C++

Mistral đã hỗ trợ một công ty năng lượng hiện đại hóa hệ thống mô phỏng cũ bằng cách sử dụng quy trình làm việc tự động hóa với các AI Agent chuyên biệt, đảm bảo tính chính xác thông qua kiểm thử đối chiếu số liệu.

Diễn biến sự kiện · 1 bài →Thêm 1 nguồn khác đưa tinX: Xiaobei (@frxiaobei)

Vì sao đáng đọc: Case study thực tế, có giá trị cao cho kỹ sư phần mềm đang đối mặt với bài toán hiện đại hóa mã nguồn cũ bằng AI.
Dex Horthy (HumanLayer)@dexhorthy
NgànhĐiểm AI 19/100

Tuyển chọn khách mời cho buổi tiệc tối dành cho lãnh đạo AI tại San Francisco

this is gonna happen wednesday sept 23 - ping me if interested, have a few more spots still

DịchDex Horthy đang tổ chức một buổi tiệc tối vào ngày 23/9 tại San Francisco dành riêng cho các lãnh đạo kỹ thuật tại các công ty có trên 100 kỹ sư đang vận hành các nhà máy phần mềm AI.

09/09

Thứ Tư · 6 tin
Google Developers Blog
Hướng dẫnĐiểm AI 59/100

Google chia sẻ kỹ thuật Harness: Cách đánh giá, cải tiến và kiểm soát AI lập trình

Google giới thiệu phương pháp đánh giá hành vi (behavioral evals) cho AI lập trình, thay vì chỉ kiểm tra kết quả cuối cùng, họ tập trung vào việc thiết lập các điểm kiểm soát cho từng bước thực thi trung gian để tối ưu hóa hiệu suất.

AI Notes@AYi_AInotes
Hướng dẫnĐiểm AI 58/100

Tranh luận về quy mô mã nguồn: Liệu code ít có đồng nghĩa với kém quan trọng?

Cuộc tranh luận giữa Theo và Laurie về tầm quan trọng của mã nguồn dựa trên quy mô. Tác giả chỉ ra rằng giá trị thực sự không nằm ở độ lớn, mà ở 'bán kính ảnh hưởng' và khả năng khôi phục hệ thống trong bối cảnh AI đang làm thay đổi cách chúng ta viết code.

Tianyi Cui@tianyi
NgànhĐiểm AI 52/100

DeepSeek tuyển dụng 150 kỹ sư cấp cao: Cải tổ quy trình phỏng vấn, bỏ thi thuật toán kiểu ACM

DeepSeek vừa mở đợt tuyển dụng lớn cho 150 vị trí kỹ sư backend, đồng thời thay đổi quy trình phỏng vấn bằng cách loại bỏ các bài thi thuật toán kiểu ACM, thay bằng thiết kế hệ thống và tư duy giải pháp để rút ngắn thời gian tuyển chọn.

Elvis Saravia@omarsar0
NgànhĐiểm AI 47/100

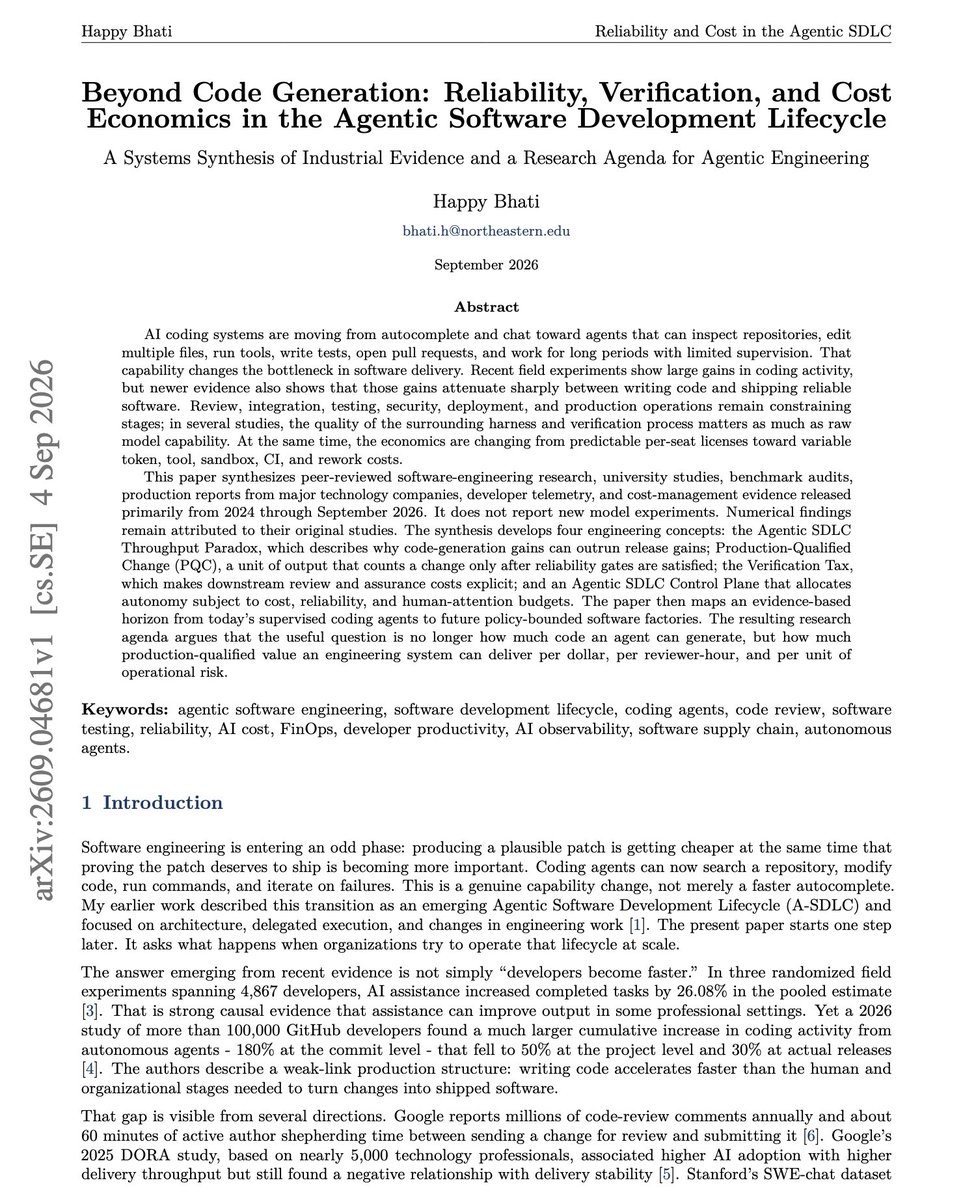
Vượt xa lập trình AI: Bài toán về độ tin cậy và kinh tế học chi phí

Nice report on agents beyond code generation. Here is why it matters: Coding agents raise how much…

DịchBáo cáo từ DAIR.AI chỉ ra rằng dù AI giúp tăng tốc viết code, nhưng chi phí thực tế lại chuyển dịch sang kiểm thử, bảo mật và vận hành. Các khái niệm mới như 'nghịch lý thông lượng' và 'thuế xác thực' đang định hình lại cách chúng ta đánh giá hiệu quả của AI trong quy trình phát triển phần mềm.

07/09

Thứ Hai · 2 tin
ByteByteGo
Hướng dẫnĐiểm AI 56/100

ByteByteGo: Hướng dẫn toàn diện về xử lý lỗi và thiết kế hệ thống LLM bền bỉ

Bài viết phân tích cách xử lý các lỗi kỹ thuật (timeout, giới hạn tốc độ) và lỗi ngữ nghĩa (ảo tưởng, định dạng sai) trong ứng dụng LLM, đồng thời đề xuất chiến lược phân loại lỗi để xây dựng hệ thống ổn định hơn.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 57/100

Google DeepMind và MIT giới thiệu SMART: Khi tài liệu thiết kế thay thế mã nguồn trong mô hình hóa ML

// Design Docs Are All You Need // Banger paper from Google DeepMind, MIT, and colleagues. What a …

DịchSMART là thư viện mô hình hóa hiệu năng ML đột phá, nơi mã nguồn được tự động tạo từ các tài liệu thiết kế dạng đồ thị thay vì viết tay, giúp tối ưu hóa quy trình cập nhật và quản lý hệ thống.

06/09

Chủ Nhật · 1 tin
Peter Steinberger@steipete
NgànhĐiểm AI 25/100

Tích hợp 'thước đo sự cẩu thả' vào server nhóm: Nhìn thấy rõ thời điểm chúng tôi bắt đầu đẩy mạnh viết test

Một kỹ sư đã xây dựng công cụ theo dõi chất lượng code (slopmeter) để đo lường sự cẩu thả trong dự án, qua đó thấy rõ tác động tích cực của việc tăng cường viết unit test đối với sự ổn định của hệ thống.

03/09

Thứ Năm · 3 tin
Rohan Paul@rohanpaul_ai
NgànhĐiểm AI 59/100

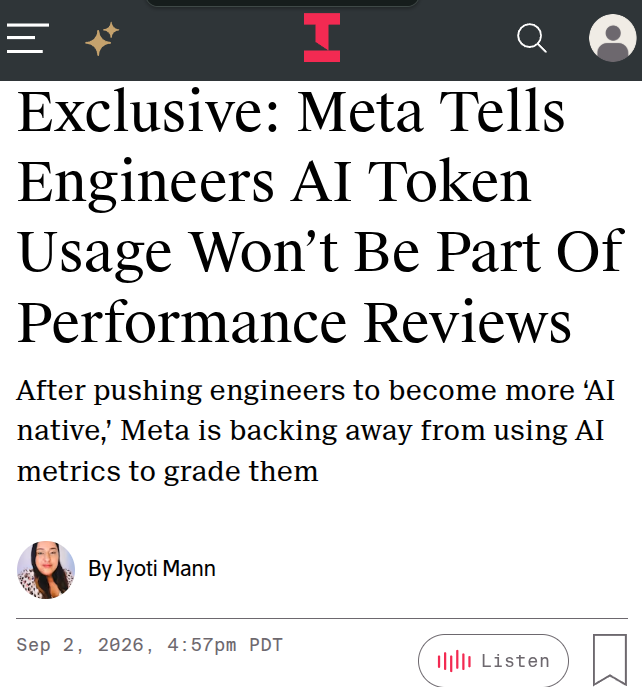
Meta loại bỏ chỉ số sử dụng AI token khỏi đánh giá hiệu suất kỹ sư

Meta is removing AI token counts from engineer reviews after employees began gaming usage metrics. …

DịchSau khi phát hiện nhân viên cố tình 'cày' chỉ số sử dụng AI, Meta đã quyết định loại bỏ tiêu chí này khỏi đánh giá hiệu suất. Dù vậy, công ty khẳng định 93% mã nguồn vẫn được hỗ trợ bởi AI và khuyến khích kỹ sư tiếp tục sử dụng công cụ này.

Thêm 1 nguồn khác đưa tinIT Home
AI Notes@AYi_AInotes
Hướng dẫnĐiểm AI 62/100

Stanford làm mới khóa học CS146S: Loại bỏ 85% giáo trình cũ để tập trung vào kỹ thuật phần mềm AI-native

Giảng viên Mihail Eric vừa công bố phiên bản mới của khóa học 'The Modern Software Developer' (CS146S) sau 9 tháng biên soạn, thay thế 85% nội dung cũ bằng kiến thức chuyên sâu về phát triển phần mềm trong kỷ nguyên AI.

GitHub Blog
Hướng dẫnĐiểm AI 61/100

Tinh chọnGitHub Copilot tối ưu chi phí vận hành AI mà không làm giảm chất lượng code

Kỹ sư GitHub chia sẻ 4 chiến lược tối ưu hóa, từ việc nén dữ liệu đầu vào đến tinh chỉnh quy trình xử lý tác vụ, giúp giảm đáng kể chi phí suy luận mà vẫn đảm bảo hiệu suất lập trình.


Vì sao đáng đọc: Bài viết cung cấp các giải pháp kỹ thuật thực tế, có tính ứng dụng cao cho các nhà phát triển và doanh nghiệp đang tối ưu hóa chi phí triển khai AI.

02/09

Thứ Tư · 3 tin
Google Developers Blog
Hướng dẫnĐiểm AI 61/100

Tinh chọnGoogle đúc kết 4 mô hình kỹ thuật từ các dự án AI Agent xuất sắc nhất

Google phân tích cuộc thi AI Agents Challenge và rút ra 4 mô hình kỹ thuật then chốt: MCP hai chiều, xử lý song song hướng sự kiện, cơ chế dự phòng chuẩn hóa và định tuyến phân tầng.


Vì sao đáng đọc: Nội dung mang tính thực tiễn cao cho kỹ sư, cung cấp kiến trúc hệ thống cụ thể từ các dự án thực tế thay vì lý thuyết suông.
Google AI: DEV tác giả
Hướng dẫnĐiểm AI 69/100

Tinh chọnHarness Engineering là gì? Google trình diễn khả năng tự sửa lỗi code với ADK 2.0 và Antigravity SDK

Google giới thiệu kỹ thuật 'harness' giúp bao bọc LLM bằng các thành phần xác định như sandbox và công cụ kiểm chứng, cho phép AI tự động tạo và sửa lỗi code an toàn mà không cần con người can thiệp.


Vì sao đáng đọc: Chủ đề kỹ thuật chuyên sâu, cung cấp giải pháp thực tế để tăng độ tin cậy cho AI Agent trong lập trình, rất hữu ích cho các kỹ sư phần mềm.
Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (57 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Kỹ thuật phần mềm” — Trang 2 | AIHOT.vn