Thủ thuật
Anthropic tối ưu hóa quy trình CI như thế nào khi AI viết 80% mã nguồn?
(giờ Việt Nam)
Tóm tắt AI
Khi lượng mã nguồn do Claude tạo ra tăng vọt khiến khối lượng công việc CI tăng gấp 25 lần, Anthropic đã phải tái cấu trúc hệ thống phân tích tác động kiểm thử để duy trì tốc độ phát triển.
Bản dịch AI
AI đang làm thay đổi CI
Các kỹ sư tại Anthropic hiện xuất xưởng lượng code trung bình gấp 8 lần mỗi quý so với giai đoạn 2021-2025. Claude viết 80% lượng code đó và cũng đóng vai trò lớn trong việc đánh giá cũng như phê duyệt các PR (Pull Request).
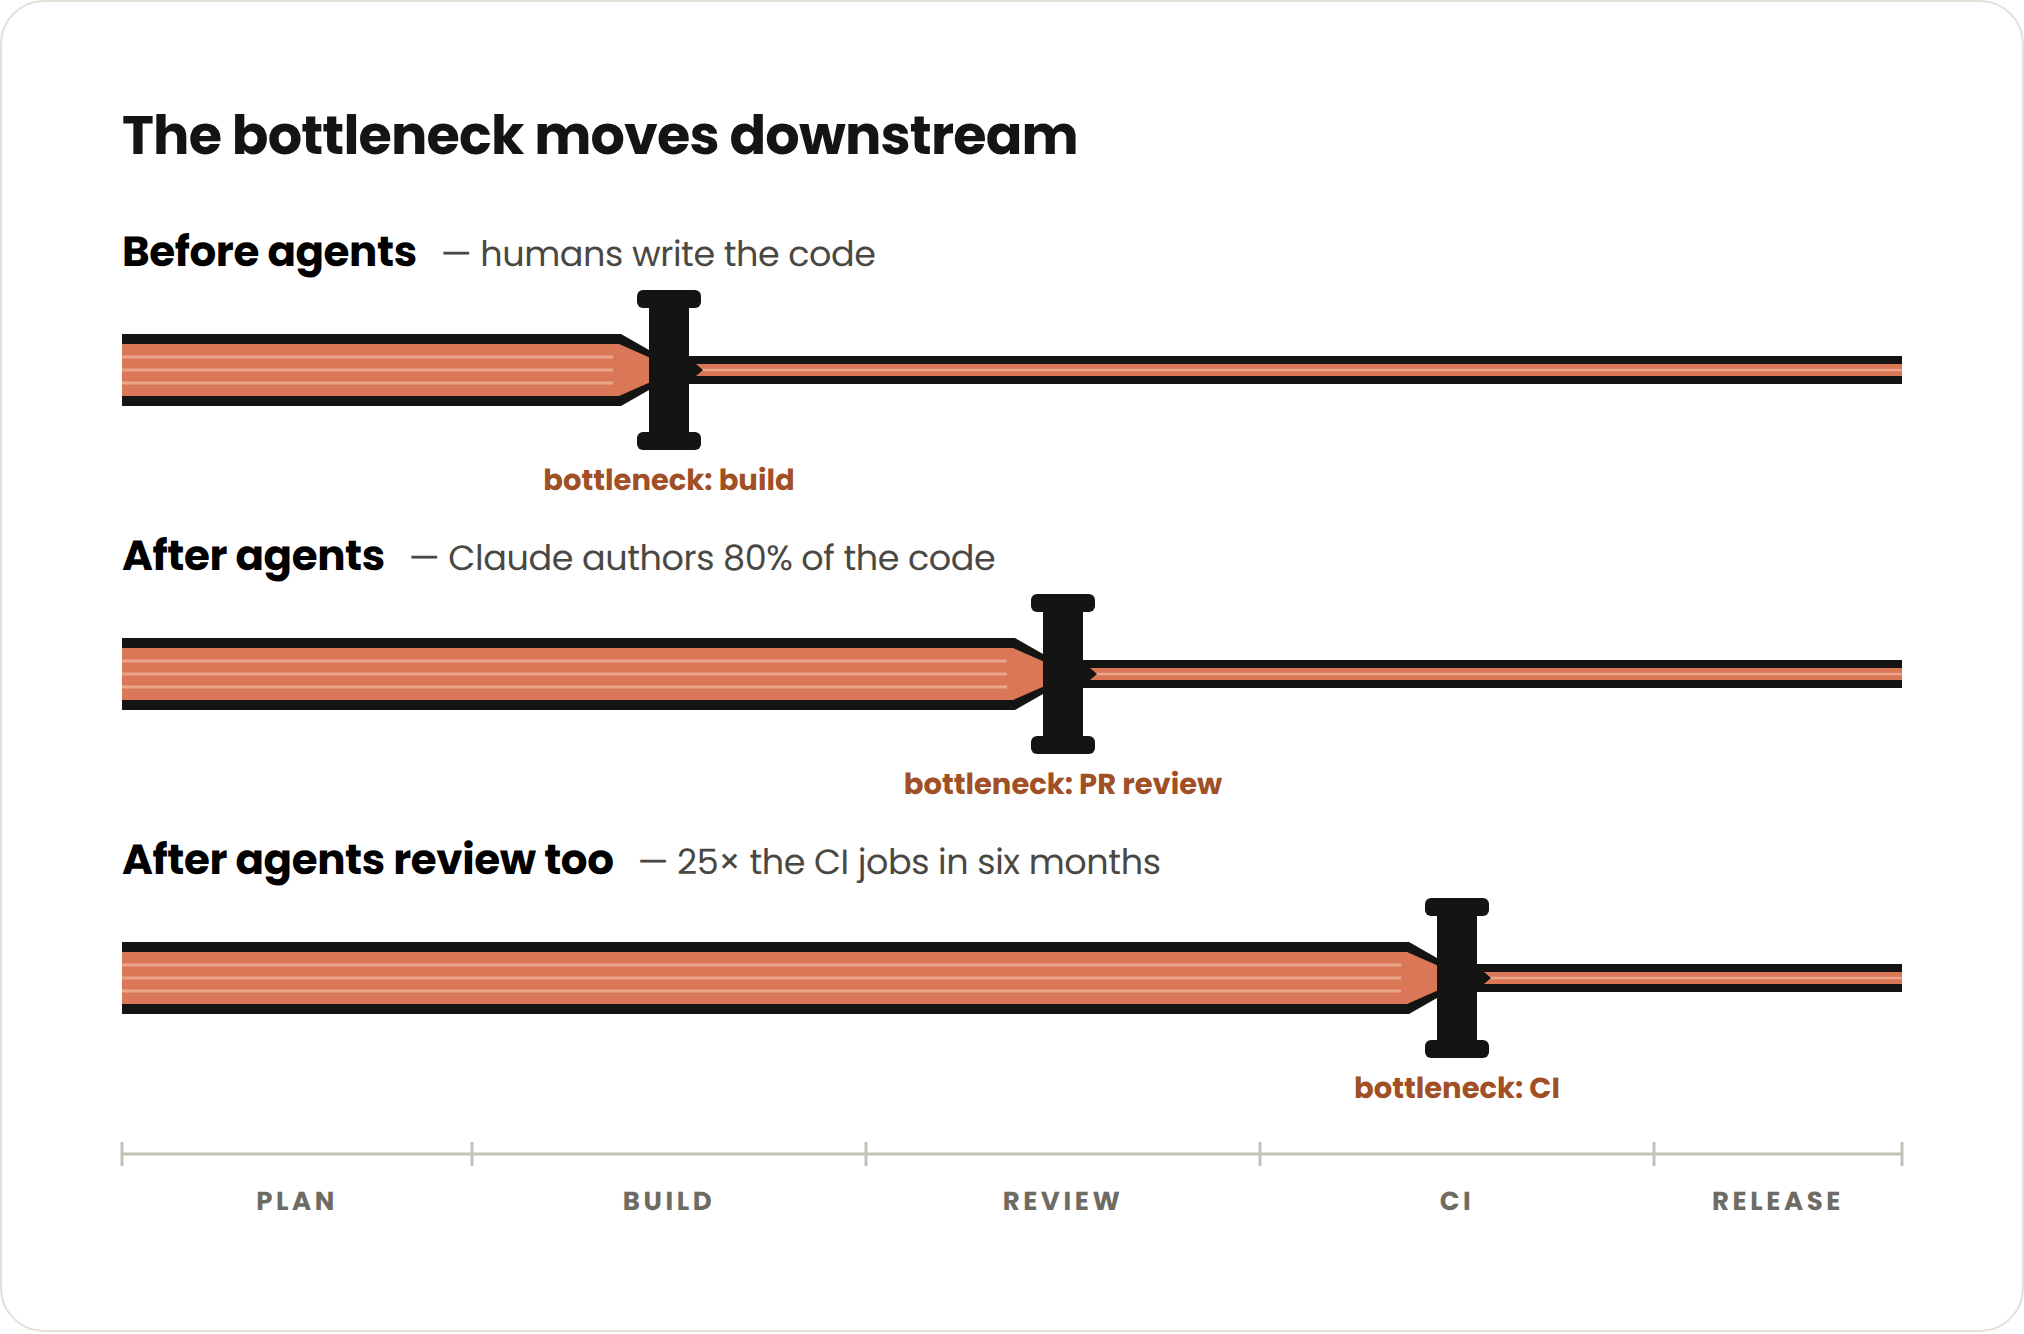
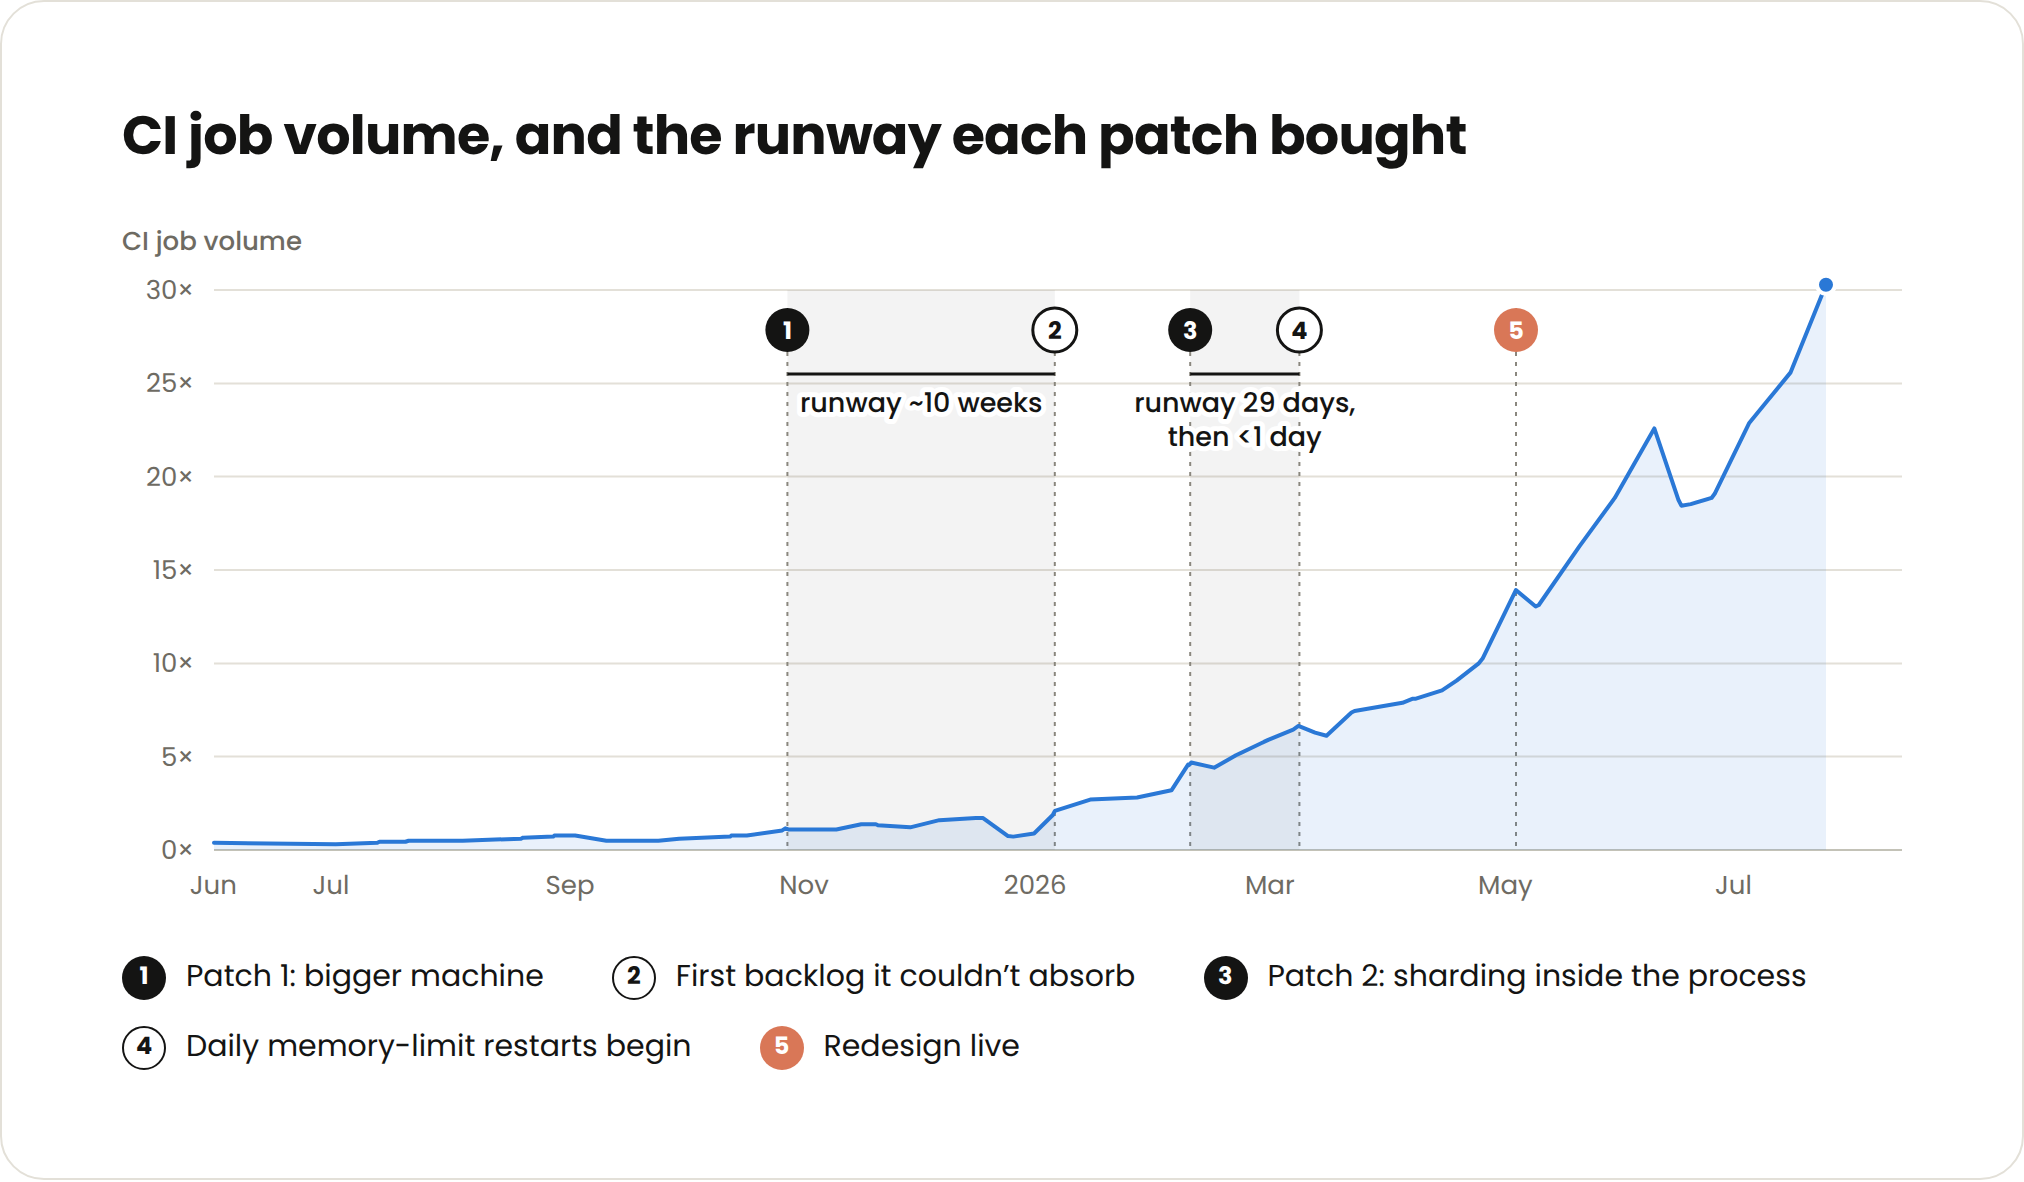
Thêm vào đó, số lượng bài kiểm thử (test) trong cơ sở mã nguồn của chúng tôi đã tăng gấp 10 lần trong khi số lượng kỹ sư chỉ tăng không đáng kể. Tất cả những điều này dẫn đến việc các tác vụ CI tăng gấp 25 lần trong khoảng thời gian sáu tháng (nếu bạn đang cố tính toán, thì không phải mọi bài test đều chạy trên mọi PR như tôi sẽ giải thích sau).
Điều này đe dọa làm quá tải dịch vụ phân tích tác động kiểm thử (test impact analysis service) của chúng tôi nhiều lần. Để tránh trở thành nút thắt cổ chai tiếp theo, chúng tôi đã phá bỏ toàn bộ hệ thống và tái hình dung kiến trúc của dịch vụ này. Nhưng để đạt được điều đó là một con đường gập ghềnh bắt đầu bằng ba bản sửa lỗi nhanh, lần lượt kéo dài 70 ngày, 29 ngày và sau đó là chưa đầy một ngày.
Mở rộng quy mô CI là một thách thức mà nhiều đội ngũ kỹ thuật có khả năng sẽ sớm phải đối mặt khi các tác nhân AI (agents) tiếp tục tăng tốc quá trình tạo và đánh giá code. Tôi dự đoán kiến trúc chọn lọc bài kiểm thử được mở rộng theo chiều ngang sẽ trở thành tiêu chuẩn ngành khi các đội ngũ vận hành các tác nhân AI tạo ra nhiều PR và nhiều bài test hơn.
Trong bài viết này, tôi sẽ thảo luận về cách chúng tôi mở rộng dịch vụ phân tích tác động kiểm thử tại Anthropic và bài học xương máu mà tôi đã rút ra: hãy luôn lập kế hoạch cho sự tăng trưởng theo cấp số nhân. Các kỹ thuật mở rộng cụ thể – mua máy chủ lớn hơn, song song hóa các tiến trình, hoặc khởi động lại dịch vụ (vâng, cách này vẫn hoạt động hiệu quả một cách đáng ngạc nhiên) – đều là những cách phổ biến và không phải là những đúc kết quan trọng từ bài viết này.
Vấn đề là mỗi kỹ thuật này chỉ mua được một phần nhỏ thời gian so với một năm trước. Mặt khác, việc đại tu và thiết kế lại hoàn toàn một dịch vụ hiện cũng chỉ tốn một phần nhỏ thời gian và bền vững hơn nhiều khi việc viết code không còn là nút thắt cổ chai nữa.
Bạn càng dự đoán trước được áp lực này và lập kế hoạch cho kiến trúc của mình phát triển theo nó, bạn càng lãng phí ít thời gian cho các giải pháp tạm bợ.
Kiến trúc phân tích tác động kiểm thử
Nhiều đồng nghiệp của tôi làm việc tại các tổ chức mà mọi bài test vẫn được chạy trên mọi thay đổi. Cách này hiệu quả đến một mức độ nhất định, nhưng không thể mở rộng: các cổng CI ngày càng trở nên chậm chạp, đắt đỏ và thiếu tin cậy.
Ngoài ra, con người rất giỏi trong việc xác định những lỗi kiểm thử nào không liên quan đến họ, trong khi các tác nhân AI sẽ cần nhiều ngữ cảnh và hướng dẫn hơn. Khi nhận được một tập hợp các bài test hợp lệ cụ thể, chúng có thể tự xác minh và lặp lại hiệu quả hơn.
Tại Anthropic, chúng tôi đã xây dựng một dịch vụ phân tích tác động kiểm thử hoặc chọn lọc bài kiểm thử mang tính tất định (deterministic), giúp xác định bài test nào cần chạy trên mỗi thay đổi dựa trên hiệu suất trong quá khứ và mức độ liên quan của gói (package). Đây không phải là một thực tiễn hiếm gặp và có cả một danh mục các nhà cung cấp dịch vụ trong lĩnh vực này.
Dịch vụ của chúng tôi phụ thuộc vào việc hai thành phần tất định phải luôn đồng bộ với nhau:
Điều này rất hiệu quả, nhưng khi có nhiều tác vụ CI chạy mỗi giây, trình lắng nghe (listener) bắt đầu ngày càng tụt hậu so với hàng đợi PR. Đối với một quy trình phát triển phần mềm (SDLC) thuần AI, một độ trễ nhỏ có thể gây ra tác động lớn. Ví dụ, 20 phút độ trễ của trình lắng nghe có thể dẫn đến hàng chục nghìn cập nhật kiểm thử không được áp dụng vào bộ chọn (selector).
Tất cả những điều này chạy như một tiến trình đơn lẻ vì việc duy trì lịch sử chạy cho mỗi bài test đồng nghĩa với việc cần một trình ghi (writer) duy nhất để áp dụng kết quả. Thiết kế v0 này đã ngăn cản chúng tôi khả năng phân mảnh (shard) theo chiều ngang.
Con đường gập ghềnh đến việc thiết kế lại
Đến tháng 10 năm ngoái, dịch vụ đã bắt đầu có dấu hiệu quá tải và chúng tôi bị gọi cảnh báo (paged) liên tục trong hai ngày.
Bản vá 1: Một cỗ máy lớn hơn
Bản sửa lỗi đầu tiên rất dễ dàng: chúng tôi tăng gấp đôi số nhân (core) chạy dịch vụ. Chúng tôi cũng biết rằng nó chỉ là tạm thời.
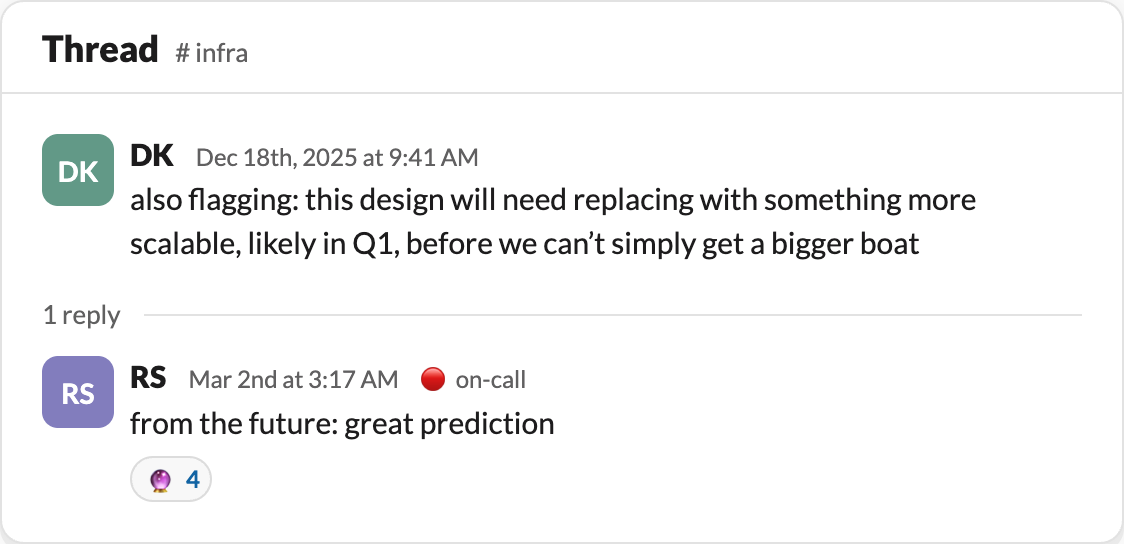
Ngay cả khi xu hướng đã rõ ràng, quyền sở hữu vẫn rất mơ hồ. Không ai muốn sở hữu thêm một phần hạ tầng nào nữa. Ngoài ra, đội ngũ CI còn có những vấn đề quan trọng hơn cần giải quyết.
Bản vá 2: Phân mảnh (Sharding)
Tại thời điểm này, chúng tôi bị gọi cảnh báo khá thường xuyên do độ trễ tích tụ trong trình lắng nghe của dịch vụ. Để thúc đẩy một số giải pháp dài hạn, tôi đã bắt đầu một phiên làm việc kéo dài trong một phiên bản Claude Tag nội bộ dành riêng cho việc giám sát dịch vụ. Bất cứ khi nào độ trễ của trình lắng nghe vượt quá 50.000 tác vụ, Claude sẽ gửi thông báo cho tôi và tiếp tục cuộc trò chuyện về các bước tiếp theo.
Việc này kéo dài hàng tháng trời và rất hữu ích khi không phải liên tục nhắc lại các nỗ lực hoặc ngữ cảnh trước đó. Claude thường tranh luận về việc đại tu, nhưng chúng tôi thường chọn một bản vá khác.
Vào tháng 2, sự tăng trưởng theo cấp số nhân của các tác vụ CI lại bắt đầu gây áp lực lên dịch vụ một lần nữa. Lần này, chúng tôi quyết định song song hóa.
Trình lắng nghe không cần một trình ghi duy nhất để sắp xếp kết quả kiểm thử một cách chính xác, nó cần một trình ghi cho mỗi gói để sắp xếp kết quả kiểm thử cho từng phần của cơ sở mã nguồn một cách chính xác. Claude đã tạo code để chúng tôi chia trạng thái của mỗi gói thành một phân mảnh (shard) với worker riêng của nó.
Chúng tôi cũng biết bản sửa lỗi này sẽ chỉ là tạm thời, nhưng không ngờ nó chỉ giúp chúng tôi trụ được 29 ngày.
Bản vá 3: Khởi động lại hàng ngày
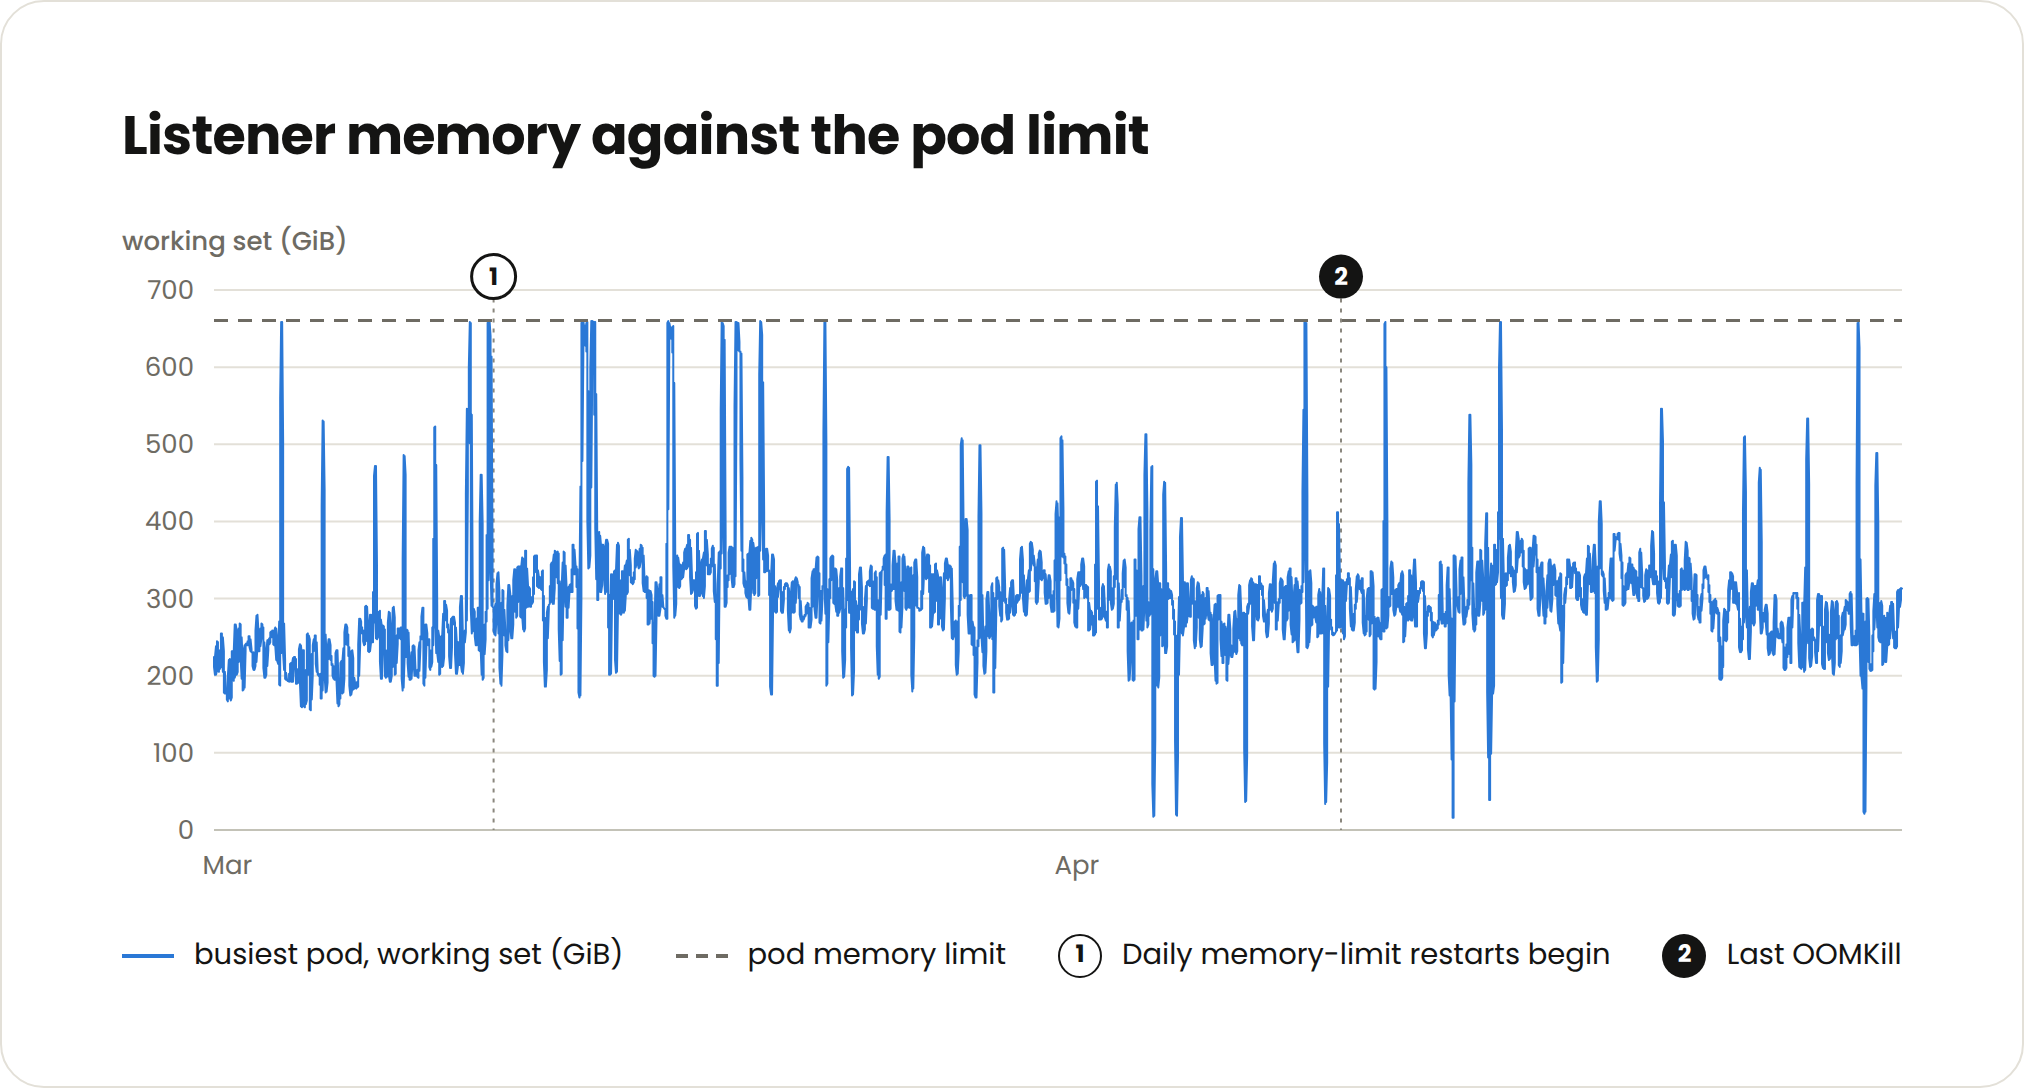
Vào tháng 3, tiến trình đã đạt đến giới hạn bộ nhớ vào giữa buổi chiều các ngày trong tuần. Một lần nữa, chúng tôi tìm kiếm các bản sửa lỗi nhanh nhưng:
Chúng tôi cũng phát hiện ra việc khởi động lại hàng ngày khiến dịch vụ dần dần tụt hậu xa hơn. Khi nó bị tụt hậu hơn một giờ, điều đã xảy ra vài lần, rất nhiều kết quả tác vụ không được trình lắng nghe ghi lại.
Cần làm rõ rằng, điều này không có nghĩa là CI không bao giờ chạy trên các PR đó, hoặc code chưa được kiểm thử bị đẩy lên môi trường production. Điều đó có nghĩa là trình lắng nghe đã không ghi nhận một số kết quả, dẫn đến thành phần chọn lọc bài kiểm thử của chúng tôi sử dụng dữ liệu cũ để quyết định những gì cần chạy và không cần chạy trên các PR. Phần lớn điều này dẫn đến việc chúng tôi chạy các bài test vốn đã rất thiếu ổn định hoặc thất bại trên diện rộng.
Thiết kế lại
Đã đến lúc (thực ra là quá muộn) để thiết kế lại dịch vụ, và chúng tôi đã làm theo lời khuyên của Claude: chúng tôi cung cấp cho dịch vụ chọn lọc bài kiểm thử một cơ sở dữ liệu, hoặc chính xác hơn là một kho lưu trữ dữ liệu trong bộ nhớ (in-memory data store). Bằng cách đó, chúng tôi đã giảm tải hiệu quả một phần lớn quá trình xử lý trong bộ nhớ mà tiến trình đơn lẻ (singleton) trước đây phải thực hiện.
Giờ đây, bất kỳ worker lắng nghe nào cũng có thể xử lý bất kỳ kết quả nào, thêm nó vào một nhật ký (journal) trong kho lưu trữ bộ nhớ và tiếp tục mà không cần giữ bất cứ thứ gì trong bộ nhớ - không trạng thái (stateless) và do đó, có thể mở rộng theo chiều ngang. Một tiến trình tiêu thụ (consumer) nhỏ riêng biệt sẽ tổng hợp nhật ký thành lịch sử cho mỗi bài test sau mỗi vài giây, và bộ chọn có thể tra cứu lịch sử kết quả liên quan một cách nhanh chóng.
Kiến trúc phân tán này tốn kém hơn khi vận hành, nhưng dễ mở rộng và dễ đo lường bộ nhớ hơn nhiều so với một tiến trình đơn lẻ thiếu ổn định. Dự án này chỉ mất ba tuần cho một kỹ sư. Một năm trước, con số đó có lẽ đã gần bằng một quý.
Bài viết được AI dịch và tổng hợp tự động từ Claude: Blog (Web). Liên kết bài gốc ở phía trên. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.