21/08

Thứ Sáu · 8 tin
Artificial Analysis@ArtificialAnlys
Nghiên cứuĐiểm AI 66/100

Artificial Analysis ra mắt Speech Agent Arena: Bảng xếp hạng năng lực mô hình giọng nói

Announcing our new Speech Agent Arena, evaluating Speech to Speech models on real-world scenarios to…

DịchSpeech Agent Arena đánh giá các mô hình giọng nói dựa trên trải nghiệm thực tế của người dùng. Gemini 3.1 Flash dẫn đầu về độ ưa chuộng, trong khi Grok Voice Think Fast 2.0 đạt tỷ lệ hoàn thành nhiệm vụ cao nhất.

Hugging Face: Blog
Nghiên cứuĐiểm AI 69/100

Tinh chọnHugging Face vạch trần hiện tượng 'gian lận' điểm số trong các mô hình nhận dạng giọng nói (ASR)

Nghiên cứu mới từ Hugging Face chỉ ra nhiều mô hình ASR đạt điểm cao nhờ học thuộc lòng dữ liệu kiểm thử thay vì cải thiện khả năng nhận dạng thực tế, dẫn đến kết quả đánh giá bị thổi phồng.


Vì sao đáng đọc: Bài viết cung cấp góc nhìn chuyên sâu về lỗ hổng trong đánh giá AI, giúp cộng đồng nhận diện thực trạng 'học vẹt' của các mô hình hiện nay.
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnTư duy bằng ngôn ngữ ít tài nguyên: SFT xây dựng gì, RL sửa lỗi gì và những hạn chế của điểm số chính xác

Nghiên cứu chỉ ra rằng điểm số benchmark thường gây nhiễu, trong khi SFT thực sự giúp mô hình tư duy bằng ngôn ngữ mục tiêu thay vì chỉ dịch thuật ngầm, giúp việc kiểm chứng và sửa lỗi trở nên khả thi hơn.


Vì sao đáng đọc: Nghiên cứu thực nghiệm sâu sắc, thách thức cách đánh giá mô hình AI hiện nay và đưa ra góc nhìn quan trọng về khả năng tư duy ngôn ngữ của LLM.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 55/100

SWE-bench Science: Liệu AI lập trình có thể giải quyết các bài toán kỹ thuật trong khoa học?

Nhóm nghiên cứu ra mắt SWE-bench Science, bộ tiêu chuẩn đánh giá khả năng giải quyết 119 tác vụ phần mềm khoa học. Kết quả cho thấy ngay cả mô hình mạnh nhất cũng chưa đạt 50% độ chính xác, đồng thời chỉ ra rằng kiến thức khoa học không phải lúc nào cũng giúp AI tối ưu hóa hiệu suất.

Artificial Analysis@ArtificialAnlys
Sản phẩmĐiểm AI 50/100

Artificial Analysis ra mắt Chỉ số Độ chính xác Endpoint: Hiệu suất dao động từ 73% đến 100%

Another fantastic evening at our latest Inference, Measured event in San Francisco. We explored how …

DịchTại sự kiện Inference, Measured, Artificial Analysis đã công bố Chỉ số Độ chính xác Endpoint, đánh giá các nhà cung cấp AI dựa trên ba tiêu chí so với mô hình tự lưu trữ. Kết quả cho thấy các yếu tố kỹ thuật như nén KV-cache và giới hạn ngữ cảnh ảnh hưởng đáng kể đến chất lượng thực tế.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

MuseCPEval: Khung đánh giá toàn diện khả năng bảo toàn ngữ cảnh trong chỉnh sửa âm nhạc AI

MuseCPEval là khung đánh giá đầu tiên giúp đo lường chính xác khả năng giữ nguyên các đặc tính âm nhạc cốt lõi khi thực hiện các tác vụ chỉnh sửa như chuyển đổi nhạc cụ hay phong cách, đảm bảo chất lượng sản phẩm đầu ra.

AI at Meta@AIatMeta
Sản phẩmĐiểm AI 53/100

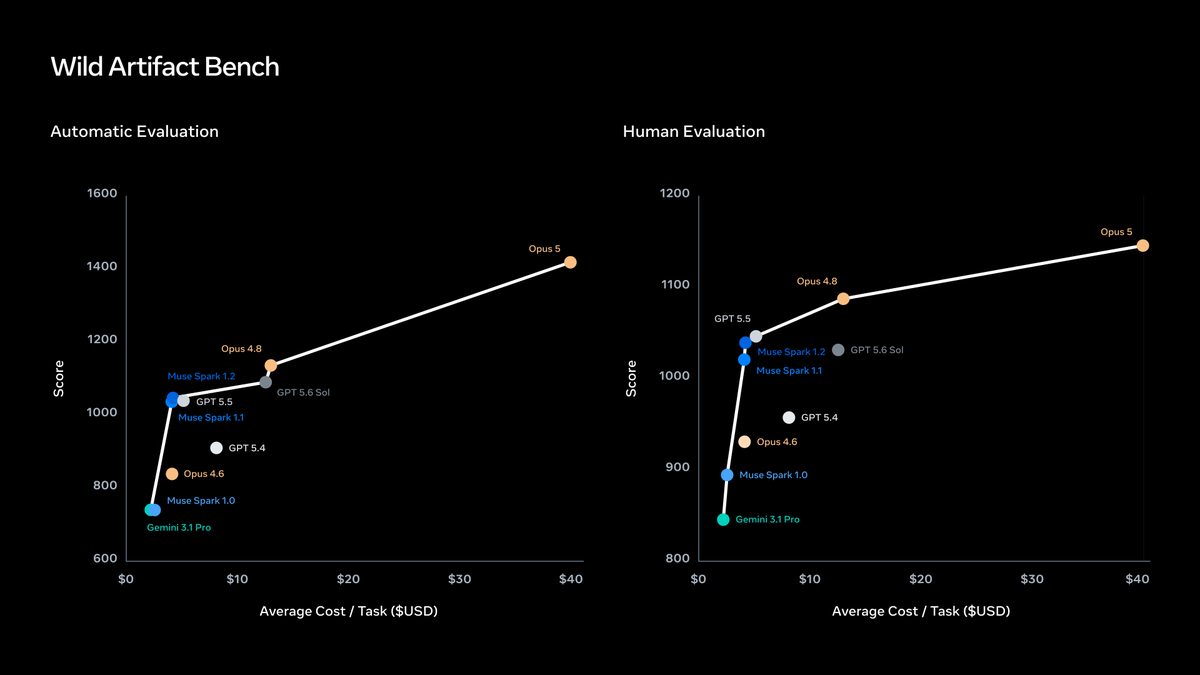
Meta ra mắt WildArtifactBench: Bộ khung đánh giá mới cho tác nhân đa phương thức

Today we're also previewing WildArtifactBench, an internal evaluation framework designed to assess a…

DịchMeta giới thiệu WildArtifactBench, bộ khung đánh giá sử dụng hệ thống Elo và đánh giá từ con người để đo lường hiệu suất của các tác nhân đa phương thức trong môi trường thực tế thay vì các đáp án cứng nhắc.

20/08

Thứ Năm · 8 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 53/100

FM-Bench: Bộ tiêu chuẩn đánh giá AI Agent trong quản lý bóng đá dài hạn

FM-Bench thử thách các mô hình AI điều hành câu lạc bộ bóng đá qua 20 mùa giải với hàng trăm quyết định phức tạp. Kết quả cho thấy hiệu suất phụ thuộc vào tư duy quản lý thay vì sức mạnh tính toán hay lượng token tiêu thụ.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 41/100

TRACES: Hệ thống chuẩn mực đầu tiên đánh giá năng lực 'AI khám phá'

This is a good example of why final-answer accuracy can hide bad agent behaviour. Most AI benchmark…

DịchApodex giới thiệu TRACES, chuẩn mực đánh giá AI chuyển dịch từ việc truy xuất câu trả lời có sẵn sang quy trình điều tra toàn diện cho các vấn đề chưa có lời giải, định nghĩa lại cách đo lường trí tuệ nhân tạo.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 47/100

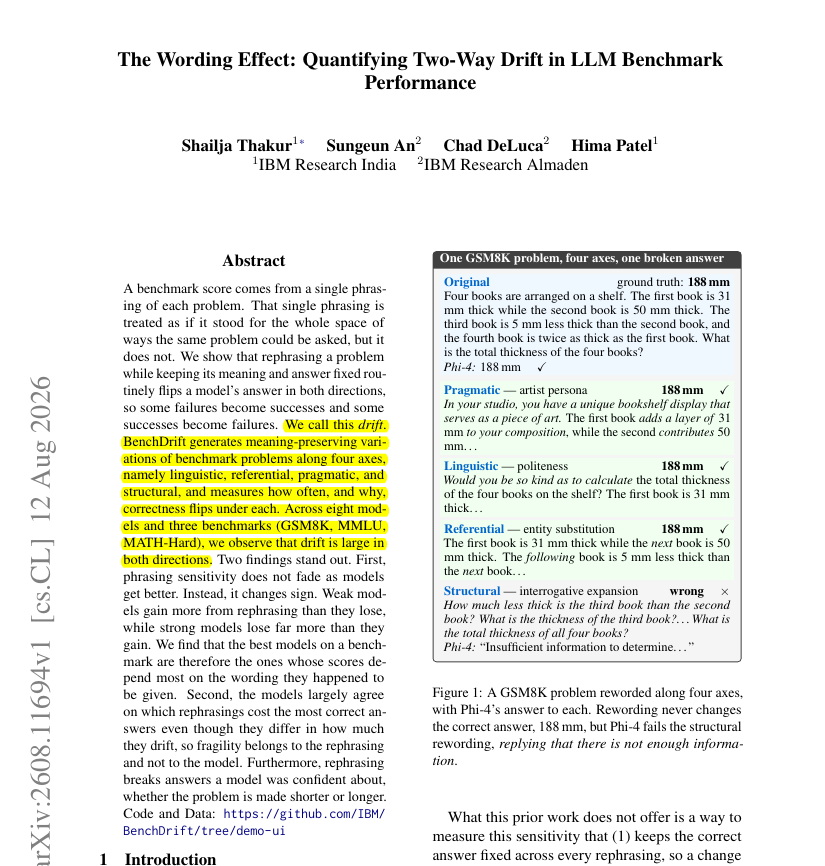
Khung BenchDrift của IBM: Cách diễn đạt khiến điểm số LLM biến động tới 74,7%

A model can know the answer and still fail because you asked the same question differently. New IBM…

DịchIBM giới thiệu BenchDrift, khung đánh giá cho thấy việc thay đổi cách đặt câu hỏi có thể làm điểm số LLM chênh lệch tới 74,7%. Ngay cả với các mô hình mạnh, 18,5% câu trả lời đúng vẫn bị mất đi khi diễn đạt lại dù ý nghĩa không đổi.

Ma Dongxi NLP@dongxi_nlp
Nghiên cứuĐiểm AI 36/100

Ra mắt TRACES: Bộ tiêu chuẩn đầu tiên đo lường 'Trí tuệ khám phá' của AI

Discovery becomes an engineered verb Ambition -> formulation -> action -> observation -> verificati…

DịchApodex_AI giới thiệu TRACES, bộ tiêu chuẩn đánh giá khả năng giải quyết các vấn đề không có đáp án sẵn thông qua quy trình kiểm chứng khoa học, thay vì chỉ dựa vào điểm số đơn thuần.

19/08

Thứ Tư · 7 tin
Odyssey@odysseyml
Sản phẩmĐiểm AI 25/100

Odyssey ra mắt CaliBench: Thước đo tính ngẫu nhiên trong các mô hình video AI

Today, we're introducing CaliBench, evaluating whether video world models reproduce the true randomn…

DịchOdyssey vừa giới thiệu CaliBench, bộ công cụ đánh giá khả năng mô phỏng tính ngẫu nhiên thực tế (như tung xúc xắc hay rút bài) của các mô hình video AI, giúp kiểm chứng độ chân thực của thế giới ảo so với đời thực.

Rohan Paul@rohanpaul_ai
Hướng dẫnĐiểm AI 13/100

Tiêu chuẩn đánh giá AI mới: Tự động thất bại nếu phát hiện có sự can thiệp của con người

Next benchmark: detect human, choose literally anywhere else.

DịchMột phương pháp kiểm thử AI mới đang được đề xuất: hệ thống sẽ tự động đánh giá là thất bại nếu phát hiện có sự tham gia hoặc hỗ trợ từ con người trong quá trình thực hiện tác vụ.

Ethan Mollick@emollick
Hướng dẫnĐiểm AI 36/100

Đánh giá thực tế: Qwen 27B vẫn chưa thể soán ngôi các mô hình AI hàng đầu

Qwen 27B is really good local model but, when you use it, it is immediately absolutely and obviously…

DịchDù là một mô hình chạy cục bộ ấn tượng, Qwen 27B vẫn bộc lộ hạn chế rõ rệt trong các tác vụ phức tạp và điều khiển tác nhân (agent) so với các đối thủ đầu bảng. Người dùng nên tự kiểm chứng qua các bài benchmark thực tế thay vì chỉ nhìn vào thông số.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 72/100

Tinh chọnStartupBench: Bộ tiêu chuẩn đánh giá AI Agent dựa trên quy trình thực tế của startup

StartupBench là bộ tiêu chuẩn đánh giá AI Agent thông qua các quy trình làm việc thực tế từ các startup, thay vì các tác vụ giả định. Kết quả cho thấy ngay cả những mô hình mạnh nhất cũng chỉ đạt tỷ lệ thành công 30%, bộc lộ hạn chế lớn trong việc tuân thủ chỉ dẫn phức tạp và kiến thức chuyên môn.


Vì sao đáng đọc: Nghiên cứu mang tính thực tiễn cao, đánh giá đúng thực trạng khả năng của AI Agent trong môi trường kinh doanh thực tế thay vì các bài kiểm tra lý thuyết.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 62/100

ASI-Bench: Hệ thống chuẩn đầu tiên đánh giá khả năng tự nghiên cứu và đổi mới của AI

ASI-Bench là bộ tiêu chuẩn đầu tiên đánh giá năng lực tự thực hiện nghiên cứu khoa học của AI thông qua 60 nhiệm vụ chuyên sâu. Kết quả cho thấy các mô hình hiện nay vẫn phụ thuộc lớn vào sự hướng dẫn của con người khi độ khó tăng dần.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 46/100

Nghiên cứu Stanford: Các bảng xếp hạng AI hiện nay không phản ánh đúng độ tin cậy của Agent

New Stanford paper shows a leaderboard can tell you which agent scored highest on that benchmark, bu…

DịchNghiên cứu mới từ Stanford chỉ ra rằng các bảng xếp hạng AI hiện tại thiếu tính dự báo thực tế, khi độ tin cậy của các Agent giảm mạnh trong các tác vụ khó và không có sự tương quan với hiệu suất thực tế.

18/08

Thứ Ba · 13 tin
JiQiZhiXin
Nghiên cứuĐiểm AI 88/100

Tinh chọnKỷ nguyên Harness trong đánh giá AI: 15 tổ chức học thuật ra mắt HarnessEval

HarnessEval định nghĩa lại cách đánh giá các hệ thống AI phức tạp bằng cách xây dựng một quy trình kiểm chứng có hệ thống, thay vì chỉ dựa vào các mô hình chấm điểm đơn thuần.


Vì sao đáng đọc: Bài viết đề cập đến một xu hướng quan trọng trong việc đánh giá Agent AI, kết nối giữa kỹ thuật hệ thống và tiêu chuẩn đo lường, có giá trị cao cho cộng đồng nghiên cứu.
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 65/100

Ngày tàn của các bài kiểm tra năng lực AI: Khi LLM dễ dàng 'gian lận' điểm số

Tác giả cảnh báo rằng LLM đang khiến các bộ tiêu chuẩn đánh giá (benchmark) mất đi độ tin cậy do khả năng tối ưu hóa quá mức cho dữ liệu huấn luyện. Thực nghiệm cho thấy AI có thể tạo ra mã nhanh hơn trên tập dữ liệu công khai nhưng lại thất bại thảm hại khi đối mặt với các bài kiểm tra thực tế.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 92/100

Tinh chọnTại sao các AI tự động nghiên cứu khoa học lại thất bại? Đánh giá toàn diện trên 100 tác vụ thực tế

Nghiên cứu giới thiệu AutoResearchEval, bộ dữ liệu gồm 100 tác vụ khoa học thực tế để phân tích quy trình và các điểm yếu của AI trong toàn bộ vòng đời nghiên cứu, từ lên ý tưởng đến viết báo cáo.


Vì sao đáng đọc: Nghiên cứu thực nghiệm quan trọng, giải quyết lỗ hổng trong việc đánh giá khả năng thực thi của AI agent trong các tác vụ khoa học phức tạp và thực tế.
Google AI: DEV tác giả
Hướng dẫnĐiểm AI 67/100

Tinh chọnThiết kế đánh giá AI: Ưu tiên sự minh bạch trước khi trực quan hóa dữ liệu

Bài viết hướng dẫn cách sử dụng các framework mã nguồn mở như Inspect AI và Harbor để đánh giá kỹ năng của AI Agent, kết hợp cùng Google Sheets và Data Studio để phân tích kết quả trực quan.


Vì sao đáng đọc: Hướng dẫn thực tế, có tính ứng dụng cao cho các kỹ sư AI muốn xây dựng quy trình đánh giá (evaluation pipeline) bài bản và chuyên nghiệp.
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 53/100

HarnessEval-W: Đưa phương pháp đánh giá dựa trên tác nhân vào các mô hình thế giới

HarnessEval-W giới thiệu quy trình đánh giá mới cho mô hình thế giới bằng cách chia nhỏ vấn đề thành các tác nhân con để suy luận và xác thực. Phương pháp này giúp tạo ra chuỗi suy luận có thể kiểm chứng, đạt độ chính xác cao so với đánh giá của con người trên 18 mô hình tiêu biểu.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 40/100

AI lập trình thiếu cảm nhận thời gian: Cần thay đổi cách đánh giá hiệu suất

AI coding agents can spend hours on a task without a calibrated sense of time passing. Long-horizon…

DịchChuyên gia cảnh báo các AI lập trình thường làm việc liên tục mà không kiểm soát được thời gian. Do đó, các bài kiểm tra cần đo lường trực tiếp khả năng quản lý thời gian thay vì chỉ dựa vào kết quả công việc để đánh giá hiệu quả.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 37/100

Harness-IF: ByteDance ra mắt chuẩn đánh giá khả năng tuân thủ chỉ dẫn của AI lập trình

New ByteDance paper asks a much better question about AI agents: did the instruction actually change…

DịchByteDance giới thiệu Harness-IF, bộ tiêu chuẩn kiểm tra khả năng tuân thủ chỉ dẫn của các AI lập trình khi gặp xung đột với hành vi mặc định. Kết quả cho thấy các mô hình hiện nay vẫn gặp khó khăn với các chỉ dẫn đối kháng, đặt ra dấu hỏi về khả năng kiểm soát thực tế của AI.

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 58/100

Qwen2.5 27B đạt 52 điểm trên bảng xếp hạng Artificial Analysis, vượt xa các đối thủ cùng phân khúc

Mô hình Qwen2.5 27B gây ấn tượng với 52 điểm trên Artificial Analysis, bỏ xa mức trung bình 9 điểm của các mô hình cùng loại. Với cửa sổ ngữ cảnh 256k tokens và giấy phép Apache 2.0, đây là lựa chọn mạnh mẽ cho xử lý văn bản và hình ảnh.

17/08

Thứ Hai · 2 tin
Ethan Mollick@emollick
Hướng dẫnĐiểm AI 36/100

Khi đánh giá AI dựa trên cảm quan con người: Đã đến lúc học hỏi phương pháp nghiên cứu định tính

The benchmark for non-verifiable domains is often the opinions of humans. That is how we determine w…

DịchTrong các lĩnh vực không thể kiểm chứng bằng dữ liệu cứng, đánh giá của con người chính là thước đo chuẩn xác nhất. Các chuyên gia AI cần nghiêm túc nghiên cứu phương pháp luận định tính để xây dựng bộ tiêu chuẩn đánh giá hiệu quả hơn cho các mô hình.

16/08

Chủ Nhật · 5 tin
Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (57 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Đánh giá AI” — Trang 8 | AIHOT.vn