15/09

Thứ Ba · 9 tin
Kim@kimmonismus
NgànhĐiểm AI 36/100

Glasser ra mắt API hợp nhất 40+ nguồn dữ liệu với mô hình trả phí theo lượt gọi

An agent may need five data sources for a single task. Paying five monthly subscriptions for that ge…

DịchGlasser cung cấp quyền truy cập vào hơn 40 nhà cung cấp dữ liệu thông qua một API duy nhất, giúp các AI agent linh hoạt thay đổi nguồn dữ liệu mà không cần đăng ký nhiều gói thuê bao hàng tháng.

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 75/100

Đánh giá GPT-5.6 Luna vs GPT-6 Astra: Liệu mô hình rẻ hơn 28 lần có đủ sức thay thế trong review code?

Entelligence thực hiện bài kiểm tra trên 50 PR công khai để so sánh hiệu năng review code giữa GPT-5.6 Luna và GPT-6 Astra, tập trung vào khả năng tối ưu chi phí mà vẫn đảm bảo chất lượng.

Diễn biến sự kiện · 2 bài →
Fireworks AI (Web)
Mô hìnhĐiểm AI 71/100

Đã có đại diệnFireworks ra mắt DeepSeek-V4.1-Flash: Hiệu năng ngang ngửa GPT-6 Astra với chi phí rẻ gấp 15 lần

Fireworks vừa trình làng DeepSeek-V4.1-Flash, đạt tỷ lệ pass@1 ấn tượng 74.34% trên DeepSWE. Mô hình này mang lại độ chính xác tương đương GPT-6 Astra nhưng với chi phí vận hành chỉ bằng 1/15.

Cùng sự kiện, tinh chọn hiển thị «DeepSeek ra mắt DeepSeek-V4.1-Flash: Cửa sổ 1M token, tối ưu bộ nhớ KV Cache cực đỉnh»
Arena@arena
Nghiên cứuĐiểm AI 66/100

Tinh chọnDeepSeek-V4.1-Flash (Max) vươn lên vị trí thứ 3 trên bảng xếp hạng Agent Arena

Exciting news: DeepSeek-V4.1-Flash (Max) by @deepseek_ai just landed in Agent Arena at #3 among open…

DịchDeepSeek-V4.1-Flash (Max) đạt vị trí thứ 3 trong nhóm mô hình mã nguồn mở trên Agent Arena với hiệu suất tăng 4,87% và chi phí tối ưu chỉ 0,07 USD mỗi tác vụ, vượt xa các đối thủ về hiệu quả kinh tế.


Vì sao đáng đọc: Tin tức quan trọng về hiệu suất và tối ưu chi phí của mô hình DeepSeek, thu hút sự quan tâm lớn từ cộng đồng AI và các nhà phát triển ứng dụng Agent.
Elvis Saravia@omarsar0
NgànhĐiểm AI 39/100

Tự xây dựng Agent Harness: Bí quyết cắt giảm chi phí Token hiệu quả

If you build your own harness, you can drive that cost down even further. Out-of-the-box agent harn…

DịchThay vì dùng các bộ khung (harness) cồng kềnh, việc tự xây dựng hệ thống tối giản giúp giảm đáng kể chi phí token thông qua tối ưu hóa prompt, gọi công cụ thông minh và kiểm soát luồng dữ liệu chặt chẽ.

13/09

Chủ Nhật · 3 tin
JiQiZhiXin
Nghiên cứuĐiểm AI 92/100

Tinh chọnChi phí suy luận giảm 96%, hiệu năng vượt trội: Khi mô hình nhỏ biết tự 'cầu cứu' AI lớn

Pyromind giới thiệu PyroDash, giải pháp cho phép các mô hình nhỏ tự quyết định thời điểm cần gọi mô hình lớn hỗ trợ. Cách tiếp cận này giúp cắt giảm chi phí vận hành tới 96% mà vẫn duy trì, thậm chí cải thiện độ chính xác so với việc chỉ dùng mô hình lớn.


Vì sao đáng đọc: Đây là bước tiến thực tế giải quyết bài toán chi phí đắt đỏ trong AI, có tính ứng dụng cao cho doanh nghiệp và lập trình viên, đồng thời phương pháp tiếp cận rất thông minh.

12/09

Thứ Bảy · 3 tin
Hongming@hongming731
NgànhĐiểm AI 38/100

Cùng sự kiệnĐiểm tin AI: Uber tối ưu chi phí AI nhờ mô hình mở và quản trị bộ nhớ Agent

Bản tin tổng hợp 10 nội dung AI nổi bật, trong đó Uber đã cắt giảm tới 52% chi phí mỗi phiên làm việc nhờ áp dụng mô hình trọng số mở, định tuyến mô hình và kiểm thử liên tục.

Cùng sự kiện, tinh chọn hiển thị «Anthropic đánh giá khả năng của AI trong tác chiến tình báo và phát triển vũ khí thông thường»
Hongming@hongming731
NgànhĐiểm AI 44/100

Cùng sự kiệnĐiểm tin AI: Uber tối ưu chi phí mô hình, quản trị bộ nhớ Agent và ứng dụng AI tại JD.com

Bản tin tổng hợp cách Uber cắt giảm 52% chi phí hội thoại AI, kỹ thuật quản trị bộ nhớ dài hạn cho Agent của Alibaba và kinh nghiệm ứng dụng AI giúp JD.com rút ngắn 50% thời gian phát triển sản phẩm.

Cùng sự kiện, tinh chọn hiển thị «Anthropic đánh giá khả năng của AI trong tác chiến tình báo và phát triển vũ khí thông thường»

11/09

Thứ Sáu · 7 tin
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Hướng dẫnĐiểm AI 66/100

RTK có thực sự giúp giảm chi phí lập trình AI? Kết quả kiểm chứng từ Quesma cho thấy điều ngược lại

Quesma đã chi hơn 1.500 USD để kiểm chứng RTK trên Terminal-Bench 2.1 và kết luận rằng công cụ này không giúp giảm chi phí lập trình AI như quảng cáo, thậm chí còn làm tăng chi phí trung bình ở một số mô hình do các chi phí ẩn từ bộ nhớ đệm và số vòng lặp.

WeChat: Carl AI Watts
Hướng dẫnĐiểm AI 76/100

Đã có đại diệnTrải nghiệm thực tế DeepSeek V4.1 Flash: Giá rẻ bất ngờ, tích hợp thị giác, hiệu năng ấn tượng

DeepSeek V4.1 Flash giảm giá sâu tới 7 lần cho input cache và 2/3 cho output. Từ 14/9, mọi yêu cầu v4-pro sẽ tự động chuyển sang bản Flash với chi phí tối ưu hơn.

Cùng sự kiện, tinh chọn hiển thị «DeepSeek ra mắt DeepSeek-V4.1-Flash: Cửa sổ 1M token, tối ưu bộ nhớ KV Cache cực đỉnh»
MarkTechPost
Mô hìnhĐiểm AI 59/100

Sakana AI ra mắt Fugu Max và Fugu Ultra v2: Đột phá tối ưu chi phí cho điều phối đa mô hình

Sakana AI vừa giới thiệu bộ đôi mô hình Fugu mới, cho phép định tuyến tác vụ thông minh giữa nhiều mô hình thông qua một API duy nhất tương thích với OpenAI, giúp giảm đáng kể chi phí vận hành.

Thêm 1 nguồn khác đưa tinSakana AI: Blog (Web)
Testing Catalog@testingcatalog
Hướng dẫnĐiểm AI 65/100

Pocket FM tăng gấp đôi doanh thu lên 500 triệu USD nhờ ứng dụng AI vào sản xuất nội dung

Pocket FM doubled its revenue run rate to $500M in 1 year by using AI to power its content. Accordi…

DịchNhờ tích hợp AI tự phát triển vào quy trình viết và chuyển đổi văn bản thành giọng nói, Pocket FM đã rút ngắn thời gian sản xuất từ 1 năm xuống còn 1 ngày, giảm 80 lần chi phí và đạt mức doanh thu 500 triệu USD/năm.

Replit@Replit
NgànhĐiểm AI 42/100

Replit ra mắt Routines: Tự động hóa tác vụ AI theo lịch trình

Agents can now automate most repetitive tasks. But running them 24/7 burns countless tokens. Introd…

DịchReplit giới thiệu tính năng Routines giúp tự động hóa các tác vụ định kỳ theo giờ, ngày hoặc tuần. Giải pháp này tối ưu chi phí bằng cách chỉ gọi AI khi cần thiết, thay vì duy trì chạy liên tục.

TechCrunch: AI
NgànhĐiểm AI 63/100

Pocket FM đạt doanh thu 500 triệu USD: AI chiếm 93% nội dung, giảm chi phí sản xuất gấp 80 lần

Nền tảng âm thanh Pocket FM tăng gấp đôi doanh thu nhờ ứng dụng AI sản xuất 99% nội dung mới, giúp rút ngắn thời gian tạo 100 giờ nội dung từ một năm xuống còn một ngày và tối ưu chi phí hiệu quả.

Thêm 1 nguồn khác đưa tinX: Rohan Paul (@rohanpaul_ai)

10/09

Thứ Năm · 6 tin
Yuchen Jin@Yuchenj_UW
Mô hìnhĐiểm AI 64/100

Cùng sự kiệnDeepSeek V4.1 Flash vượt mặt GPT-5.6 Sol trong lập trình với chi phí rẻ hơn 97%

DeepSeek V4.1 Flash is beating GPT-5.6 Sol on coding and agent benchmarks, while being ~97% cheaper….

DịchDeepSeek V4.1 Flash thiết lập chuẩn mực mới về hiệu năng lập trình và tác vụ AI với chi phí thấp hơn 97% so với GPT-5.6 Sol. Mô hình này tối ưu hóa bộ nhớ đệm KV gấp 4 lần, đánh dấu bước tiến lớn cho cộng đồng mã nguồn mở.

Cùng sự kiện, tinh chọn hiển thị «DeepSeek ra mắt DeepSeek-V4.1-Flash: Cửa sổ 1M token, tối ưu bộ nhớ KV Cache cực đỉnh»
Elvis Saravia@omarsar0
Sản phẩmĐiểm AI 61/100

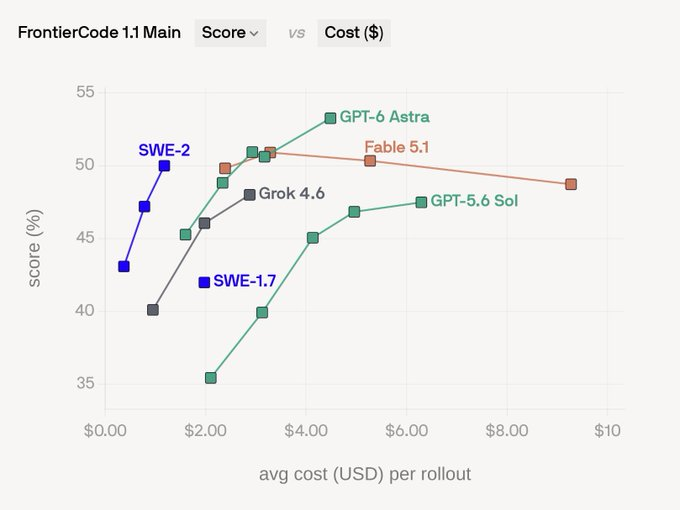
Cognition ra mắt SWE-2: Hiệu năng tiệm cận mô hình đầu bảng với chi phí giảm tới 70%

Just amazed by how specialized models keep pushing the Pareto frontier. Just watch that massive co…

DịchCognition vừa trình làng SWE-2, mô hình đạt điểm số ấn tượng trên FrontierCode 1.1 với chi phí vận hành thấp hơn 64-70% so với các đối thủ hàng đầu nhờ ứng dụng kỹ thuật học tăng cường (RL) quy mô lớn.

LlamaIndex: Sản phẩm, kỹ thuật và đánh giá
Hướng dẫnĐiểm AI 65/100

Tinh chọnLlamaIndex giới thiệu OCR thông minh: Giải pháp cân bằng chi phí và độ chính xác cho tài liệu

LlamaIndex đề xuất quy trình OCR hai bước: dùng công cụ miễn phí để quét sơ bộ, sau đó chỉ dùng mô hình thị giác (VLM) cho các trang quan trọng nhằm tối ưu chi phí và hiệu suất.


Vì sao đáng đọc: Giải pháp thực tế, giải quyết trực tiếp bài toán chi phí cao khi xử lý tài liệu bằng AI, rất hữu ích cho các kỹ sư và doanh nghiệp.
Deedy Das@deedydas
Hướng dẫnĐiểm AI 68/100

DeepSeek V4.1 Flash: 'Vua' mã nguồn mở mới vượt mặt GLM 5.3 và Kimi K3

DeepSeek might be the new king of open-source models. It obliterates GLM 5.3 and Kimi K3 on benchmar…

DịchNhà đầu tư Deedy Das đánh giá DeepSeek V4.1 Flash vượt trội hơn GLM 5.3 và Kimi K3 trong các bài kiểm tra, với chi phí rẻ hơn 4-10 lần. Đặc biệt, mô hình đạt 3471 điểm trên Codeforces, là lựa chọn tối ưu cho các startup phát triển sản phẩm lập trình.

Elvis Saravia@omarsar0
NgànhĐiểm AI 31/100

GPT-6 Astra: Tối ưu hóa hiệu suất và chi phí trong quy trình làm việc AI

Better models don't automatically mean smaller AI bills. Sometimes they mean you finally have a rea…

DịchGPT-6 Astra giúp hiện thực hóa các quy trình phức tạp chỉ với một lần phản hồi. Thay vì chỉ nhìn vào chi phí token, doanh nghiệp nên tập trung vào việc tối đa hóa kết quả thực tế đạt được trong cùng một ngân sách.

09/09

Thứ Tư · 8 tin
Cognition Mô hình / Devin Blog (Web)
Mô hìnhĐiểm AI 70/100

Tinh chọnCognition ra mắt mô hình lập trình SWE-2: Hiệu năng tiệm cận đỉnh cao với chi phí tối ưu

Cognition giới thiệu SWE-2, mô hình lập trình dựa trên Kimi K33, đạt 50% điểm số trên FrontierCode 1.1. Dù hiệu năng gần bằng Fable 5.1, SWE-2 giúp tiết kiệm tới 64% chi phí vận hành.


Vì sao đáng đọc: Đây là bước tiến quan trọng trong việc tối ưu hóa chi phí cho các tác nhân AI lập trình, thu hút sự quan tâm lớn từ cộng đồng kỹ thuật và doanh nghiệp.
Artificial Analysis@ArtificialAnlys
Sản phẩmĐiểm AI 53/100

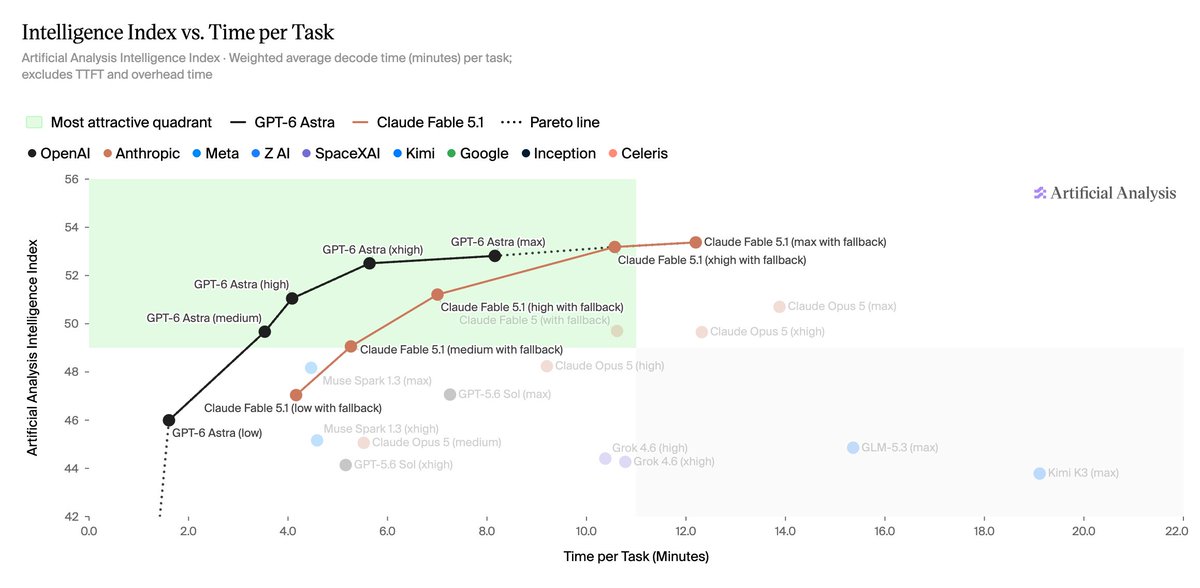
Artificial Analysis ra mắt trang so sánh hiệu năng, chi phí và tốc độ mô hình AI theo từng cấp độ

You can now easily compare the intelligence, cost, and speed on different effort levels for your pre…

DịchArtificial Analysis vừa giới thiệu trang Model Release, cho phép người dùng so sánh trực quan khả năng thông minh, chi phí và tốc độ của các mô hình AI ở nhiều cấp độ vận hành khác nhau, kèm theo chỉ số năng lực chuyên sâu trong các lĩnh vực như tài chính, luật và y tế.

WeChat: Khazix
Hướng dẫnĐiểm AI 70/100

Tinh chọnBí quyết tối ưu Token khi chọn cấp độ suy luận trên GPT-6 Astra

Bài viết giải mã ý nghĩa các cấp độ 'Reasoning Effort' trên GPT-6 Astra, giúp bạn hiểu cách điều chỉnh ngân sách tư duy của AI để tiết kiệm chi phí mà vẫn đạt hiệu quả cao nhất.

Diễn biến sự kiện · 1 bài →

Vì sao đáng đọc: Nội dung thực tế, giải quyết trực tiếp bài toán chi phí cho người dùng chuyên nghiệp khi sử dụng các mô hình AI thế hệ mới.
Claude: Blog (Web)
Hướng dẫnĐiểm AI 66/100

Tinh chọnAnthropic chia sẻ bí quyết tối ưu chi phí và hiệu suất khi sử dụng Claude API

Anthropic hướng dẫn ba chiến lược giúp doanh nghiệp tiết kiệm chi phí khi dùng Claude: tận dụng bộ nhớ đệm prompt, loại bỏ các lỗi thiết kế prompt cũ và điều chỉnh độ phức tạp của tác vụ phù hợp với từng mô hình.

Diễn biến sự kiện · 2 bài →Thêm 1 nguồn khác đưa tinX: Claude Devs (@ClaudeDevs)

Vì sao đáng đọc: Nội dung cực kỳ thiết thực cho các lập trình viên và doanh nghiệp đang tích hợp Claude, giúp giải quyết bài toán chi phí vốn là rào cản lớn nhất hiện nay.
Claude Devs@ClaudeDevs
Hướng dẫnĐiểm AI 67/100

Đã có đại diện3 chiến lược tối ưu chi phí và hiệu suất khi sử dụng nền tảng Claude từ Anthropic

Anthropic chia sẻ cách tối ưu hóa bộ nhớ đệm prompt, loại bỏ các lỗi thiết lập câu lệnh cũ và điều chỉnh mức độ nỗ lực của mô hình để tiết kiệm chi phí mà vẫn duy trì hiệu suất cao.

Cùng sự kiện, tinh chọn hiển thị «Anthropic chia sẻ bí quyết tối ưu chi phí và hiệu suất khi sử dụng Claude API»

08/09

Thứ Ba · 2 tin

06/09

Chủ Nhật · 1 tin

05/09

Thứ Bảy · 5 tin
Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (59 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Tối ưu chi phí” — Trang 3 | AIHOT.vn